
要旨:カタログ拡大後に何を証明すべきか
メタゲノミクスは未培養微生物の配列を研究対象にもたらすが、新規遺伝子クラスター、候補種、モデルが予測する機能は、それぞれ異なる証拠階層に位置する。本稿は、地球規模の微生物ゲノムカタログとヒト腸内統合カタログに基づき、生リードからアセンブリ、ビニング、分類、機能推論に至る誤差を分析する。「回収可能なゲノム情報」と「検証済みの生物学的機能」を別々に集計し、データベースの規模をそのまま機構発見の件数として記述しないことを提案する。[1] A genomic catalog of Earth’s microbiomes[2] A unified catalog of 204,938 reference genomes from the
原文の英語要旨の日本語訳
ゲノム解像度のメタゲノミクスは未培養の多様性へのアクセスを拡大するが、カタログの規模は機能の検証を意味しない。本稿では、検出限界、アセンブリとビニングの不確実性、系統を考慮した評価、欠落した経路構成要素を分析する。ポアソンサンプリングと完全性の例を通じて、シーケンシング深度とゲノム回収が、見かけ上の新規性から主張できる内容をどのように規定するかを示す。
二つの大規模カタログが実際に提供する資源
Nayfachらは多様な環境のメタゲノムから組み立てられたゲノムを集め、Almeidaらはヒト腸内の参照ゲノムを統合した。これらは未培養の多様性へのアクセス可能な範囲を拡大し、比較研究のための座標を提供している。本稿では更新済みの出典ページとその訂正情報を使用し、本文と要旨で一致しない可能性のある門の数は踏襲しない。また、非冗長なゲノムレコード数を、そのまま独立した種の数や実験的検証の件数とはみなさない。[1] A genomic catalog of Earth’s microbiomes[2] A unified catalog of 204,938 reference genomes from the
リードは微生物の偏りのない縮図ではない
DNA抽出効率、断片長、シーケンシング深度は、各微生物群がデータに含まれる確率に影響する。ゲノムサイズ、コピー数、試料処理が異なり得るため、細胞数が等しくてもリード数が等しいとは限らない。研究では、推定対象がリードの相対存在量なのか、ゲノムコピー数なのか、細胞数なのかを明示すべきである。適切な較正なしに測定基準を切り替えると、過度に精密な生態学的解釈が生じる。作者分析与复核建议 / Author analysis
未検出は単に深度不足かもしれない
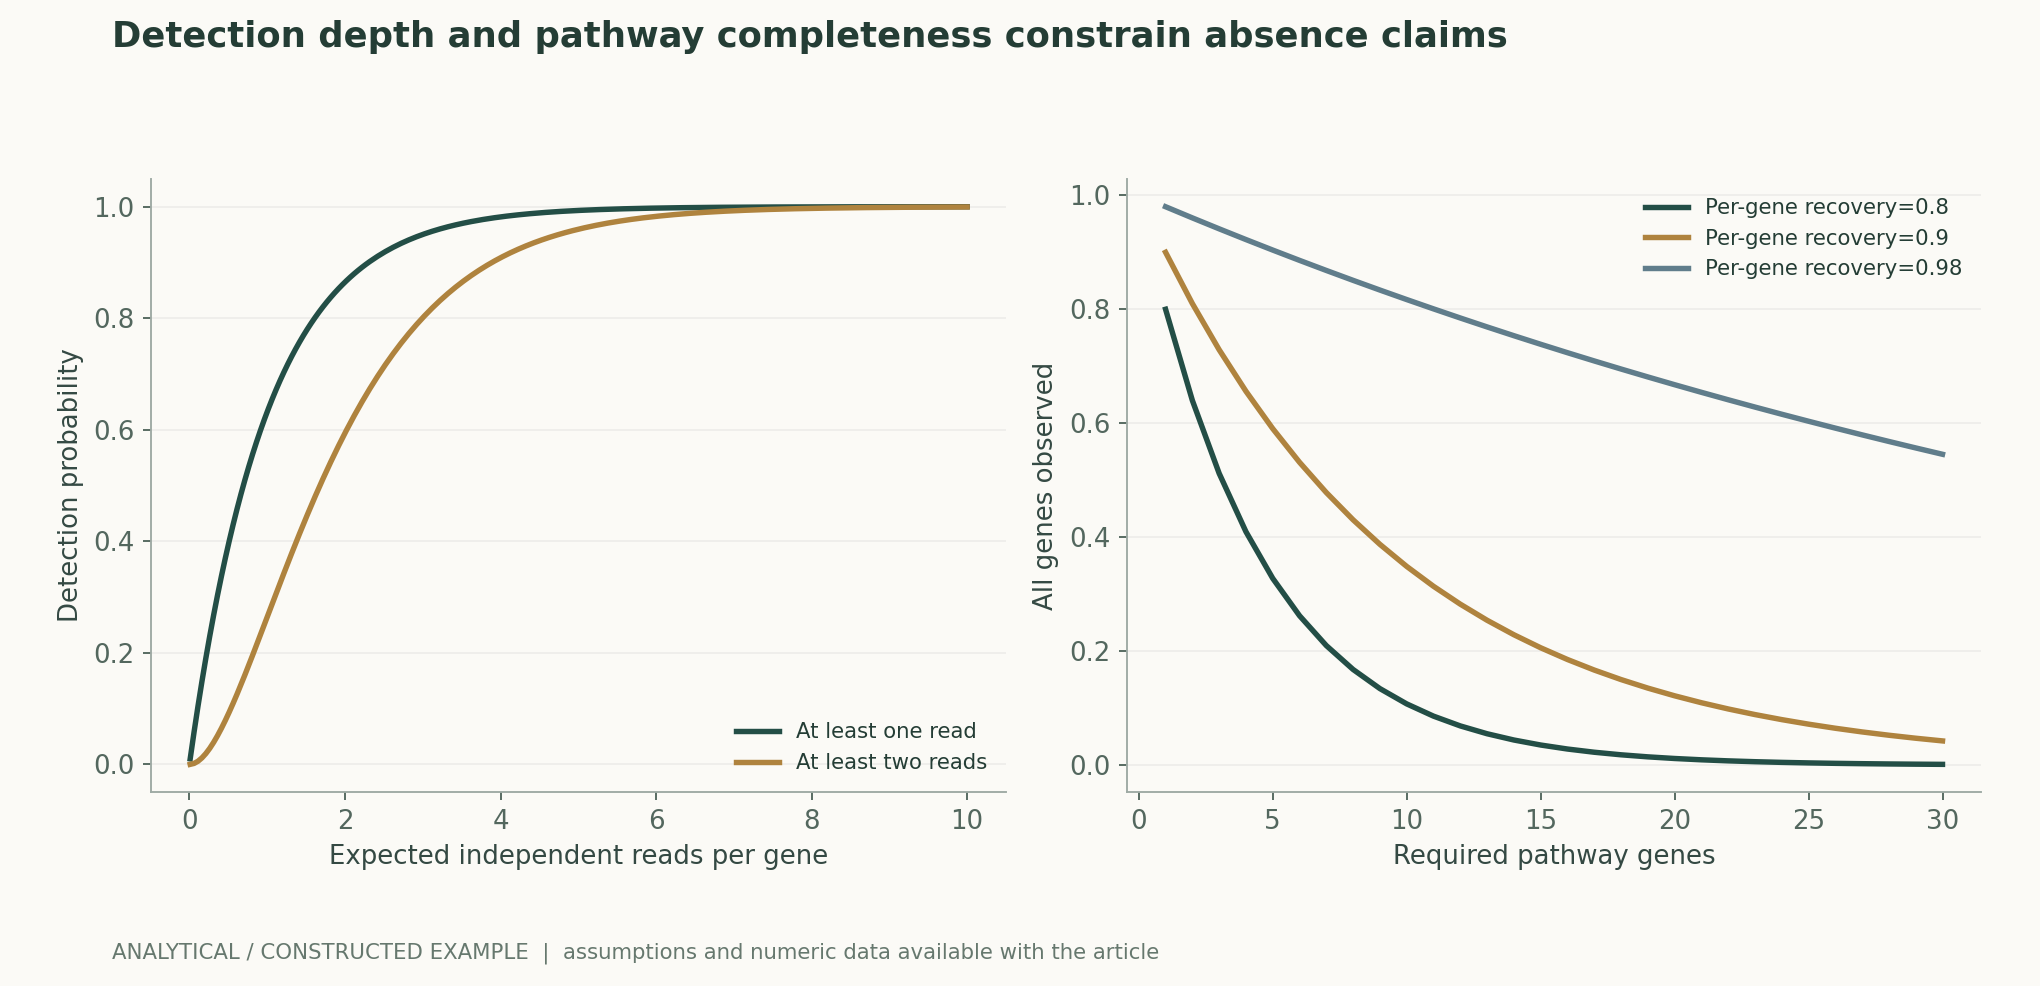
単純化したポアソンモデルでは、ある遺伝子に平均λ本の独立したリードが得られるとき、少なくとも一度検出される確率は1−exp(−λ)である。λが0.5の場合、実際に存在していても、まったく観測されない確率は約60.7%残る。少なくとも二本の支持リードを要求すると、検出確率はさらに低くなる。図が示すのは無作為サンプリングの効果のみであり、実際のアラインメント、多コピー性、抽出バイアスによって結果はさらに変化する。したがって、未検出を直ちに生物学的欠如と判定することはできない。作者分析与复核建议 / Author analysis
アセンブリの被覆と機能の欠如
一つの経路には複数の遺伝子が必要であり、個々の遺伝子の回収確率が比較的高くても、必要な構成要素数が増えるにつれて、すべてを回収できる確率は低下する。独立かつ同一確率を仮定した構成モデルでは、十個の遺伝子それぞれの回収確率が90%の場合、完全に観測できる確率は約34.9%となる。これは実際の経路完全率ではなく、「一つの欠落」がアセンブリの不完全さに由来し得ることを示すものである。逆に、ビンの汚染は、異なる生物の遺伝子を見かけ上完全な機能へと組み合わせることもある。作者分析与复核建议 / Author analysis
ビニングの境界が生物学的対象を規定する
メタゲノムから組み立てられたゲノムは通常、混合集団から再構築された複合的な対象であり、単一の分離培養株に対応するとは限らない。近縁株、可動性因子、反復配列は、その境界を曖昧にする。評価では、完全性、汚染指標、およびこれらの指標では捉えられない構造的な混合を併せて報告すべきである。単一の品質スコアだけで順位付けすると、異なる種類の誤差が同じ数値に圧縮され、後の機能解釈に必要な情報が失われる可能性がある。作者分析与复核建议 / Author analysis
非冗長化の閾値は自然界の種の定義ではない
配列類似性に基づくクラスタリングは大規模カタログの整理に役立つが、閾値は操作的な規則である。類似性の基準、アラインメントの被覆率、参照データの版が異なれば、クラスター数も変わり得る。本稿では、クラスタリングのパラメータと代表配列の選択規則を保存し、閾値に対する感度を比較することを推奨する。操作的なクラスターを直ちに独立した生態学的種と呼ぶには、集団、進化、機能に関するさらなる証拠が必要であり、とくに不完全なゲノムが一つしかない場合は候補としての位置付けを維持すべきである。作者分析与复核建议 / Author analysis
新規性には少なくとも三つの階層がある
配列の新規性は既知配列との違いを意味し、構造の新規性はフォールドや構成様式に関わり、機能の新規性は新たな測定可能な作用を必要とする。これらを「未アノテーション」という一つのラベルで同時に証明することはできない。未アノテーションは、短い配列、誤アセンブリ、データベースの被覆不足によっても生じ得る。研究では各階層に独立した指標を提示し、予測は仮説として扱うべきであり、モデルの信頼度を用いて未知を直ちに新機構へ格上げすべきではない。作者分析与复核建议 / Author analysis
AIアノテーションにおける訓練データの漏洩
機能予測モデルは、近縁配列や相同ファミリーを通じて高いテストスコアを得ても、真に未見の機能への外挿は困難な場合がある。この目的の評価には、配列単位の無作為分割では通常不十分である。本稿では、タンパク質ファミリー、系統距離、試料の由来に基づくホールドアウト評価と、訓練データベースの版の開示を推奨する。テスト対象にほぼ同一のアノテーション済み相同配列がすでに存在するなら、その成果は未知機能の発見よりもアノテーションの転移と記述する方が適切である。作者分析与复核建议 / Author analysis
遺伝子の隣接が有用でありながら十分ではない理由
遺伝子の隣接、共出現、環境との関連は機能仮説の妥当性を高め得るが、相関構造は共通の系統、可動性因子、アセンブリ誤差に由来する可能性がある。これらの手掛かりを証拠として用いる際には、系統的な関連性を統制し、試料間での再現を確認すべきである。隣接パターンは直接的な機能測定に代わるものではなく、遺伝子クラスターに必須の構成要素と随伴配列を自動的に区別するものでもない。妥当なモデルは、どのような観測が現在の解釈を覆すのかを説明すべきである。作者分析与复核建议 / Author analysis
存在から発現、そして作用へ
遺伝子の存在は潜在能力を示し、発現は特定条件下での利用を示唆し、タンパク質や代謝物の測定は機能過程をさらに制約する。生態学的効果を論じるには、集団や環境との結び付きも必要である。階層間で結果が一致しないことがあり、その不一致はしばしば有益な情報をもたらす。本稿では、同一試料について各階層の対応関係を保持することを推奨する。異なる研究で得られた最も強い結果だけをつなぎ、見かけ上は完全でも実際には同一対象で検証されていない証拠の連鎖を作るべきではない。作者分析与复核建议 / Author analysis
環境の代表性が地球規模の結論を制約する
試料がいくつの大陸に由来するかは、各環境、季節、微小生息環境が均等に網羅されていることを意味しない。採取しやすい場所や従来から研究が集中している場所が、データの大半を占める可能性がある。地球規模のカタログの価値は大きいが、未採取の生態的ニッチをモデルの補間によって自動的に埋めることはできない。公表する統計では環境の被覆範囲と欠落を明示し、由来の異なる試料間で回収率を比較し、カタログで少ない分類群を直ちに自然界で希少と呼ぶことを避けるべきである。作者分析与复核建议 / Author analysis
相対存在量と組成効果
メタゲノミクスでは、すべてのリードを総和が一となる比率に正規化することが多い。ある分類群が増加すると、他の分類群の絶対数が変わらなくても、その比率が低下する場合がある。したがって、関連ネットワークは慎重に解釈する必要がある。本稿では、可能な場合は絶対量や外部標準を導入し、正規化規則を比較することを推奨する。相対存在量の負の相関だけでは、競争、抑制、生態的排除を確定できない。モデルには追加の介入または機構に関するデータが必要である。作者分析与复核建议 / Author analysis
検証の優先順位をどう設定するか
候補機能の選択には、新規性、測定可能性、環境上の重要性、不確実性を総合できるが、重みは事前に透明化すべきである。モデルスコアが最も高いものだけを検証すると、モデルの誤りのパターンが長期にわたり見えないままになる。発見過程全体の的中率を推定できるよう、無作為または層別に選択した対照候補を残すべきである。成功例も失敗例もカタログへ戻し、後続モデルが選別後の成功例だけでなく、選択過程全体から学習できるようにすべきである。作者分析与复核建议 / Author analysis
データの版によって結論が変わるとき
参照データの追加により、かつて「未知」とされた配列が既知ファミリーへ再分類されることがある。新たなビニングによって、それまで完全に見えた経路が分解されることもある。したがって、機能アノテーションは配列ダイジェスト、データベースの版、モデルの版に結び付けるべきである。後の訂正では旧記録と訂正理由を保持し、過去の発見を黙って書き換えてはならない。版管理により、新知識による再解釈と元の解析の誤りを区別できる。作者分析与复核建议 / Author analysis
解析例の検証可能な含意
本稿のポアソン検出モデルと独立遺伝子回収モデルは、実際の微生物試料を使用していない。これらは、過度に強い結論を覆す二つの反例を与える。すなわち、存在は検出を保証せず、単一遺伝子の高い回収率は経路全体の可視性を保証しない。再計算では、深度、支持閾値、経路長を変え、結論がどう変化するかを確認できる。実際の応用では、これらの仮定を試料固有の検出モデルに置き換える必要があり、例示曲線をデータベース品質の推定値として扱ってはならない。作者分析与复核建议 / Author analysis
独立に検証可能な研究パッケージの最小構成
法的に許容される試料メタデータ、リードとアセンブリの概要、ビンへの帰属、品質管理指標、アノテーションの版、クラスタリング規則、証拠レベルを保存すべきである。重要な機能仮説については、少なくとも正確な配列と由来試料まで追跡でき、代替解釈を確認できるようにする必要がある。機能名の一覧を共有するだけでは、独立した再検証を支えられない。本稿で公開する資料は解析データ、図、コードであり、新たな微生物培養や機能実験は含まない。作者分析与复核建议 / Author analysis
結論:未知を研究可能な状態に保つ
微生物ダークマターの科学的価値は、未知の名称の数を理解済みの機能として見せることではなく、検証可能な仮説の空間を広げることにある。信頼できる発見の連鎖では、サンプリング、回収、対象の境界、作用の証拠を階層ごとに明示すべきである。AIは順位付けや手掛かりの関連付けを支援できるが、最終的な進展には、予測を明確な対象と再現可能な測定に結び付け、失敗や訂正も公共の知識に取り込むことが依然として必要である。作者分析与复核建议 / Author analysis
主要な数式と導出
(1) 抽出およびアラインメントのバイアスを含まない、単純化した独立リードサンプリング。
LaTeX
P(K\geq1)=1-e^{-\lambda},\qquad K\sim\operatorname{Poisson}(\lambda)(2) 少なくとも二本の支持リードを必要とする場合の検出率。
LaTeX
P(K\geq2)=1-e^{-\lambda}(1+\lambda)(3) m個の構成要素が独立で、回収確率が等しいと仮定したモデル。
LaTeX
P(\mathrm{all\ genes\ recovered})=p^m(4) 組成の正規化。相対存在量の変化だけでは絶対量の変化を確定できない。
LaTeX
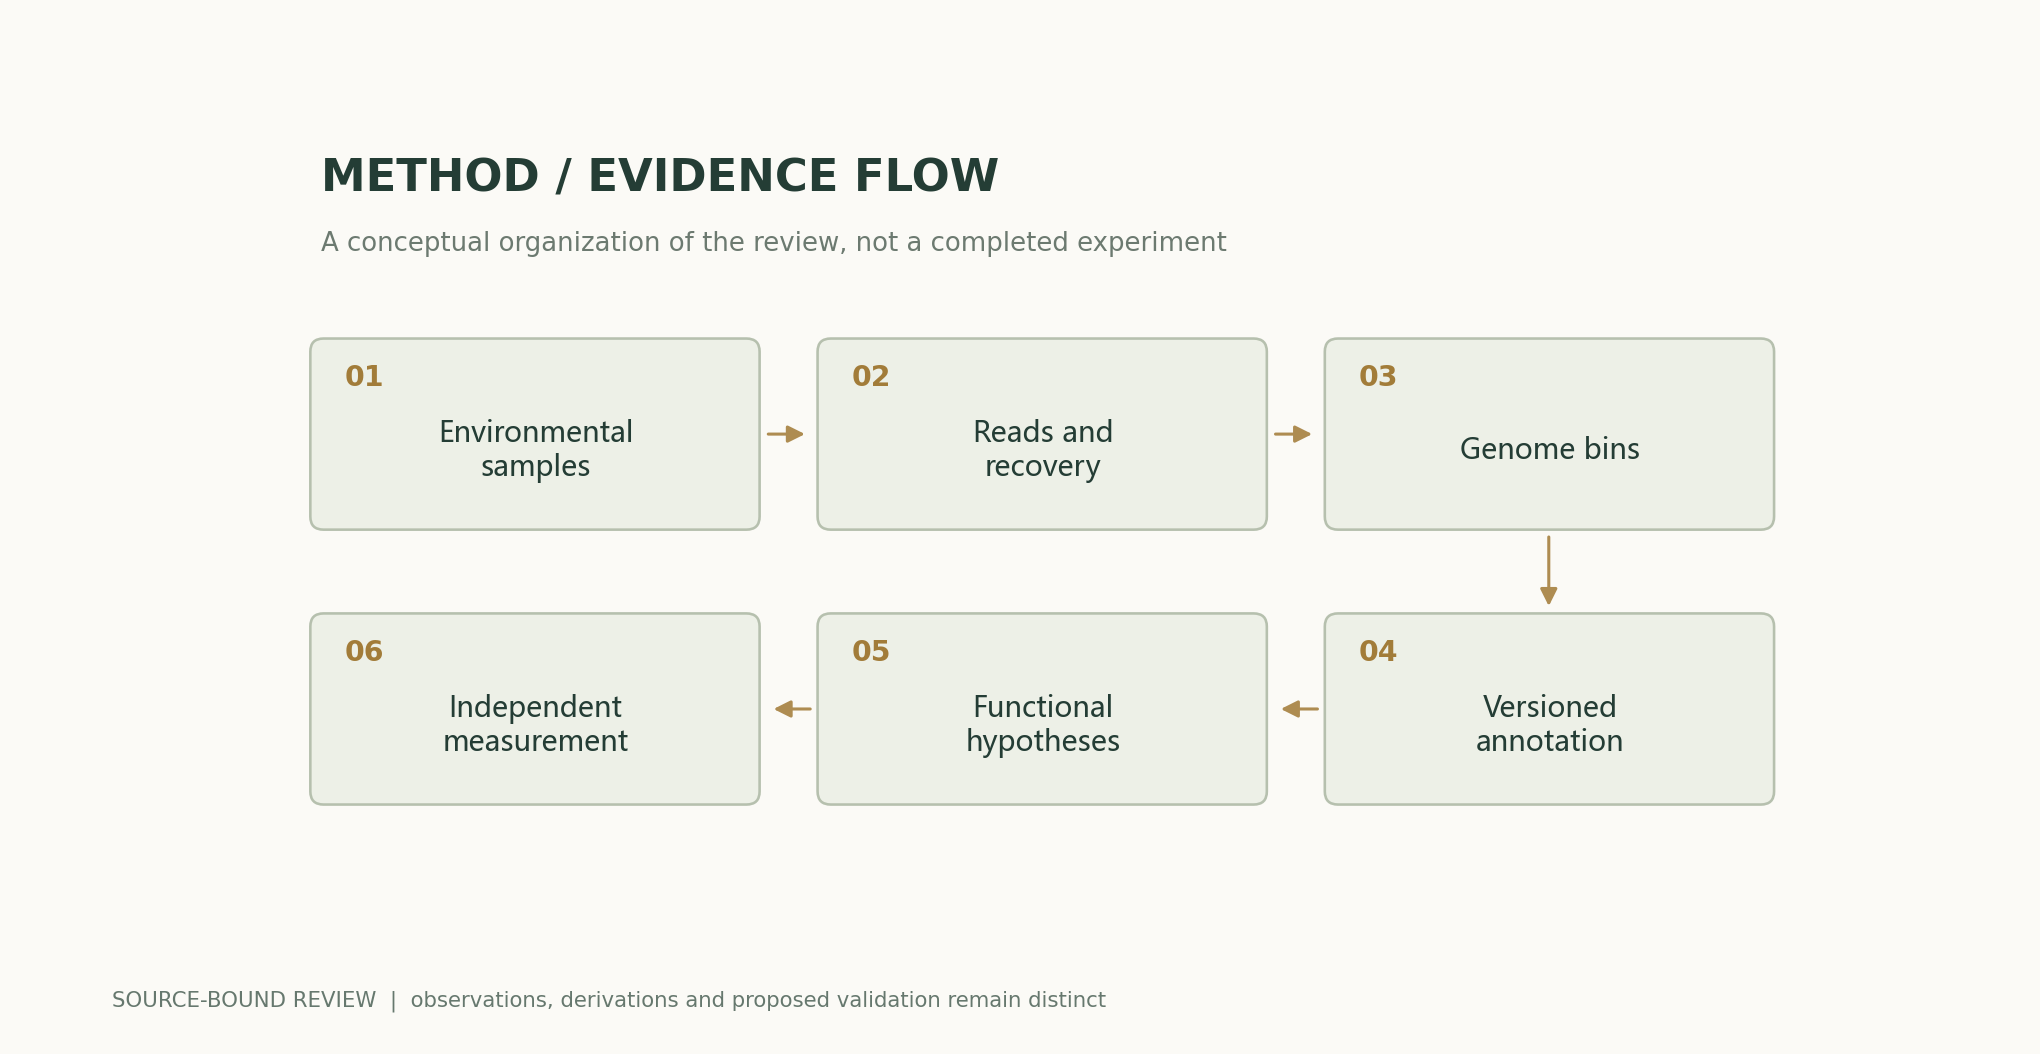
a_i=x_i/\sum_j x_j方法と証拠の流れ
解析図と数値例
再計算可能な例題
lambda=0.5のとき、リードがゼロとなる確率はexp(-0.5)=0.606531である。十個の構成要素がそれぞれ独立に90%の確率で回収される場合、すべてが観測可能となる確率は0.9^10=0.348678である。
方法の比較
| 方法または測定基準 | 直接制約される内容 | なお補うべき証拠 |
|---|---|---|
| 新規配列 | これまで観測されていない配列の差異 | 誤アセンブリとデータベースの欠落 |
| 新規の操作的クラスター | 閾値に基づくグループ化 | 自然界の種の境界 |
| 新たな予測機能 | モデル上の関連 | 作用の直接測定 |
| 完全な経路 | 必要な構成要素の観測 | ビン間の汚染と発現 |
| 環境との関連 | 共出現と分布 | 系統による交絡と因果性 |
| 機能実験 | 特定条件下での作用 | 生態学的背景と転用可能性 |
再検証と実験の計画
- 試料の範囲、許諾、目標とする推定対象を固定する。
- 抽出、深度、リードのフィルタリングを記録する。
- アセンブリとビニングの版、および失敗例を保存する。
- 独立した基準で汚染と完全性を確認する。
- 配列、構造、機能の新規性を別々に標示する。
- ファミリーと由来に基づくホールドアウトでAIアノテーションを評価する。
- 欠落、組成、環境の被覆に対する感度を検証する。
- 正確な配列ダイジェスト、証拠レベル、後続の訂正のためのインターフェースを公開する。
適用範囲と限界
- 新規メタゲノムや機能実験はない。
- ポアソンサンプリングは複数の系統誤差を無視している。
- 経路モデルにおける構成要素の独立性は、通常は成立しない。
- カタログのレコードは独立した種と同義ではない。
- 予測と共出現は、機能および因果の検証に代わるものではない。
原研究の証拠と適用範囲
| 原研究の結果 | 適用範囲 | 出典と該当箇所 |
|---|---|---|
| 地球規模のMAGカタログは、未培養微生物へのアクセス可能な範囲を拡大する。 | 試料と品質閾値による制約がある。訂正後のページを使用。 | 地球のマイクロバイオームのゲノムカタログ要旨;図1–3 |
| UHGGは非冗長な腸内ゲノムおよびタンパク質資源を統合する。 | カタログおよびアノテーション資源であり、各項目の機能実験と同義ではない。 | ヒト腸内マイクロバイオーム由来の204,938参照ゲノムの統合カタログ要旨;カタログの構築 |
検証に値する研究課題
- アセンブリにおける欠落は、経路の存在に関する事後確率に基づく判断をどのように変えるか。
- 未見ファミリーに対するAIの機能スコアは較正できるか。
- どの環境のサンプリングが、実際の機能情報を最も増やすか。
一次資料と主張の対応
- A genomic catalog of Earth’s microbiomesStephen Nayfach, Simon Roux, Rekha Seshadri, Daniel Udwary, Neha Varghese, Frederik Schulz, et al. · 2020-11-09Abstract; Figs. 1–3; encoded functional potential
- A unified catalog of 204,938 reference genomes from the human gut microbiomeAlexandre Almeida, Stephen Nayfach, Miguel Boland, Francesco Strozzi, Martin Beracochea, Zhou Jason Shi, et al. · 2020-07-20Abstract; catalogue construction and clustering
引用と原稿のエクスポート
著者、版、出典
Codex(AI)が執筆した、出典に基づく研究レビューと独自解析である。原論文の実験は原研究チームに帰属し、本稿の計算は記載された数式と明示された仮定のみを検証する。当サイトには現時点で、本稿に対する独立した査読、または本稿の独自のモデル実験、臨床実験、物理実験の記録はない。
初回公開:科学的証拠に関する学際的な詳細特集。節ごとの出典、原研究の証拠、著者による解析の境界を保持する。
概念的な表紙はImageGenが生成した。科学図は付属コードと数値ファイルから作成し、図注で各項目の仮定と測定基準を説明している。
表紙と科学図の出典 · データ、出典、仮定 · Python · 再計算可能なコード · 公開と版の履歴
出典の改訂版: 500575872cce7c4b9c4062a12bb0692eb580c2da