
摘要:目录扩大之后该证明什么
宏基因组把未培养微生物的序列带入研究视野,但一个新基因簇、候选物种或模型预测功能,处于不同证据层级。本文以全球微生物基因组目录和人类肠道统一目录为基础,分析从原始读段到组装、分箱、分类及功能推断的误差。我们提出以“可恢复的基因组信息”和“经过验证的生物学功能”分别记账,避免把数据库规模直接写成机制发现数量。[1] A genomic catalog of Earth’s microbiomes[2] A unified catalog of 204,938 reference genomes from the
English abstract
Genome-resolved metagenomics expands access to uncultivated diversity, yet catalogue size is not functional validation. We analyze detection limits, assembly and binning uncertainty, lineage-aware evaluation and missing pathway components. Poisson sampling and completeness examples show how sequencing depth and genome recovery shape what can be claimed from apparent novelty.
两个大型目录实际提供的资源
Nayfach等汇集不同环境中的宏基因组组装基因组,Almeida等整合人类肠道参考基因组。它们拓展了未培养多样性的可访问范围,并提供比较研究的坐标。本文使用更新后的来源页及其更正提示,不沿用正文与摘要中可能不一致的分类门数,也不把非冗余基因组记录数量直接当作独立物种数量或实验验证数。[1] A genomic catalog of Earth’s microbiomes[2] A unified catalog of 204,938 reference genomes from the
读段不是微生物的无偏缩影
DNA提取效率、片段长度和测序深度会影响每类微生物进入数据的概率。细胞数相同不保证读段数相同,因为基因组大小、拷贝数及样本处理均可能不同。研究应明确估计对象是读段相对丰度、基因组拷贝还是细胞数量。若没有相应校准,从一种口径跳到另一种口径会制造过于精确的生态解释。作者分析与复核建议 / Author analysis
测不到可能只是深度不足
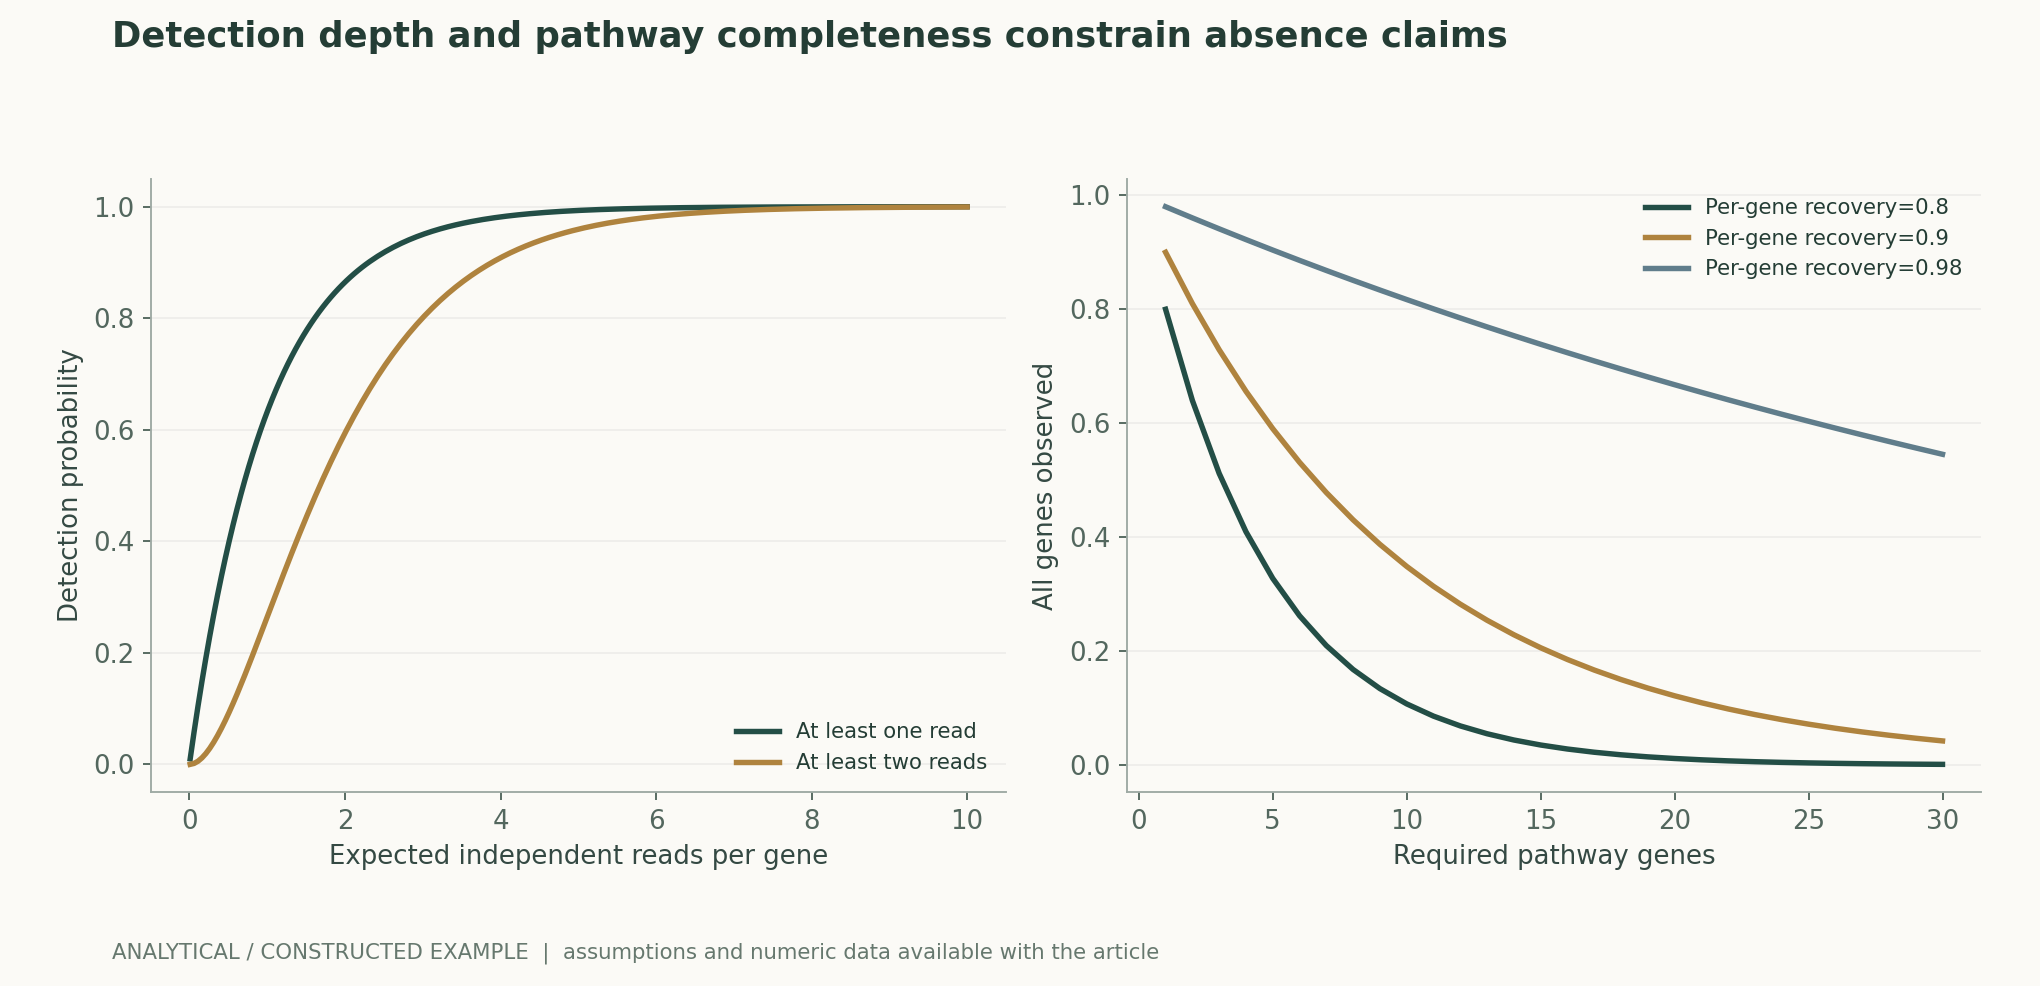
在简化Poisson模型中,某基因平均获得λ条独立读段,至少检出一次的概率为1−exp(−λ)。λ为0.5时,即使真实存在,仍有约60.7%机会完全看不到。要求至少两条支持时,检出概率更低。图中只展示随机取样效应;真实比对、多拷贝与提取偏差会进一步改变结果,因此不能把未检出直接判成生物学缺失。作者分析与复核建议 / Author analysis
组装覆盖与功能缺失
一个途径需要多个基因,单个基因可恢复概率即使较高,全部恢复也会随所需组分数下降。在独立且同概率的构造模型中,十个基因各有90%恢复机会,完整观察概率约34.9%。这不是实际途径完备率,而是说明“缺一环”可能来自组装不完整。反过来,分箱污染也能把来自不同生物的基因拼成貌似完整的功能。作者分析与复核建议 / Author analysis
分箱边界决定生物学对象
宏基因组组装基因组通常是从混合群体中重建的组合对象,不一定对应一个分离培养株。相近菌株、可移动元件和重复序列会使边界模糊。评价应同时报告完整性、污染指标与这些指标无法捕捉的结构混合。只用一个质量分数排序,可能把不同类型误差压成同一数值,失去后续功能解释所需的信息。作者分析与复核建议 / Author analysis
非冗余阈值不是自然物种定义
按序列相似性聚类有助于组织大目录,但阈值是操作性规则。不同相似性、比对覆盖及参考版本可能得到不同簇数。本文建议保存聚类参数和代表选择规则,并比较阈值敏感性。把一个操作性簇直接命名为独立生态物种,需要更多群体、进化与功能证据;尤其在只有单个不完整基因组时应保留候选性质。作者分析与复核建议 / Author analysis
新颖性至少有三个层次
序列新颖意味着与已知序列不同;结构新颖涉及折叠或组织方式;功能新颖则要求新的可测量作用。它们不能由一个“未注释”标签同时证明。未注释也可能来自短序列、错误组装或数据库覆盖不足。研究应为每层提供独立指标,并把预测放在假说栏,而不是用模型置信度把未知直接升级为新机制。作者分析与复核建议 / Author analysis
AI注释的训练泄漏
功能预测模型可能通过近缘序列或同源家族获得很高测试分数,却难以外推到真正未见功能。随机按序列划分通常不足以评估这一目标。本文建议按蛋白家族、系统发育距离与样本来源留出,并披露训练库版本。若测试对象已有近乎相同的已注释同源物,成果更适合描述为注释转移,而非发现未知功能。作者分析与复核建议 / Author analysis
基因邻接为何有用但不充分
相邻基因、共同出现和环境关联可以提高功能假说的合理性,但相关结构可能由共同谱系、移动元件或组装误差造成。将这些线索作为证据时,应控制系统发育相关并查看跨样本重现。邻接模式不能代替直接功能测量,也不能自动区分基因簇的必要组分与伴随序列。一个合理模型应说明哪些观察会推翻当前解释。作者分析与复核建议 / Author analysis
从存在到表达再到作用
基因存在表示潜在能力,表达提示某条件下被使用,蛋白或代谢物测量再约束功能过程;生态效应还需要与群体和环境联系。不同层级可能不一致,而这种不一致往往很有信息。本文建议对同一样本保留各层对应关系,不要把不同研究中各自最强的结果拼接成一条看似完整、实际没有同对象验证的证据链。作者分析与复核建议 / Author analysis
环境代表性限制全球结论
样本来自多少大陆,并不等于各环境、季节和微生境被均匀覆盖。易采集地点和已有研究热点可能占据大部分数据。全球目录的价值很大,但未采样生态位仍不能通过模型插值自动填满。发布统计应列明环境覆盖与缺失,比较不同来源中的恢复率,并避免把目录中少见的类群直接称为自然界稀有。作者分析与复核建议 / Author analysis
相对丰度与组成效应
宏基因组常把所有读段归一化为总和一的比例。当某一类群扩增时,其他类群比例可能下降,即使绝对数量不变。关联网络因此需要谨慎解释。本文建议在可能时加入绝对量或外部标准,并比较归一化规则。仅凭相对丰度的负相关,不能确定竞争、抑制或生态排斥;模型需要额外干预或机制数据。作者分析与复核建议 / Author analysis
验证优先级如何设定
候选功能的选择可以综合新颖度、可测性、环境重要性与不确定性,但权重应预先透明。只验证最高模型分数,会使模型的错误模式长期不可见。应保留随机或分层选择的对照候选,才能估计整个发现流程的命中率。成功案例和失败案例均应回到目录,使后续模型学习的是完整选择过程,而不是被筛选后的赢家。作者分析与复核建议 / Author analysis
数据版本改变结论时
新增参考可能把过去“未知”的序列重新归入已知家族;新的分箱又可能拆解原本貌似完整的途径。因此功能注释应绑定序列摘要、数据库版本和模型版本。后续更正必须保留旧记录与原因,不能静默改写曾经的发现。版本化使研究者能够区分新知识带来的重新解释和原始分析中的错误。作者分析与复核建议 / Author analysis
解析示例的可检验含义
本文的Poisson检测和独立基因恢复模型没有使用真实微生物样本。它们提供两个可推翻过强结论的反例:存在不保证检出,单基因高恢复不保证完整途径可见。复算时可以改变深度、支持阈值及途径长度,检查结论如何变化。真实应用需要以样本特定检测模型替换这些假设,不能把示例曲线当成数据库质量估计。作者分析与复核建议 / Author analysis
可复核研究包的最小内容
应保留样本合法元数据、读段与组装摘要、分箱归属、质控指标、注释版本、聚类规则和证据等级。对关键功能假说,至少允许追踪到准确序列与来源样本,并看见替代解释。仅共享一个功能名称列表无法支持独立复核。本文公开的材料是解析数据、图和代码,不包含新增微生物培养或功能实验。作者分析与复核建议 / Author analysis
结论:让未知保持可研究
微生物暗物质的科学价值在于扩大可检验假说的空间,而不是把未知名字的数量包装成已经理解的功能。可信的发现链应逐层交代取样、恢复、对象边界和作用证据。AI可以帮助排序和关联线索,但最终进展仍需要将预测绑定到明确对象与可重复测量,并让失败和更正同样进入公共知识。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 简化独立读段取样,不包括提取和比对偏差。
LaTeX
P(K\geq1)=1-e^{-\lambda},\qquad K\sim\operatorname{Poisson}(\lambda)(2) 至少两条支持的检出率。
LaTeX
P(K\geq2)=1-e^{-\lambda}(1+\lambda)(3) m个组分独立且恢复率相同的假定模型。
LaTeX
P(\mathrm{all\ genes\ recovered})=p^m(4) 组成归一化;相对丰度变化不能单独确定绝对变化。
LaTeX
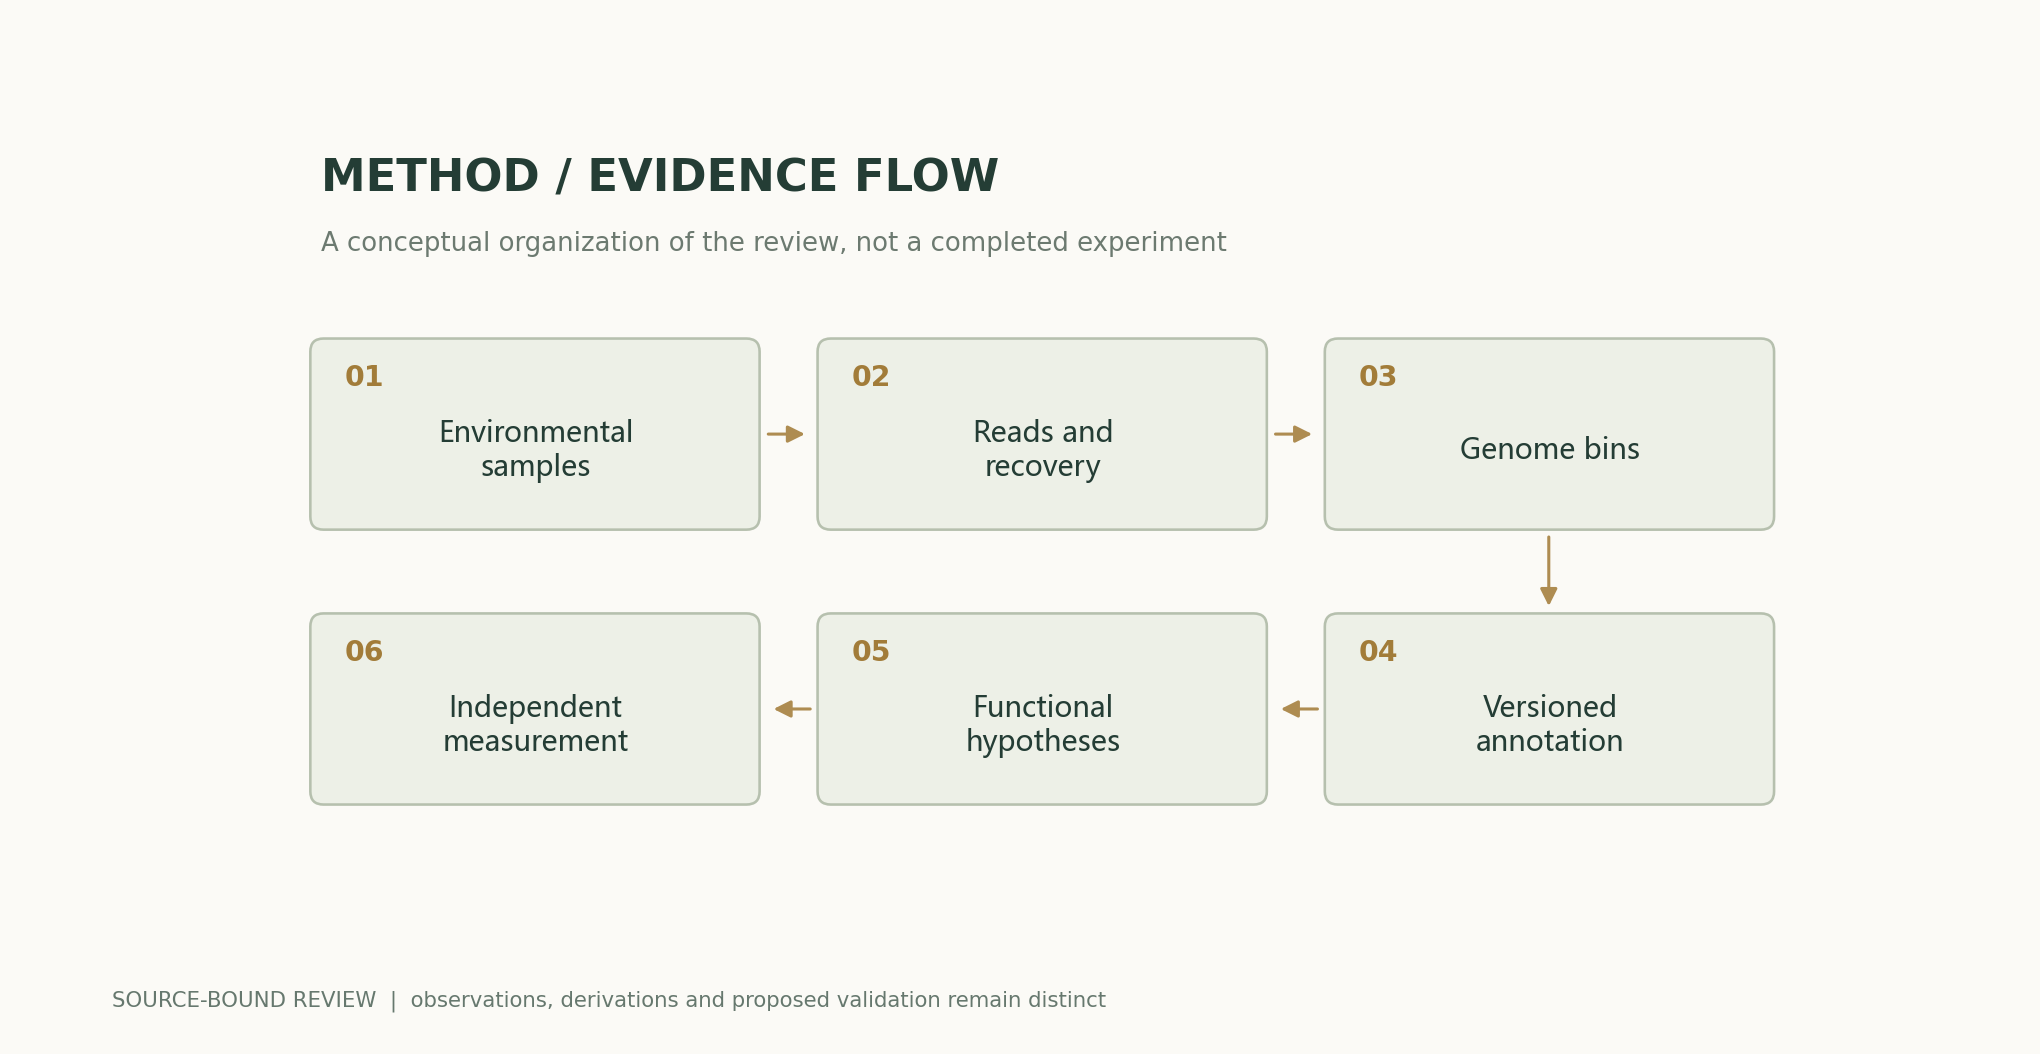
a_i=x_i/\sum_j x_j方法与证据流程
解析图与数值示例
可复算例题
lambda=0.5时零读段概率exp(-0.5)=0.606531。十个组分各独立90%恢复,完整可见概率0.9^10=0.348678。
方法比较
| 方法或口径 | 直接约束 | 仍需补足的证据 |
|---|---|---|
| 新序列 | 未见序列差异 | 错误组装与数据库缺口 |
| 新操作性簇 | 阈值下的分组 | 自然物种边界 |
| 新预测功能 | 模型关联 | 直接作用测量 |
| 完整途径 | 观察到所需组分 | 跨分箱污染与表达 |
| 环境关联 | 共现和分布 | 谱系混杂与因果 |
| 功能实验 | 特定条件中的作用 | 生态背景与可迁移性 |
复核与实验方案
- 固定样本范围、许可和目标估计量。
- 记录提取、深度与读段过滤。
- 保存组装和分箱版本及失败项。
- 以独立标准检查污染与完整性。
- 分开标注序列、结构和功能新颖。
- 按家族与来源留出评价AI注释。
- 检验缺失、组成和环境覆盖敏感性。
- 发布准确序列摘要、证据等级及后续更正接口。
适用范围与局限
- 无新增宏基因组或功能实验。
- Poisson取样忽略多种系统误差。
- 途径模型的组分独立性通常不成立。
- 目录记录不等于独立物种。
- 预测与共现不能代替功能和因果验证。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| 全球MAG目录扩大未培养微生物可访问范围。 | 样本和质量阈值限定;使用更正后页面。 | A genomic catalog of Earth’s microbiomesAbstract; Figs. 1–3 |
| UHGG整合非冗余肠道基因组与蛋白资源。 | 目录和注释资源,不等于逐项功能实验。 | A unified catalog of 204,938 reference genomes from the human gut microbiomeAbstract; catalogue construction |
值得检验的研究问题
- 组装缺失如何改变途径存在的后验判断?
- 未见家族的AI功能分数能否校准?
- 哪些环境采样最能增加真实功能信息?
一手来源与主张对应
- A genomic catalog of Earth’s microbiomesStephen Nayfach, Simon Roux, Rekha Seshadri, Daniel Udwary, Neha Varghese, Frederik Schulz, et al. · 2020-11-09Abstract; Figs. 1–3; encoded functional potential
- A unified catalog of 204,938 reference genomes from the human gut microbiomeAlexandre Almeida, Stephen Nayfach, Miguel Boland, Francesco Strozzi, Martin Beracochea, Zhou Jason Shi, et al. · 2020-07-20Abstract; catalogue construction and clustering
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:跨学科科学证据深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: 500575872cce7c4b9c4062a12bb0692eb580c2da