
要旨
学習型MRI再構成は、事例から学習した統計的構造を用いて、高速収集で欠落した情報を補う。そのため、視覚的にもっともらしい画像にも、測定データによる制約が弱い特徴が含まれうる。本総説は、再構成のデータセットおよびアルゴリズムを零空間解析と結び付け、データ整合性、画像類似度、臨床的忠実度をそれぞれ別個に評価する必要がある理由を示す。
再構成には測定された情報と推論された情報が含まれる
高速MRI収集では、画像を完全に決定するために必要な情報の一部のみをサンプリングする。再構成は、これらの測定と、生じやすい画像に関する仮定を組み合わせる。学習はその仮定を強力なものにしうるが、未測定の成分を直接観察された解剖学的構造に変えるわけではない。小さな特徴が科学的または臨床的に重要な場合、この区別が意味を持つ。
データセット、手法、不安定性
Knollらが記述したfastMRIデータセットは、高速再構成に関する再現可能な研究を支えている。Hammernikらは、MRI再構成のための変分ネットワークを開発した。Antunらは、選択された摂動と分布変化の下で、学習型画像再構成に不安定性が生じることを示した。これらの貢献は、平均的な画像類似度スコアを超えた評価の必要性を示唆する。 [1], [2], [3]
データ整合性には零空間がある
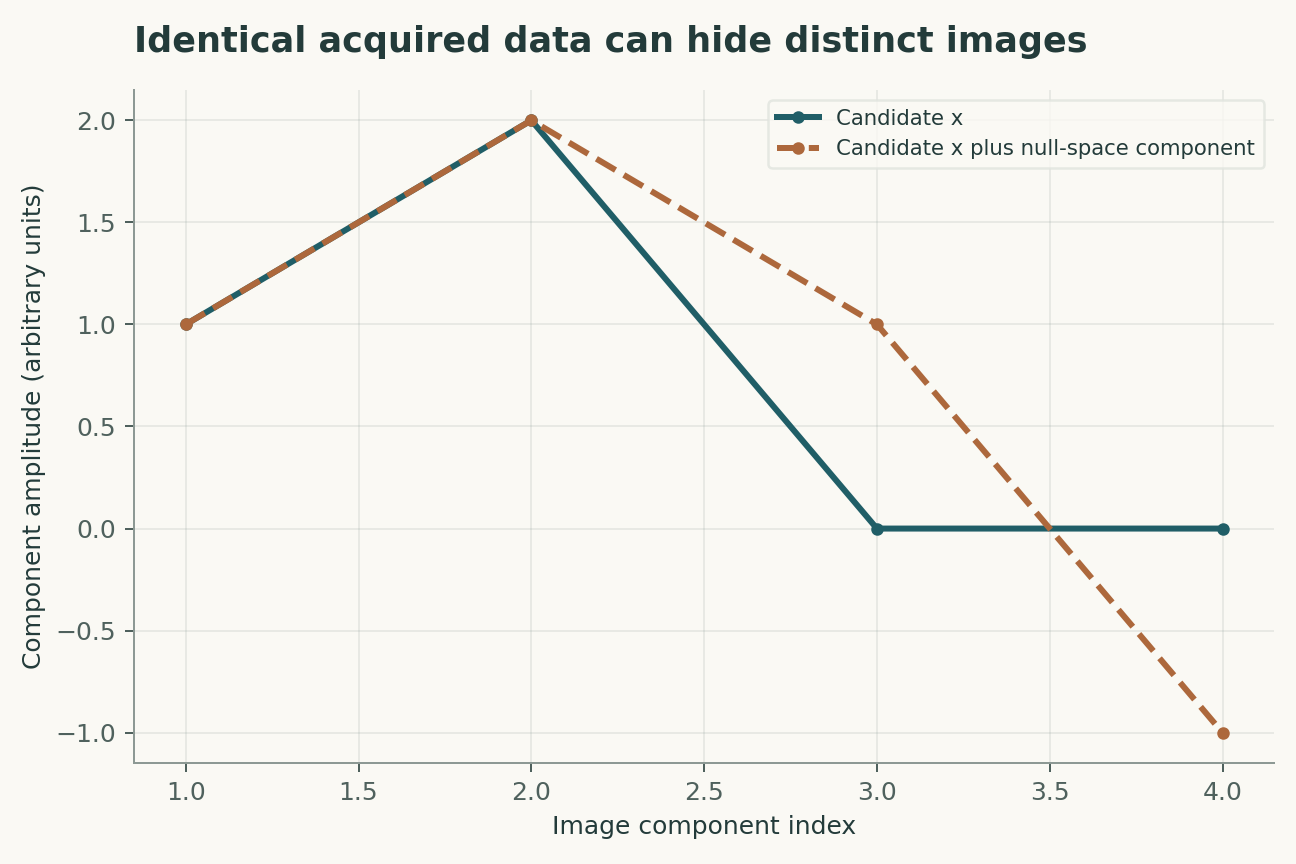
摂動が収集作用素の零空間に属する場合、それを画像に加えても理想的な測定データは変化しない。したがって、異なる二つの画像がいずれも完全なデータ整合性を満たしうる。事前情報は、その両者の間で選択を行う。データ整合性は多くの再構成手法に必要であるが、推論された特徴のすべてが正しいことを証明するには十分ではない。
大域的誤差は小さな病変を見落としうる
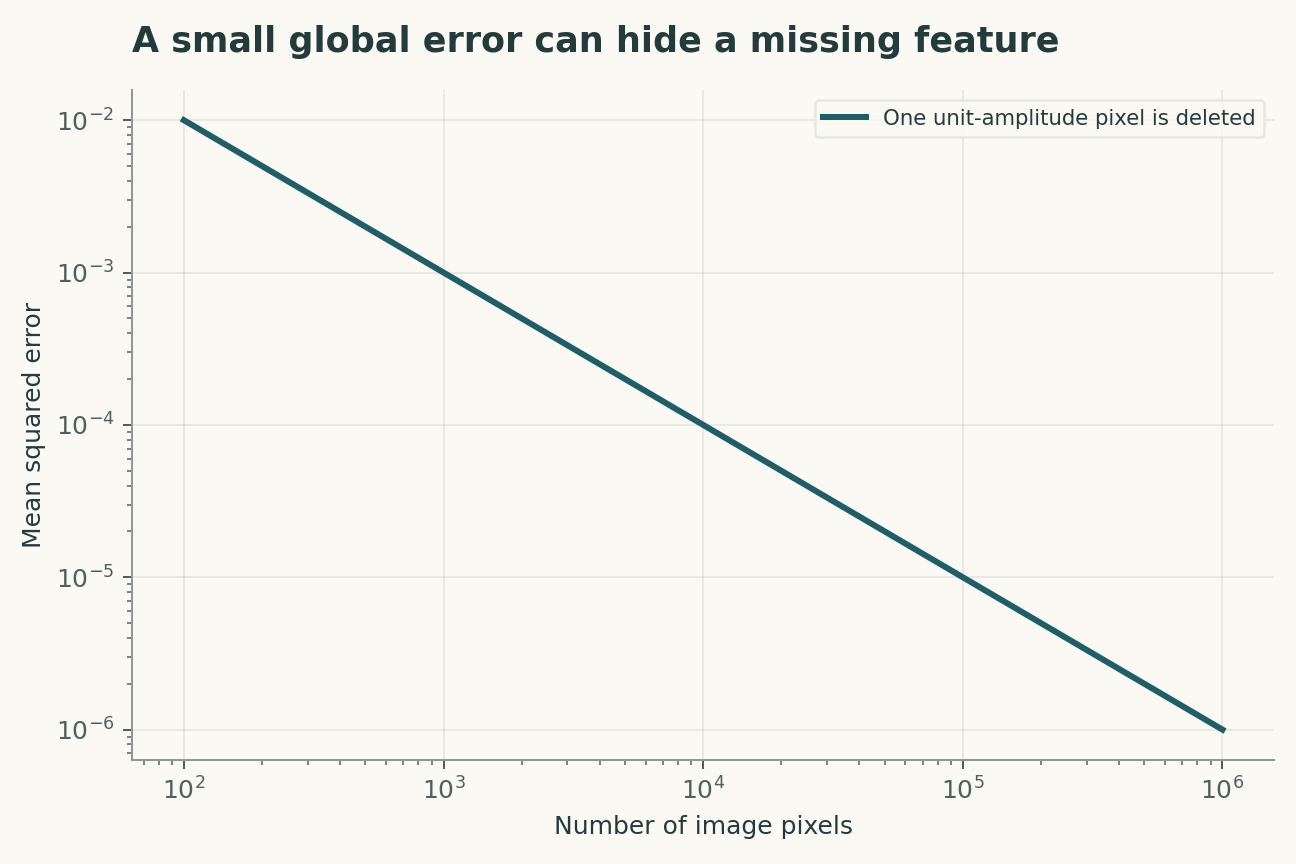
平均二乗誤差は全画素にわたって平均を取る。特に平滑化によって広い背景領域が改善される場合、小さく重要な特徴が除去されても、大域的なスコアはほとんど変化しないことがある。タスクに即した評価では、全体的な忠実度だけでなく、特徴の検出、位置特定、不確実性を検証すべきである。対象となる特徴とその許容誤差は、モデル選択の前に定義する必要がある。
サンプリングマスクは分布を形成する
あるサンプリングパターンで学習したモデルは、異なる高速化率、コイル構成、ノイズレベルに対して異なる応答を示しうる。完全サンプリングされたスキャンから後ろ向きにデータを除去することは有用でありうるが、前向きに実施する高速収集の影響をすべて再現できるとは限らない。どちらの試験形式にも役割があり、それぞれの適用範囲を明示すべきである。
摂動試験には物理的根拠が必要である
敵対的事例は数学的な脆弱性を明らかにするが、実運用に向けた評価には、現実的に生じうる体動、較正誤差、ハードウェアの変動も含めるべきである。ある摂動群に耐えるモデルでも、別の摂動群では失敗しうる。摂動は測定過程を通して伝播させるべきであり、その意味が異なりうる最終画像に加えるだけにとどめるべきではない。
不確実性は誤差に照らして検証しなければならない
複数の再構成や信頼度マップは曖昧さを伝えうるが、その較正には、誤差を評価できる独立した事例が必要である。単一のモデルが生成する狭い分布は、同じ事前情報を繰り返しているだけかもしれない。有意義な検討を支えるためには、未知の収集条件や制約の弱い特徴に対して、不確実性が拡大すべきである。
臨床的忠実度は別個の研究課題である
ベンチマークでの改善は、診断上の安全性を確立するものではない。読影者研究、前向き試験、サブグループ解析は、アルゴリズムによる再構成誤差とは異なる問いを扱う。本総説が提供するのは数学的な評価枠組みであり、臨床的推奨でも、特定のモデルが患者診療に用いるものとして検証済みであるという主張でもない。
データ整合性が制約するのは測定された部分空間のみである
収集作用素に零空間がある場合、その空間内の成分を加えても収集データは変化しない。再構成の事前情報は、そのような整合する画像の中から選択を行う。事前情報が実際の構造を捉えている場合には有用であるが、まれな病変が学習分布の外にある場合には危険である。提案する評価では、収集作用素を適用する前に制御された特徴を挿入し、位置、大きさ、コントラストを変えてその復元を調べる。再構成後に特徴を加える方法が検証するのは表示品質であり、測定情報の復元ではない。四成分の例は曖昧さを厳密に示すものであり、現実的な試験では実際のサンプリングモデルとノイズモデルを用いることになる。
臨床的有用性には特徴レベルの誤差解析が必要である
一画素の計算が示すように、低い平均画像誤差と小構造の欠落は両立しうる。逆に、視覚的に目立つアーチファクトが、特定の定量的タスクにはほとんど影響しない場合もある。提案する評価では、後続の測定または診断タスクを明示し、適切な参照基準と比較し、特徴の種類および患者サブグループ別に誤差を解析する。読影者研究は盲検化し、複数のスライスを別々の症例として数えるのではなく、患者の独立性を保つべきである。目的は大域的な画像指標を置き換えることではなく、画像が保持すべき情報とそれらの指標を結び付けることである。
反証に開かれたモデル
以下の四つの式は簡潔な解析モデルであり、引用したすべての論文に対する同時フィッティングではない。その解釈は次のとおりである。MRI測定値yは、サンプリングとコイル応答を含む収集作用素Aを通じて画像xに依存する。学習された正則化項またはそれと等価な事前情報が、測定された標本を超える情報を補う。零空間内の摂動hは理想的な収集では観測できないため、厳密なデータ整合性によって画像が一意に同定されるわけではない。大域的な二乗誤差は各画素に等しい重みを与えるため、タスクに不可欠な小さな特徴への重みを過小にしうる。
観測の対象は、測定忠実度と、タスクに不可欠な画像特徴の保持である。このモデルは、解析可能な機序を意図的に切り出しており、その目的は、その機序を代替的な機序から区別する測定を明らかにすることである。図中のパラメータ値は、例示用の入力として明示されている。それらの値から生成される曲線は数学的帰結であり、未測定の生物学的または物理的な量の推定ではない。
識別力のある検証設計
主要な比較では、物理的に妥当な収集時の摂動の下で、特徴の保持を検証すべきである。独立反復の単位は、独立した患者データ収集である。同一単位からの反復読影は精度を高めるが、独立反復を生み出すものではない。厳密な検証では、閾値の選択や付随要因に対する補正のフィッティングに先立ち、新しいスキャナ、マスク、病態を検証用に取り分ける。特に、収集の零空間と学習分布のシフトは、測定するか、制約するか、感度解析で変化させなければならない。主要な推定値と、その仮定を緩和した際の変化の両方を報告すべきである。最も有利な除外規則を選んだ後にのみ成功するモデルが答えた問いは、事前に固定した規則で評価されたモデルが答える問いとは異なる。
具体的な数値解析
四成分の例では、最初の二成分だけを観測する作用素は、最後の二成分だけが異なる画像を区別できない。どちらも測定データに対する残差はゼロである。これとは別に、10,000画素の画像の一画素を占める単位振幅の特徴を削除しても、MSEの増加は0.0001にすぎない。図は測定上の等価性と局所誤差の希釈を示しており、合成画像を患者のスキャンとして提示してはいない。
これらの計算は、付属のPythonファイルとそのパラメータ表から再現できる。軸ラベルにはモデルの単位を保持し、キャプションでは変化させた量と固定した量を区別している。数値例は依存関係を明らかにするために選んだものであり、公表済みの図の外観を再現するためではない。有用な独立確認として、極限的な場合を評価した後、描画コードを用いずに中間の一点を再計算する方法がある。一致は明示されたモデル内の算術を検証するが、自然がそのモデルに従うことを確立するものではない。
証拠、転用、今後の取り組み
結論の範囲は、収集の零空間と学習分布のシフトによって制限される。新しいスキャナ、マスク、病態への転用には、元の観測への当てはまりを超える証拠が必要である。将来の追試では、生の測定値、較正記録、除外事項、および各結果と対応する解析を結ぶ機械可読なリンクを保存すべきである。以下の証拠表は、選択した各一次研究の貢献を示す。この比較は焦点を絞った叙述的統合であり、系統的レビューでも、その後の証拠をすべて調査したという主張でもない。提案した研究はここでは実施していない。その価値は、否定的な結果が単にベンチマークのスコアを下げるのではなく、明示された説明を制約する点にある。
明示された解析モデル
四つの式と明示的な仮定
(1) MRI測定値yは、サンプリングとコイル応答を含む収集作用素Aを通じて画像xに依存する。
(2) 学習された正則化項またはそれと等価な事前情報が、測定された標本を超える情報を補う。
(3) 零空間内の摂動hは理想的な収集では観測できないため、厳密なデータ整合性によって画像が一意に同定されるわけではない。
(4) 大域的な二乗誤差は各画素に等しい重みを与えるため、タスクに不可欠な小さな特徴への重みを過小にしうる。
構成した例 · 再現可能なデータ
定量的な論拠を検証する
これらの曲線は、明示されたモデルから計算したものである。引用した研究からの観測値ではない。各図には数値データとベクター版が含まれる。


どの証拠がどの問いに答えるのか
| 証拠または設計上の選択 | 明らかにすること | 未解決のまま残ること |
|---|---|---|
| 出典1 | fastMRIは、高速再構成に関する再現可能な研究のためのデータセットを提供した。 | データセット上の性能は、臨床導入の妥当性を確立するものではない。 |
| 出典2 | 変分ネットワークがMRI再構成の手続きを学習した。 | 学習時の収集条件と対象集団が、学習される分布を規定する。 |
| 出典3 | 不安定性解析は、選択された摂動の下での失敗様式を示した。 | この結果は、あらゆるモデルについて一括した主張を行うのではなく、より広範な試験を行う動機となる。 |
| 主要観測量 | 測定忠実度と、タスクに不可欠な画像特徴の保持 | 収集の零空間と学習分布のシフト |
| 独立した試験 | 物理的に妥当な収集時の摂動の下での特徴の保持 | 新たな測定が必要 |
| 転用評価用データセット | 新しいスキャナ、マスク、病態 | 構成した数値例によって検証されたものではない |
提案する検証プロトコル
これは提案段階の評価設計である。本記事のために、新たな生物学的実験、臨床試験、物理実験は実施していない。
- フィッティング前に、測定忠実度とタスクに不可欠な画像特徴の保持について規定する。
- 独立した各患者データ収集に、個別の識別子を保持する。
- 新しいスキャナ、マスク、病態をモデル開発から分離する。
- 収集の零空間と学習分布のシフトを測定するか、その範囲を定める。
- 単位、較正、観測作用素を記録する。
- 主要モデルを、名称を明示した競合する説明と比較する。
- 試験を事前規定する:物理的に妥当な収集時の摂動の下での特徴の保持。
- 生データ、除外事項、パラメータファイル、実行可能な解析を保存する。
一次資料が確立していること
Florian Knoll, Jure Zbontar, Anuroop Sriram et al. · 2020 [1]
貢献。 fastMRIは、高速再構成に関する再現可能な研究のためのデータセットを提供した。
適用範囲の限界。 データセット上の性能は、臨床導入の妥当性を確立するものではない。
出典内の参照箇所。 要旨/一次資料の選択された節。リンク先の書誌記録を参照。
Kerstin Hammernik, Teresa Klatzer, Erich Kobler et al. · 2017 [2]
貢献。 変分ネットワークがMRI再構成の手続きを学習した。
適用範囲の限界。 学習時の収集条件と対象集団が、学習される分布を規定する。
出典内の参照箇所。 要旨/一次資料の選択された節。リンク先の書誌記録を参照。
Vegard Antun, Francesco Renna, Clarice Poon et al. · 2020 [3]
貢献。 不安定性解析は、選択された摂動の下での失敗様式を示した。
適用範囲の限界。 この結果は、あらゆるモデルについて一括した主張を行うのではなく、より広範な試験を行う動機となる。
出典内の参照箇所。 要旨/一次資料の選択された節。リンク先の書誌記録を参照。
本解析の限界
- データセット上の性能は、臨床導入の妥当性を確立するものではない。
- 学習時の収集条件と対象集団が、学習される分布を規定する。
- この結果は、あらゆるモデルについて一括した主張を行うのではなく、より広範な試験を行う動機となる。
- 付属の図は構成した解析例であり、新たな実験結果ではない。
- 本総説は、新しいスキャナ、マスク、病態への転用を実証していない。
指定した一次研究に焦点を絞った叙述的解析であり、系統的な文献検索でも、2026年までを網羅的に扱ったという主張でもない。
結論を変えうる問い
- どのような収集条件の変化によって、信頼度の較正が不適切になるのか。
- 大域的な画像類似度を補完する特徴レベルの指標は何か。
- 前向き検証によって、再構成誤差と収集誤差をどのように分離できるか。
参考文献
- Florian Knoll, Jure Zbontar, Anuroop Sriram et al.. fastMRI: A Publicly Available Raw k-Space and DICOM Dataset of Knee Images for Accelerated MR Image Reconstruction Using Machine Learning. Radiology: Artificial Intelligence (2020). 10.1148/ryai.2020190007.
- Kerstin Hammernik, Teresa Klatzer, Erich Kobler et al.. Learning a variational network for reconstruction of accelerated MRI data. Magnetic Resonance in Medicine (2017). 10.1002/mrm.26977.
- Vegard Antun, Francesco Renna, Clarice Poon et al.. On instabilities of deep learning in image reconstruction and the potential costs of AI. Proceedings of the National Academy of Sciences (2020). 10.1073/pnas.1907377117.
書誌情報の同一性はCrossrefで照合した。解釈にはアクセス可能な一次記録、要旨、選択された本文を用いており、全文および補足的な方法の網羅的な確認は行っていない。
著者と来歴
資料に基づく研究総説と独自の数学的解析は、Codex(AI)が執筆した。引用した実験は、引用先の研究チームによるものである。
概念的な表紙は、内蔵のImageGenツールで作成した。定量的な図は、コードと数値データを伴う、明示的に構成された解析であり、引用論文の測定値ではない。
このローカル草稿には、独立した査読または学術誌での受理の記録はない。