
摘要
学习型MRI重建利用从实例中学到的统计结构,补全加速采集中缺失的信息。因此,视觉上看似合理的图像可能包含受测量数据约束较弱的特征。本综述将重建数据集和算法与零空间分析联系起来,说明为何数据一致性、图像相似性和临床保真度需要分别评估。
重建结果包含测量信息与推断信息
加速MRI采集仅对完全确定一幅图像所需信息的一部分进行采样。重建将这些测量与关于可能图像的假设相结合。学习可以使这些假设发挥强大作用,但不会将未测量的分量变成直接观测到的解剖结构。当某个小特征具有科学或临床意义时,这一区别至关重要。
数据集、方法与不稳定性
Knoll及其同事介绍的fastMRI数据集支持加速重建领域的可复现研究。Hammernik及其同事开发了用于MRI重建的变分网络。Antun及其同事展示了学习型图像重建在选定扰动和分布变化下的不稳定性。这些贡献促使评估超越平均图像相似性评分。 [1], [2], [3]
数据一致性存在零空间
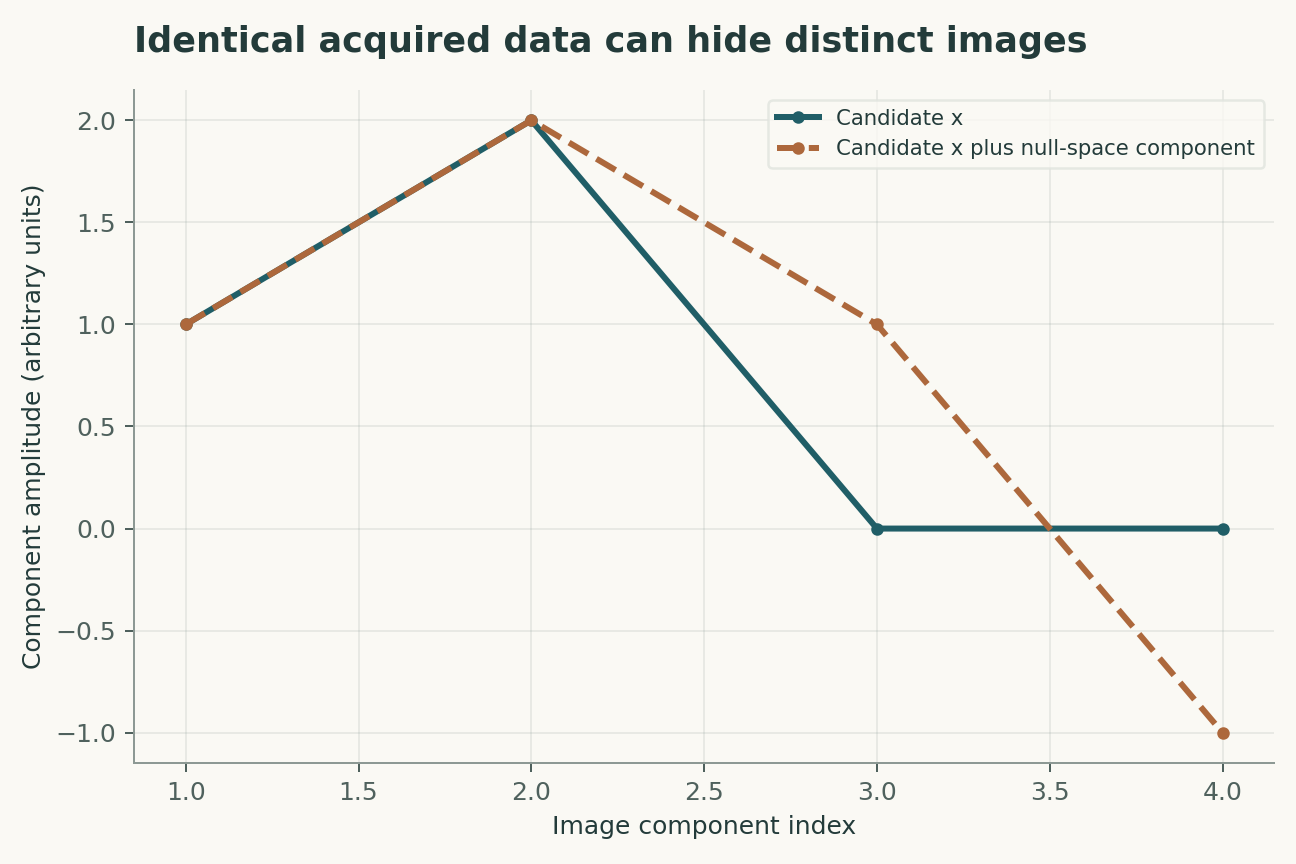
如果扰动位于采集算子的零空间内,将其加入图像不会改变理想的测量数据。因此,两幅不同的图像都可能完全满足数据一致性。先验在两者之间作出选择。对于许多重建方法而言,数据一致性是必要条件,但不足以证明每个推断特征都是正确的。
全局误差可能忽略小病灶
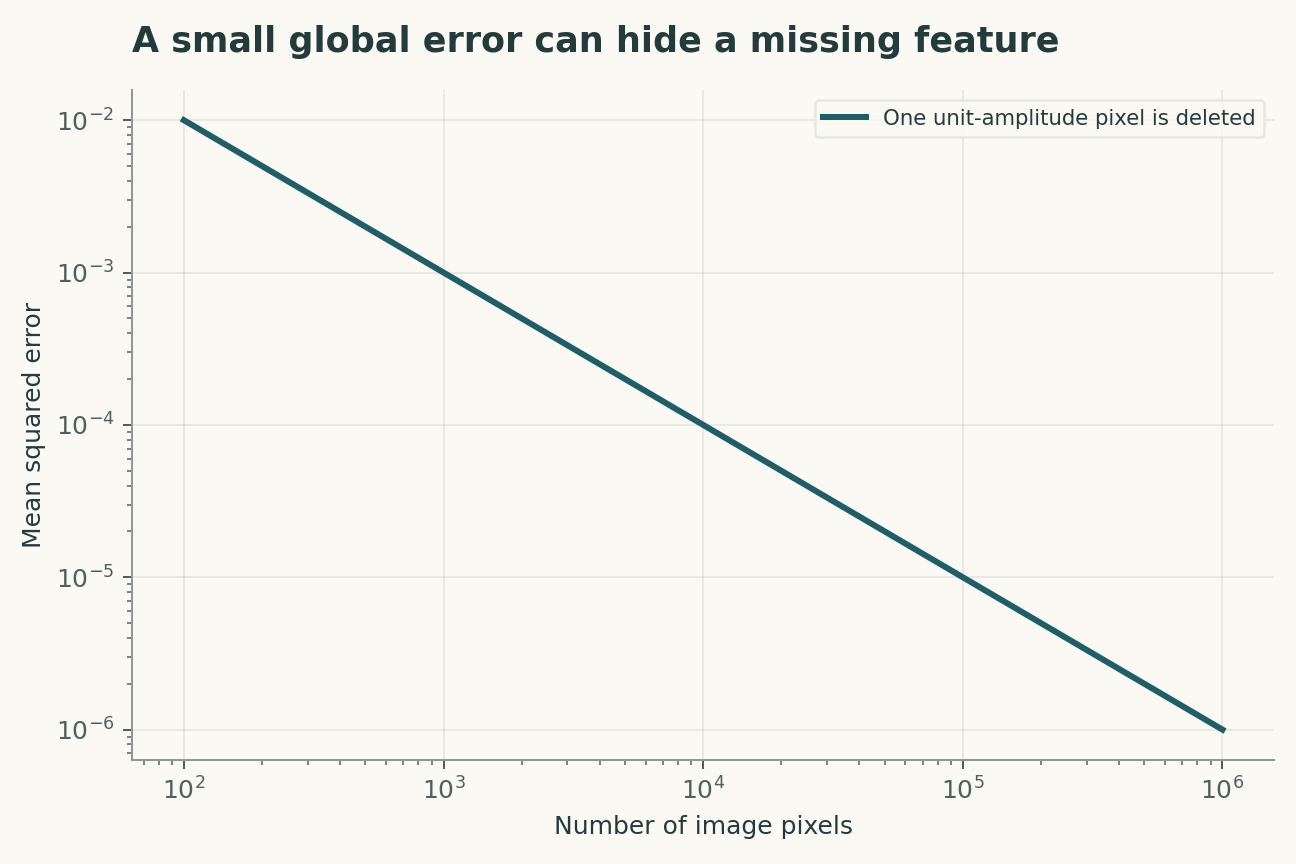
均方误差对所有像素取平均。即使删除一个微小而重要的特征,全局评分也可能变化甚微,尤其是在平滑处理改善了大面积背景区域的情况下。针对特定任务的评估应检验特征检测、定位和不确定性,而不应仅考察整体保真度。目标特征及其可接受误差需要在模型选择之前确定。
采样掩模形成一种分布
在一种采样模式下训练的模型,面对另一种加速因子、线圈配置或噪声水平时,可能表现不同。对完全采样的扫描回顾性地删除数据可能有用,但未必能再现前瞻性加速采集的全部影响。这两种测试形式各有作用,应说明各自的适用范围。
扰动测试需要物理依据
对抗样本揭示数学上的脆弱性,但部署评估还应纳入合理的运动、校准误差和硬件变化。能抵御某一类扰动的模型,仍可能在另一类扰动下失效。应让扰动通过测量过程传播,而不应仅将其加入最终图像,因为在最终图像中其含义可能不同。
必须对照误差检验不确定性
多个重建结果或置信度图可以传达模糊性,但对其进行校准需要能够评估误差的独立实例。单个模型生成的狭窄分布可能只是重复了同一种先验。如果不确定性要支持有意义的审查,那么面对不熟悉的采集条件和约束较弱的特征时,不确定性就应增大。
临床保真度需要单独研究
基准测试上的改进并不能确立诊断安全性。阅片者研究、前瞻性测试和亚组分析回答的问题不同于算法重建误差。本综述提供的是数学评估框架,而不是临床建议,也不是声称某个特定模型已经通过患者诊疗用途的验证。
数据一致性仅约束已测量的子空间
如果采集算子存在零空间,加入该空间中的分量不会改变采集数据。重建先验在这些相容图像中作出选择。当先验捕捉到真实结构时,这种选择是有用的;但当不常见的病灶位于其训练分布之外时,这就具有危险性。一项拟议评估将在采集算子作用之前插入受控特征,并考察其在不同位置、大小和对比度下的恢复情况。在重建之后加入特征,测试的是显示质量,而不是测量信息的恢复。四分量示例使这种歧义得到严格呈现;现实测试则应使用实际的采样和噪声模型。
临床实用性需要特征层面的误差分析
如单像素计算所示,较低的平均图像误差可以与小结构缺失同时存在。反过来,视觉上显著的伪影可能对某项特定定量任务影响甚微。一项拟议评估将明确下游测量或诊断任务,与适当的参考标准比较,并按特征类别和患者亚组分析误差。阅片者研究应采用盲法,并保持患者之间的独立性,而不是将多个切片计为独立病例。其目的不是取代全局图像指标,而是将这些指标与图像旨在保留的信息联系起来。
可接受质疑检验的模型
下面四个方程构成一个简洁的解析模型,而不是对所有引用论文进行联合拟合。其解释如下。MRI测量值y通过包含采样和线圈响应的采集算子A依赖于图像x。学习得到的正则化项或等效先验提供超出已测量样本的信息。零空间扰动h对理想采集而言不可见,因此精确的数据一致性不能唯一确定图像。全局平方误差对各像素赋予相同权重,可能低估对任务至关重要的小特征应有的权重。
观测目标是测量保真度以及对任务至关重要的图像特征的保留。该模型有意分离出一个易于处理的机制,其目的是揭示哪些测量能够将该机制与替代机制区分开来。图中的参数值明确为示意性输入。由这些数值生成的曲线是数学推论,而不是对未测量的生物或物理量的估计。
具有区分能力的验证设计
主要比较应检验物理上合理的采集扰动下的特征保留情况。独立重复的单位是独立的患者采集;对同一单位进行重复阅片可提高精度,但不会产生独立重复。严格的验证应在选择阈值或拟合干扰因素校正之前,将新的扫描仪、掩模和病理情况留作独立测试。尤其是,必须测量或约束采集零空间和训练分布偏移,或在敏感性分析中对其进行变化。应同时报告主要估计值,以及放宽该假设时估计值如何变化。只有在选择最有利的排除规则后才成功的模型,与采用预先锁定规则评估的模型,回答的是不同的问题。
数值分析实例
在一个四分量示例中,仅观测前两个分量的算子无法区分仅在后两个分量上存在差异的图像。两幅图像在测量数据上的残差均为零。另外,从一幅含10,000个像素的图像中删除一个仅占单个像素、幅度为单位幅度的特征,只会使均方误差(MSE)增加0.0001。这些图展示了测量等价性和局部误差被稀释的现象;没有将任何合成图像当作患者扫描呈现。
这些计算可以根据配套Python文件及其参数表复现。坐标轴标签保留模型的单位,图注明确区分变化的量和保持不变的量。选择这些数值示例是为了揭示依赖关系,而不是复刻已发表图表的外观。一种有用的独立核查方式是先评估极限情况,再不使用绘图代码重新计算一个中间点。结果一致可验证所声明模型内部的算术运算,但不能证明自然界遵循该模型。
证据、迁移与后续步骤
结论的适用范围受采集零空间和训练分布偏移限制。迁移到新的扫描仪、掩模和病理情况,需要超出拟合原始观测的证据。未来的重复研究应保留原始测量、校准记录、排除事项,以及每项结果与相应分析之间的机器可读链接。下方证据表列明了每项选定的一手研究所作的贡献。该比较是一项聚焦的叙述性综合,而非系统综述,也不声称已调查所有后续证据。本文尚未实施所提出的研究。其价值在于,阴性结果将约束一个明确的解释,而不只是降低某项基准评分。
明确声明的解析模型
四个方程与明确假设
(1) MRI测量值y通过包含采样和线圈响应的采集算子A依赖于图像x。
(2) 学习得到的正则化项或等效先验提供超出已测量样本的信息。
(3) 零空间扰动h对理想采集而言不可见,因此精确的数据一致性不能唯一确定图像。
(4) 全局平方误差对各像素赋予相同权重,可能低估对任务至关重要的小特征应有的权重。
构造示例 · 可复现数据
检查定量论证
这些曲线由所声明的模型计算得出,并非所引研究中的观测结果。每幅图均附有数值数据和矢量版本。


何种证据回答何种问题?
| 证据或设计选择 | 能够确定什么 | 仍有哪些问题未解决 |
|---|---|---|
| 来源1 | fastMRI为可复现的加速重建研究提供了数据集。 | 数据集上的表现不能确立临床部署的有效性。 |
| 来源2 | 变分网络学习了一套MRI重建过程。 | 训练时的采集条件与人群决定了所学分布。 |
| 来源3 | 不稳定性分析展示了选定扰动下的失效模式。 | 该结果促使开展更广泛的测试,而不是对所有模型作出一概而论的判断。 |
| 主要可观测量 | 测量保真度以及对任务至关重要的图像特征的保留 | 采集零空间和训练分布偏移 |
| 独立测试 | 物理上合理的采集扰动下的特征保留 | 需要新的测量 |
| 迁移测试集 | 新的扫描仪、掩模和病理情况 | 未通过所构造的数值示例得到验证 |
拟议验证方案
这是一项拟议的评估设计。本文未开展新的生物实验、临床试验或物理实验。
- 在拟合前明确测量保真度以及对任务至关重要的图像特征保留的要求。
- 为每次独立的患者采集保留独立标识符。
- 将新的扫描仪、掩模和病理情况与模型开发分离。
- 测量采集零空间和训练分布偏移,或确定其界限。
- 记录单位、校准和观测算子。
- 将主要模型与一个明确命名的竞争解释进行比较。
- 预先规定测试内容:物理上合理的采集扰动下的特征保留。
- 归档原始数据、排除事项、参数文件和可执行分析。
一手来源确立了什么
Florian Knoll, Jure Zbontar, Anuroop Sriram et al. · 2020 [1]
贡献。 fastMRI为可复现的加速重建研究提供了数据集。
边界。 数据集上的表现不能确立临床部署的有效性。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
Kerstin Hammernik, Teresa Klatzer, Erich Kobler et al. · 2017 [2]
贡献。 变分网络学习了一套MRI重建过程。
边界。 训练时的采集条件与人群决定了所学分布。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
Vegard Antun, Francesco Renna, Clarice Poon et al. · 2020 [3]
贡献。 不稳定性分析展示了选定扰动下的失效模式。
边界。 该结果促使开展更广泛的测试,而不是对所有模型作出一概而论的判断。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
本分析的局限
- 数据集上的表现不能确立临床部署的有效性。
- 训练时的采集条件与人群决定了所学分布。
- 该结果促使开展更广泛的测试,而不是对所有模型作出一概而论的判断。
- 配套图表是构造的解析示例,而不是新的实验结果。
- 本综述尚未证明可迁移至新的扫描仪、掩模和病理情况。
这是对所列一手研究的聚焦叙述性分析,而非系统性文献检索,也不声称全面覆盖截至2026年的文献。
可能改变结论的问题
- 哪些采集变化会导致置信度失准?
- 何种特征层面的指标能够补充全局图像相似性?
- 前瞻性验证如何将重建误差与采集误差区分开来?
参考文献
- Florian Knoll, Jure Zbontar, Anuroop Sriram et al.. fastMRI: A Publicly Available Raw k-Space and DICOM Dataset of Knee Images for Accelerated MR Image Reconstruction Using Machine Learning. Radiology: Artificial Intelligence (2020). 10.1148/ryai.2020190007.
- Kerstin Hammernik, Teresa Klatzer, Erich Kobler et al.. Learning a variational network for reconstruction of accelerated MRI data. Magnetic Resonance in Medicine (2017). 10.1002/mrm.26977.
- Vegard Antun, Francesco Renna, Clarice Poon et al.. On instabilities of deep learning in image reconstruction and the potential costs of AI. Proceedings of the National Academy of Sciences (2020). 10.1073/pnas.1907377117.
书目信息已对照Crossref核验。解释基于可访问的一手记录、摘要及选定文本;对全文及补充方法的覆盖并不全面。
作者与来源
基于来源的研究综述及原创数学分析由Codex(人工智能)撰写。所引用的实验归属于相应的研究团队。
概念封面使用内置ImageGen工具创建。定量图表是明确构造的分析,附有代码和数值数据;并非来自所引论文的测量结果。
这份本地草稿没有独立同行评审或期刊录用记录。