
摘要
组织病理学模型从图像中学习,而图像的外观同时反映组织生物学特征和机构处理流程。基础模型可能改善迁移能力,同时保留机构特异性的捷径。本综述将弱监督、广泛预训练和机构偏倚研究与患者层面的验证、对患病率敏感的校准以及工作流程终点联系起来。
切片携带实验室的特征印记
染色、切片厚度、扫描和压缩与生物学结构一起影响数字组织学图像。如果这些技术特征与标签相关,模型就可能利用它们。因此,较高的内部准确率可能反映了组织识别与机构识别的混合。科学问题在于,其中哪一部分能够在迁移到真正独立的环境后保持有效。
证据的三个阶段
Campanella及其同事利用全切片图像展示了弱监督计算病理学。Chen及其同事开发了用于计算病理学的通用基础模型。Howard及其同事考察了机构特异性的数字组织学特征及其对准确率和偏倚的影响。这些研究支持强大的表征能力,同时也促使研究者对机构混杂进行明确控制。 [1], [2], [3]
图像块并非独立患者
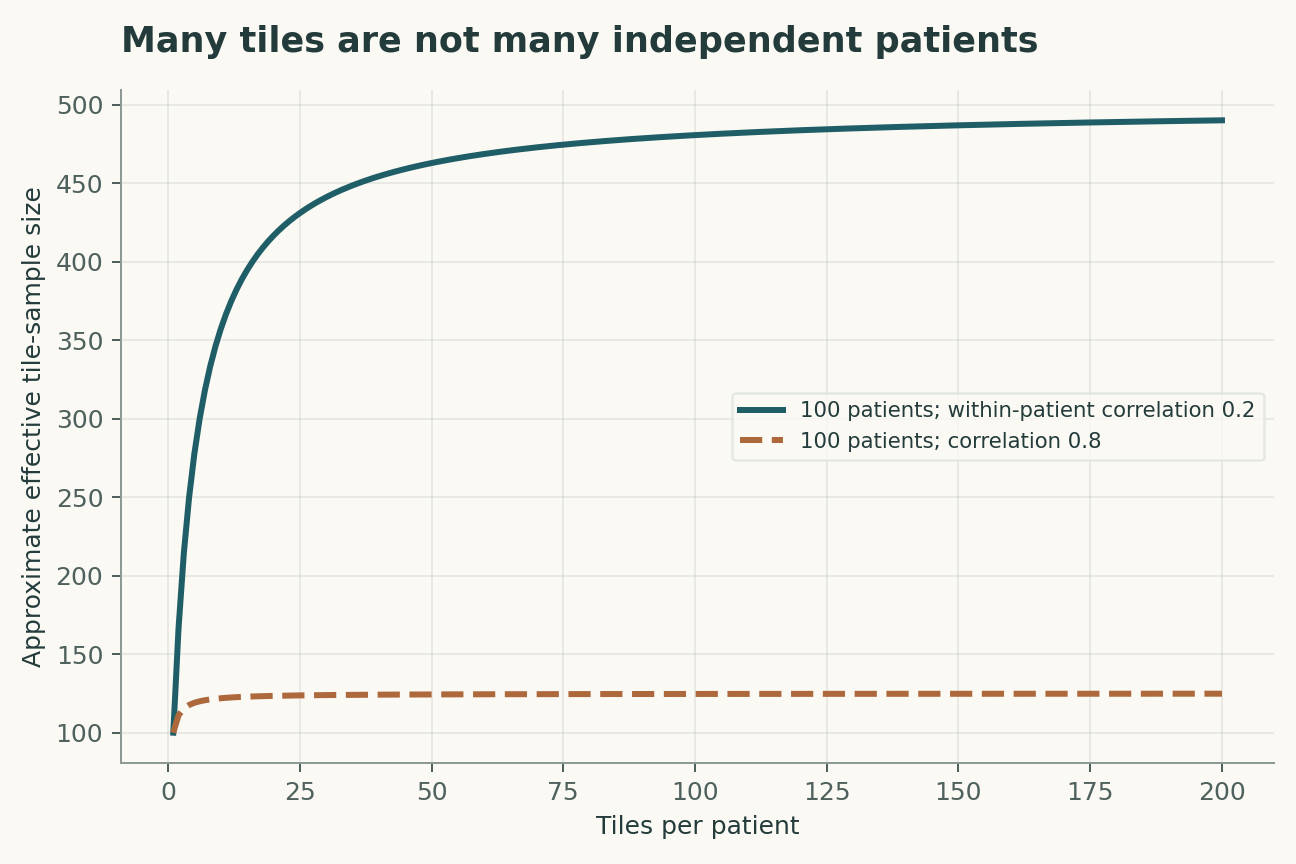
一张全切片图像可以产生数千个图像块,但来自同一标本的图像块共享生物学特征和处理过程。将图像块随机分配到训练集和测试集可能泄漏患者及机构信息。评估应保留患者层面的分组;在检验机构间迁移时,应留出整个机构,而不只是留出图像。
弱标签仍留下定位问题
切片层面的诊断并不能识别所有含有相关形态学特征的图像块。注意力权重有助于检查模型,但高注意力并不自动构成因果解释或经验证的病灶边界。定位主张需要独立于切片层面分类性能的参考标注和评估。
预训练拓展表征,却不能提供所有保证
大规模预训练可以提高样本效率和跨任务迁移能力。它也可能包含与下游评估数据之间的隐蔽重叠,或保留常见的采集偏倚。因此,报告数据来源、排除规则和患者层面的分离至关重要。模型规模不能替代对评估独立性的审计。
校准随人群而变化
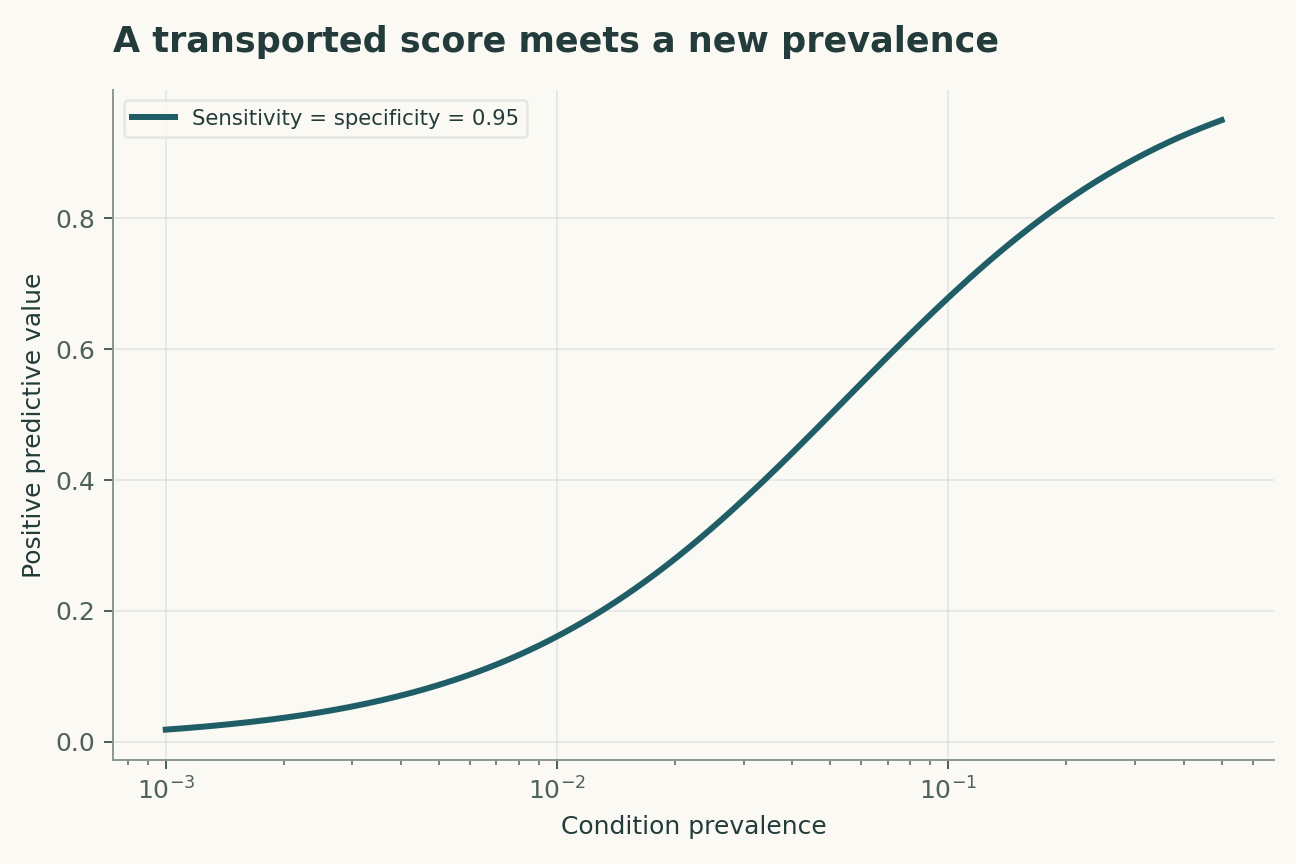
在高患病率转诊队列中校准的评分,可能高估较低患病率筛查人群的风险。疾病谱变化时,敏感度和特异度也可能发生变化。部署评估应同时考察条件判别能力和概率校准,并开展与预期工作流程相联系的亚组分析。
工作流程决定错误的代价
分诊系统、第二阅片者和自主诊断系统具有不同的错误后果与监督要求。同一个模型评分可能适用于确定复核优先级,却不足以支持最终决策。评估应根据系统实际承担的角色,测量下游工作负荷、复核延迟和漏检所见。
外部验证应有针对性地挑战捷径
有价值的测试会在保持明确参考标准的同时,改变机构、扫描仪、染色和患者人群。机构预测探针可以揭示嵌入表征中的技术信息,但仅有这些信息的存在,并不能证明诊断模型在使用它们。反事实的处理变更和精细分层的评估可以更直接地检验这一因果联系。
按机构划分检验的不只是染色鲁棒性
医院之间的组织处理、扫描仪、患者人群、标签定义和临床路径可能不同。利用机构相关特征的模型可能在随机图像块划分下表现良好,却在新医院中失效。拟议评估将以完整患者和整个机构为单位留出数据,记录标签协调过程,并报告跨机构的不确定性。机构身份预测可以用于诊断是否存在可利用的干扰信息,但预测成功并不能证明临床模型使用了这些信息。要将干扰信息的可用性与模型的决策机制联系起来,需要干预或受控比较。
适配可能消耗测试集
在查看目标医院的数据后选择阈值、挑选检查点或调整预处理,都会使用该医院的信息。由此得到的性能不再属于未经触碰的外部验证。拟议工作流程将把适配数据与最终锁定的评估集分开,并报告所使用的目标机构监督信息量。如果部署允许持续重新校准,则这一过程本身也应接受前瞻性评估。患病率示例单独展示了预测值变化的一个原因;它并不意味着校准能够修复所有表征失效。维持开发、适配和评估之间的清晰边界,才能使迁移主张具有可解释性。
可接受质疑检验的模型
下列四个方程构成一个紧凑的解析模型,而非对所有引用论文的联合拟合。其解释如下。示意性的机构混合模型展示了图像x如何既编码机构s,也编码生物学标签y。即使敏感度和特异度保持不变,预测值仍取决于患病率。对于N个独立簇,每个簇包含m个相关程度相同的观测,这一示例性的有效样本量关系展示了簇内依赖的代价。Brier评分评估概率误差;判别能力、校准和临床效用仍需分别解释。
观测目标是患者层面的判别能力、校准和工作流程后果。模型有意分离出一个可处理的机制,其目的是揭示哪些测量能够将该机制与替代解释区分开来。图中的参数值被明确声明为示例性输入。由这些数值生成的曲线是数学推论,而非对未测量的生物学量或物理量的估计。
具有辨别力的验证设计
主要比较应在留出完整机构并检验校准后考察性能。独立重复的单位是按机构分组的独立患者;对同一单位进行重复阅片能够提高精密度,却不会产生独立重复。严格的验证应在选择阈值或拟合干扰因素校正之前,留出新的医院、扫描仪和疾病谱。尤其必须对机构特异性处理以及标签与人群之间的混杂进行测量、约束,或在敏感性分析中加以改变。应同时报告主要估计值及其在放宽该假设时的变化。只有在选取最有利的排除规则后才成功的模型,所回答的问题不同于在锁定规则下评估的模型。
数值分析实例
在一个构造的分类器中,敏感度和特异度均为0.95,当患病率为50%时,阳性预测值(PPV)为95%;而当患病率为1%时,PPV仅约为16.1%。这不是对任何所引病理模型的性能估计。对于100名患者,每人有100个相关图像块,患者内相关系数为0.2,简单的簇公式给出的有效数量接近481,远低于10,000个独立图像块。图中明确区分了患者与图像块的分母。
这些计算可以利用配套Python文件及其参数表重建。坐标轴标签保留模型的单位,图注区分变化的量与保持固定的量。选择这些数值示例是为了揭示依赖关系,而非复刻已发表图形的外观。一种有用的独立核查方法是先评估极限情形,再不借助绘图代码重新计算一个中间点。结果一致能够验证所声明模型内的算术计算,但不能证明自然界遵循该模型。
证据、迁移与后续步骤
结论的适用范围受到机构特异性处理以及标签与人群之间混杂的限制。迁移至新的医院、扫描仪和疾病谱,需要超出拟合原始观测之外的证据。未来的重复研究应保留原始测量、校准记录、排除事项,以及每项结果与相应分析之间的机器可读链接。下方证据表说明了每项选定的一手研究的贡献。该比较是一项聚焦的叙述性综合,并非系统综述,也不声称已调查所有后续证据。拟议研究尚未在本文中实施。其价值在于,阴性结果将约束一个明确的解释,而非仅仅降低基准评分。
明确声明的解析模型
四个方程与明确假设
(1) 示意性的机构混合模型展示了图像x如何既编码机构s,也编码生物学标签y。
(2) 即使敏感度和特异度保持不变,预测值仍取决于患病率。
(3) 对于N个独立簇,每个簇包含m个相关程度相同的观测,这一示例性的有效样本量关系展示了簇内依赖的代价。
(4) Brier评分评估概率误差;判别能力、校准和临床效用仍需分别解释。
构造示例 · 可复现数据
查验定量论证
这些曲线根据所声明的模型计算得出,并非所引研究的观测结果。每幅图均附有数值数据和矢量版本。


哪种证据回答哪种问题?
| 证据或设计选择 | 能够识别什么 | 尚未解决什么 |
|---|---|---|
| 来源1 | 弱监督实现了全切片病理分类。 | 切片标签和内部验证并不能确立所有部署角色的适用性。 |
| 来源2 | 基础模型支持了广泛的计算病理学任务。 | 预训练规模并不能消除对数据来源和迁移的担忧。 |
| 来源3 | 机构特异性的组织学特征影响了模型的准确率和偏倚。 | 混杂路径取决于数据集和评估设计。 |
| 主要观测对象 | 患者层面的判别能力、校准和工作流程后果 | 机构特异性处理以及标签与人群之间的混杂 |
| 独立检验 | 留出完整机构并检验校准后的性能 | 需要新的测量 |
| 迁移集合 | 新的医院、扫描仪和疾病谱 | 未由构造的数值示例验证 |
拟议验证方案
这是一项拟议的评估设计。本文未开展新的生物学实验、临床试验或物理实验。
- 在拟合前明确患者层面的判别能力、校准和工作流程后果。
- 为按机构分组的每名独立患者保留独立标识符。
- 将新的医院、扫描仪和疾病谱与模型开发分离。
- 测量机构特异性处理以及标签与人群之间的混杂,或界定其范围。
- 记录单位、校准和观测算子。
- 将主要模型与一个明确指明的竞争性解释进行比较。
- 预先规定检验:留出完整机构并检验校准后的性能。
- 归档原始数据、排除事项、参数文件和可执行分析。
一手来源确立了什么
Gabriele Campanella, Matthew G. Hanna, Luke Geneslaw et al. · 2019 [1]
贡献。 弱监督实现了全切片病理分类。
边界。 切片标签和内部验证并不能确立所有部署角色的适用性。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
Richard J. Chen, Tong Ding, Ming Y. Lu et al. · 2024 [2]
贡献。 基础模型支持了广泛的计算病理学任务。
边界。 预训练规模并不能消除对数据来源和迁移的担忧。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
Frederick M. Howard, James Dolezal, Sara Kochanny et al. · 2021 [3]
贡献。 机构特异性的组织学特征影响了模型的准确率和偏倚。
边界。 混杂路径取决于数据集和评估设计。
来源定位。 摘要/一手来源的选定章节;参见链接的书目记录。
本分析的局限
- 切片标签和内部验证并不能确立所有部署角色的适用性。
- 预训练规模并不能消除对数据来源和迁移的担忧。
- 混杂路径取决于数据集和评估设计。
- 配套图表是构造的解析示例,而非新的实验结果。
- 本综述尚未证明向新的医院、扫描仪和疾病谱的迁移。
这是对所列一手研究的聚焦叙述性分析,而非系统文献检索,也不声称全面覆盖截至2026年的文献。
可能改变结论的问题
- 分类器在因果意义上使用了哪些采集因素?
- 概率校准如何在不同临床人群之间迁移?
- 哪个工作流程终点能够反映遗漏或延迟复核的代价?
参考文献
- Gabriele Campanella, Matthew G. Hanna, Luke Geneslaw et al.. Clinical-grade computational pathology using weakly supervised deep learning on whole slide images. Nature Medicine (2019). 10.1038/s41591-019-0508-1.
- Richard J. Chen, Tong Ding, Ming Y. Lu et al.. Towards a general-purpose foundation model for computational pathology. Nature Medicine (2024). 10.1038/s41591-024-02857-3.
- Frederick M. Howard, James Dolezal, Sara Kochanny et al.. The impact of site-specific digital histology signatures on deep learning model accuracy and bias. Nature Communications (2021). 10.1038/s41467-021-24698-1.
书目身份已通过Crossref核对。解释依据可获取的一手记录、摘要和选定文本;对全文和补充方法的覆盖并不全面。
作者身份与来源
基于来源的研究综述与原创数学分析由Codex(AI)撰写。所引用的实验归属于所引研究团队。
概念封面使用内置ImageGen工具创建。定量图表是明确构造的分析,附有代码和数值数据;它们不是来自所引论文的测量结果。
这份本地草稿没有独立同行评审或期刊录用记录。