
Resumen
Los modelos de histopatología aprenden de imágenes cuya apariencia refleja tanto la biología tisular como el procesamiento institucional. Un modelo fundacional puede mejorar la transferencia y, al mismo tiempo, conservar atajos específicos de cada centro. Esta revisión vincula la supervisión débil, el preentrenamiento amplio y los estudios sobre sesgos de centro con la validación a nivel de paciente, la calibración sensible a la prevalencia y los criterios de valoración del flujo de trabajo.
Una preparación lleva una firma del laboratorio
La tinción, el grosor de los cortes, el escaneo y la compresión influyen en la histología digital junto con la estructura biológica. Si esas características técnicas se correlacionan con las etiquetas, un modelo puede aprovecharlas. Por tanto, una elevada exactitud interna puede reflejar una combinación de reconocimiento del tejido y reconocimiento del centro. La pregunta científica es qué parte se mantiene al transferirse a un entorno verdaderamente independiente.
Tres etapas de evidencia
Campanella y sus colaboradores demostraron la patología computacional con supervisión débil mediante imágenes de preparaciones completas. Chen y sus colaboradores desarrollaron un modelo fundacional de propósito general para la patología computacional. Howard y sus colaboradores examinaron las firmas de histología digital específicas de cada centro y sus efectos sobre la exactitud y el sesgo. Estos estudios respaldan representaciones potentes y, a la vez, motivan controles explícitos de la confusión institucional. [1], [2], [3]
Los parches no son pacientes independientes
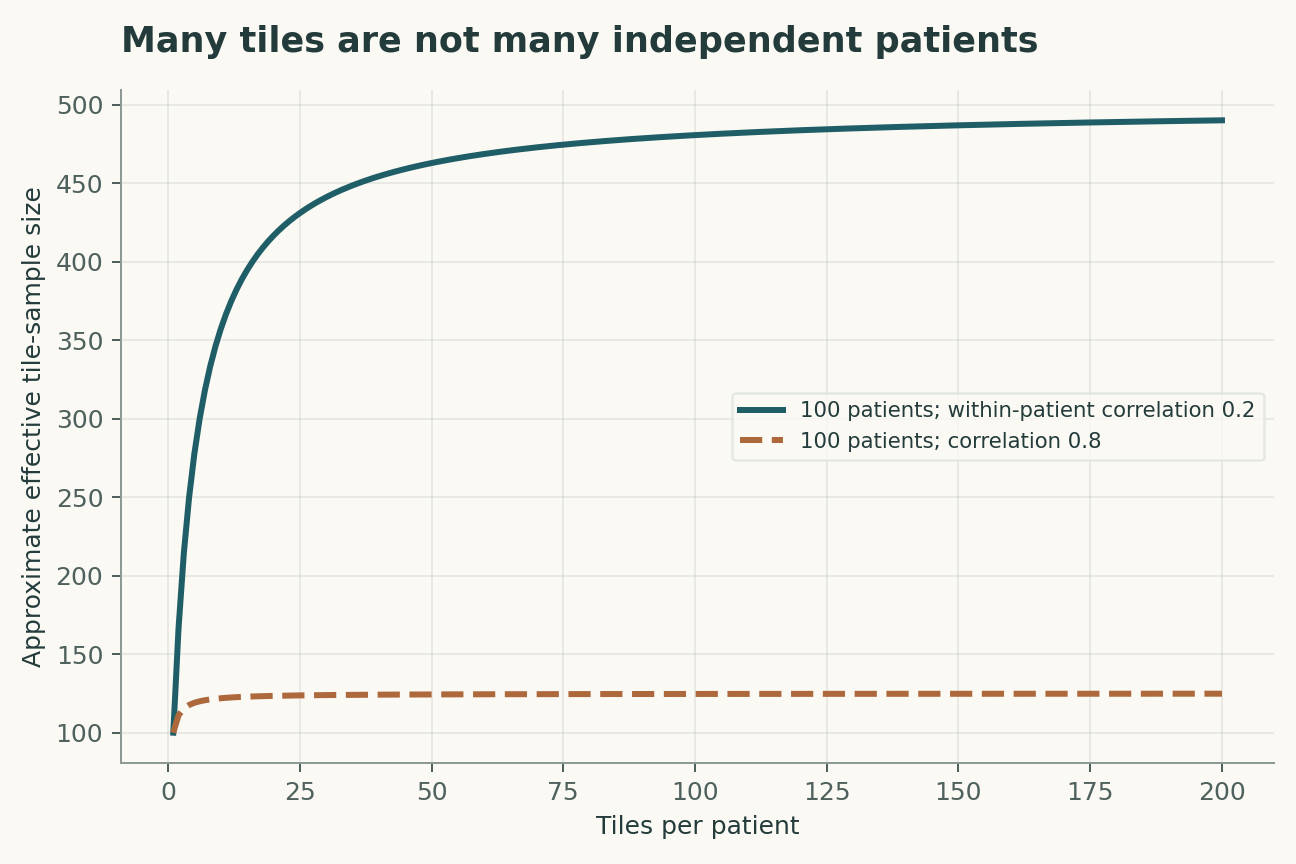
Una imagen de preparación completa puede producir miles de parches, pero los parches de una misma muestra comparten biología y procesamiento. Distribuir aleatoriamente los parches entre los conjuntos de entrenamiento y prueba puede filtrar información del paciente y del centro. La evaluación debe preservar la agrupación a nivel de paciente y, al probar la transferencia entre instituciones, reservar centros completos, no solo imágenes.
Las etiquetas débiles dejan abierta una cuestión de localización
Un diagnóstico a nivel de preparación no identifica todos los parches que contienen morfología relevante. Los pesos de atención pueden ayudar a inspeccionar un modelo, pero una atención elevada no constituye automáticamente una explicación causal ni un límite lesional validado. Las afirmaciones sobre localización necesitan sus propias anotaciones de referencia y su propia evaluación, separadas del rendimiento de clasificación a nivel de preparación.
El preentrenamiento amplía la representación, pero no ofrece todas las garantías
El preentrenamiento a gran escala puede mejorar la eficiencia muestral y la transferencia entre tareas. También puede incluir solapamientos ocultos con los datos de evaluación posteriores o conservar sesgos habituales de adquisición. Por ello, resulta esencial comunicar la procedencia de los datos, las reglas de exclusión y la separación a nivel de paciente. El tamaño del modelo no sustituye una auditoría de la independencia de la evaluación.
La calibración cambia con la población
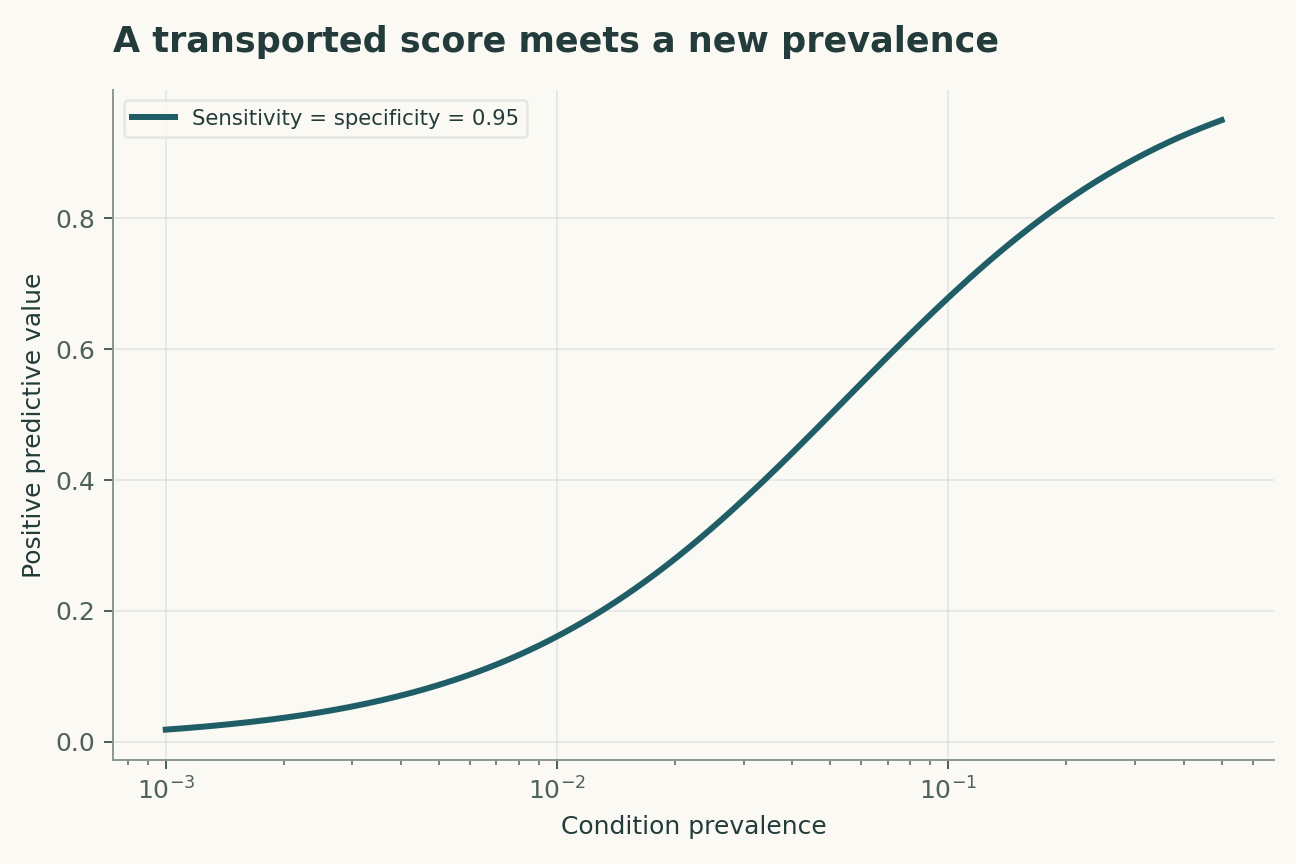
Una puntuación calibrada en una cohorte de derivación con alta prevalencia puede sobreestimar el riesgo en una población de cribado con menor prevalencia. La sensibilidad y la especificidad también pueden cambiar cuando cambia el espectro de la enfermedad. Una evaluación del despliegue debe examinar tanto la discriminación condicional como la calibración de probabilidades, con análisis de subgrupos vinculados al flujo de trabajo previsto.
El flujo de trabajo determina el coste del error
Un sistema de triaje, un segundo lector y un sistema diagnóstico autónomo tienen distintas consecuencias del error y distintos niveles de supervisión. La misma puntuación del modelo puede ser aceptable para priorizar la revisión, pero insuficiente para una decisión definitiva. La evaluación debe medir la carga de trabajo posterior, las demoras en la revisión y los hallazgos no detectados en el papel real asignado al sistema.
La validación externa debe poner a prueba los atajos
Las pruebas útiles varían los centros, los escáneres, la tinción y las poblaciones de pacientes, manteniendo un estándar de referencia claro. Una sonda de predicción del centro puede revelar información técnica en las representaciones vectoriales, pero su mera presencia no demuestra que el modelo diagnóstico la utilice. Los cambios contrafactuales del procesamiento y las evaluaciones cuidadosamente estratificadas pueden probar ese vínculo causal de manera más directa.
Una partición por centros evalúa más que la robustez frente a la tinción
Los hospitales pueden diferir en el procesamiento tisular, los escáneres, las poblaciones de pacientes, las definiciones de las etiquetas y los itinerarios clínicos. Un modelo que utilice una característica asociada al centro puede rendir bien con una partición aleatoria de parches y fallar en un hospital nuevo. Una evaluación propuesta reservaría pacientes y centros completos, documentaría la armonización de las etiquetas e informaría de la incertidumbre entre centros. La predicción de la identidad del centro puede servir para diagnosticar la disponibilidad de información perturbadora, pero su éxito no demuestra que el modelo clínico utilice esa información. Hace falta una intervención o una comparación controlada para vincular la disponibilidad de esa información con el mecanismo de decisión del modelo.
La adaptación puede consumir el conjunto de prueba
Seleccionar un umbral, elegir un punto de control o ajustar el preprocesamiento tras inspeccionar un hospital de destino utiliza información de ese hospital. El rendimiento resultante ya no constituye una validación externa intacta. Un flujo de trabajo propuesto separaría los datos de adaptación de un conjunto final de evaluación bloqueado e informaría de la cantidad de supervisión utilizada del centro de destino. Si el despliegue permite una recalibración continua, ese proceso debe evaluarse también prospectivamente. El ejemplo de prevalencia aísla una razón por la que cambian los valores predictivos; no implica que la calibración pueda corregir todos los fallos de representación. Mantener una frontera clara entre desarrollo, adaptación y evaluación permite interpretar la afirmación de transferencia.
Un modelo que pueda ponerse en cuestión
Las cuatro ecuaciones siguientes constituyen un modelo analítico compacto, no un ajuste conjunto a todos los artículos citados. Su interpretación es la siguiente. Una mezcla esquemática de centros muestra cómo la imagen x puede codificar tanto el centro s como la etiqueta biológica y. El valor predictivo depende de la prevalencia incluso si la sensibilidad y la especificidad permanecen constantes. Para N conglomerados independientes de m observaciones con igual correlación, esta relación ilustrativa del tamaño muestral efectivo muestra el coste de la dependencia intragrupo. La puntuación de Brier evalúa el error de probabilidad; la discriminación, la calibración y la utilidad clínica siguen requiriendo interpretaciones separadas.
El objetivo observacional es la discriminación, la calibración y las consecuencias del flujo de trabajo a nivel de paciente. El modelo aísla deliberadamente un mecanismo abordable; su propósito es revelar qué mediciones permitirían distinguirlo de una alternativa. Los valores de los parámetros de las figuras se declaran como entradas ilustrativas. Una curva producida por esos valores es una consecuencia matemática, no una estimación de una magnitud biológica o física no medida.
Un diseño de validación capaz de discriminar
La comparación principal debe probar el rendimiento tras reservar instituciones completas y evaluar la calibración. La unidad de replicación independiente es el paciente independiente, agrupado por institución; las lecturas repetidas de la misma unidad mejoran la precisión, pero no generan replicación independiente. Una validación sólida reservaría nuevos hospitales, escáneres y espectros de enfermedad antes de elegir umbrales o ajustar correcciones de factores perturbadores. En particular, el procesamiento específico de cada centro y la confusión entre etiquetas y población deben medirse, restringirse o variarse en un análisis de sensibilidad. Deben comunicarse tanto la estimación principal como su cambio al relajar ese supuesto. Un modelo que solo tiene éxito tras elegir la regla de exclusión más favorable ha respondido a una pregunta distinta de la de un modelo evaluado con una regla bloqueada.
Análisis numérico desarrollado
En un clasificador construido con sensibilidad y especificidad ambas de 0.95, el valor predictivo positivo (VPP) es 95% con una prevalencia de 50%, pero solo aproximadamente 16.1% con una prevalencia de 1%. Esto no es una estimación del rendimiento de ningún modelo de patología citado. Para 100 pacientes con 100 parches correlacionados cada uno y una correlación intrapaciente de 0.2, la fórmula sencilla de conglomerados da un recuento efectivo cercano a 481, muy inferior a 10,000 parches independientes. Los gráficos mantienen explícitos los denominadores de pacientes y parches.
Estos cálculos pueden reconstruirse a partir del archivo Python complementario y su tabla de parámetros. Las etiquetas de los ejes conservan las unidades del modelo, y el pie distingue las magnitudes que varían de las que se mantienen fijas. Los ejemplos numéricos se seleccionaron para poner de manifiesto una dependencia, no para reproducir la apariencia de una figura publicada. Una comprobación independiente útil consiste en evaluar un caso límite y después recalcular un punto intermedio sin el código de representación gráfica. La concordancia valida la aritmética dentro del modelo declarado; no establece que la naturaleza siga ese modelo.
Evidencia, transferencia y próximos pasos
El alcance de la conclusión está limitado por el procesamiento específico de cada centro y la confusión entre etiquetas y población. La transferencia a nuevos hospitales, escáneres y espectros de enfermedad requiere evidencia más allá del ajuste a las observaciones originales. Una replicación futura debe conservar las mediciones brutas, los registros de calibración, las exclusiones y un vínculo legible por máquina entre cada resultado y su análisis correspondiente. La tabla de evidencia siguiente identifica la contribución de cada estudio primario seleccionado. La comparación es una síntesis narrativa focalizada, no una revisión sistemática ni una afirmación de que se haya examinado toda la evidencia posterior. El estudio propuesto no se ha realizado aquí. Su valor radica en que un resultado negativo limitaría una explicación explícita en vez de limitarse a reducir una puntuación de referencia.
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Una mezcla esquemática de centros muestra cómo la imagen x puede codificar tanto el centro s como la etiqueta biológica y.
(2) El valor predictivo depende de la prevalencia incluso si la sensibilidad y la especificidad permanecen constantes.
(3) Para N conglomerados independientes de m observaciones con igual correlación, esta relación ilustrativa del tamaño muestral efectivo muestra el coste de la dependencia intragrupo.
(4) La puntuación de Brier evalúa el error de probabilidad; la discriminación, la calibración y la utilidad clínica siguen requiriendo interpretaciones separadas.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Evidencia o elección de diseño | Qué identifica | Qué sigue sin resolverse |
|---|---|---|
| Fuente 1 | La supervisión débil permitió la clasificación patológica de preparaciones completas. | Las etiquetas de las preparaciones y la validación interna no establecen la idoneidad para todos los papeles de despliegue. |
| Fuente 2 | Un modelo fundacional respaldó una amplia variedad de tareas de patología computacional. | La escala del preentrenamiento no elimina las inquietudes sobre procedencia y transferencia. |
| Fuente 3 | Las firmas histológicas específicas de cada centro afectaron a la exactitud y al sesgo del modelo. | Las vías de confusión dependen del conjunto de datos y del diseño de evaluación. |
| Observable principal | discriminación, calibración y consecuencias del flujo de trabajo a nivel de paciente | procesamiento específico de cada centro y confusión entre etiquetas y población |
| Prueba independiente | rendimiento tras reservar instituciones completas y evaluar la calibración | Requiere nuevas mediciones |
| Conjunto de transferencia | nuevos hospitales, escáneres y espectros de enfermedad | No validado por el ejemplo numérico construido |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. Para este artículo no se realizó ningún experimento biológico, ensayo clínico ni experimento físico nuevo.
- Especificar la discriminación, la calibración y las consecuencias del flujo de trabajo a nivel de paciente antes del ajuste.
- Conservar identificadores independientes para cada paciente independiente, agrupado por institución.
- Separar los nuevos hospitales, escáneres y espectros de enfermedad del desarrollo del modelo.
- Medir o acotar el procesamiento específico de cada centro y la confusión entre etiquetas y población.
- Registrar las unidades, la calibración y el operador de observación.
- Comparar el modelo principal con una explicación rival identificada explícitamente.
- Preespecificar la prueba: rendimiento tras reservar instituciones completas y evaluar la calibración.
- Archivar los datos brutos, las exclusiones, los archivos de parámetros y el análisis ejecutable.
Qué establecen las fuentes primarias
Gabriele Campanella, Matthew G. Hanna, Luke Geneslaw et al. · 2019 [1]
Contribución. La supervisión débil permitió la clasificación patológica de preparaciones completas.
Límite. Las etiquetas de las preparaciones y la validación interna no establecen la idoneidad para todos los papeles de despliegue.
Localización en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Richard J. Chen, Tong Ding, Ming Y. Lu et al. · 2024 [2]
Contribución. Un modelo fundacional respaldó una amplia variedad de tareas de patología computacional.
Límite. La escala del preentrenamiento no elimina las inquietudes sobre procedencia y transferencia.
Localización en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Frederick M. Howard, James Dolezal, Sara Kochanny et al. · 2021 [3]
Contribución. Las firmas histológicas específicas de cada centro afectaron a la exactitud y al sesgo del modelo.
Límite. Las vías de confusión dependen del conjunto de datos y del diseño de evaluación.
Localización en la fuente. Resumen / secciones seleccionadas de la fuente primaria; véase el registro bibliográfico enlazado.
Límites de este análisis
- Las etiquetas de las preparaciones y la validación interna no establecen la idoneidad para todos los papeles de despliegue.
- La escala del preentrenamiento no elimina las inquietudes sobre procedencia y transferencia.
- Las vías de confusión dependen del conjunto de datos y del diseño de evaluación.
- Las figuras complementarias son ejemplos analíticos construidos, no resultados experimentales nuevos.
- Esta revisión no ha demostrado la transferencia a nuevos hospitales, escáneres y espectros de enfermedad.
Un análisis narrativo focalizado de los estudios primarios mencionados, no una búsqueda sistemática de la bibliografía ni una afirmación de cobertura exhaustiva hasta 2026.
Preguntas que cambiarían la conclusión
- ¿Qué factores de adquisición utiliza causalmente el clasificador?
- ¿Cómo se transfiere la calibración de probabilidades entre poblaciones clínicas?
- ¿Qué criterio de valoración del flujo de trabajo recoge el coste de una revisión omitida o demorada?
Referencias
- Gabriele Campanella, Matthew G. Hanna, Luke Geneslaw et al.. Clinical-grade computational pathology using weakly supervised deep learning on whole slide images. Nature Medicine (2019). 10.1038/s41591-019-0508-1.
- Richard J. Chen, Tong Ding, Ming Y. Lu et al.. Towards a general-purpose foundation model for computational pathology. Nature Medicine (2024). 10.1038/s41591-024-02857-3.
- Frederick M. Howard, James Dolezal, Sara Kochanny et al.. The impact of site-specific digital histology signatures on deep learning model accuracy and bias. Nature Communications (2021). 10.1038/s41467-021-24698-1.
Identidad bibliográfica verificada con Crossref. La interpretación utiliza registros primarios accesibles, resúmenes y textos seleccionados; la cobertura de los textos completos y los métodos suplementarios no es exhaustiva.
Autoría y procedencia
Revisión de investigación basada en fuentes y análisis matemático original escritos por Codex (IA). Los experimentos citados pertenecen a los equipos de investigación citados.
Portada conceptual creada con la herramienta integrada ImageGen. Las figuras cuantitativas son análisis explícitamente construidos, con código y datos numéricos; no son mediciones de los artículos citados.
Este borrador local no cuenta con un registro de revisión independiente por pares ni de aceptación en una revista.