
الملخص
تتطلب خدمة النماذج اللغوية عبر الإنترنت إدارة حالة KV المتزايدة باستمرار، والطلبات ذات الأطوال المختلفة، وحوسبة الجهاز في آن واحد. يستلهم PagedAttention فكرة التقسيم إلى صفحات، ويربط التسلسلات المنطقية بكتل فيزيائية غير متجاورة، مما يقلل الهدر الناجم عن حجز سعة للطول الأقصى، ويدعم مشاركة الكتل عند توافر الشروط المناسبة. تقارن هذه المقالة الحساب الحتمي للبايتات بين الحجز الثابت والتقسيم إلى صفحات، وتحلل المفاضلات بين حجم الكتلة، ومشاركة البادئات، والنسخ عند الكتابة، والمعالجة الدفعية المستمرة. جميع أطوال التسلسلات في الرسوم مدخلات مُنشأة، ولا تمثل حركة طلبات فعلية أو أداء خدمة فعلياً.[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Fast Inference from Transformers via Speculative Decodi
ترجمة الملخص الإنجليزي
يُحلَّل تخصيص ذاكرة KV المخبئية بالصفحات بصورة مستقلة عن العمليات الحسابية للانتباه. نحسب التجزئة الداخلية لأطوال التسلسلات وأحجام الصفحات المعلنة، ونميّز المشاركة المنطقية عن العمر الفيزيائي، ونصف قياسات تقديم الخدمة في ظل توزيعات واقعية لوصول الطلبات وأطوال المخرجات. لا تتضمن هذه الحسابات اختبارات معيارية لـ vLLM، ولا تدّعي تحقيق تسريع على الجهاز. ويُعد الاسترداد الصحيح، والنسخ عند الكتابة، والإلغاء جزءاً من التقييم المقترح.
1. تمثل KV الحالة المستمرة لكل تسلسل نشط
يجب أن يحتفظ فك الترميز ذاتي الانحدار بالمفاتيح والقيم السابقة، وتزداد السعة المطلوبة مع عدد الطبقات، وطول التسلسل، وعدد رؤوس KV، وبُعد الرأس، والدقة. يغيّر GQA أو MQA عدد رؤوس KV، ولذلك لا يمكن تقدير الذاكرة المخبئية استناداً إلى العدد الإجمالي لمعاملات النموذج وحده. عندما يكون طول التوليد مجهولاً، فإن حجز مساحة متجاورة وفق الطول الأقصى لكل طلب يترك سعة كبيرة غير مستخدمة للطلبات القصيرة. يغيّر التقسيم إلى صفحات تخصيص التخزين وتنظيم الفهرسة؛ ولا يحذف مباشرة المعلومات السابقة التي يتعين على الانتباه قراءتها، ولا يغيّر الحد الأعلى النظري لسياق النموذج.[1] Efficient Memory Management for Large Language Model Se
2. كيفية حساب التجزئة بعد فصل الكتل المنطقية عن الكتل الفيزيائية
يحتاج تسلسل طوله n، مع B من الرموز في كل كتلة، إلى ceil(n/B) من الكتل، وتهدر الكتلة الأخيرة ما لا يزيد على B−1 من المواضع. مقارنةً بالحجز وفق الطول الأقصى M، يمكن لطلبات متعددة استخدام مخزون الكتل نفسه بصورة أكثر تراصاً؛ وتعتمد الفائدة على توزيع الأطوال، لا على B وحده. تقلل الكتل الصغيرة الهدر في النهاية، لكنها تزيد تكاليف جدول الكتل والعنونة والإدارة. تستخدم هذه المقالة الأطوال الخمسة 37 و91 و128 و201 و511 لمقارنة كتل تضم 16 موضعاً وأخرى تضم 32 موضعاً، مع بيان دقيق للمواضع المخصصة والمواضع الفعلية؛ ولا تشمل الحسابات البايتات الإضافية لنوى الجهاز أو جدول الكتل أو المحاذاة.[1] Efficient Memory Management for Large Language Model Se
3. تتطلب مشاركة البادئات شروطاً صارمة للمحتوى والعمر
يمكن للفروع التي تتطابق في النموذج وبادئة الرموز وظروف التشغيل ذات الصلة أن تتشارك الكتل الفيزيائية المحسوبة مسبقاً ضمن تنفيذ مناسب. يجب أن تتوافق عدادات المشاركة مع أعمار الطلبات؛ وعندما يحتاج فرع إلى تعديل كتلة مشتركة غير ممتلئة، يمكن للنسخ عند الكتابة منع الكتابة فوق بيانات الفروع الأخرى. وقد يؤدي الإلغاء أو انتهاء المهلة أو إعادة المحاولة أو دمج الفروع إلى الاسترداد. إن استخدام مفاتيح غير مكتملة أو الاسترداد المبكر قد يحوّل تحسين الموارد إلى أخطاء في المخرجات، بل إلى مشكلات بيانات بين الطلبات. لذلك ينبغي لاختبارات الصحة أن تتحقق من إصدارات المحتوى، وعدادات المراجع، والفترات التي يُحظر فيها إعادة استخدام العناوين، بدلاً من الاكتفاء بفحص انخفاض استهلاك الذاكرة.[1] Efficient Memory Management for Large Language Model Se
4. تغيّر المعالجة الدفعية المستمرة الانتظار بين الطلبات
يمكن للخدمة إضافة طلبات جديدة وإزالة الطلبات المكتملة في كل خطوة، مما يرفع استغلال الجهاز، لكن متطلبات الموارد تختلف بين التعبئة المسبقة وفك الترميز. قد تؤخر التعبئة المسبقة الطويلة الطلبات التي يجري فك ترميزها، وقد تزيد الدفعات الأكبر الإنتاجية مع تدهور زمن استجابة الطلب الفردي. ينبغي تحديد أولويات الجدولة وقواعد الاستباق وترحيل KV بوضوح، والإبلاغ عن زمن الوصول إلى أول رمز، والزمن لكل رمز، وزمن الاستجابة من البداية إلى النهاية، وزمن الاستجابة في ذيل التوزيع. وإذا اقتصرت القياسات على دفعات غير متصلة تصل فيها جميع الطلبات في الوقت نفسه، فلن تمثل عملية الوصول الفعلية أو أهداف الخدمة.[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. يعمل التقسيم إلى صفحات وتحسين الإدخال والإخراج على مستويين مختلفين
ينظم FlashAttention حسابات الانتباه في كتل لتقليل عمليات القراءة والكتابة بين الذاكرة عالية عرض النطاق والتخزين على الشريحة؛ أما تقسيم KV إلى صفحات فيركز على تخصيص الحالة والوصول إليها أثناء تقديم الخدمة. يمكن الجمع بين الآليتين، لكن الاستفادة من الجمع تتطلب دعماً فعلياً من النوى. كما يولّد فك الترميز التخميني مواضع KV للتخزين المؤقت والتراجع، مما يؤثر إضافياً في التخصيص. ينبغي أن يتضمن التقييم دراسات استئصال منفصلة لتحسين المؤثرات، وتخصيص الذاكرة المخبئية، والجدولة، لتجنب عزو الفروق في مكدس الخدمة بأكمله إلى خوارزمية واحدة للتقسيم إلى صفحات.[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] Efficient Memory Management for Large Language Model Se[3] Fast Inference from Transformers via Speculative Decodi
6. يتطلب القبول السليم فرض قيود على الجودة وأهداف الخدمة معاً
بعد تثبيت الأوزان وأخذ العينات، ينبغي أولاً التأكد من أن التقسيم إلى صفحات والمشاركة والاسترداد لم تغيّر دلالات المخرجات، ثم مقارنة الإنتاجية وزمن الاستجابة في ذيل التوزيع تحت توزيع ثابت لوصول الطلبات. وينبغي عند تحليل استغلال الذاكرة التمييز بين KV الفعلي، وتجزئة الكتل الأخيرة، وجدول الكتل، ومساحة العمل، والمخزون المحجوز. ويجب أن تشمل اختبارات الأعطال أيضاً نفاد الذاكرة (OOM)، والإلغاء، والاستئناف بعد الاستباق. تقتصر هذه المقالة على الحساب باستخدام المعادلات، ولا يمكن استنتاج «تسريع بعدة أضعاف» من انخفاض التجزئة؛ إذ تعتمد الفوائد الفعلية على عبء العمل، والنوى، والجهاز، وأهداف الخدمة.[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
المعادلات الأساسية واشتقاقاتها
(1) يرمز b إلى عدد البايتات لكل قيمة قياسية؛ والضرب في 2 يقابل المفتاح والقيمة. لا يشمل ذلك جدول الكتل أو مساحة العمل أو الحشو أو حالات النموذج الأخرى.
LaTeX
M_{\mathrm{KV}}=2Lnh_{\mathrm{KV}}d_hb(2) يمثل A المواضع المخصصة، ويمثل W التجزئة الداخلية في الكتلة الأخيرة؛ أما في الحجز بطول ثابت فالهدر هو M−n.
LaTeX
A_B(n)=B\lceil n/B\rceil,\qquad W_B(n)=A_B(n)-n(3) يحسب استغلال المواضع فقط، ولا يشمل جدول الكتل أو المشاركة أو الجدولة؛ ولا يمكن اعتباره مباشرةً استغلالاً للجهاز.
LaTeX
U=\frac{\sum_i n_i}{\sum_i B\lceil n_i/B\rceil}مسار المنهجية والأدلة
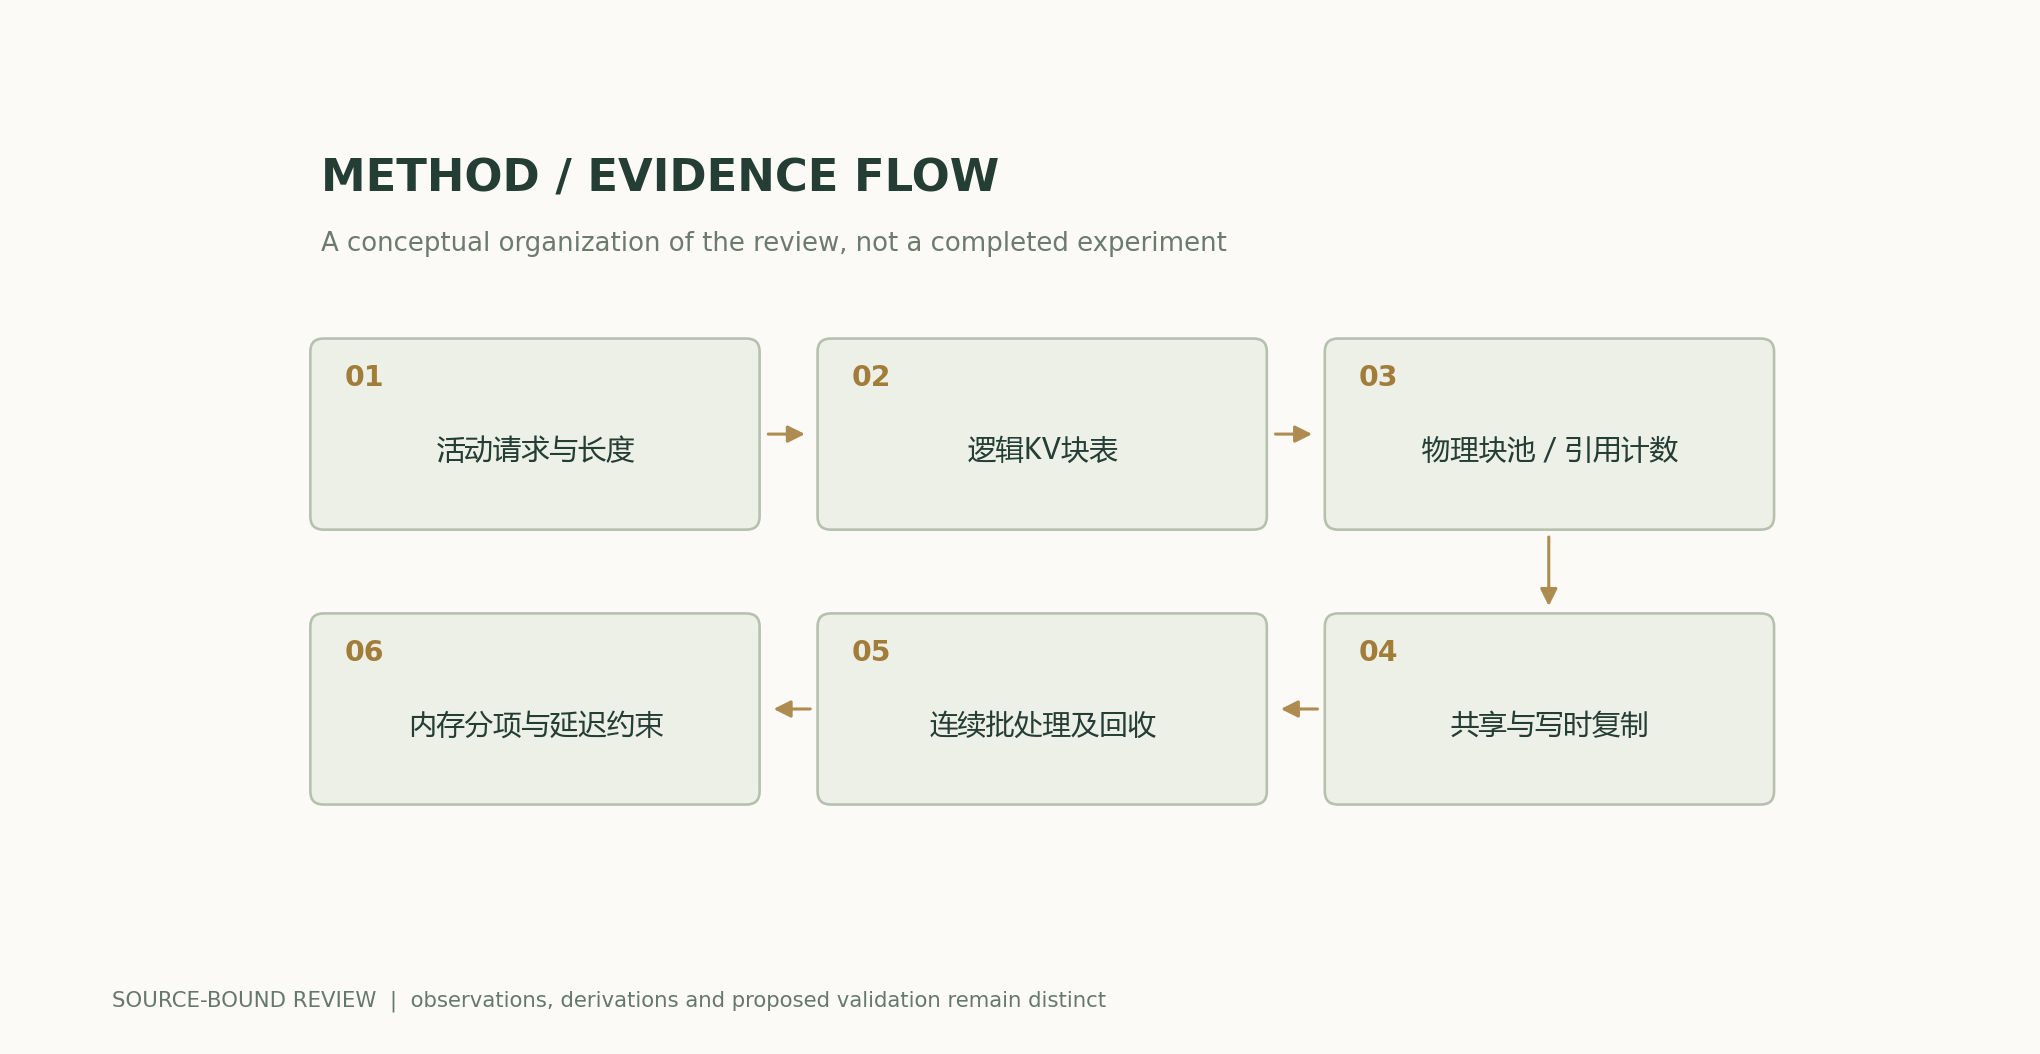
الرسوم التحليلية والأمثلة العددية
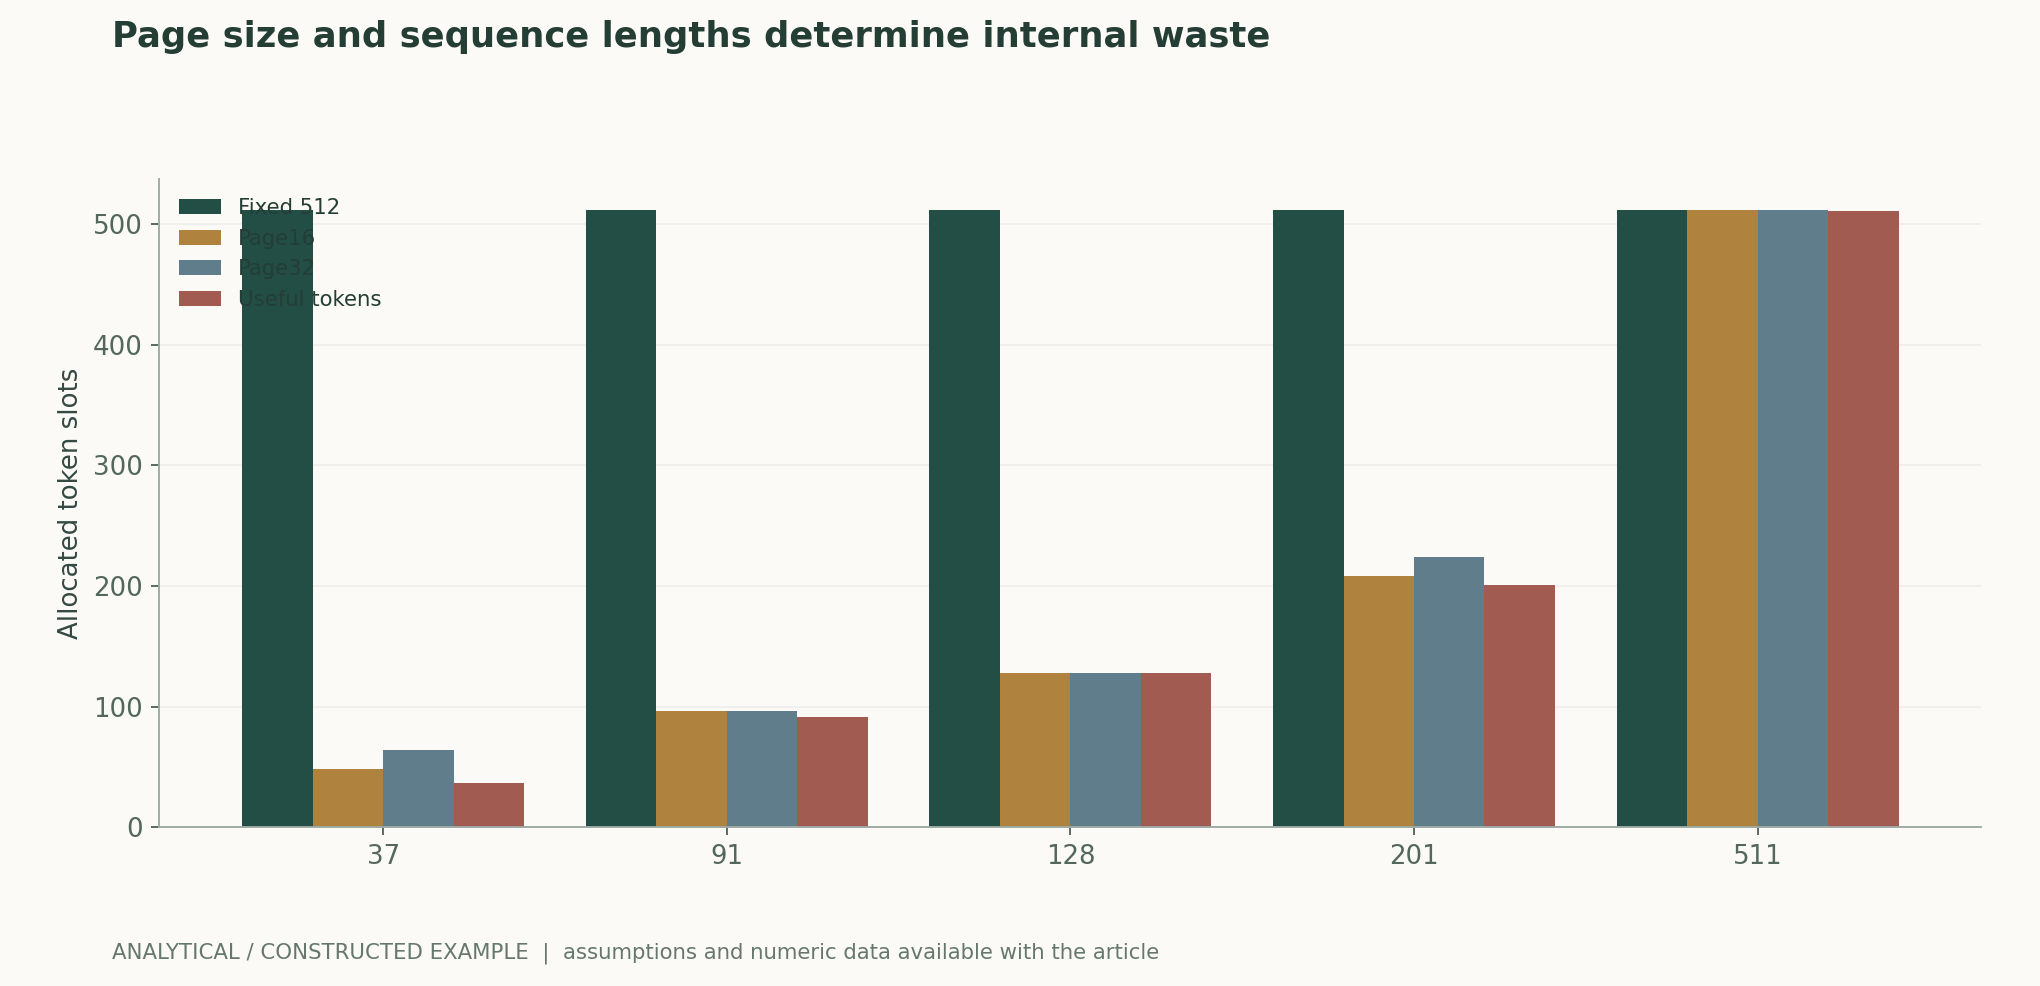
مثال محلول يمكن إعادة حسابه
يبلغ مجموع المواضع الفعلية في التسلسلات الخمسة 968؛ ويتطلب الحجز الثابت بمقدار 512 لكل تسلسل 2560، بينما يتطلب التقسيم إلى صفحات تضم 16 موضعاً 992، والتقسيم إلى صفحات تضم 32 موضعاً 1024. وتبلغ نسب استغلال المواضع نحو 37.81% و97.58% و94.53%، وهي لا تمثل استغلال الجهاز أو الإنتاجية.
مقارنة الطرق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| الحجز الثابت وفق الطول الأقصى | الحساب باستخدام مجموعة الطلبات النشطة نفسها | كلما زاد التفاوت في الأطوال، قد تزداد السعة المحجوزة غير المستخدمة |
| تقسيم KV إلى صفحات | تسجيل حجم الكتلة والمواضع الفعلية وبايتات جدول الكتل | تقلل الكتل الصغيرة التجزئة لكنها تزيد تكلفة الإدارة |
| مشاركة البادئات | التحقق من النموذج والرموز والإعدادات وأعمار المراجع | تغيّر أخطاء مفاتيح المشاركة أو الاسترداد المبكر المخرجات |
| الجدولة عبر الإنترنت | تثبيت عملية الوصول وقياس زمن الاستجابة في ذيل التوزيع | لا تمثل الإنتاجية في الوضع غير المتصل تجربة الخدمة |
خطة التحقق والتجارب
- تثبيت الأوزان وعدد رؤوس KV والدقة وقواعد أخذ العينات، ومقارنة المخرجات بخط أساس يستخدم KV متجاوراً.
- حفظ أطوال المدخلات والمخرجات وعملية الوصول، سواء كانت فعلية أو مُنشأة على نحو معلن بوضوح، دون خلط نوعَي الأدلة.
- مسح أحجام الكتل وإحصاء KV الفعلي وتجزئة الكتلة الأخيرة وجدول الكتل والمخزون المحجوز.
- اختبار المشاركة والنسخ عند الكتابة والتفرع والإلغاء والاستباق والاسترداد، والتحقق من عزل المخرجات.
- إجراء دراسات استئصال منفصلة للمؤثرات والتقسيم إلى صفحات والجدولة، وتسجيل زمن الوصول إلى أول رمز والزمن لكل رمز وزمن الاستجابة في ذيل التوزيع.
- مقارنة عدد الطلبات التي يمكن استيعابها عند أهداف زمن استجابة وجودة متماثلة، مع الاحتفاظ بعينات نفاد الذاكرة (OOM) وانتهاء المهلة.
نطاق التطبيق والقيود
- عينات الأطوال مدخلات مُنشأة.
- استغلال المواضع لا يساوي استغلال الجهاز.
- لم تُجرَ اختبارات إنتاجية لـ vLLM أو للعتاد.
- تتطلب صحة المشاركة والاسترداد تحققاً على مستوى التنفيذ.
المصادر الأولية والادعاءات التي تسندها
- Efficient Memory Management for Large Language Model Serving with PagedAttention, , , , , , , , · 2023-09-12Abstract; 原文方法、理论和实验章节见作者原始论文链接
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ كتبها Codex (ذكاء اصطناعي) وأجرى اشتقاقاتها التحليلية استناداً إلى المصادر الأولية المدرجة. لا يتضمن هذا الموقع سجلاً لتحكيم علمي مستقل لهذه المقالة أو لتجارب أصلية على النماذج.
مراجعة لأداء القارئ: تُعاد أيضاً الاستفادة من الصفحات المقروءة عندما يعيد طلب HEAD حديث 200 ويكون ETag مطابقاً. يحتفظ متن المقال والمعادلات والمصادر وبيانات الرسوم العلمية بمحتوى الإصدار السابق.
الغلاف المفاهيمي منفصل عن الرسوم العلمية؛ وتُحسب الرسوم العلمية باستخدام معادلات منشورة وافتراضات معلنة، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
المؤلف والإصدار وسجل التصحيحات · /guides/paged-attention-serving/v1/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770