
要旨
オンラインの言語モデルサービングでは、増加し続けるKV状態、長さの異なるリクエスト、デバイス上の計算を同時に管理する必要がある。PagedAttentionはページングの考え方を取り入れ、論理シーケンスを非連続の物理ブロックに対応付けることで、最大長に合わせた領域予約による無駄を減らし、適切な条件下でのブロック共有を可能にする。本稿では、固定予約とページングについて決定論的なバイト数の計算を比較し、ブロックサイズ、プレフィックス共有、コピーオンライト、連続バッチ処理の間のトレードオフを分析する。図中のシーケンス長はいずれも構成した入力であり、実際のトラフィックやサービス性能を表すものではない。[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Fast Inference from Transformers via Speculative Decodi
原文英語要旨の日本語訳
ページングによるKVキャッシュ割り当てを、アテンションの算術演算とは独立に分析する。明示したシーケンス長とページサイズについて内部断片化を計算し、論理的な共有と物理的な寿命を区別するとともに、現実的な到着分布および出力長分布の下でのサービング測定を記述する。これらの計算はvLLMのベンチマークではなく、デバイスの高速化を主張するものでもない。正しい回収、コピーオンライト、キャンセルは、提案する評価の一部である。
1. KVは各アクティブシーケンスの持続的な状態である
自己回帰デコーディングでは過去のキーとバリューを保持する必要があり、その必要容量は層数、シーケンス長、KVヘッド数、ヘッド次元、精度に応じて増加する。GQAやMQAはKVヘッド数を変えるため、モデルの総パラメータ数だけからキャッシュ容量を推定することはできない。生成長が未知の場合、各リクエストの最大長に合わせて連続領域を予約すると、短いリクエストでは大量の未使用容量が残る。ページングが変えるのは記憶領域の割り当てと索引の構成であり、アテンションが読み取る必要のある過去の情報を直接削除するわけではなく、モデルの理論上のコンテキスト上限を変えるものでもない。[1] Efficient Memory Management for Large Language Model Se
2. 論理ブロックと物理ブロックの分離後に断片化を計算する方法
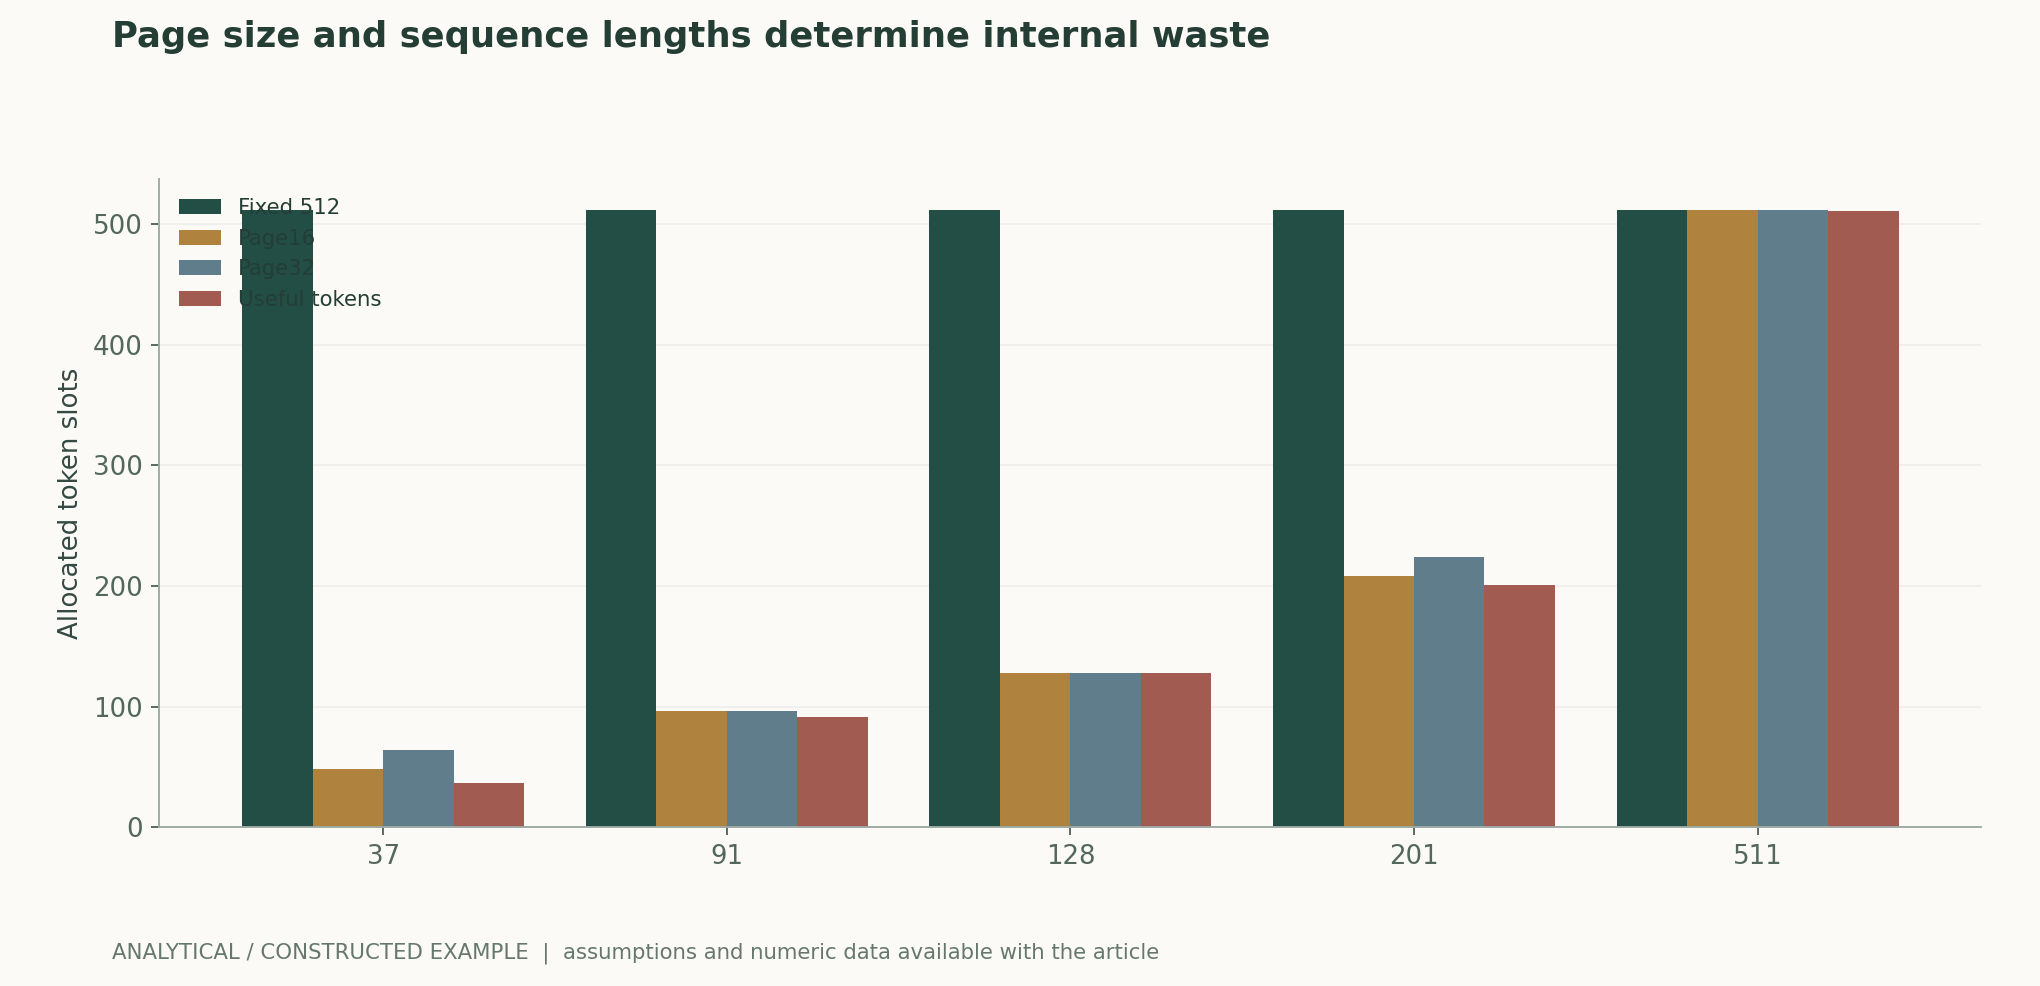
長さn、各ブロックにBトークンを格納するシーケンスにはceil(n/B)個のブロックが必要であり、最終ブロックで無駄になる位置数は最大B−1である。最大長Mに合わせて予約する場合と比べ、複数のリクエストが同じブロックプールをより高密度に利用できる。その効果はBだけでなく長さの分布に依存する。小さいブロックは末尾の無駄を減らす一方、ブロックテーブル、アドレス指定、管理のコストを増やす。本稿では、37、91、128、201、511という五つの長さを用いて、16位置および32位置のブロックを比較し、割り当て位置数と有効位置数を正確に示す。デバイスカーネル、ブロックテーブル、アラインメントによる追加バイト数は含めていない。[1] Efficient Memory Management for Large Language Model Se
3. プレフィックス共有には内容と寿命に関する厳密な条件が必要である
モデル、トークンのプレフィックス、関連する実行条件が同一の分岐は、適切な実装において、計算済みの物理ブロックを共有できる。共有カウントはリクエストの寿命と整合していなければならない。分岐が共有された未充填ブロックを変更する際には、コピーオンライトによって相互の上書きを防止できる。キャンセル、タイムアウト、再試行、分岐の統合はいずれも回収の契機となり得る。不完全なキーの使用や早すぎる回収は、資源最適化を出力誤り、さらにはリクエスト間のデータ問題へと転化させる可能性がある。したがって、正しさのテストではメモリ削減だけを確認するのではなく、内容のバージョン、参照カウント、アドレスを再利用してはならない期間を検証すべきである。[1] Efficient Memory Management for Large Language Model Se
4. 連続バッチ処理はリクエスト間の待機を変える
サービングでは、各ステップで新規リクエストを追加し、完了したリクエストを取り除くことでデバイス利用率を高められるが、プリフィルとデコーディングでは必要な資源が異なる。長いプリフィルはデコーディング中のリクエストを遅延させる可能性があり、大きなバッチはスループットを向上させる一方で個々のリクエストの遅延を悪化させる可能性がある。スケジューリングの優先順位、プリエンプション、KV移行の規則を明示し、最初のトークンまでの時間、トークン当たりの遅延、エンドツーエンド遅延、テールレイテンシを報告すべきである。すべてのリクエストが同時に到着するオフラインバッチだけで測定しても、実際の到着過程やサービス目標を代表することはできない。[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. ページングとIO最適化は異なる階層に作用する
FlashAttentionはアテンション計算をブロック化し、高帯域幅メモリとオンチップ記憶領域の間の読み書きを削減する。一方、KVページングはサービング段階における状態の割り当てとアクセスを対象とする。両者は組み合わせられるが、その組み合わせによる効果には実際のカーネルによる対応が必要である。投機的デコーディングでは、一時保存やロールバックのためのKV位置も生じ、割り当てにさらに影響する。評価では、演算子最適化、キャッシュ割り当て、スケジューリングを個別にアブレーションし、サービングスタック全体の差異を単一のページングアルゴリズムに帰属させないようにすべきである。[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] Efficient Memory Management for Large Language Model Se[3] Fast Inference from Transformers via Speculative Decodi
6. 妥当な受け入れ評価には品質とサービス目標の双方に対する制約が必要である
重みとサンプリングを固定した後、まずページング、共有、回収が出力の意味を変えていないことを確認し、その上で固定した到着分布の下でスループットとテールレイテンシを比較すべきである。メモリ利用率では、有効なKV、末尾ブロックの断片化、ブロックテーブル、ワークスペース、予約プールを区別する必要がある。障害テストにはOOM、キャンセル、プリエンプションからの復帰も含める必要がある。本稿で実施したのは数式による計算のみであり、断片化の削減から「何倍もの高速化」を導くことはできない。実際の効果はワークロード、カーネル、デバイス、サービス目標に依存する。[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
主要な数式と導出
(1) bはスカラー当たりのバイト数であり、2を乗じるのはキーとバリューに対応する。ブロックテーブル、ワークスペース、パディング、その他のモデル状態は含まない。
LaTeX
M_{\mathrm{KV}}=2Lnh_{\mathrm{KV}}d_hb(2) Aは割り当て位置数、Wは最終ブロックの内部断片化を表す。固定長予約の場合の無駄はM−nである。
LaTeX
A_B(n)=B\lceil n/B\rceil,\qquad W_B(n)=A_B(n)-n(3) 位置利用率のみを計算しており、ブロックテーブル、共有、スケジューリングは含まない。デバイス利用率として直接扱うことはできない。
LaTeX
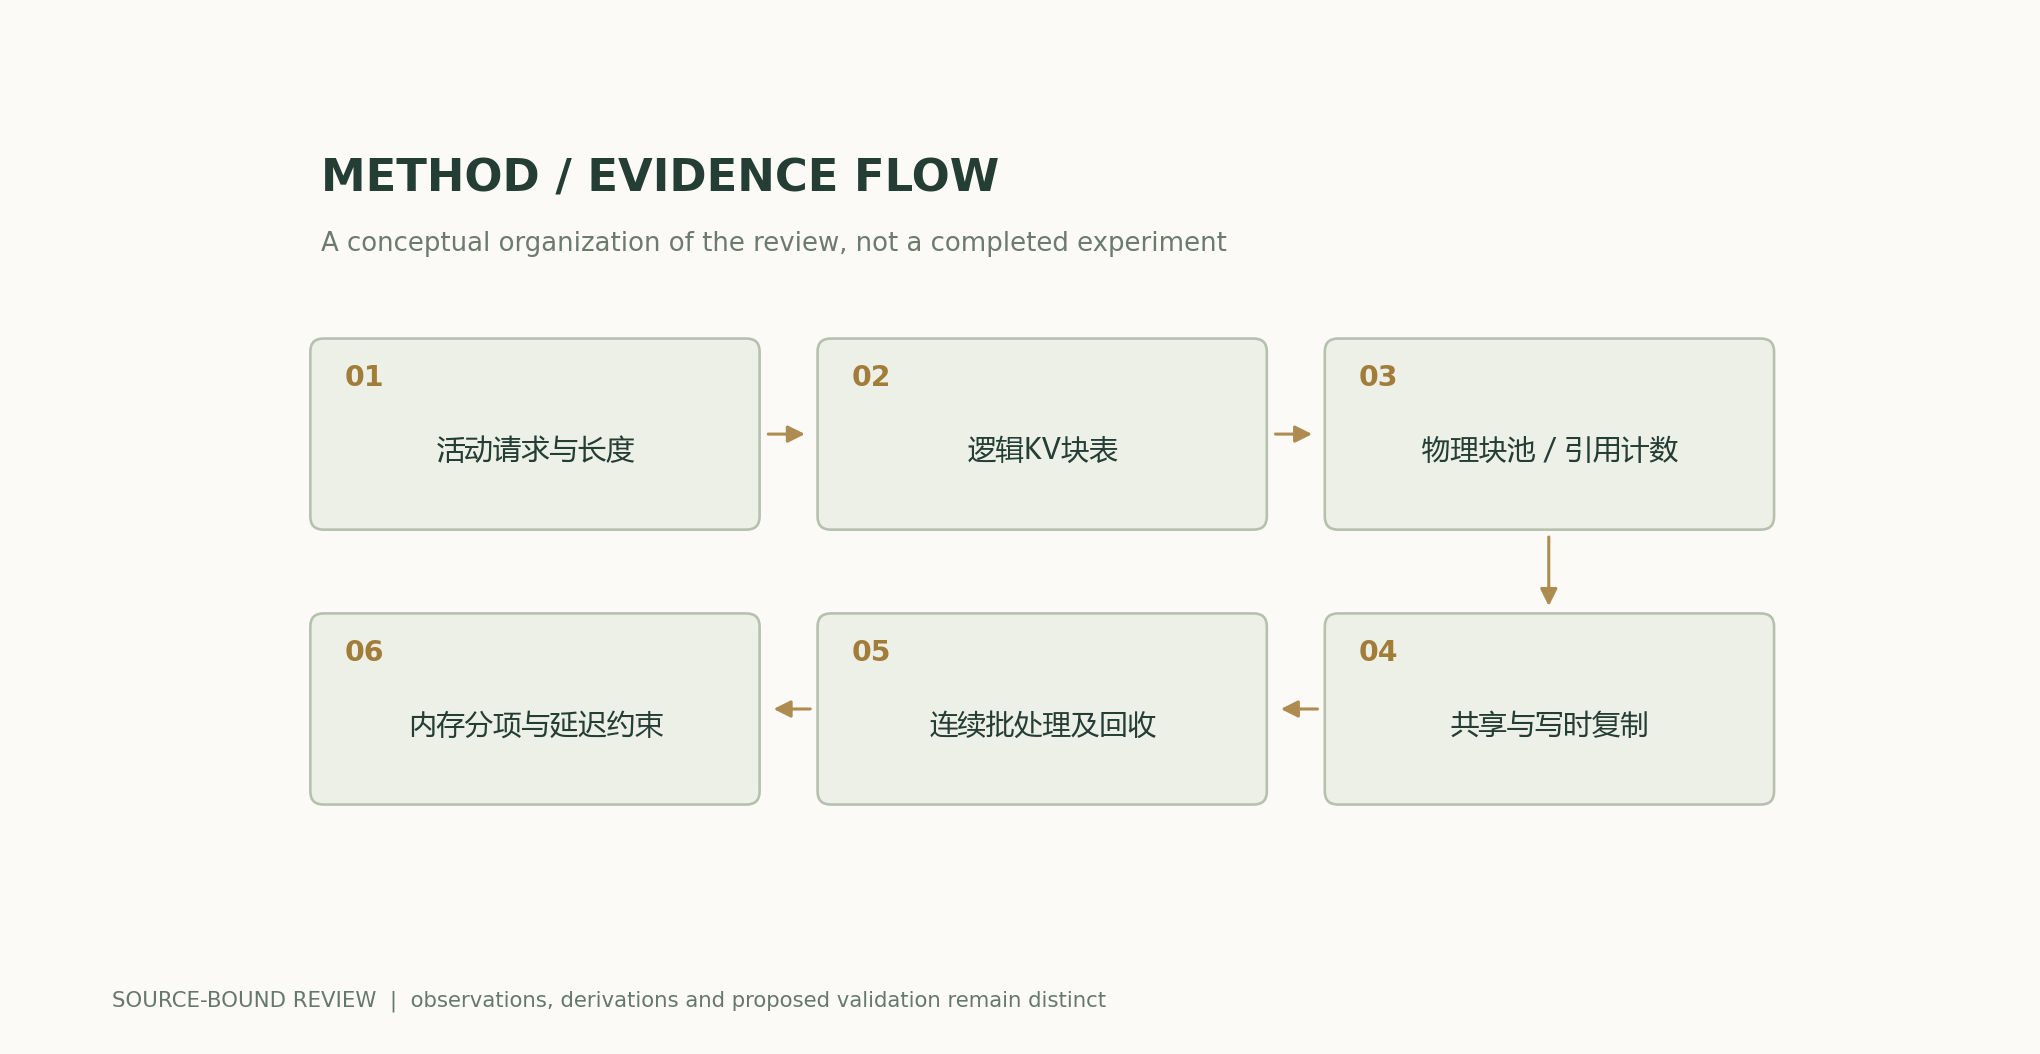
U=\frac{\sum_i n_i}{\sum_i B\lceil n_i/B\rceil}方法とエビデンスの流れ
解析図と数値例
再計算可能な計算例
五つのシーケンスの有効位置数の合計は968である。512の固定予約では2560、ページ当たり16位置のページングでは992、ページ当たり32位置のページングでは1024が必要となる。位置利用率はそれぞれ約37.81%、97.58%、94.53%であり、デバイス利用率やスループットではない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 最大長に基づく固定予約 | 同じアクティブリクエスト集合を用いて計数する | 長さのばらつきが大きいほど未使用の予約容量が増える可能性がある |
| KVページング | ブロックサイズ、有効位置数、ブロックテーブルのバイト数を記録する | 小さいブロックは断片化を減らすが管理コストを増やす |
| プレフィックス共有 | モデル、トークン、設定、参照の寿命を検証する | 共有キーの誤りや早すぎる回収は出力を変える |
| オンラインスケジューリング | 到着過程を固定し、テールレイテンシを測定する | オフラインのスループットはサービスの利用体験を代表できない |
検証と実験の計画
- 重み、KVヘッド数、精度、サンプリング規則を固定し、連続KVのベースライン出力と照合する。
- 実際の入力・出力長と到着過程、または構成したことを明示した入力・出力長と到着過程を保存し、両者のエビデンスを混同しない。
- ブロックサイズを掃引し、有効なKV、最終ブロックの断片化、ブロックテーブル、予約プールを集計する。
- 共有、コピーオンライト、分岐、キャンセル、プリエンプション、回収をテストし、出力の分離を確認する。
- 演算子、ページング、スケジューリングを個別にアブレーションし、最初のトークンまでの時間、トークン当たりの遅延、テールレイテンシを記録する。
- 同じ遅延目標と品質の下で処理可能なリクエストを比較し、OOMおよびタイムアウトのサンプルを保持する。
適用範囲と限界
- 長さのサンプルは構成した入力である。
- 位置利用率はデバイス利用率とは等しくない。
- vLLMまたはハードウェアのスループットテストは実施していない。
- 共有と回収の正しさには実装レベルでの検証が必要である。
一次資料と主張の対応
- Efficient Memory Management for Large Language Model Serving with PagedAttention, , , , , , , , · 2023-09-12Abstract; 原文方法、理论和实验章节见作者原始论文链接
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者・バージョン・出典
AI支援による研究レビュー。Codex(AI)が、記載した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿に対する独立した査読または独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持している。
概念的な表紙と科学図解は区別している。科学図は公開された数式と明示した仮定から計算しており、原論文の結果にはすべて帰属を明記している。
著者・バージョン・訂正履歴 · /guides/paged-attention-serving/v1/
表紙と科学図の出典 · データ・出典・仮定 · 公開・バージョン履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770