
Resumen
El servicio de modelos de lenguaje en línea debe gestionar simultáneamente un estado KV que crece de forma continua, solicitudes de distinta longitud y el cómputo del dispositivo. Inspirado en la paginación, PagedAttention asigna secuencias lógicas a bloques físicos no contiguos, reduce el desperdicio causado por reservar capacidad para la longitud máxima y permite compartir bloques bajo condiciones adecuadas. Este artículo compara el cómputo determinista de bytes de la reserva fija y la paginación, y analiza los compromisos entre el tamaño de bloque, la compartición de prefijos, la copia en escritura y el procesamiento continuo por lotes. Todas las longitudes de secuencia de las figuras son entradas construidas y no representan tráfico real ni rendimiento del servicio.[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Fast Inference from Transformers via Speculative Decodi
Traducción del resumen original en inglés
La asignación paginada de la caché KV se analiza con independencia de la aritmética de la atención. Calculamos la fragmentación interna para las longitudes de secuencia y los tamaños de página declarados, distinguimos la compartición lógica del tiempo de vida físico y describimos mediciones del servicio bajo distribuciones realistas de llegadas y longitudes de salida. Los cálculos no constituyen pruebas de rendimiento de vLLM ni afirman una aceleración del dispositivo. La liberación correcta, la copia en escritura y la cancelación forman parte de la evaluación propuesta.
1. KV constituye el estado persistente de cada secuencia activa
La decodificación autorregresiva debe conservar las claves y los valores históricos, cuya capacidad necesaria aumenta con el número de capas, la longitud de secuencia, el número de cabezas KV, la dimensión de cada cabeza y la precisión. GQA o MQA modifica el número de cabezas KV, por lo que el tamaño de la caché no puede deducirse únicamente del número total de parámetros del modelo. Cuando se desconoce la longitud de generación, reservar espacio contiguo para la longitud máxima de cada solicitud deja una gran cantidad de capacidad sin utilizar en las solicitudes cortas. La paginación modifica la asignación del almacenamiento y la organización de los índices; no elimina directamente la información histórica que la atención necesita leer ni modifica el límite superior teórico del contexto del modelo.[1] Efficient Memory Management for Large Language Model Se
2. Cómo calcular la fragmentación tras separar los bloques lógicos y físicos
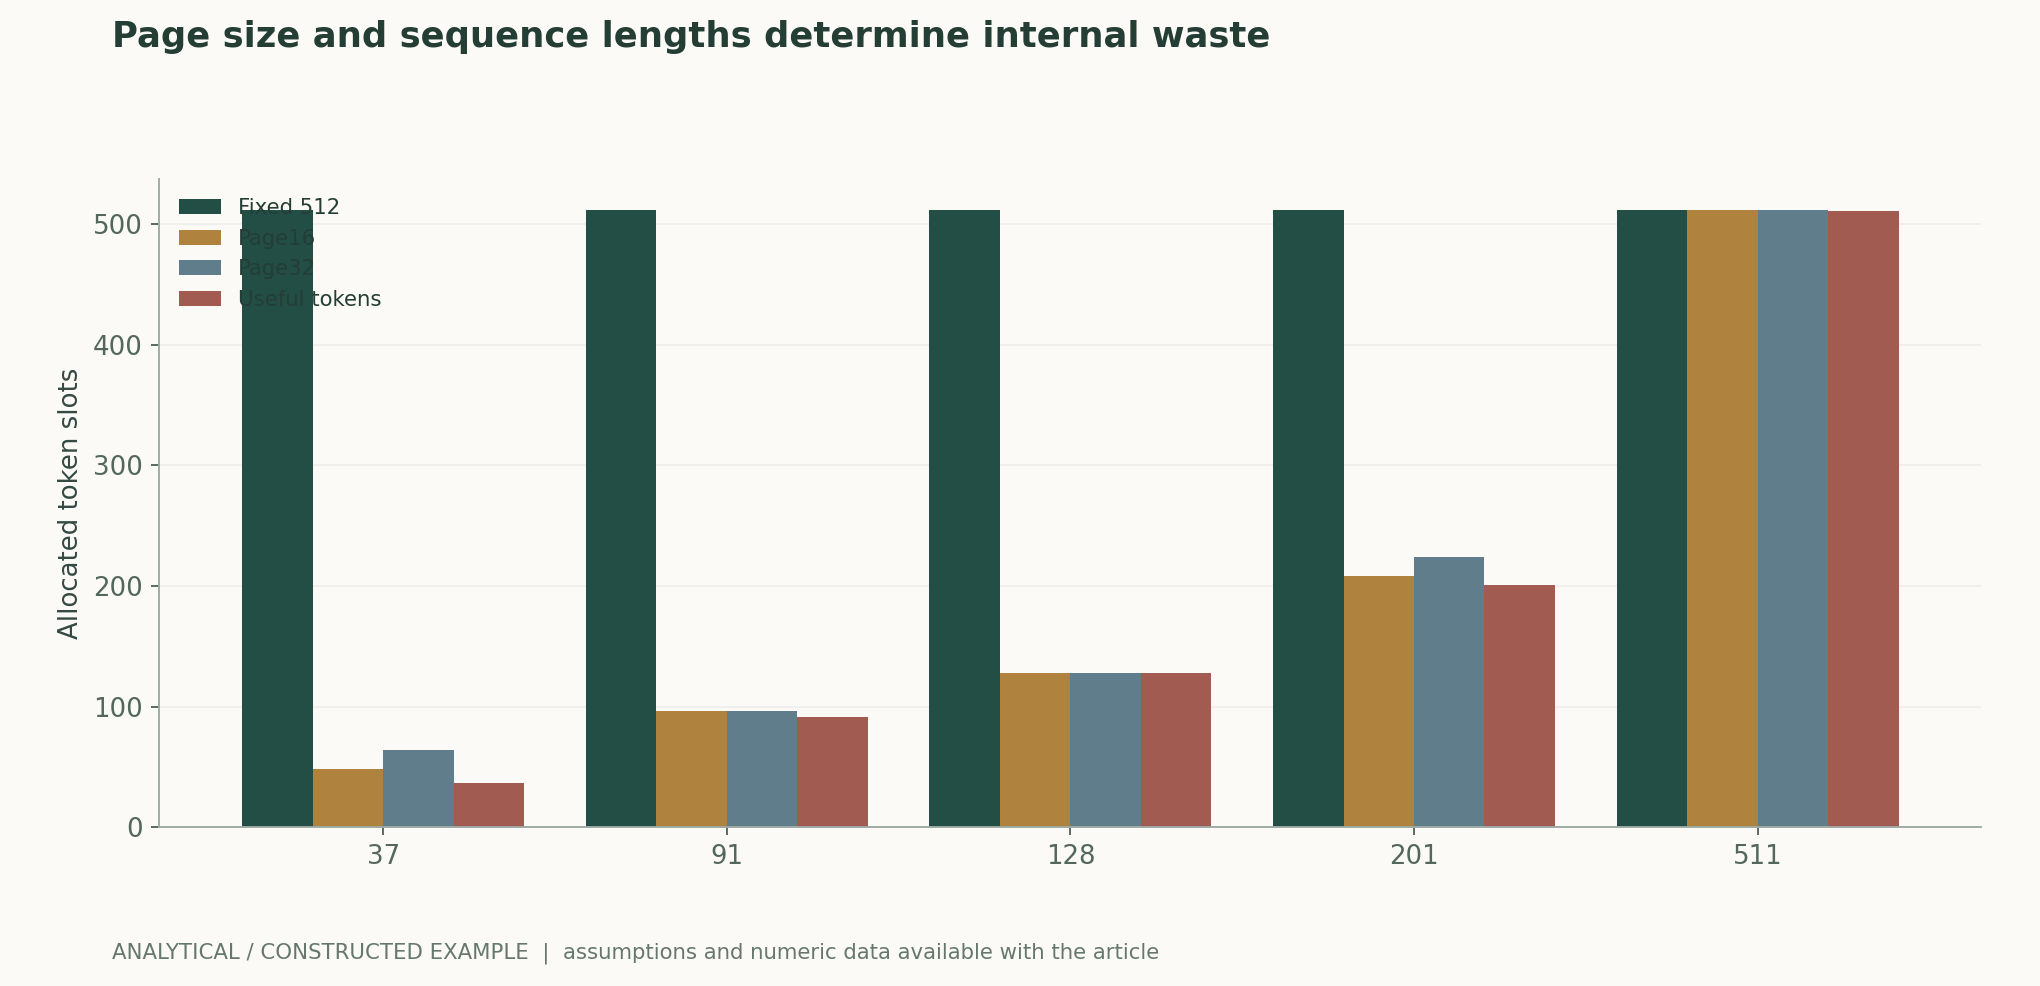
Una secuencia de longitud n con B tokens por bloque requiere ceil(n/B) bloques, y el último bloque desperdicia como máximo B−1 posiciones. Frente a la reserva para una longitud máxima M, varias solicitudes pueden utilizar de forma más compacta el mismo conjunto de bloques; el beneficio depende de la distribución de longitudes, no solo de B. Los bloques pequeños reducen el desperdicio al final, pero aumentan los costes de la tabla de bloques, el direccionamiento y la gestión. Este artículo utiliza cinco longitudes, 37, 91, 128, 201 y 511, para comparar bloques de 16 y 32 posiciones, y enumera con exactitud las posiciones asignadas y útiles; se excluyen los bytes adicionales correspondientes a los kernels del dispositivo, las tablas de bloques y la alineación.[1] Efficient Memory Management for Large Language Model Se
3. La compartición de prefijos exige condiciones estrictas de contenido y tiempo de vida
Las ramas que comparten el mismo modelo, prefijo de tokens y condiciones de ejecución pertinentes pueden compartir bloques físicos ya calculados en una implementación adecuada. Los contadores de compartición deben ser coherentes con los tiempos de vida de las solicitudes; cuando una rama necesita modificar un bloque compartido parcialmente ocupado, la copia en escritura puede evitar que las ramas sobrescriban sus datos mutuamente. La cancelación, los tiempos de espera agotados, los reintentos y la fusión de ramas pueden desencadenar la liberación. El uso de claves incompletas o una liberación prematura puede convertir una optimización de recursos en errores de salida e incluso en problemas de datos entre solicitudes. Por ello, las pruebas de corrección deben verificar las versiones del contenido, los contadores de referencias y los intervalos durante los cuales no deben reutilizarse las direcciones, en lugar de comprobar únicamente la reducción de memoria.[1] Efficient Memory Management for Large Language Model Se
4. El procesamiento continuo por lotes modifica la espera entre solicitudes
El servicio puede incorporar nuevas solicitudes y retirar las completadas en cada paso para mejorar la utilización del dispositivo, pero el prellenado y la decodificación tienen requisitos de recursos diferentes. Un prellenado largo puede retrasar solicitudes que ya están en decodificación, y los lotes mayores pueden aumentar la tasa de procesamiento mientras empeoran la latencia de cada solicitud. Deben especificarse las prioridades de planificación y las reglas de desalojo y migración de KV, e informarse del tiempo hasta el primer token, la latencia por token, la latencia de extremo a extremo y la latencia de cola. Las mediciones limitadas a lotes fuera de línea en los que todas las solicitudes llegan simultáneamente no pueden representar los procesos reales de llegada ni los objetivos del servicio.[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. La paginación y la optimización de E/S actúan en niveles diferentes
FlashAttention organiza el cálculo de la atención en bloques para reducir las lecturas y escrituras entre la memoria de alto ancho de banda y el almacenamiento en el chip; la paginación de KV se centra en la asignación y el acceso al estado durante el servicio. Ambos mecanismos pueden combinarse, pero obtener beneficios de esa combinación exige soporte efectivo de los kernels. La decodificación especulativa también genera posiciones KV para almacenamiento temporal y reversión, lo que afecta adicionalmente a la asignación. La evaluación debe realizar ablaciones separadas de la optimización de operadores, la asignación de caché y la planificación, para evitar atribuir las diferencias de toda la pila de servicio a un único algoritmo de paginación.[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[1] Efficient Memory Management for Large Language Model Se[3] Fast Inference from Transformers via Speculative Decodi
6. Una aceptación adecuada debe imponer restricciones tanto de calidad como de objetivos de servicio
Una vez fijados los pesos y el muestreo, debe comprobarse primero que la paginación, la compartición y la liberación no hayan alterado la semántica de las salidas; después se comparan la tasa de procesamiento y la latencia de cola bajo una distribución de llegadas fija. La utilización de memoria debe distinguir entre KV útil, fragmentación de los bloques finales, tablas de bloques, espacios de trabajo y conjuntos de reserva. Las pruebas de fallos también deben incluir agotamiento de memoria (OOM), cancelación y recuperación tras un desalojo. Este artículo solo realiza cálculos mediante ecuaciones; una reducción de la fragmentación no permite deducir una «aceleración de varias veces». Los beneficios reales dependen de la carga de trabajo, los kernels, el dispositivo y los objetivos de servicio.[1] Efficient Memory Management for Large Language Model Se[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
Ecuaciones fundamentales y derivaciones
(1) b es el número de bytes por escalar; la multiplicación por 2 corresponde a claves y valores. Se excluyen las tablas de bloques, los espacios de trabajo, el relleno y otros estados del modelo.
LaTeX
M_{\mathrm{KV}}=2Lnh_{\mathrm{KV}}d_hb(2) A representa las posiciones asignadas y W la fragmentación interna del último bloque; con una reserva de longitud fija, el desperdicio es M−n.
LaTeX
A_B(n)=B\lceil n/B\rceil,\qquad W_B(n)=A_B(n)-n(3) Solo se calcula la utilización de posiciones, sin incluir tablas de bloques, compartición ni planificación; no puede interpretarse directamente como utilización del dispositivo.
LaTeX
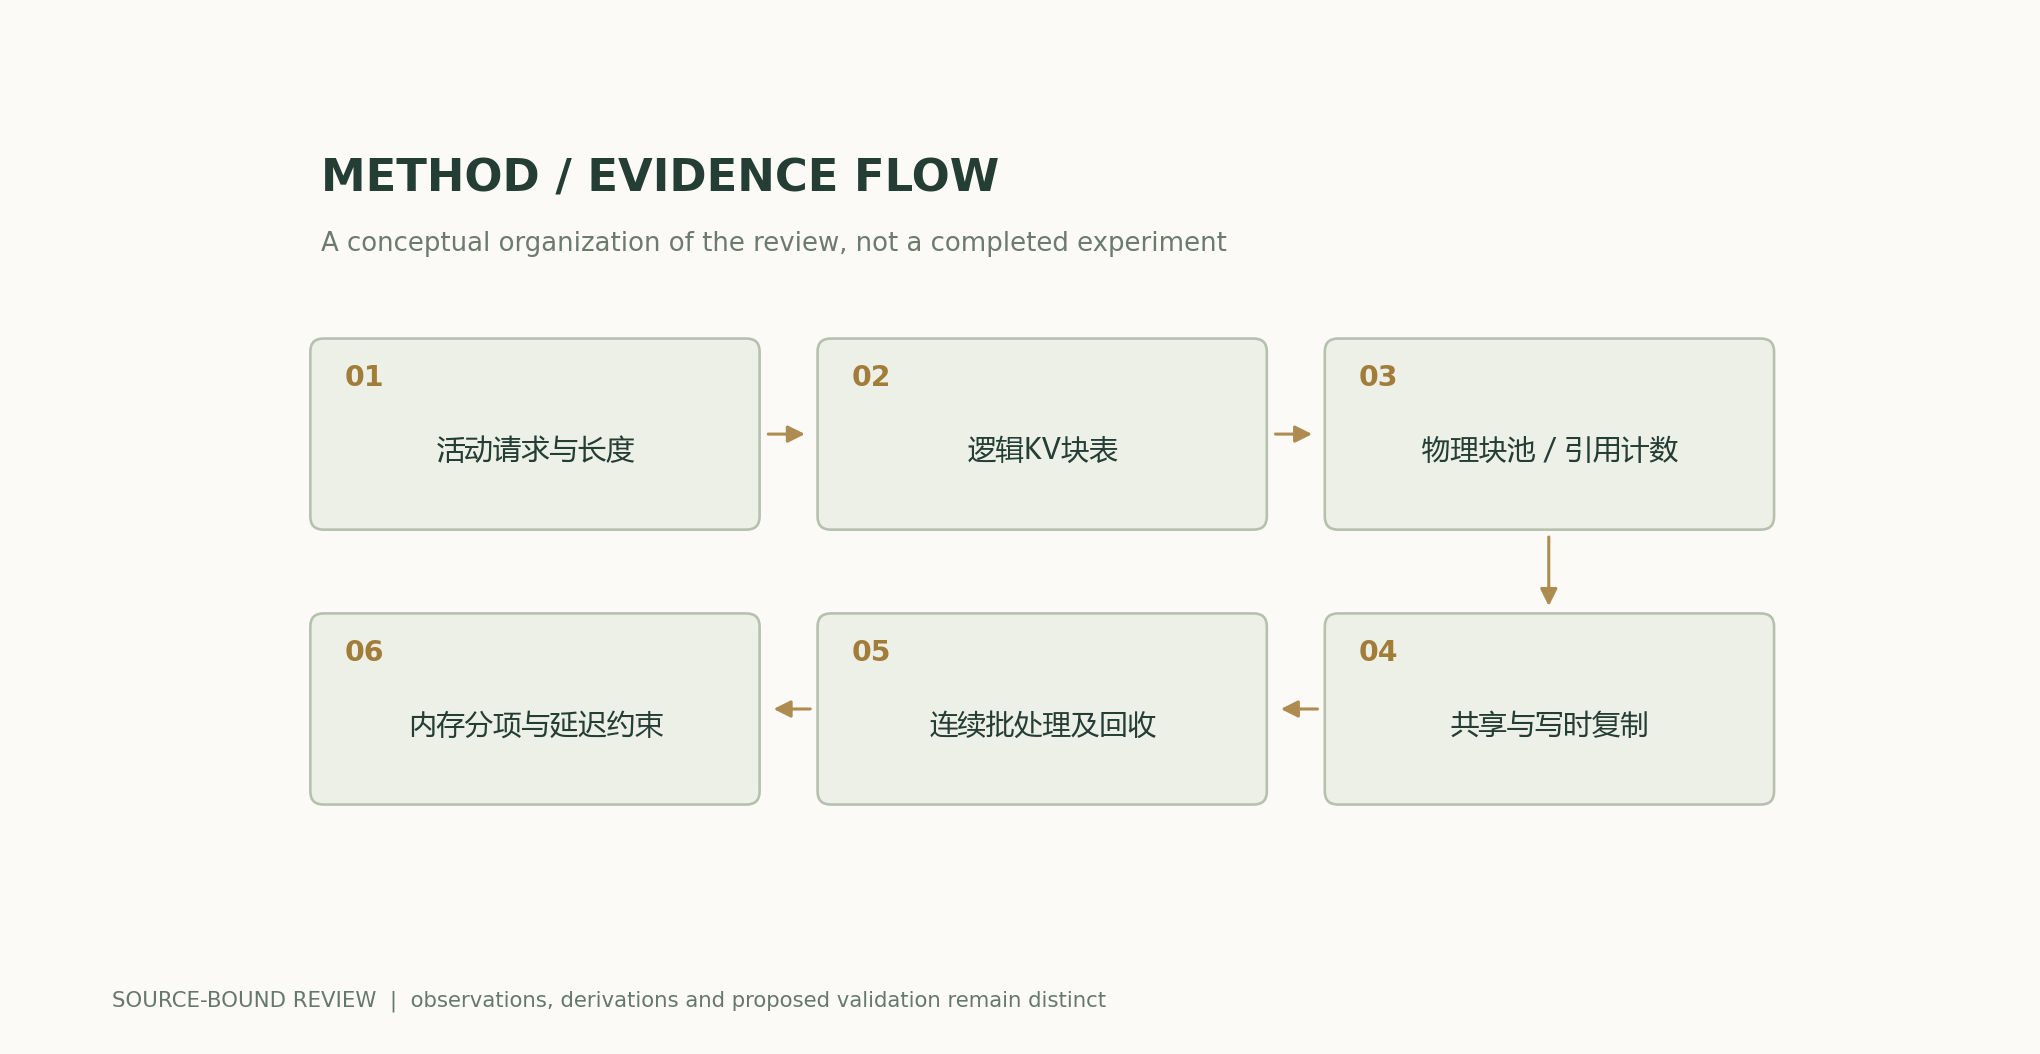
U=\frac{\sum_i n_i}{\sum_i B\lceil n_i/B\rceil}Flujo de métodos y evidencias
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto cuyos cálculos pueden reproducirse
Las cinco secuencias suman 968 posiciones útiles; las reservas fijas de 512 requieren 2560, la paginación con 16 posiciones por página requiere 992 y la paginación con 32 posiciones por página requiere 1024. La utilización de posiciones es aproximadamente 37.81%, 97.58% y 94.53%, respectivamente; estas cifras no representan la utilización del dispositivo ni la tasa de procesamiento.
Comparación de métodos
| Método o valoración | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Reserva fija para la longitud máxima | Contabilizar sobre el mismo conjunto de solicitudes activas | Una mayor variación de longitudes puede dejar más capacidad reservada sin utilizar |
| Paginación de KV | Registrar el tamaño de bloque, las posiciones útiles y los bytes de la tabla de bloques | Los bloques pequeños reducen la fragmentación, pero aumentan los costes de gestión |
| Compartición de prefijos | Verificar el modelo, los tokens, la configuración y los tiempos de vida de las referencias | Las claves de compartición incorrectas o la liberación prematura modifican las salidas |
| Planificación en línea | Fijar el proceso de llegadas y medir la latencia de cola | La tasa de procesamiento fuera de línea no representa la experiencia del servicio |
Plan de verificación y experimentación
- Fijar los pesos, el número de cabezas KV, la precisión y las reglas de muestreo, y contrastar las salidas con una referencia de KV contiguo.
- Registrar las longitudes de entrada/salida y el proceso de llegadas, reales o explícitamente construidos, sin mezclar ambos tipos de evidencia.
- Explorar distintos tamaños de bloque y contabilizar KV útil, fragmentación del último bloque, tablas de bloques y conjuntos de reserva.
- Probar la compartición, la copia en escritura, la ramificación, la cancelación, el desalojo y la liberación, y comprobar el aislamiento de las salidas.
- Realizar ablaciones separadas de los operadores, la paginación y la planificación, registrando el tiempo hasta el primer token, la latencia por token y la latencia de cola.
- Comparar las solicitudes que pueden atenderse con los mismos objetivos de latencia y calidad, conservando las muestras de OOM y de tiempos de espera agotados.
Ámbito de aplicación y limitaciones
- Las muestras de longitud son entradas construidas.
- La utilización de posiciones no equivale a la utilización del dispositivo.
- No se realizaron pruebas de tasa de procesamiento de vLLM ni del hardware.
- La corrección de la compartición y la liberación requiere verificación a nivel de implementación.
Fuentes primarias y afirmaciones correspondientes
- Efficient Memory Management for Large Language Model Serving with PagedAttention, , , , , , , , · 2023-09-12Abstract; 原文方法、理论和实验章节见作者原始论文链接
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
Citación y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas basándose en la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no ha cambiado. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual está separada de las ilustraciones científicas; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autoría, versión e historial de correcciones · /guides/paged-attention-serving/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770