
الملخص
يمكن لتدريب التفضيلات أن يغيّر سلوك الإجابة لدى النماذج اللغوية، لكن إشارة التدريب قد تكون مجرد بديل لأهداف الجودة أو السلامة. استنادًا إلى الأبحاث القائمة في RLHF وDPO، تشتق هذه المراجعة السياسة المثلى المثالية في ظل قيد مرتبط بالسياسة المرجعية، وتوضح كيفية ارتباط أزواج التفضيلات بنسب احتمالات السياسة، وتحلل لماذا لا يثبت تحسن المكافأة تلقائيًا تحسن المنفعة الحقيقية. تضبط خطة التحقق، كلًا على حدة، وسم التفضيلات وطول الإجابات وأخذ العينات والسلوك خارج المجال؛ ولا تعرض الرسوم التحليلية سوى حالات مُنشأة يمكن أن ينفصل فيها الهدف البديل عن الهدف الحقيقي.[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is [3] Language Models (Mostly) Know What They Know
ترجمة الملخص الإنجليزي الأصلي
تُدرس عملية تحسين التفضيلات من خلال التمييز بين إشارة تفضيل متعلَّمة والهدف الذي يُراد لها أن تقرّبه. وتفسّر دالة هدف للسياسة منتظمة بتباعد KL النسبة اللوغاريتمية إلى النموذج المرجعي المستخدمة في التحسين المباشر للتفضيلات. وتحدد المراجعة الطول ومزيج القائمين بالوسم وآثار الانتقاء بوصفها عوامل تجريبية منفصلة، وتقترح تقييمات على بيانات محجوزة لا يمكن الاستعاضة عنها بتحسن المكافأة.
1. غيّرت التغذية الراجعة البشرية إشارة التدريب
تبدأ العملية البحثية في InstructGPT بالضبط الدقيق الخاضع للإشراف باستخدام أمثلة توضيحية، ثم تجمع ترتيبات المخرجات، وتتعلّم نموذج مكافأة، وتحسّن السياسة بالتعلّم المعزّز. وهي تجيب عن سؤال «كيف نجعل النموذج أكثر توافقًا مع المقاصد الواردة في التغذية الراجعة المجمَّعة؟». وتؤثر في الهدف طريقة اختيار القائمين بالوسم، ومصادر المطالبات، وتغطية المهام؛ فلا يجوز وصف تفضيلات توزيع بيانات معيّن مباشرة بأنها قيم موحّدة لجميع الناس.[1] Training language models to follow instructions with hu
2. يستند التبسيط في DPO إلى افتراضات صريحة
في إطار نموذج التفضيلات ودالة الهدف المقيّدة بتباعد KL اللذين تعتمدهما DPO، تُستخدم العلاقة بين المكافأة والسياسة لإعادة صياغة التحسين بوصفه خسارة تستند مباشرة إلى التفضيلات الزوجية. وتستغني الطريقة عن ملاءمة نموذج مكافأة منفصل وعن حلقة التدريب المقابلة بالتعلّم المعزّز، لكن ذلك لا يعني إمكان الاستغناء عن بيانات التفضيلات أو السياسة المرجعية أو التحقق. كما أن بساطة الصياغة لا تزيل تلقائيًا أخطاء الوسم أو انحياز التوزيع.[2] Direct Preference Optimization: Your Language Model is
3. لماذا تهم السياسة المرجعية
تقيّد مقارنة الاحتمالات اللوغاريتمية النسبية للسياسة المستهدفة والسياسة المرجعية معنى «زيادة احتمال الإجابة المفضّلة». ويوفر النموذج المرجعي خط أساس، فيما تتحكم شدة الانتظام في كلفة الانحراف عنه. وتغيّر اختلافات البيانات والمعلمات والتنفيذ الموازنة الفعلية. ولا توصي هذه المراجعة بقيمة محددة لمعامل فائق بوصفها قيمة مثلى عامة، ولا تقارن درجات نماذج لم تُراجع شروط تدريبها على أساس موحّد.[2] Direct Preference Optimization: Your Language Model is
4. استخدام منحنيات الخسارة لفهم الهدف، لا للادعاء بوجود أثر
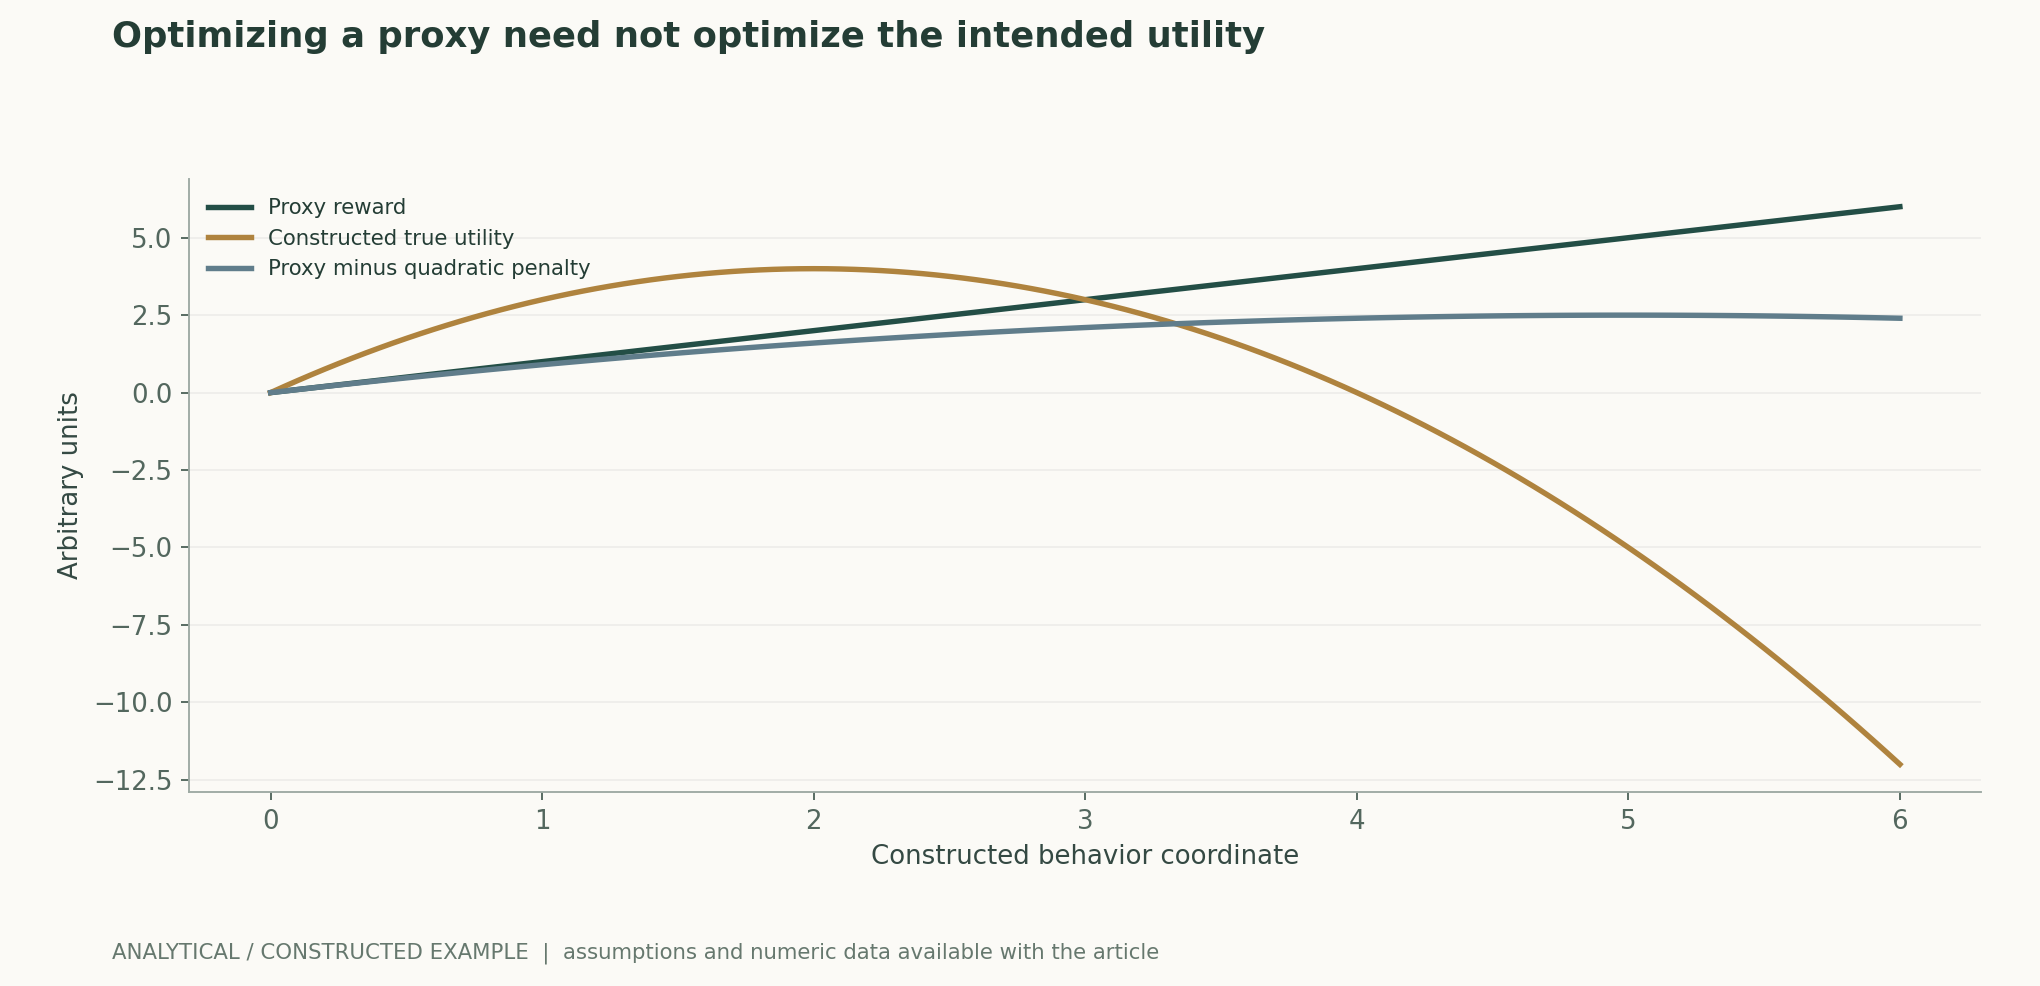
يمكن كتابة الخسارة اللوجستية من نمط DPO على النحو الآتيحيث يمثّل m فرق الاحتمالات اللوغاريتمية النسبية في اتجاه التفضيل. تنخفض الخسارة كلما ازداد m، لكن ذلك لا يضمن أن تصبح الإجابات أكثر صدقًا؛ فإذا كافأت البيانات التملّق أو التعبير الواثق، فقد يعزّز التحسين هذه السمات أيضًا. يستخدم الشكل 2 في هذه النسخة مثالًا مضادًا مستقلًا للمنفعة البديلة للتمييز بين الدرجة البديلة والمنفعة المستهدفة؛ ولا يتضمن الشكل سجلات تدريب أو قياسات فعلية للتفضيلات.[2] Direct Preference Optimization: Your Language Model is
5. تتطلب الثقة ومعدلات الصحة الفعلية أيضًا معايرة منفصلة
درس Kadavath وزملاؤه التقييم الذاتي لدى النماذج لصحة الإجابات وقابلية الأسئلة للإجابة، وحققوا نتائج واعدة في بعض صيغ المهام، كما وثّقوا صعوبات المعايرة عبر مهام جديدة. ولذلك فإن قول النموذج «أنا واثق» يظل بحاجة إلى المقارنة بمعدل الصحة الفعلي. وينبغي التعامل مع مسألة ما إذا كان تحسين التفضيلات يغيّر هذا التطابق بوصفها سؤال تقييم مستقلًا، ولا يمكن استنتاج ذلك مباشرة من ارتفاع معدل الفوز في التفضيلات.[3] Language Models (Mostly) Know What They Know
6. ما المتغيرات التي ينبغي ضبطها عند مقارنة طريقتين
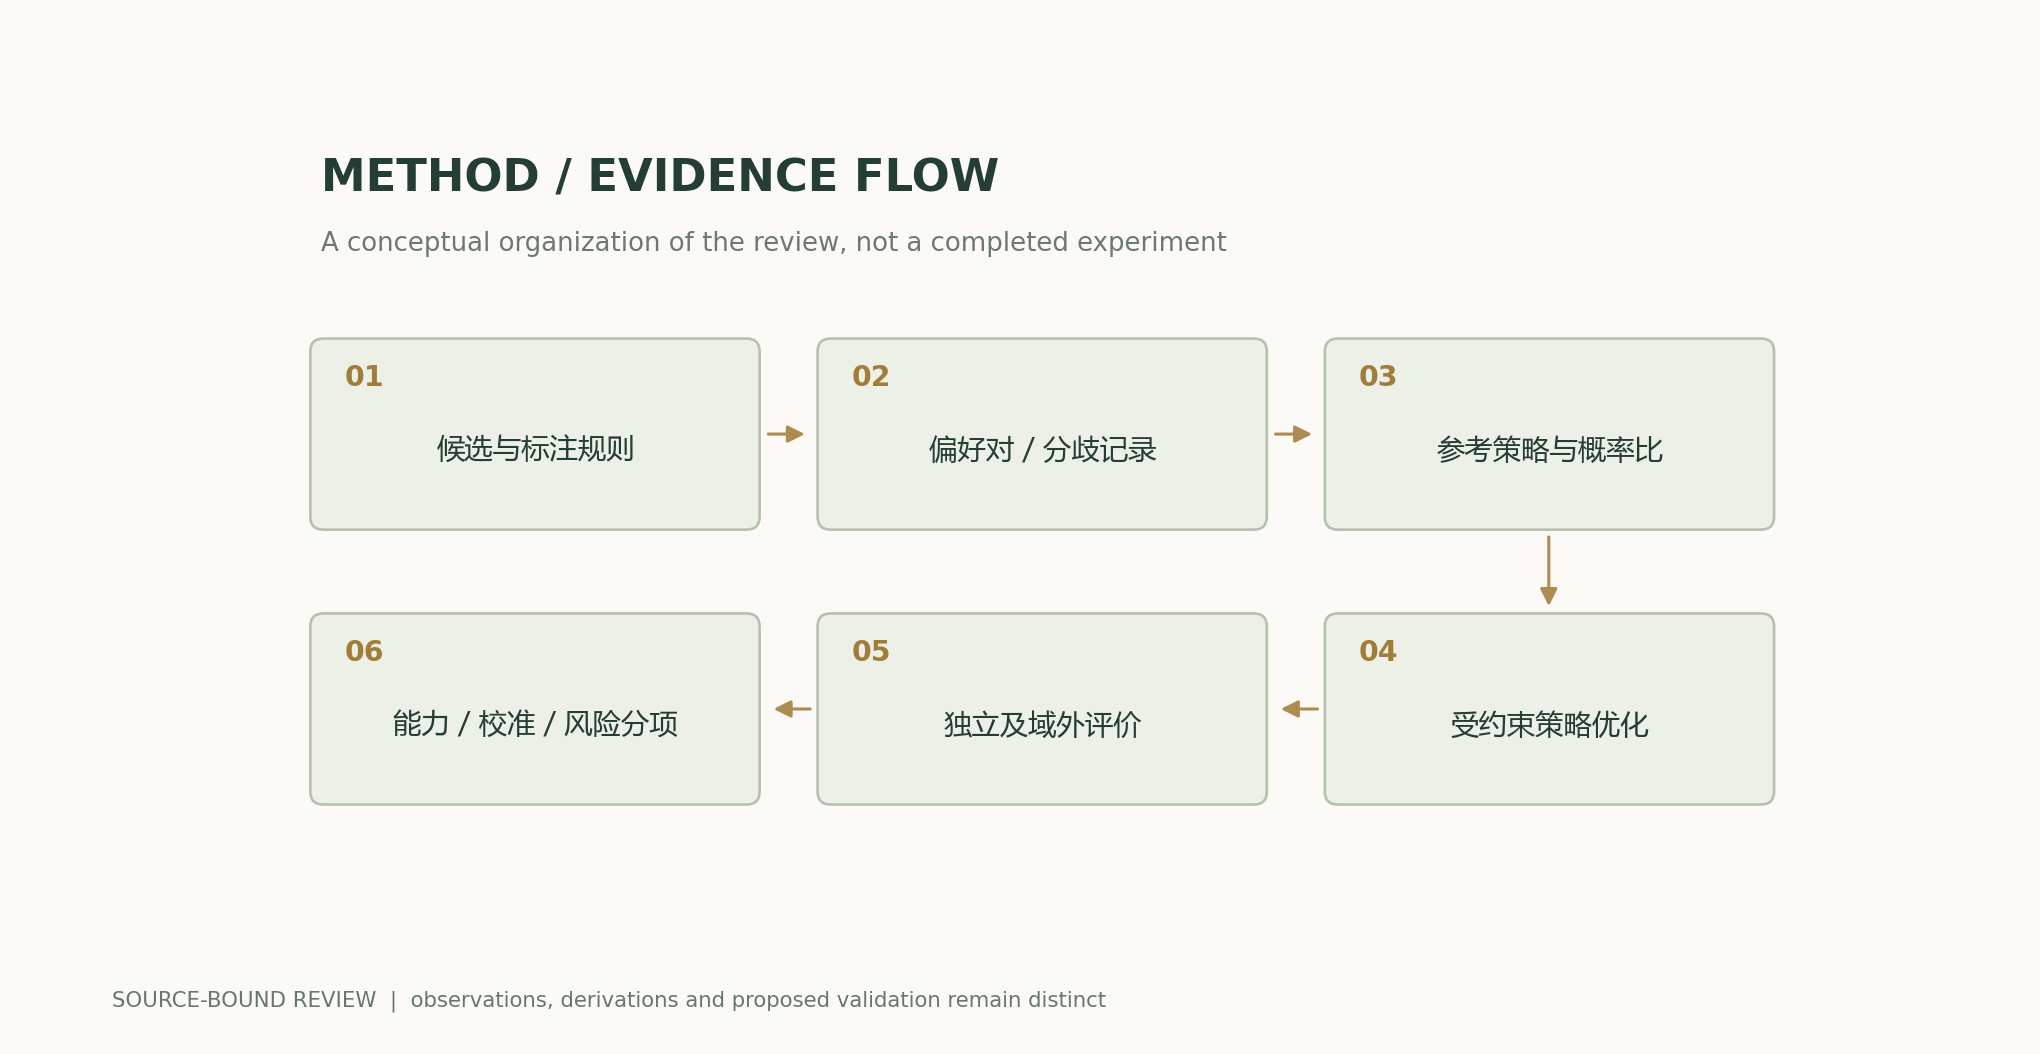
تقترح هذه المراجعة تثبيت النموذج الأساسي وتقسيم البيانات والتفضيلات الزوجية، وتسجيل صيغة المطالبات والنموذج المرجعي وميزانية التدريب والمقيّمين واستراتيجية أخذ العينات. كما تقترح قياس اتباع التعليمات والصحة الواقعية والمعايرة وانحياز الطول والمخرجات الضارة كلًا على حدة. وإذا كان المقيّمون يفضّلون الإجابات الأطول وكانت أطوال مخرجات الطريقتين مختلفة بوضوح، فينبغي الإبلاغ عن هذا العامل المربك بدلًا من الاكتفاء بمعدل فوز إجمالي.作者分析与复核建议 / Author analysis
7. التعامل مع الاختلاف بوصفه بيانات لا ضوضاء
قد يختلف القائمون بالوسم بصورة معقولة بشأن الأحكام القيمية أو أسلوب التعبير. ويساعد الاحتفاظ بنسب الاختلاف وفئات المهام وإرشادات الوسم على فهم تفضيلات مَن تعلّمتها السياسة. أما الأحكام الواقعية فينبغي ربطها بالأدلة الخارجية قدر الإمكان. ويتيح التسجيل المنفصل لعبارتي «هذه هي الإجابة التي أفضّلها» و«هذا التصريح تدعمه الأدلة» تحديد مواضع واضحة للتصحيح اللاحق وتحسين البيانات.作者分析与复核建议 / Author analysis
تحتاج بيانات التفضيلات أيضًا إلى سياق زمني وجماعي
قد تحظى بعض الإجابات بقبول أكبر في فترة زمنية أو منطقة أو فئة مستخدمين معيّنة، لكن الترتيب نفسه قد لا ينطبق في سياق آخر. وينبغي أن تسمح سجلات البيانات بفحص الاختلافات حسب فئة المهمة وجماعة القائمين بالوسم، مع التمييز خصوصًا بين تصحيح الحقائق وأسلوب التعبير والأحكام القيمية. وإذا وُلّدت بيانات التدريب والتقييم باستخدام قوالب التفضيلات نفسها، فقد تشير الدرجات الأعلى في المقام الأول إلى مطابقة القالب، لا إلى التحقق من منفعة أوسع للمستخدمين.作者分析与复核建议 / Author analysis
8. العلاقة ذات الصيغة المغلقة لدالة الهدف المقيّدة بتباعد KL
لمدخل ثابت x، تُعظَّم المكافأة المتوقعة على توزيع السياسة، مع فرض عقوبة على تباعد KL عن السياسة المرجعية. وباستخدام مضاعف لاغرانج لفرض أن مجموع الاحتمالات يساوي واحدًا، يمكن الحصول على سياسة مثلى تتناسب مع الاحتمال المرجعي مضروبًا في exp(r/β). وبعد إعادة الترتيب، يمكن التعبير عن المكافأة بوصفها نسبة لوغاريتمية بين السياسة والسياسة المرجعية، مضافًا إليها حد تطبيع يعتمد على المدخل وحده. وعند مقارنة إجابتين للمدخل نفسه، يُلغى هذا الحد. تفسّر هذه العلاقة الصلة النظرية بدالة هدف DPO، لكنها تعتمد على مكافأة ثابتة وشروط تتعلق بمجموعة الدعم والتحسين المثالي؛ ولا تضمن العينات المحدودة والنماذج ذات المعلمات بلوغ الحل الأمثل ذي الصيغة المغلقة.[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
9. بيانات التفضيلات ليست حقيقة مرجعية خالية من خطأ القياس
قد تختلف الموازنات التي يجريها القائمون بالوسم بين الإفادة والإيجاز والتهذيب والصحة والمخاطر؛ كما تحدد طريقة جمع أزواج التفضيلات الإجابات التي تدخل المقارنة. وإذا كانت مجموعة من الإجابات المرشحة أطول في المتوسط، فقد يتعلّم نموذج التفضيلات قرائن الطول بدلًا من جودة المحتوى الحقيقية. وينبغي تسجيل إرشادات الوسم ومعدل الخلاف واستراتيجية توليد الإجابات المرشحة ومعالجة العينات المكررة، مع الاحتفاظ بمجموعة تقييم مستقلة. ومعدل الفوز على تفضيلات التدريب نتيجة تخص ذلك التوزيع، ولا يجوز تعميمها مباشرة على جميع اللغات أو المهام أو الفئات السكانية.[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
10. رفع قيمة المؤشر البديل بالتحسين ليس أفضل دائمًا
ما إن تبدأ السياسة بالتكيّف مع السمات الظاهرة للمقيّم، حتى قد يصاحب ارتفاع الدرجات تراجع في صدق الإجابات أو المعايرة أو السلوك خارج المجال. ولا تُستخدم المنحنيات المُنشأة في هذه المراجعة إلا لتوضيح هذا الاحتمال المنطقي، وليست دليلًا تجريبيًا على حدوث تحايل على المكافأة في نموذج معيّن. وينبغي للاختبار الموثوق أن يستخدم أساليب تقييم مستقلة بديلة، وأن يضيف ملاحظات منفصلة عن الحقائق وحدود رفض الإجابة والتعبير عن عدم اليقين، وأن يفحص ما إذا كان توزيع المكافأة يتجاوز نطاق عينات التدريب. وإذا تولى مقيّم التدريب أيضًا دور جهة القبول الوحيدة، فلن تثبت الحلقة المغلقة سوى تحسين درجته الذاتية.[1] Training language models to follow instructions with hu[3] Language Models (Mostly) Know What They Know
11. يجب قياس القيد المرجعي والاحتفاظ بالقدرات معًا
تؤدي زيادة معامل القيد أو خفضه إلى تغيير كلفة ابتعاد السياسة عن النموذج المرجعي، لكن لا توجد قيمة واحدة صالحة لجميع المهام. وقد تؤثر تغييرات صغيرة جدًا في سلوكيات نادرة عالية الخطورة، كما أن كِبَر المسافة بين التوزيعين إجمالًا لا يعني بالضرورة إجابات أسوأ. وينبغي الإبلاغ معًا عن قدرات المهام الأصلية وتقييم التفضيلات والطول ومعدل رفض الإجابة، وفحص التغيرات بحسب فئات المهام. وتختلف أهداف تقطير المعرفة عن أهداف تدريب التفضيلات: فالأول يطابق عادة توزيع المعلّم، بينما يستفيد الثاني من التفضيلات النسبية؛ ولا يمكن تفسير انخفاض النوع نفسه من الخسارة بأنه انتقال متماثل للقدرات.[2] Direct Preference Optimization: Your Language Model is [4] Distilling the Knowledge in a Neural Network
الصيغ الأساسية والاشتقاقات
(1) يتحكم β>0 في كلفة الانحراف عن السياسة المرجعية. والمكافأة r بديل مُعطى؛ ولا يثبت التحسين الرياضي أنها تساوي المنفعة البشرية الفعلية أو هدف السلامة.
LaTeX
\max_\pi\ \mathbb E_{y\sim\pi(\cdot\mid x)}r(x,y)-\beta D_{\mathrm{KL}}\!\left(\pi(\cdot\mid x)\Vert\pi_0(\cdot\mid x)\right)(2) هذا هو التوزيع الأمثل المثالي عند ثبات المدخل والمكافأة وتوافر مجموعة دعم مناسبة. وقد لا تتمكن السياسات ذات المعلمات وبيانات التدريب المحدودة إلا من تقريب هذه العلاقة.
LaTeX
\pi_\star(y\mid x)=\frac{\pi_0(y\mid x)e^{r(x,y)/\beta}}{Z(x)}(3) يمثّل y_w وy_l الإجابة المفضّلة والإجابة غير المفضّلة للمدخل نفسه. تلائم دالة الهدف أزواج التفضيلات، ولا توفر وحدها ضمانًا للصحة الواقعية أو المعايرة أو ضبط المخاطر.
LaTeX
\mathcal L_{\rm DPO}=-\log\sigma\!\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_0(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_0(y_l\mid x)}\right]\right)مسار المنهج والأدلة
رسوم تحليلية وأمثلة عددية
مثال محلول يمكن إعادة حسابه
تبلغ المنفعة الحقيقية المُنشأة قيمتها العظمى عند x=2؛ ويبلغ المؤشر البديل ناقص العقوبة قيمته العظمى عند x=5، حيث تصبح المنفعة الحقيقية، على العكس، −5. ولا يقدم ذلك سوى مثال مضاد، ولا يقدّر مقدار التراجع الفعلي في RLHF أو DPO.
مقارنة الطرق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| تحسن مكافأة التدريب | مقيّمون مستقلون ومهام خارج المجال، مع الاحتفاظ بالمدخلات والمخرجات الفعلية | ارتفاع الدرجة البديلة لا يحسّن بالضرورة المنفعة الفعلية |
| مقارنة معدلات الفوز في التفضيلات | مطابقة الطول وميزانية أخذ العينات والإجابات المرشحة وإرشادات الوسم | تغيّر اختلافات انتقاء الإجابات المرشحة معدل الفوز |
| قيد السياسة المرجعية | الإبلاغ عن β والانحراف التوزيعي والاحتفاظ بالقدرات الأصلية | لا يحدد تباعد KL الإجمالي مواضع السلوكيات النادرة الخطرة |
| القدرات وعدم اليقين | اختبار الأسئلة الواقعية والأسئلة غير القابلة للإجابة وحدود رفض الإجابة كلًا على حدة | لا يحل التهذيب أو الطلاقة محل الصدق |
خطة التحقق والتجارب
- تثبيت النموذج المرجعي ونسخة بيانات التفضيلات واستراتيجية توليد الإجابات المرشحة، وتسجيل إزالة التكرارات وتوزيع الأطوال واختلافات الوسم.
- تقسيم تفضيلات التدريب والتحقق داخل التوزيع والتحقق خارج المجال إلى مجموعات غير متداخلة؛ ويجب ألا تتسرب صيغ السؤال نفسه بين المجموعات.
- اختبار نطاق من قيم معامل القيد، وحفظ التغيرات في الاحتمالات اللوغاريتمية للسياسة والنموذج المرجعي، لا معدل الفوز النهائي وحده.
- مقارنة الإجابات بأسلوب تقييم مستقل مع مطابقة الطول وميزانية فك الترميز، وعشوائية ترتيب الإجابات.
- عرض الصحة الواقعية والمعايرة ورفض الإجابة وقدرات المهام الأساسية كلًا على حدة، وفحص ما إذا كان التحسن الإجمالي يخفي تراجعًا موضعيًا.
- الاحتفاظ بمدخلات حالات الإخفاق ونسخة الهدف وأسس الحكم؛ وإعادة التقييم بعد تعديل الوسم أو خطة التحسين، من دون توريث حالة الاجتياز السابقة مباشرة.
نطاق التطبيق والقيود
- تتأثر إشارة التفضيلات بجماعة القائمين بالوسم وتوزيع الإجابات المرشحة.
- منحنيات المنفعة في الشكل أمثلة مُنشأة وليست تجارب على نماذج.
- الاشتقاق بصيغة مغلقة لا يعادل ضمانًا لتدريب نموذج محدود المعلمات.
- لم تُضف دراسة جديدة للتفضيلات البشرية أو شهادة سلامة.
مطابقة المصادر الأولية مع الادعاءات
- Training language models to follow instructions with human feedbackOuyang et al. · 2022-03-04v1; method and limitations
- Direct Preference Optimization: Your Language Model is Secretly a Reward ModelRafailov et al. · 2023-05-29v3; sections 3-5
- Language Models (Mostly) Know What They KnowKadavath et al. · 2022-07-11v4 abstract
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والنسخة والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ أعدّ Codex، وهو ذكاء اصطناعي، النص والاشتقاقات التحليلية استنادًا إلى الأدبيات الأولية المدرجة. ولا يضم هذا الموقع سجلًا لمراجعة أقران مستقلة لهذه المقالة أو لتجارب أصلية على النماذج.
تعديل أداء القارئ: تُعاد أيضًا الاستفادة من الصفحة التي سبق قراءتها عندما يعيد طلب HEAD حديث 200 وتبقى قيمة ETag مطابقة. ويحتفظ المتن والصيغ والمصادر وبيانات الرسوم العلمية بمحتوى النسخة السابقة.
الغلاف المفاهيمي منفصل عن الرسوم التوضيحية العلمية؛ وتُحسب الرسوم العلمية من صيغ متاحة علنًا وافتراضات مصرّح بها، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
المؤلف والنسخة وسجل التصحيحات · /guides/preference-alignment/v5/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والنسخ
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770