
要旨
選好訓練は言語モデルの応答行動を変えうるが、訓練信号は品質や安全性の目的に対する代理指標にすぎない可能性がある。本稿は既存のRLHFおよびDPO研究に基づき、参照方策による制約の下での理想的な最適方策を導出し、選好対が方策の確率比にどのようにつながるかを説明するとともに、報酬の改善が真の効用の向上を自動的には証明しない理由を分析する。検証計画では、選好アノテーション、回答長、サンプリング、ドメイン外の行動を個別に統制する。解析図は、代理目的と真の目的が乖離しうる構成例のみを示す。[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is [3] Language Models (Mostly) Know What They Know
原文英語要旨の日本語訳
選好最適化を、学習された選好信号と、その信号が近似しようとする目的との区別を通じて検討する。KL正則化付きの方策目的は、直接選好最適化で用いられる参照モデルに対する対数比を説明する。本レビューは、長さ、アノテータの混合構成、選択効果をそれぞれ別個の実験要因として特定し、報酬の改善では代替できないホールドアウト評価を提案する。
1. 人間からのフィードバックが訓練信号を変えた
InstructGPTの研究手順では、まず実演例を用いて教師ありファインチューニングを行い、次に出力の順位付けを収集して報酬モデルを学習し、強化学習によって方策を最適化する。これは「収集したフィードバックに含まれる意図に、モデルをどのようにより適合させるか」という問いに答えるものである。アノテータの選び方、プロンプトの出所、タスクの網羅範囲はいずれも目的に影響する。特定のデータ分布における選好を、すべての人に共通する統一的な価値観と直接表現することはできない。[1] Training language models to follow instructions with hu
2. DPOの簡素化は明示的な仮定に基づく
DPOは、その選好モデルとKL制約付き目的の設定の下で、報酬と方策の関係を利用し、最適化を対比較による選好に直接基づく損失として書き換える。独立した報酬モデルの適合と、それに対応する強化学習の訓練ループを省略できることは、選好データ、参照方策、検証まで省略できることを意味しない。手法の形式が簡潔であっても、誤ったアノテーションや分布の偏りが自動的に解消されるわけではない。[2] Direct Preference Optimization: Your Language Model is
3. 参照方策が重要である理由
対象方策と参照方策の相対的な対数確率を比較することにより、「選好される回答の確率を高める」という操作の意味が制約される。参照モデルは基準を提供し、正則化の強さはそこから逸脱するコストを制御する。データ、パラメータ、実装の違いによって、実際のトレードオフは変化する。本稿は特定のハイパーパラメータ値を普遍的な最適値として推奨せず、訓練条件を共通の基準で確認していないモデルのスコアも比較しない。[2] Direct Preference Optimization: Your Language Model is
4. 損失曲線を効果の主張ではなく目的の理解に用いる
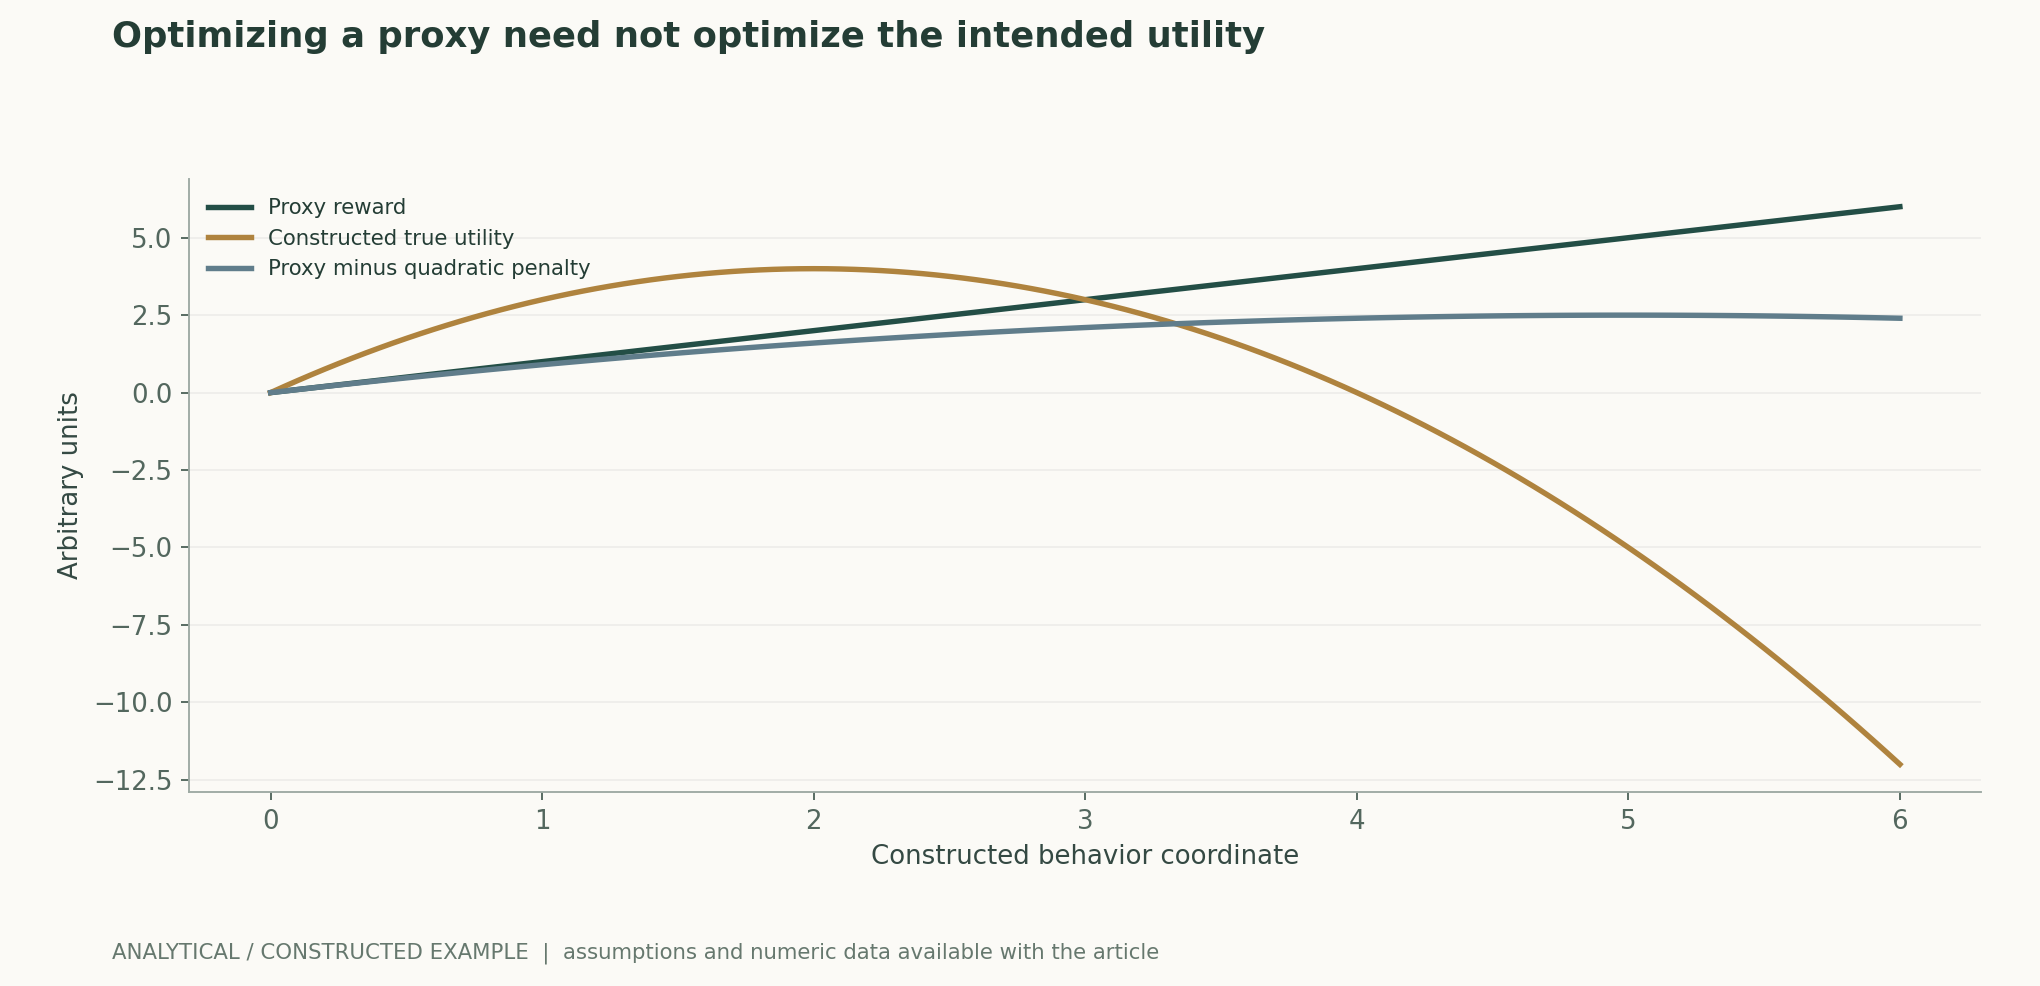
DPO型のロジスティック損失は次のように書けるここでmは、選好の方向における相対対数確率の差を表す。mが増えると損失は減少するが、それによって回答がより真実に即したものになるとは保証されない。データが迎合や自信に満ちた表現に報酬を与える場合、最適化がそれらの特徴を強化する可能性もある。本版の図2は、独立した代理効用の反例を用いて、代理スコアと目的とする効用を区別する。図には訓練ログも実際の選好測定値も含まれていない。[2] Direct Preference Optimization: Your Language Model is
5. 確信度と実際の正答率も別個に較正する必要がある
Kadavathらは、回答の妥当性および回答可能性に関するモデルの自己評価を研究し、一部のタスク形式で有望な結果を得る一方、新しいタスクにまたがる較正の難しさも記録した。したがって、モデルが「自信がある」と述べても、実際の正答率との照合が必要である。選好最適化がこの対応関係を変えるかどうかは、独立した評価課題として扱うべきであり、選好勝率の上昇から直接導くことはできない。[3] Language Models (Mostly) Know What They Know
6. 二つの手法を比較する際に統制すべき変数
本稿は、基盤モデル、データ分割、選好対を固定し、プロンプト形式、参照モデル、訓練予算、評価者、サンプリング戦略を記録することを提案する。また、指示追従、事実的正確性、較正、長さバイアス、有害な出力をそれぞれ測定する。評価者が長い回答を好み、二つの手法の出力長が明らかに異なる場合、総合的な勝率だけを示すのではなく、この交絡を報告すべきである。作者分析与复核建议 / Author analysis
7. 不一致をノイズではなくデータとして扱う
価値判断や表現スタイルについて、アノテータが合理的に意見を異にすることはありうる。不一致率、タスク分類、アノテーション指針を保持することは、方策が誰の選好を学習したかを理解する助けとなる。一方、事実判断は可能な限り外部の証拠と関連付けるべきである。「こちらの回答を好む」と「この記述は証拠に裏付けられている」を分けて記録することで、その後の訂正やデータ改善の対象を明確にできる。作者分析与复核建议 / Author analysis
選好データには時間的・集団的文脈も必要である
ある時期、地域、ユーザー層で特定の回答が好まれていても、同じ順位が別の状況に適用できるとは限らない。データ記録は、タスク分類やアノテータ集団ごとに差異を検討できるものであるべきであり、とりわけ事実の訂正、表現スタイル、価値判断を区別する必要がある。訓練データと評価データが同じ選好テンプレートから生成されている場合、高いスコアは、より広範なユーザーにとっての効用が検証されたことよりも、まずテンプレートへの適合を示している可能性がある。作者分析与复核建议 / Author analysis
8. KL制約付き目的の閉形式の関係
固定された入力xに対し、参照方策からのKLダイバージェンスにペナルティを課しつつ、方策分布上の期待報酬を最大化する。ラグランジュ乗数を用いて確率の総和が一となるよう制約すると、最適方策が参照確率とexp(r/β)の積に比例することが得られる。式を整理すると、報酬は方策と参照方策の対数比に、入力のみに依存する正規化項を加えた形で表せる。同一入力に対する二つの回答を比較する際、この項は相殺される。この関係はDPOの目的との理論的なつながりを説明するが、報酬が固定されていること、台に関する条件、理想的な最適化条件に依存する。有限標本とパラメータ化されたモデルでは、閉形式の最適解に到達する保証はない。[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
9. 選好データは測定誤差のない真値ではない
有用性、簡潔さ、礼儀正しさ、正確性、リスクの間の重み付けは、アノテータによって異なりうる。また、選好対の収集方法によって、比較対象となる回答が決まる。ある候補群が平均して長い場合、選好モデルは実際の内容の質ではなく、長さの手掛かりを学習する可能性がある。アノテーション指針、不一致率、候補生成戦略、重複標本の処理を記録し、独立した評価セットを保持すべきである。訓練時の選好における勝率は、その分布に固有の結果であり、すべての言語、タスク、集団へ直接外挿することはできない。[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
10. 代理指標をより高く最適化することが常によいとは限らない
方策が評価器の観測可能な特徴に適応し始めると、スコアの上昇と同時に、回答の真実性、較正、ドメイン外の行動が悪化する場合がある。本稿の構成曲線はこの論理的可能性を示すためだけのものであり、特定のモデルにおける報酬ハッキングの実証ではない。信頼できる試験では、別の独立した評価方法を用い、事実、回答拒否の境界、不確実性の表現について項目別の観察を加え、報酬分布が訓練標本の範囲を超えていないか確認すべきである。訓練用評価器が唯一の合否判定器を兼ねると、閉ループはその評価器自身のスコアが最適化されたことしか示さなくなる。[1] Training language models to follow instructions with hu[3] Language Models (Mostly) Know What They Know
11. 参照方策への制約と能力保持は併せて測定する必要がある
制約係数を増減すると、方策が参照モデルから離れるコストは変わるが、すべてのタスクに適用できる単一の値は存在しない。ごく小さな変化でも稀な高リスク行動に影響しうる一方、分布全体の距離が大きいことが、必ずしも回答の悪化を意味するわけではない。元のタスク能力、選好評価、長さ、回答拒否率を併せて報告し、タスクごとに層別して変化を検討すべきである。知識蒸留と選好訓練では目的が異なる。前者は通常、教師分布への一致を目指し、後者は相対的な選好を利用する。同種の損失の減少を、同一の能力移転と解釈することはできない。[2] Direct Preference Optimization: Your Language Model is [4] Distilling the Knowledge in a Neural Network
主要な数式と導出
(1) β>0は参照方策からの逸脱コストを制御する。報酬rは与えられた代理指標であり、数学的最適化は、それが実際の人間の効用や安全性の目的に等しいことを証明しない。
LaTeX
\max_\pi\ \mathbb E_{y\sim\pi(\cdot\mid x)}r(x,y)-\beta D_{\mathrm{KL}}\!\left(\pi(\cdot\mid x)\Vert\pi_0(\cdot\mid x)\right)(2) これは、固定された入力、固定された報酬、適切な台の下での理想的な最適分布である。パラメータ化された方策と有限の訓練データでは、この関係を近似するにとどまる可能性がある。
LaTeX
\pi_\star(y\mid x)=\frac{\pi_0(y\mid x)e^{r(x,y)/\beta}}{Z(x)}(3) y_wとy_lは、同一入力に対する選好される回答と選好されない回答である。この目的は選好対に適合するものであり、それ自体で事実的正確性、較正、リスク制御を保証するものではない。
LaTeX
\mathcal L_{\rm DPO}=-\log\sigma\!\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_0(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_0(y_l\mid x)}\right]\right)手法とエビデンスの流れ
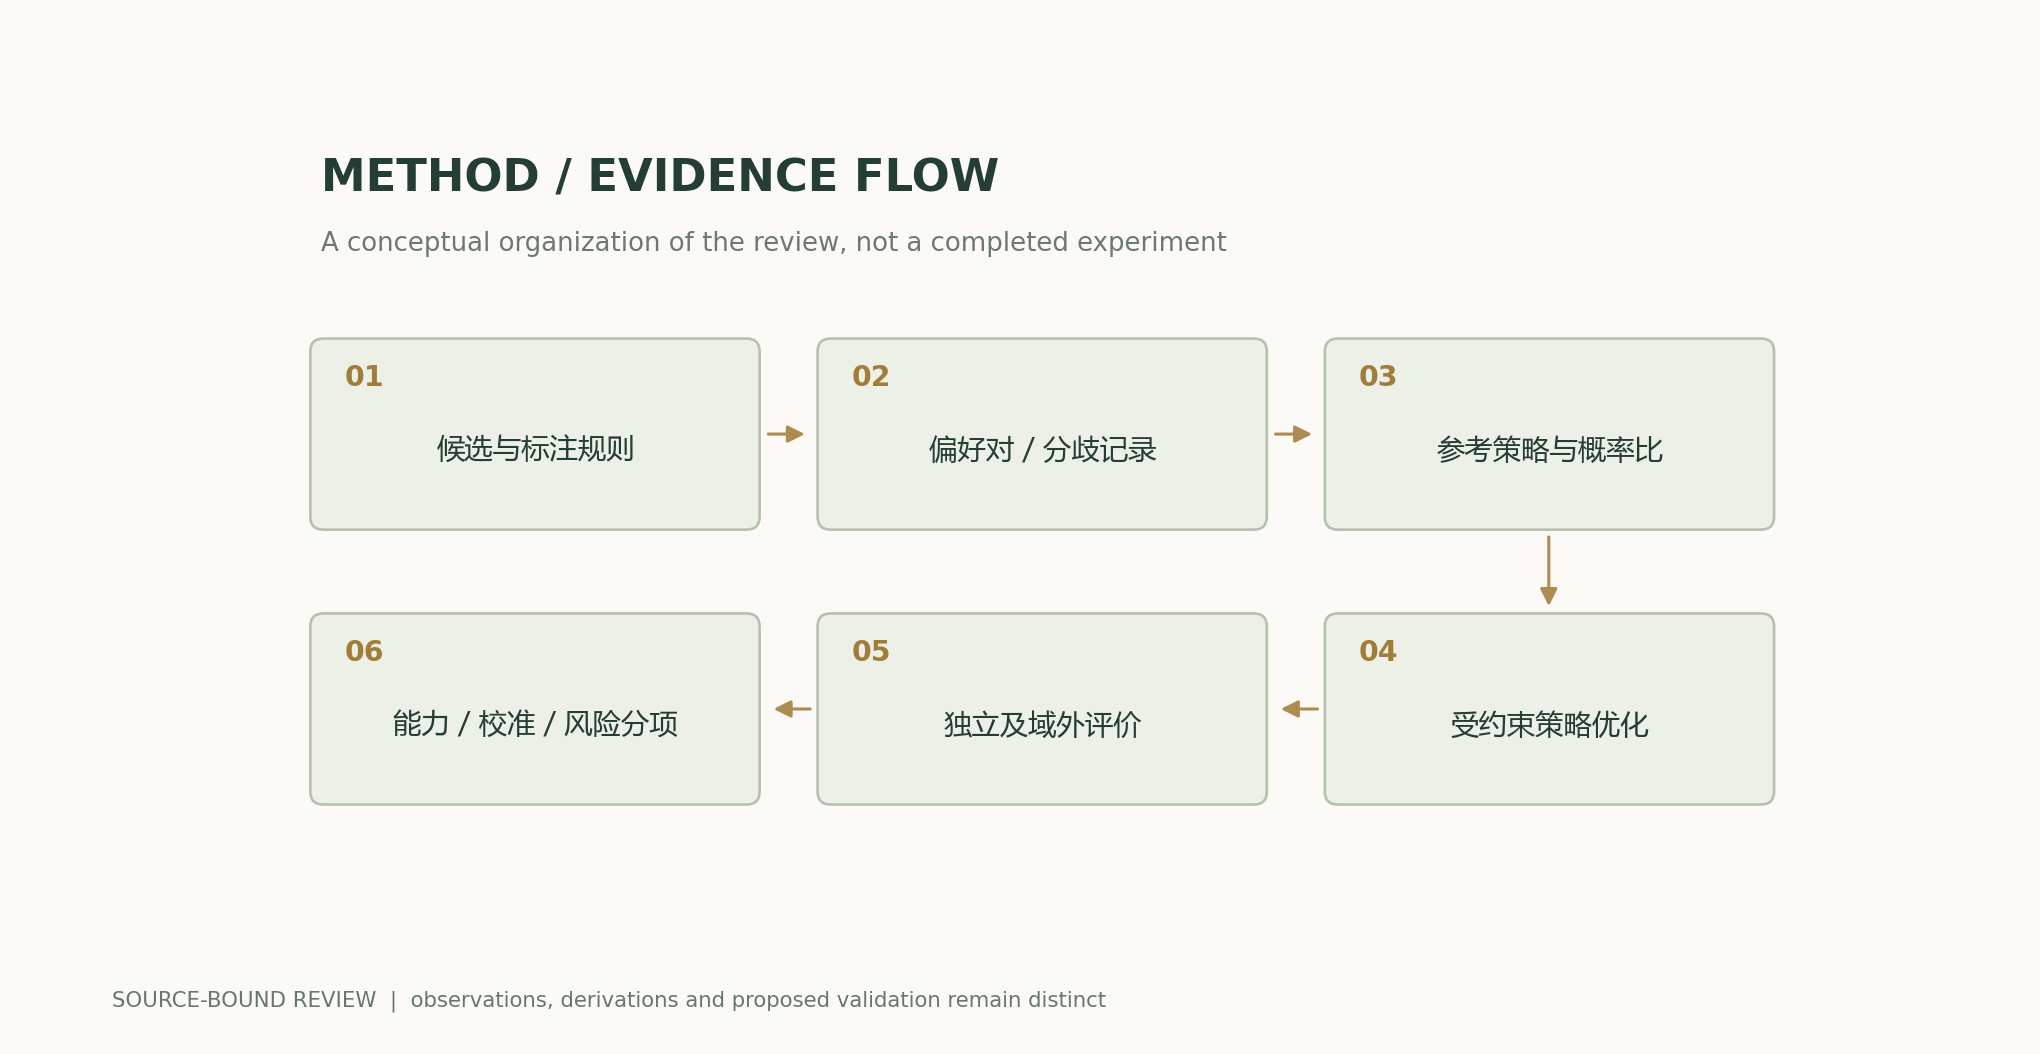
解析図と数値例
再計算可能な例題
構成した真の効用はx=2で最大となる。代理指標からペナルティを引いた値はx=5で最大となるが、その点での真の効用は逆に−5となる。これは反例を示すだけであり、RLHFやDPOの実際の劣化幅を推定するものではない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 訓練報酬の向上 | 独立した評価器とドメイン外タスクを用い、実際の入出力を保持する | 代理スコアの上昇は実際の効用を必ずしも高めない |
| 選好勝率の比較 | 長さ、サンプリング予算、候補、アノテーション指針を揃える | 候補選別の違いによって勝率は変化する |
| 参照方策による制約 | β、分布の逸脱、元の能力の保持を報告する | 全体のKLでは稀なリスク行動を特定できない |
| 能力と不確実性 | 事実に関する問題、回答不能な問題、回答拒否の境界を個別に測定する | 礼儀正しさや流暢さは真実性の代わりにはならない |
検証と実験の計画
- 参照モデル、選好データの版、候補生成戦略を固定し、重複除去、長さの分布、アノテーションの不一致を記録する。
- 訓練用選好、同一分布内の検証、ドメイン外の検証を重複しない集合に分割する。同じ問題の変種が集合間で漏洩してはならない。
- 制約係数を範囲内で変化させ、最終的な勝率だけでなく、方策と参照モデルの対数確率の変化を保存する。
- 長さとデコーディング予算を揃えた条件で、独立した評価方法によって回答を比較し、回答の順序をランダム化する。
- 事実的正確性、較正、回答拒否、基本タスク能力を個別に示し、全体的な改善が局所的な劣化を覆い隠していないか確認する。
- 失敗例については入力、目的の版、判断根拠を保持する。アノテーションや最適化計画を変更した後は再評価し、以前の合格状態をそのまま引き継いではならない。
適用範囲と限界
- 選好信号は、アノテータ集団と候補分布の影響を受ける。
- 図中の効用曲線は構成例であり、モデル実験ではない。
- 閉形式の導出は、有限個のパラメータを持つモデルの訓練保証と同義ではない。
- 新たな人間の選好研究や安全性認証は提供していない。
一次資料と主張の対応
- Training language models to follow instructions with human feedbackOuyang et al. · 2022-03-04v1; method and limitations
- Direct Preference Optimization: Your Language Model is Secretly a Reward ModelRafailov et al. · 2023-05-29v3; sections 3-5
- Language Models (Mostly) Know What They KnowKadavath et al. · 2022-07-11v4 abstract
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿についての独立した査読や独自のモデル実験の記録はない。
リーダー性能の改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学的図解は区別する。科学図は公開された数式と明示した仮定から計算し、原論文の結果にはすべて帰属を明記している。
著者、版、訂正履歴 · /guides/preference-alignment/v5/
表紙と科学図の出典 · データ、出典、仮定 · 公開・版履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770