
Resumen
El entrenamiento con preferencias puede modificar el comportamiento de respuesta de los modelos de lenguaje, pero la señal de entrenamiento puede ser solo un indicador sustitutivo de los objetivos de calidad o seguridad. A partir de las investigaciones existentes sobre RLHF y DPO, esta revisión deriva la política óptima ideal sujeta a una restricción respecto de la política de referencia, explica cómo se relacionan los pares de preferencias con las razones de probabilidades de la política y analiza por qué una mejora de la recompensa no demuestra automáticamente un aumento de la utilidad real. El plan de verificación controla por separado la anotación de preferencias, la longitud de las respuestas, el muestreo y el comportamiento fuera del dominio; las figuras analíticas solo muestran casos construidos en los que el objetivo sustitutivo y el real pueden divergir.[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is [3] Language Models (Mostly) Know What They Know
Traducción del resumen original en inglés
La optimización de preferencias se examina mediante la distinción entre una señal de preferencias aprendida y el objetivo que pretende aproximar. Un objetivo de política regularizado por KL explica la razón logarítmica respecto del modelo de referencia utilizada en la optimización directa de preferencias. La revisión identifica la longitud, la mezcla de anotadores y los efectos de selección como factores experimentales separados, y propone evaluaciones con datos reservados que no pueden sustituirse por una mejora de la recompensa.
1. La retroalimentación humana cambió la señal de entrenamiento
El proceso de investigación de InstructGPT utiliza primero demostraciones para el ajuste fino supervisado; después recopila ordenaciones de las salidas, aprende un modelo de recompensa y optimiza la política mediante aprendizaje por refuerzo. Responde a la pregunta de cómo lograr que el modelo se ajuste mejor a las intenciones expresadas en la retroalimentación recopilada. La selección de anotadores, la procedencia de las instrucciones y la cobertura de tareas influyen en el objetivo; las preferencias de una distribución de datos concreta no pueden describirse directamente como los valores unificados de todas las personas.[1] Training language models to follow instructions with hu
2. La simplificación de DPO se basa en supuestos explícitos
Bajo su modelo de preferencias y su formulación del objetivo restringido por KL, DPO utiliza la relación entre recompensa y política para reformular la optimización como una pérdida basada directamente en preferencias por pares. Eliminar el ajuste separado de un modelo de recompensa y el correspondiente ciclo de entrenamiento por refuerzo no significa que puedan omitirse los datos de preferencias, la política de referencia o la validación. Una formulación más sencilla tampoco elimina automáticamente los errores de anotación ni el sesgo de distribución.[2] Direct Preference Optimization: Your Language Model is
3. Por qué importa la política de referencia
Comparar las probabilidades logarítmicas relativas de la política objetivo y la de referencia delimita el significado de «aumentar la probabilidad de la respuesta preferida». El modelo de referencia proporciona una base de comparación, y la intensidad de regularización controla el coste de desviarse de ella. Los distintos datos, parámetros e implementaciones modifican el equilibrio práctico. Esta revisión no recomienda ningún valor de hiperparámetro como óptimo universal ni compara puntuaciones de modelos cuyas condiciones de entrenamiento no se hayan comprobado sobre una base común.[2] Direct Preference Optimization: Your Language Model is
4. Utilizar las curvas de pérdida para comprender el objetivo, no para afirmar su eficacia
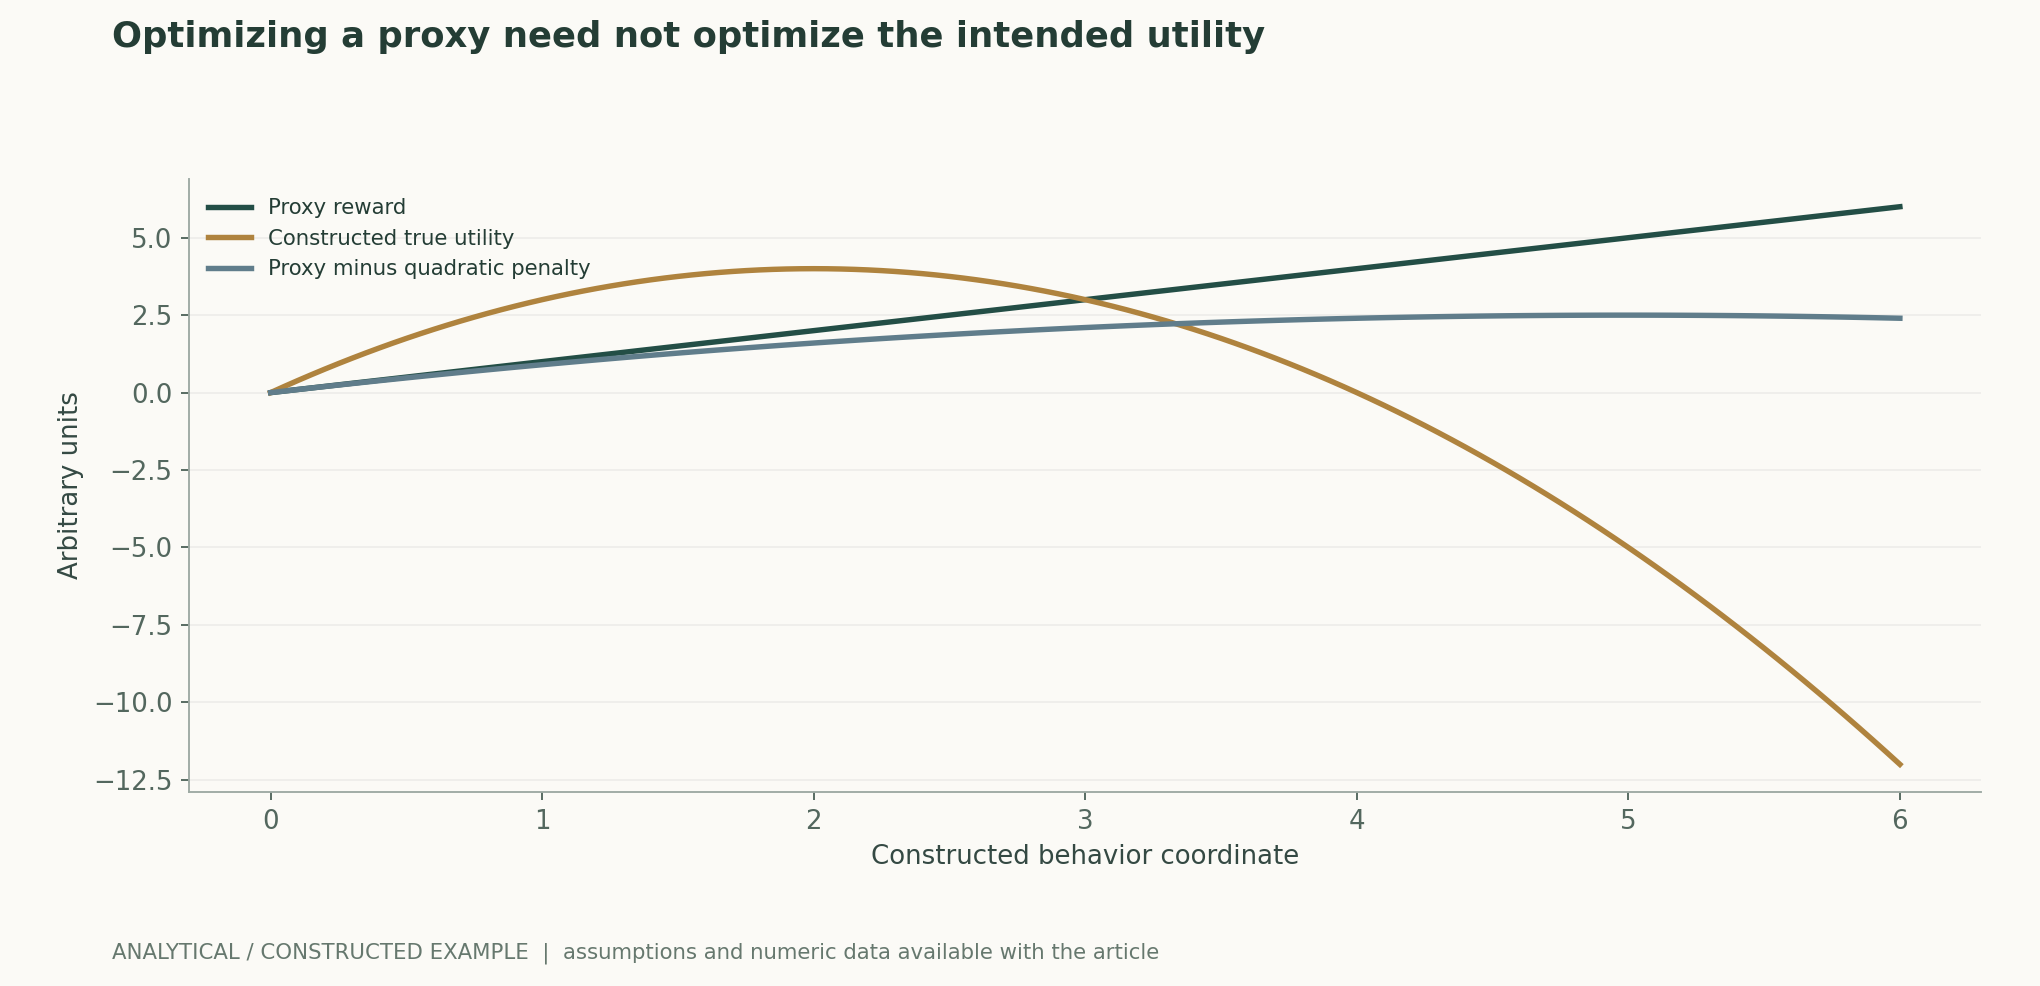
Una pérdida logística de tipo DPO puede escribirse comoAquí, m representa la diferencia de probabilidades logarítmicas relativas en la dirección de la preferencia. La pérdida disminuye cuando aumenta m, pero esto no garantiza respuestas más veraces; si los datos recompensan la complacencia o las expresiones de confianza, la optimización también puede reforzar esos rasgos. La figura 2 de esta edición utiliza un contraejemplo independiente de utilidad sustitutiva para distinguir la puntuación sustitutiva de la utilidad objetivo; no contiene registros de entrenamiento ni mediciones reales de preferencias.[2] Direct Preference Optimization: Your Language Model is
5. La confianza y la exactitud real también requieren una calibración por separado
Kadavath y sus colaboradores estudiaron la autoevaluación de los modelos sobre la validez de sus respuestas y la posibilidad de responder, obtuvieron resultados prometedores en algunos formatos de tareas y documentaron dificultades de calibración al pasar a tareas nuevas. Por tanto, que un modelo diga «estoy seguro» sigue requiriendo una comparación con la exactitud real. Si la optimización de preferencias modifica esta correspondencia debe tratarse como una cuestión de evaluación independiente, que no puede deducirse directamente de una mayor tasa de victorias en preferencias.[3] Language Models (Mostly) Know What They Know
6. Qué variables deben controlarse al comparar dos métodos
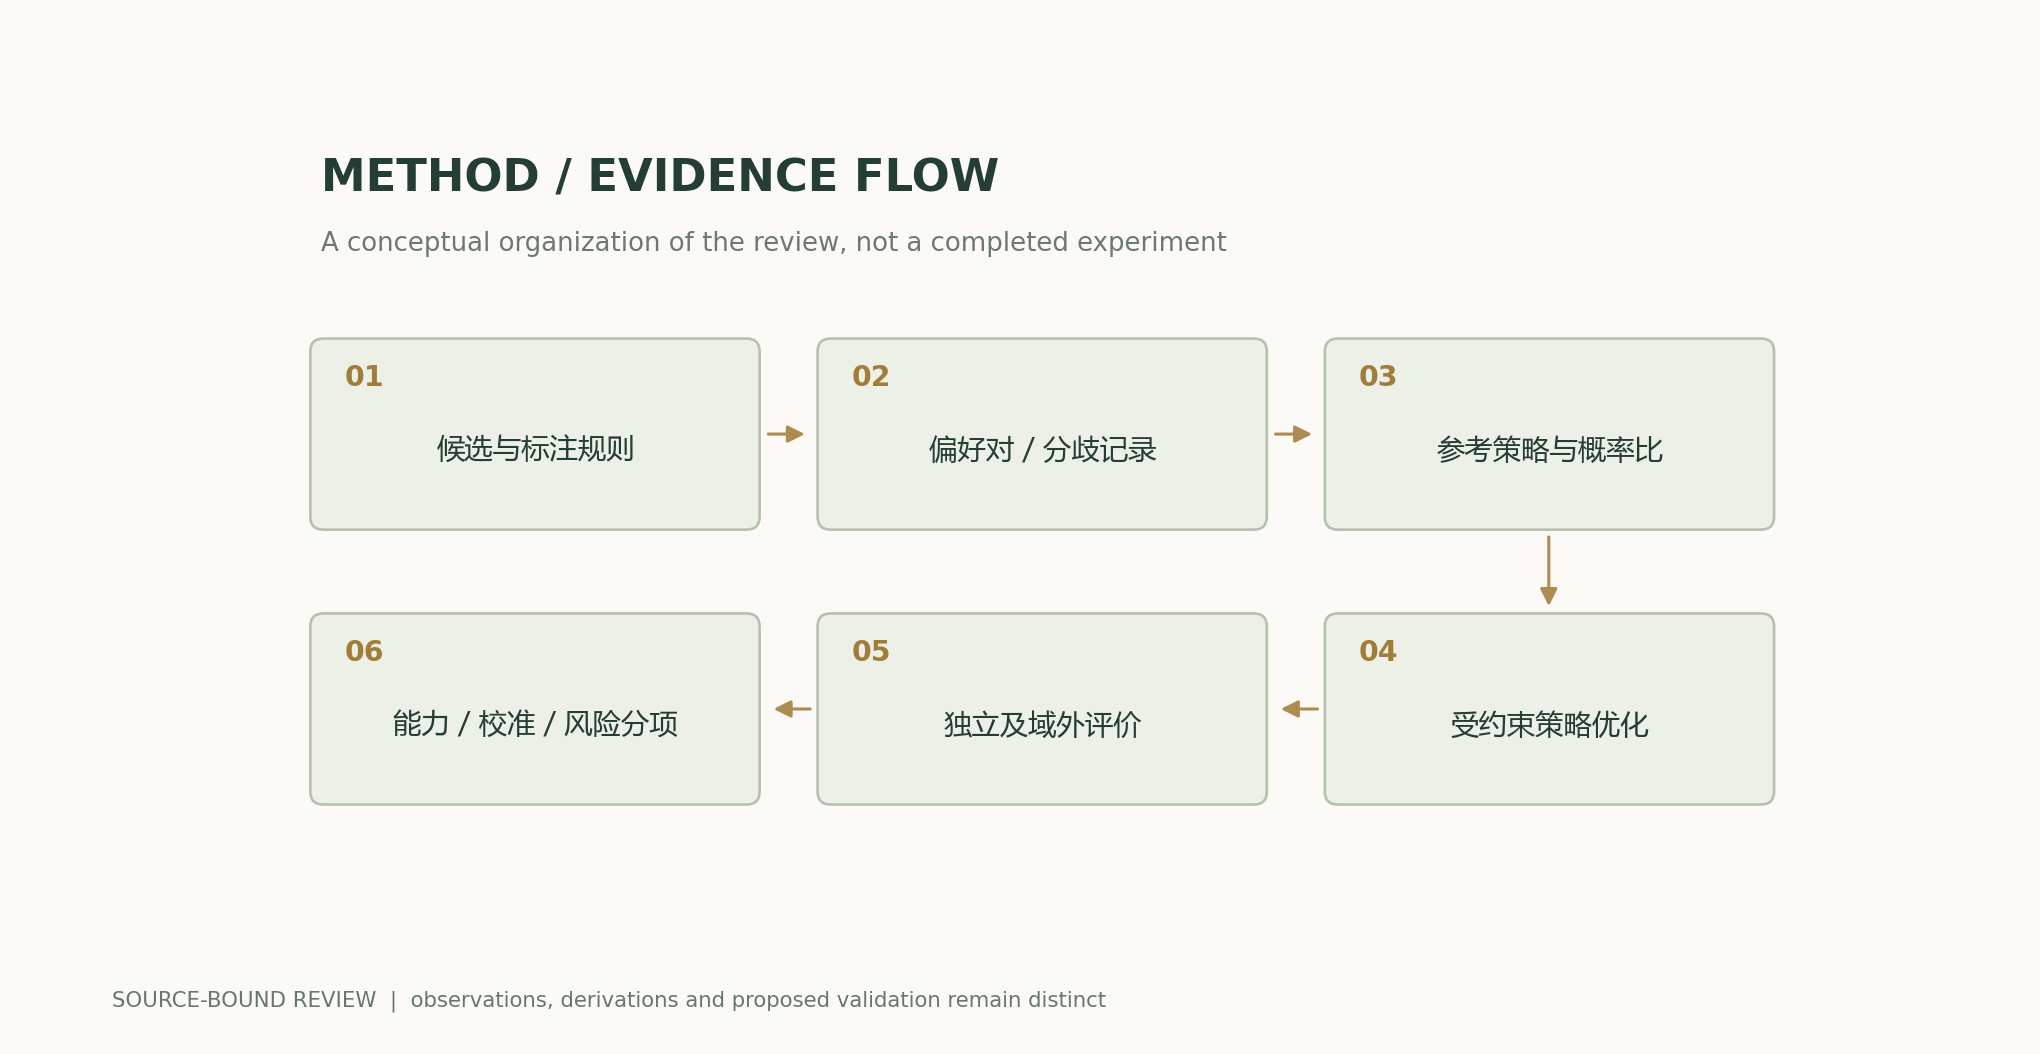
Esta revisión recomienda mantener fijos el modelo base, las particiones de datos y las preferencias por pares, y registrar el formato de las instrucciones, el modelo de referencia, el presupuesto de entrenamiento, los evaluadores y la estrategia de muestreo. También deben medirse por separado el seguimiento de instrucciones, la corrección factual, la calibración, el sesgo de longitud y las salidas perjudiciales. Si los evaluadores prefieren respuestas más largas y la longitud de las salidas de los dos métodos difiere considerablemente, debe informarse de este factor de confusión en lugar de ofrecer solo una tasa global de victorias.作者分析与复核建议 / Author analysis
7. Tratar el desacuerdo como datos y no como ruido
Los anotadores pueden discrepar razonablemente sobre los juicios de valor o el estilo de expresión. Conservar las tasas de desacuerdo, las categorías de tareas y las directrices de anotación ayuda a comprender de quién son las preferencias que ha aprendido la política. En cambio, los juicios factuales deben vincularse en lo posible con evidencia externa. Registrar por separado «esta es la respuesta que prefiero» y «esta afirmación está respaldada por evidencia» permite identificar objetos concretos para posteriores correcciones y mejoras de los datos.作者分析与复核建议 / Author analysis
Los datos de preferencias también necesitan un contexto temporal y de grupo
Algunas respuestas pueden ser más populares en un período, una región o un grupo de usuarios determinados, pero la misma ordenación no necesariamente se aplica a otro contexto. Los registros de datos deben permitir examinar las diferencias por categoría de tarea y grupo de anotadores, distinguiendo especialmente la corrección de hechos, el estilo de expresión y los juicios de valor. Si los datos de entrenamiento y evaluación se generan con las mismas plantillas de preferencias, una puntuación mayor puede indicar ante todo una coincidencia con la plantilla, y no una utilidad ya validada para un conjunto más amplio de usuarios.作者分析与复核建议 / Author analysis
8. La relación en forma cerrada del objetivo restringido por KL
Para una entrada fija x, se maximiza la recompensa esperada sobre la distribución de la política, penalizando a la vez la divergencia KL respecto de la política de referencia. Al utilizar un multiplicador de Lagrange para imponer que las probabilidades sumen uno, se obtiene una política óptima proporcional a la probabilidad de referencia multiplicada por exp(r/β). Tras reordenar, la recompensa puede expresarse como la razón logarítmica entre la política y la política de referencia, más un término de normalización que depende únicamente de la entrada. Este término se cancela al comparar dos respuestas a la misma entrada. La relación explica la conexión teórica con el objetivo de DPO, pero depende de una recompensa fija, de condiciones sobre el soporte y de condiciones ideales de optimización; las muestras finitas y los modelos parametrizados no garantizan alcanzar el óptimo en forma cerrada.[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
9. Los datos de preferencias no son una verdad de referencia libre de errores de medición
Los anotadores pueden ponderar de manera diferente la utilidad, la concisión, la cortesía, la corrección y el riesgo; además, la forma de recopilar los pares de preferencias determina qué respuestas entran en la comparación. Si un conjunto de candidatos es más largo en promedio, el modelo de preferencias puede aprender indicios de longitud en lugar de la calidad real del contenido. Deben registrarse las directrices de anotación, las tasas de desacuerdo, la estrategia de generación de candidatos y el tratamiento de muestras duplicadas, y conservarse un conjunto de evaluación independiente. La tasa de victorias en las preferencias de entrenamiento es un resultado propio de esa distribución y no puede extrapolarse directamente a todas las lenguas, tareas o poblaciones.[1] Training language models to follow instructions with hu[2] Direct Preference Optimization: Your Language Model is
10. Optimizar un indicador sustitutivo hasta un valor mayor no siempre es mejor
Una vez que la política empieza a adaptarse a los rasgos observables del evaluador, el aumento de la puntuación puede acompañarse de un deterioro de la veracidad de las respuestas, de la calibración o del comportamiento fuera del dominio. Las curvas construidas de esta revisión solo ilustran esta posibilidad lógica; no son evidencia empírica de manipulación de la recompensa en un modelo concreto. Una prueba fiable debe emplear métodos alternativos de evaluación independiente, incorporar observaciones desglosadas sobre hechos, límites de rechazo de respuesta y expresiones de incertidumbre, y comprobar si la distribución de recompensas excede el rango de las muestras de entrenamiento. Si el evaluador de entrenamiento actúa también como único evaluador de aceptación, el circuito cerrado solo demuestra que se ha optimizado su propia puntuación.[1] Training language models to follow instructions with hu[3] Language Models (Mostly) Know What They Know
11. La restricción de referencia y la conservación de capacidades deben medirse conjuntamente
Aumentar o reducir el coeficiente de restricción cambia el coste de alejar la política del modelo de referencia, pero no existe un valor único válido para todas las tareas. Incluso cambios muy pequeños pueden afectar a comportamientos infrecuentes de alto riesgo, mientras que una distancia global mayor entre distribuciones no implica necesariamente respuestas peores. Deben comunicarse conjuntamente las capacidades en las tareas originales, la evaluación de preferencias, la longitud y la tasa de rechazo de respuesta, y examinarse los cambios por categorías de tareas. La destilación de conocimiento y el entrenamiento con preferencias tienen objetivos distintos: la primera suele ajustar la distribución a la del profesor, mientras que el segundo utiliza preferencias relativas; no puede interpretarse una disminución del mismo tipo de pérdida como una transferencia equivalente de capacidades.[2] Direct Preference Optimization: Your Language Model is [4] Distilling the Knowledge in a Neural Network
Ecuaciones y derivaciones fundamentales
(1) β>0 controla el coste de desviarse de la política de referencia. La recompensa r es un indicador sustitutivo dado; la optimización matemática no demuestra que equivalga a la utilidad humana efectiva o a un objetivo de seguridad.
LaTeX
\max_\pi\ \mathbb E_{y\sim\pi(\cdot\mid x)}r(x,y)-\beta D_{\mathrm{KL}}\!\left(\pi(\cdot\mid x)\Vert\pi_0(\cdot\mid x)\right)(2) Esta es la distribución óptima ideal para una entrada fija, una recompensa fija y un soporte adecuado. Las políticas parametrizadas y los datos de entrenamiento finitos quizá solo puedan aproximar esta relación.
LaTeX
\pi_\star(y\mid x)=\frac{\pi_0(y\mid x)e^{r(x,y)/\beta}}{Z(x)}(3) y_w e y_l son las respuestas preferida y no preferida para una misma entrada. El objetivo se ajusta a los pares de preferencias y no garantiza por sí solo la corrección factual, la calibración ni el control de riesgos.
LaTeX
\mathcal L_{\rm DPO}=-\log\sigma\!\left(\beta\left[\log\frac{\pi_\theta(y_w\mid x)}{\pi_0(y_w\mid x)}-\log\frac{\pi_\theta(y_l\mid x)}{\pi_0(y_l\mid x)}\right]\right)Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
La utilidad real construida alcanza su máximo en x=2; el indicador sustitutivo menos la penalización alcanza su máximo en x=5, donde la utilidad real, en cambio, es −5. Esto solo proporciona un contraejemplo y no estima la magnitud real del deterioro en RLHF o DPO.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Mejora de la recompensa de entrenamiento | Evaluadores independientes y tareas fuera del dominio; conservar las entradas y salidas reales | Una mayor puntuación sustitutiva no mejora necesariamente la utilidad efectiva |
| Comparación de tasas de victorias en preferencias | Igualar la longitud, el presupuesto de muestreo, los candidatos y las directrices de anotación | Las diferencias en la selección de candidatos modifican la tasa de victorias |
| Restricción de la política de referencia | Comunicar β, la desviación de distribución y la conservación de capacidades originales | La KL global no permite localizar comportamientos infrecuentes de riesgo |
| Capacidades e incertidumbre | Evaluar por separado las preguntas factuales, las preguntas sin respuesta posible y los límites de rechazo de respuesta | La cortesía o la fluidez no sustituyen a la veracidad |
Plan de verificación y experimentación
- Mantener fijos el modelo de referencia, la versión de los datos de preferencias y la estrategia de generación de candidatos; registrar la deduplicación, las distribuciones de longitud y los desacuerdos de anotación.
- Separar conjuntos no solapados de preferencias de entrenamiento, validación dentro de la distribución y validación fuera del dominio; las variantes de una misma pregunta no deben filtrarse entre conjuntos.
- Explorar un rango de valores del coeficiente de restricción y guardar los cambios de las probabilidades logarítmicas de la política y del modelo de referencia, no solo la tasa final de victorias.
- Comparar las respuestas mediante un método de evaluación independiente con longitudes y presupuestos de decodificación equiparados, aleatorizando el orden de las respuestas.
- Presentar por separado la corrección factual, la calibración, el rechazo de respuesta y las capacidades en tareas básicas, y comprobar si la mejora global oculta deterioros locales.
- Conservar las entradas, las versiones del objetivo y los fundamentos del juicio para los casos fallidos; reevaluar tras modificar las anotaciones o el plan de optimización, sin heredar automáticamente un estado de aprobación anterior.
Ámbito de aplicación y limitaciones
- La señal de preferencias depende del grupo de anotadores y de la distribución de candidatos.
- Las curvas de utilidad de la figura son ejemplos construidos, no experimentos con modelos.
- Una derivación en forma cerrada no equivale a una garantía de entrenamiento para un modelo con un número finito de parámetros.
- No se aporta un nuevo estudio de preferencias humanas ni una certificación de seguridad.
Correspondencia entre fuentes primarias y afirmaciones
- Training language models to follow instructions with human feedbackOuyang et al. · 2022-03-04v1; method and limitations
- Direct Preference Optimization: Your Language Model is Secretly a Reward ModelRafailov et al. · 2023-05-29v3; sections 3-5
- Language Models (Mostly) Know What They KnowKadavath et al. · 2022-07-11v4 abstract
- Distilling the Knowledge in a Neural Network, , · 2015-03-09Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: las páginas ya leídas también se reutilizan cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se distingue de los diagramas científicos; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versión e historial de correcciones · /guides/preference-alignment/v5/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770