
الملخص
لا تُعد عبارة «نموذج بدقة 4 بت» وصفًا كاملًا يكفي لإعادة إنتاج تجربة: فقد تستخدم الأوزان والتنشيطات وذاكرة KV المؤقتة درجات دقة مختلفة، كما تؤثر مقاييس المجموعات ونقاط الصفر ومعالجة القيم المتطرفة في النتائج. ينطلق هذا المقال من خطأ التكميم القياسي لشرح سبب اعتماد تأثير خطأ الأوزان نفسه في مخرجات النموذج على توزيع المدخلات، ثم يناقش المراحل المختلفة التي تستهدفها GPTQ وAWQ وSmoothQuant. تقتصر الرسوم المصاحبة على حساب تخزين الأوزان الخام والخطأ في ظل افتراضات محددة، ولا تعرض نسب تسريع أو جودة أداء في المهام لم تُقَس.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
ترجمة الملخص الإنجليزي
يُحلَّل الاستدلال منخفض البتات من خلال خطأ التكميم والمعايرة ومحاسبة الذاكرة. يُعد ضغط الأوزان وحدها، وتكميم التنشيطات، وتحديد دقة ذاكرة KV المؤقتة تدخلات متميزة. تعرض الرسوم التحليلية حجم التخزين الخام وتقريبًا يفترض توزيعًا منتظمًا للخطأ، ولا تعرض دقة مهام أو سرعة مقاستين. ونصف اختبارات لتحول توزيع المعايرة والقيم المتطرفة والكلفة الإضافية للبيانات الوصفية والنوى الحسابية الفعلية على الجهاز.
1. صيغة التكميم لا تقتصر على عدد البتات
يحوّل التكميم الأفيني المنتظم الأعداد الحقيقية إلى نطاق محدود من الأعداد الصحيحة، ثم يعيد بناءها باستخدام مقياس ونقطة صفر. ويجب أن تحدد الصيغة الفعلية أيضًا النطاق ذي الإشارة واتجاه التجميع وحجم المجموعة ودقة المقياس وقواعد التقريب وطريقة القص. يتيح التجميع الأدق عادةً تكيفًا أفضل مع نطاقات القيم المحلية، لكنه يتطلب بيانات وصفية أكثر. لذلك قد تقابل تسمية 4 بت نفسها أعدادًا فعلية مختلفة من البايتات وأخطاء مختلفة. كما يؤثر تخطيط حزم الأوزان ونوى العتاد الحسابية في إمكان الحساب المباشر؛ فصغر الملف المضغوط لا يثبت عدم الحاجة إلى ذاكرة وسيطة لفك التكميم أثناء التشغيل.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
2. يتضخم خطأ الأوزان بفعل تغاير المدخلات
في الطبقة الخطية، يسبب اضطراب الأوزان ΔW خطأً في المخرجات مقداره ΔWx، ويرتبط التوقع الرياضي لمربعه بإحصاءات المدخلات من الرتبة الثانية. وقد يكون خطأ الأوزان صغيرًا في اتجاهات معينة، لكنه يسبب تغيرًا ملحوظًا في المخرجات بسبب كبر مقدار المدخلات في تلك الاتجاهات. تستخدم GPTQ معلومات مرتبطة بمدخلات المعايرة لمعالجة مسألة إعادة بناء الطبقة على نحو تقريبي؛ بينما تركز AWQ على معالجة الأوزان مع مراعاة التنشيطات. ولا تثبت هاتان الطريقتان صغر الخطأ لجميع المدخلات، بل تُجريان تقريبًا ضمن سياق معايرة محدد. ويجب أن يشمل التقييم أطوالًا ومهام ولغات خارج مجموعة المعايرة، للتحقق من عدم التطابق الإحصائي.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
3. القيم المتطرفة في التنشيطات تغيّر صعوبة التكميم
قد تفرض قلة من القيم الكبيرة في التنشيطات توسيع نطاق التكميم، مما يخفض دقة التمييز بين معظم القيم الاعتيادية. تنقل SmoothQuant صعوبة التكميم بين الأوزان والتنشيطات عبر إعادة تحجيم مكافئة للعمليات الخطية المتجاورة؛ ولا يزيل التحويل المكافئ بحد ذاته خطأ إعادة التكميم. وينبغي تسجيل معاملات التحجيم وطريقة المعايرة، وفحص المدخلات الطويلة والتوزيعات غير الاعتيادية. إن تخزين الأوزان وحدها بعدد قليل من البتات يختلف عن إجراء حسابات التنشيطات أيضًا بعدد قليل من البتات، ولا يجوز الاستناد إلى استنتاجات الجودة الخاصة بالأول لإثبات جودة الثاني.[3] SmoothQuant: Accurate and Efficient Post-Training Quant
4. يتطلب توفير الذاكرة محاسبة تفصيلية كاملة
يمكن حساب حجم تخزين الأوزان الخام بدقة من عدد المعاملات وعدد البتات، لكن استهلاك الذاكرة أثناء التشغيل يشمل أيضًا المقاييس ونقاط الصفر والطبقات غير المكمَّمة ومساحة العمل والتنشيطات وذاكرة KV المؤقتة. وقد تجعل السياقات الطويلة ذاكرة KV المكوّن المهيمن، فلا يستمر إجمالي ذاكرة الجهاز بالضرورة في الانخفاض تناسبيًا عند تقليل عدد بتات الأوزان. لا تمثل معاملات 7B في الرسم سوى مثال عددي لعدد من القيم القياسية مقداره 7×10^9؛ وتُعرض GB وGiB كلٌّ على حدة لتجنب الخلط بين الوحدات. وأي استنتاج بشأن ذروة استهلاك الذاكرة لا يزال يتطلب القياس على جهاز فعلي وفي ظروف حجم الدفعة الفعلية.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
5. يجب الفصل الصارم بين المعايرة والتحقق
تُستخدم عينات المعايرة لاختيار المقاييس أو تقريب إحصاءات المدخلات، بينما تُستخدم عينات التحقق لتقدير الجودة على توزيعات غير مشاهدة. وإذا استمر تعديل حجم المجموعة وعتبات القيم المتطرفة استنادًا إلى مجموعة الاختبار، فإنها تكون قد استُخدمت بالفعل في التطوير. يُوصى بتثبيت مجموعة معايرة مستقلة، وتحديد تقسيمات المهام والأطوال مسبقًا، وحفظ أمثلة الإخفاق ومخرجات خط الأساس بالفاصلة العائمة. وفي المهام المتعلقة بالسلامة أو صحة المعلومات، ينبغي أيضًا فحص الأخطاء النادرة بدلًا من الاكتفاء بمقارنة متوسط واحد للحيرة. ويجب أن يوضح التقرير النهائي، بعد المفاضلة بين إعدادات تكميم متعددة، ميزانية البحث.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
6. تعتمد مكاسب السرعة على نوى حسابية قابلة للتنفيذ
قد يخفف التخزين بعدد قليل من البتات الضغط على عرض النطاق، لكنه قد يزيد أيضًا تكاليف فك الحزم وفك التكميم وتحويل الصيغ. تختلف اختناقات الأداء بين فك الترميز بدفعات صغيرة والملء المسبق بدفعات كبيرة وبين أنواع العتاد، وقد يتغير ترتيب السرعات. ينبغي أن تفصل التجارب بين التحميل والملء المسبق وفك الترميز رمزًا برمز وزمن الاستجابة من البداية إلى النهاية، مع تسجيل حجم الدفعة والطول والدقة وإصدار النواة الحسابية. لا توضح محاسبة البايتات في هذا المقال إلا الحد الأدنى للتخزين، ولا يفسر تقريب الضوضاء المنتظمة إلا دقة التمييز؛ ولا يمكن لأي منهما أن يحل محل القياس الفعلي على الجهاز أو فحص جودة الأداء في المهام.[1] GPTQ: Accurate Post-Training Quantization for Generativ[3] SmoothQuant: Accurate and Efficient Post-Training Quant
المعادلات الأساسية واشتقاقاتها
(1) يمثّل s المقياس، ويمثّل z نقطة الصفر؛ ويجب التصريح بقواعد التجميع والتقريب والقص.
LaTeX
\hat w=s\left[\operatorname{clip}(\operatorname{round}(w/s)+z,q_{\min},q_{\max})-z\right](2) علاقة دقيقة من الرتبة الثانية عند تثبيت خطأ الأوزان، توضّح أن إحصاءات المدخلات تغيّر خطأ المخرجات.
LaTeX
\mathbb E\|\Delta W x\|_2^2=\operatorname{tr}(\Delta W\,\mathbb E[xx^\top]\,\Delta W^\top)(3) لا تشمل المعادلة الأولى البيانات الوصفية؛ وتتطلب الثانية افتراضات منها عدم التشبع والتوزيع المنتظم التقريبي للخطأ، ولا يجوز تطبيقها على أوزان أي نموذج دون تمييز.
LaTeX
M_{\mathrm{raw}}=Nb/8,\qquad \operatorname{Var}(e)\approx\Delta^2/12مسار المنهج والأدلة
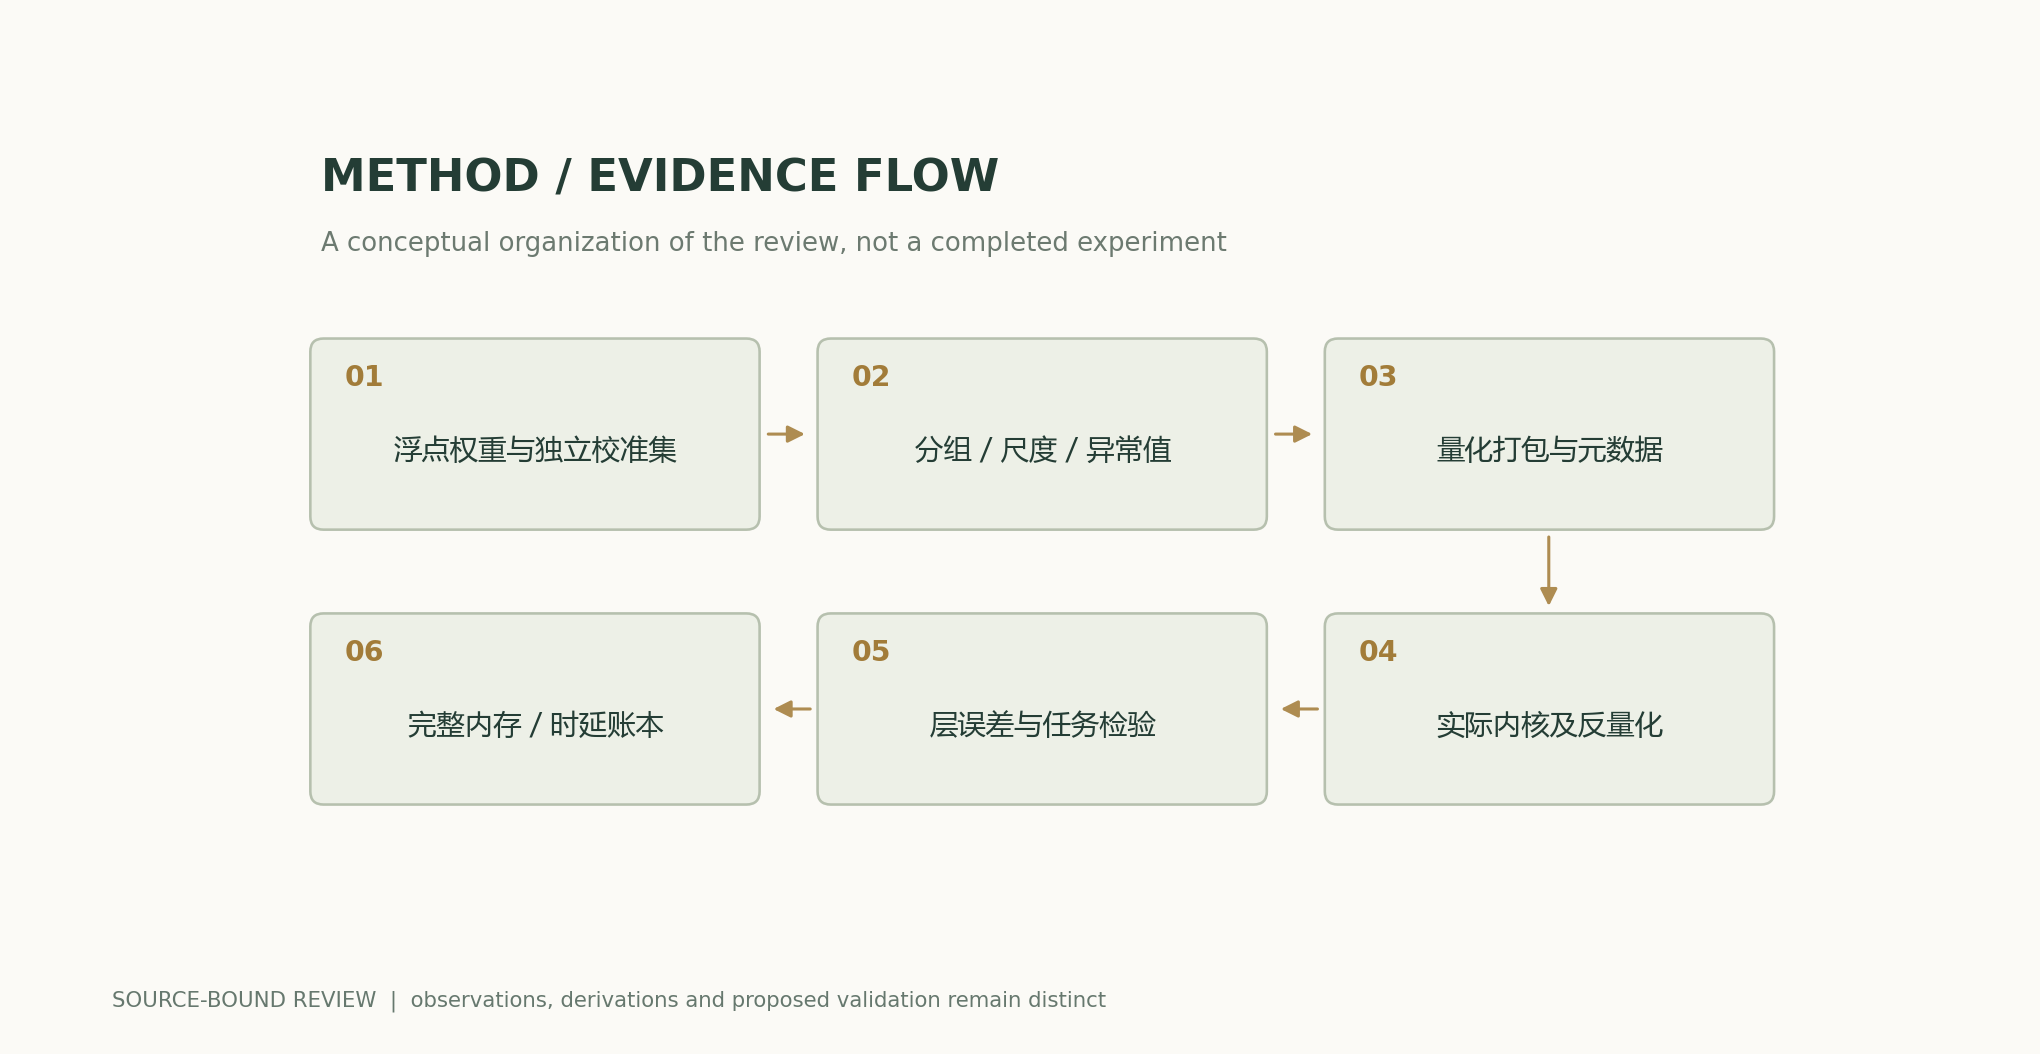
رسوم تحليلية وأمثلة عددية
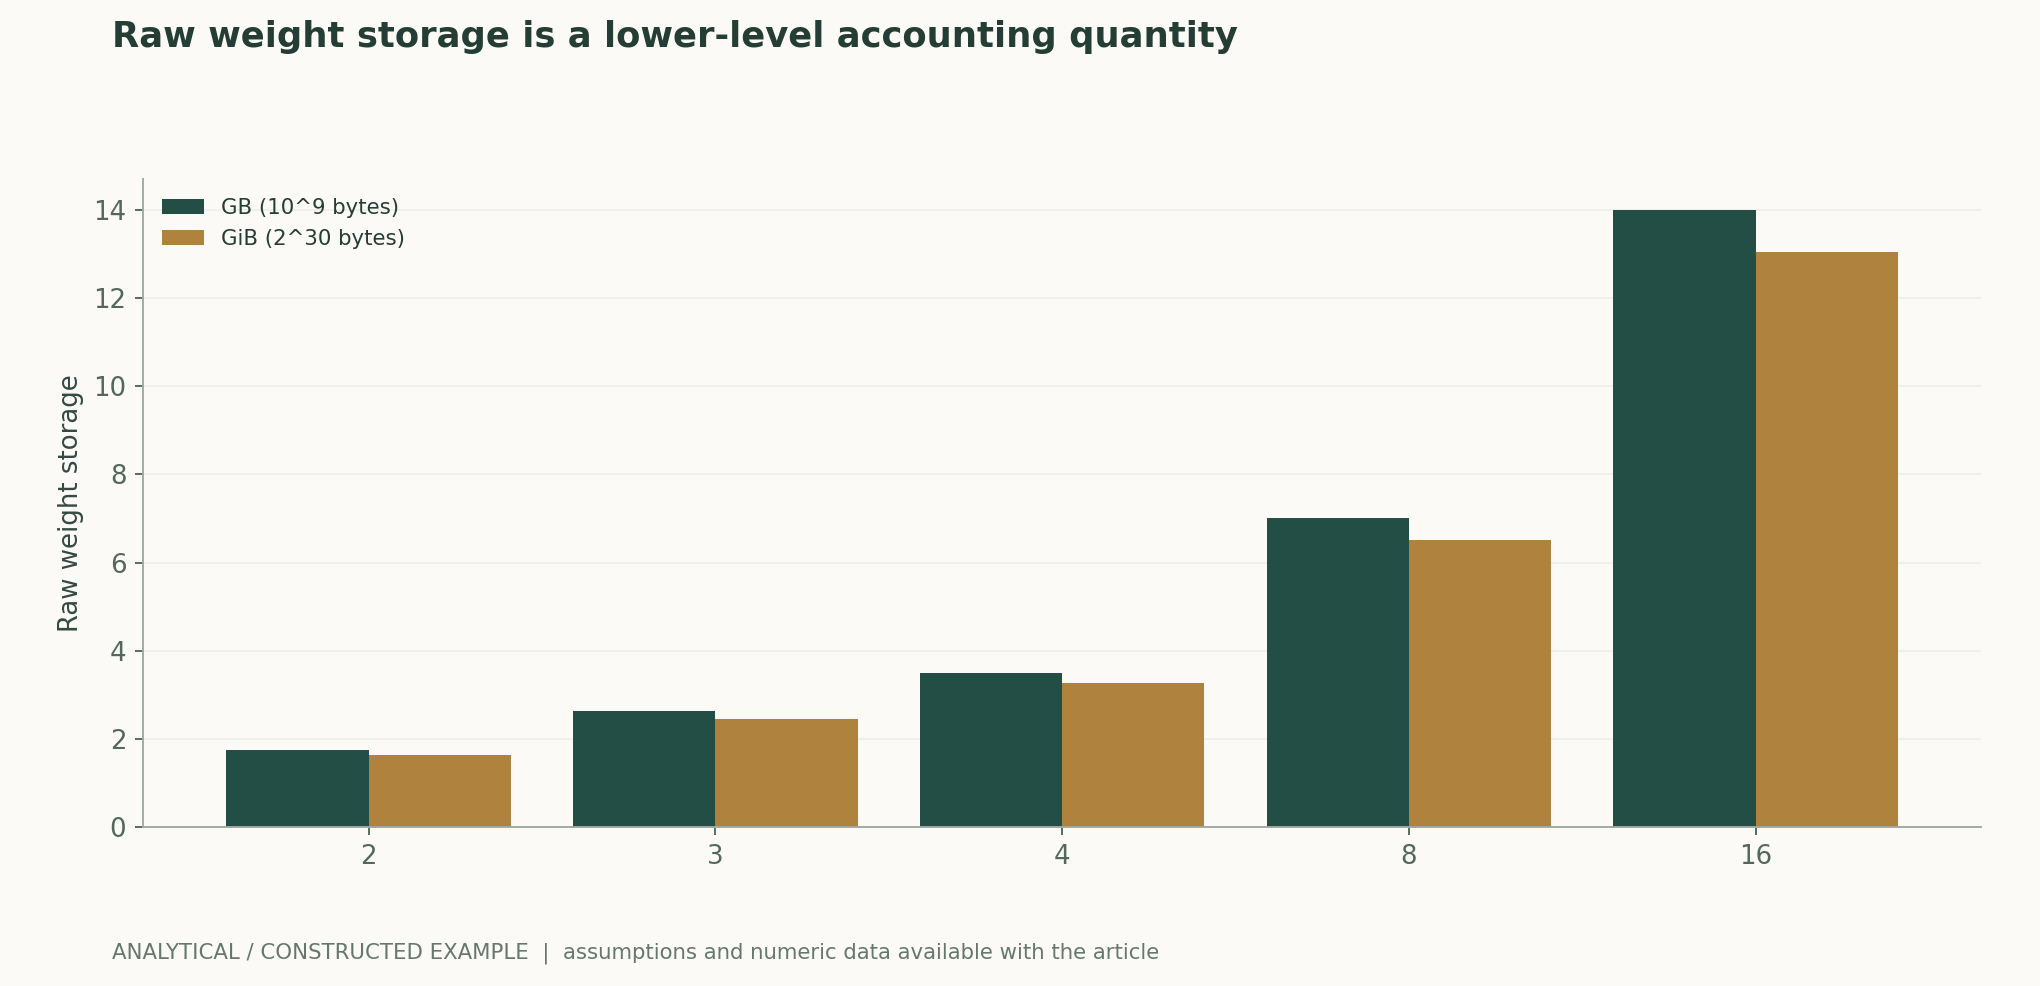
مثال محلول قابل لإعادة الحساب
يشغل 7×10^9 وزنًا، عند حزمها حزمًا مثاليًا بدقة 4 بت، حجمًا مقداره 3.5 GB، أي نحو 3.260 GiB. ولم تُحتسب بعد مقاييس المجموعات والطبقات غير المكمَّمة وKV ومساحة العمل، ولذلك لا يمكن وصف هذا الحجم بأنه إجمالي ذاكرة الجهاز اللازمة للنشر.
مقارنة المناهج
| المنهج أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| تكميم الأوزان | تحديد التجميع والمقاييس والطبقات غير المكمَّمة والتخطيط | حجم الملف لا يساوي ذروة ذاكرة الجهاز أثناء التشغيل |
| تكميم التنشيطات | قياس القيم المتطرفة وتغيرات توزيع المعايرة بصورة مستقلة | لا يمكن تعميم نتائج الأوزان منخفضة البتات على التنشيطات |
| تقدير الخطأ | قياس إعادة بناء الطبقات وجودة الأداء في المهام معًا | متوسط الخطأ التربيعي للأوزان MSE يتجاهل اتجاهات المدخلات |
| قياس الأداء | تثبيت العتاد والنواة الحسابية وحجم الدفعة والطول | انخفاض عدد البايتات لا يضمن تسريعًا بالنسبة نفسها |
خطة المراجعة والتجارب
- تثبيت خط الأساس بالفاصلة العائمة ومجزّئ الرموز والتقسيم المستقل بين المعايرة والتحقق، مع تسجيل المصادر وقيم التجزئة.
- تسجيل دقة الأوزان والتنشيطات وKV ومعاملات التجميع تسجيلًا كاملًا، وسرد جميع الطبقات التي أُبقيت بالفاصلة العائمة.
- إحصاء بايتات الملفات الفعلية والبيانات الوصفية للمقاييس ومساحة عمل فك التكميم وذروة ذاكرة الجهاز.
- قياس خطأ مخرجات الطبقات والحيرة والنجاح في المهام والإخفاقات النادرة كلٌّ على حدة، دون استخدام مقياس واحد بديلًا عن الجميع.
- اختبار انتقال المعايرة عبر أطوال ولغات وتوزيعات مدخلات مختلفة، وحفظ الشرائح الأسوأ أداءً.
- تكرار قياسات زمن الملء المسبق وفك الترميز بصورة مستقلة على نواة حسابية وعتاد ثابتين، والإبلاغ عن المكاسب في ظل قيود الجودة.
نطاق الانطباق والقيود
- لا توجد قياسات فعلية لتكميم نموذج حقيقي أو للتسريع على الجهاز.
- لا ينطبق تقريب الخطأ المنتظم على جميع توزيعات الأوزان.
- لا تشمل بايتات الأوزان الخام KV ومساحة العمل.
- يجب التحقق بصورة مستقلة من الجودة خارج مجموعة المعايرة.
مطابقة المصادر الأولية بالادعاءات
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, , , · 2022-10-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, , , , , , , , , · 2023-06-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, , , , , · 2022-11-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقال
BibTeXRISCSL JSONTXTالمقال JSON
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ كتبها Codex، وهو نظام ذكاء اصطناعي، وأجرى اشتقاقاتها التحليلية استنادًا إلى الأدبيات الأولية المدرجة. لا يتضمن هذا الموقع سجلًا لتحكيم مستقل لهذا المقال أو لتجارب أصلية على النماذج.
تعديل أداء القارئ: تُعاد أيضًا الاستفادة من الصفحة المقروءة مسبقًا عندما يعيد طلب HEAD حديث الحالة 200 وتبقى قيمة ETag مطابقة. ويظل متن المقال والمعادلات والمصادر وبيانات الرسوم العلمية كما كانت في الإصدار السابق.
يُفصل الغلاف المفاهيمي عن الرسوم العلمية؛ وتُحسب الرسوم العلمية من معادلات متاحة علنًا وافتراضات مصرَّح بها، وتُنسب جميع نتائج الأوراق الأصلية إلى مصادرها.
سجل المؤلف والإصدارات والتصحيحات · /guides/quantization-low-bit-inference/v1/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770