
要旨
「4ビットモデル」という表現は、実験の再現に十分な完全な記述ではない。重み、活性値、KVキャッシュには異なる精度が用いられる可能性があり、グループごとのスケール、ゼロ点、外れ値の処理も結果を変える。本稿ではスカラー量子化誤差を出発点に、同じ重み誤差がモデル出力に与える影響が入力分布に依存する理由を説明し、さらにGPTQ、AWQ、SmoothQuantが対象とする段階の違いを論じる。掲載図は重みの生の保存容量と限定した仮定の下での誤差のみを算定しており、未測定の高速化率やタスク品質は報告しない。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
英文要旨の日本語訳
低ビット推論を、量子化誤差、較正、メモリ使用量の算定を通じて分析する。重みのみの圧縮、活性値の量子化、KVキャッシュの精度は、それぞれ異なる介入である。解析図が示すのは生の保存容量と一様誤差近似であり、実測されたタスク精度や速度ではない。較正分布の変化、外れ値、メタデータのオーバーヘッド、実際のデバイスカーネルに関する試験を記述する。
1. 量子化形式はビット幅だけでは決まらない
一様アフィン量子化は実数を有限の整数範囲に写像し、スケールとゼロ点を用いて再構成する。実際の形式では、符号付きの値域、グループ化の方向、グループサイズ、スケールの精度、丸め規則、クリッピング方法も明示する必要がある。グループ化を細かくするほど、一般に局所的な値域に適応しやすくなる一方、より多くのメタデータを要する。したがって、同じ4ビットという表示でも、実効的なバイト数と誤差は異なりうる。重みのパッキング配置とハードウェアカーネルも、直接計算できるかどうかに影響する。圧縮ファイルが小さいことは、実行時に逆量子化バッファが不要であることの証明にはならない。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
2. 重み誤差は入力の共分散を通じて増幅される
線形層では、重みの摂動ΔWが出力誤差ΔWxを生じ、その大きさの二乗の期待値は入力の二次統計量に依存する。ある方向の重み誤差が小さくても、その方向の入力の振幅が大きければ、顕著な出力変化を生じうる。GPTQは較正入力に関連する情報を利用して層の再構成問題を近似的に扱い、AWQは活性値を考慮した重みの処理を重視する。これらはすべての入力で誤差が小さいことを証明するものではなく、所与の較正条件の下で近似を行うものである。評価では、較正集合に含まれない長さ、タスク、言語を取り入れ、統計的な不整合を確認しなければならない。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
3. 活性値の外れ値が量子化の難しさを変える
活性値に含まれる少数の大きな値は、量子化範囲の拡大を必要とし、多数の通常値に対する分解能を低下させる可能性がある。SmoothQuantは、隣接する線形演算の等価なスケーリングにより、量子化の難しさを重みと活性値の間で移す。等価変換そのものが再量子化誤差を除去するわけではない。スケーリングパラメータと較正方法を記録し、長い入力や非典型的な分布を調べるべきである。重みだけを低ビットで保存する方式と、活性値も低ビットで計算する方式は異なり、前者の品質に関する結論をもって後者の品質を証明することはできない。[3] SmoothQuant: Accurate and Efficient Post-Training Quant
4. メモリ削減には内訳を含む完全な算定が必要である
重みの生の保存容量はパラメータ数とビット幅から正確に計算できるが、実行時にはスケール、ゼロ点、非量子化層、ワークスペース、活性値、KVキャッシュも含まれる。長いコンテキストではKVが支配的になる可能性があり、重みのビット幅を減らしてもデバイスメモリ総量が引き続き比例して減るとは限らない。図中の7Bパラメータは、7×10^9個のスカラーという個数の例にすぎない。単位の混同を避けるため、GBとGiBを別々に報告する。ピークメモリに関するいかなる結論も、実際のデバイスとバッチ条件での測定を必要とする。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
5. 較正と検証は厳密に分離しなければならない
較正サンプルはスケールの選択や入力統計量の近似に用い、検証サンプルは未知の分布における品質の推定に用いる。テスト集合に基づいてグループサイズや外れ値の閾値を繰り返し調整すれば、そのテスト集合はすでに開発に使われている。独立した較正集合を固定し、タスクと長さの層別区分を事前に規定し、失敗例と浮動小数点ベースラインの出力を保存することを推奨する。安全性や事実性に関わるタスクでは、単一の平均パープレキシティを比較するだけでなく、低頻度の誤りも調べるべきである。複数の量子化設定を選別した後の最終報告では、探索予算を明示する必要がある。[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
6. 速度向上は実行可能なカーネルに依存する
低ビット保存は帯域幅への負荷を軽減しうる一方、アンパッキング、逆量子化、形式変換のコストを増加させる可能性もある。小バッチのデコード、大バッチのプリフィル、異なるハードウェアではボトルネックが異なり、速度の順位が変わることがある。実験では、ロード、プリフィル、トークンごとのデコード、エンドツーエンドのレイテンシを分け、バッチサイズ、長さ、精度、カーネルのバージョンを記録するべきである。本稿のバイト数算定が示せるのは保存容量の下限のみであり、一様雑音近似が説明できるのは分解能のみである。いずれも、デバイス上での実測やタスク品質の確認に代わるものではない。[1] GPTQ: Accurate Post-Training Quantization for Generativ[3] SmoothQuant: Accurate and Efficient Post-Training Quant
主要な数式と導出
(1) sはスケール、zはゼロ点である。グループ化、丸め、クリッピングの規則を明示しなければならない。
LaTeX
\hat w=s\left[\operatorname{clip}(\operatorname{round}(w/s)+z,q_{\min},q_{\max})-z\right](2) 重み誤差を固定した場合の厳密な二次関係であり、入力統計量が出力誤差を変えることを示す。
LaTeX
\mathbb E\|\Delta W x\|_2^2=\operatorname{tr}(\Delta W\,\mathbb E[xx^\top]\,\Delta W^\top)(3) 最初の式はメタデータを含まない。次の式は飽和がないことや誤差が近似的に一様であることなどの仮定を必要とし、任意のモデルの重みに適用することはできない。
LaTeX
M_{\mathrm{raw}}=Nb/8,\qquad \operatorname{Var}(e)\approx\Delta^2/12方法とエビデンスの流れ
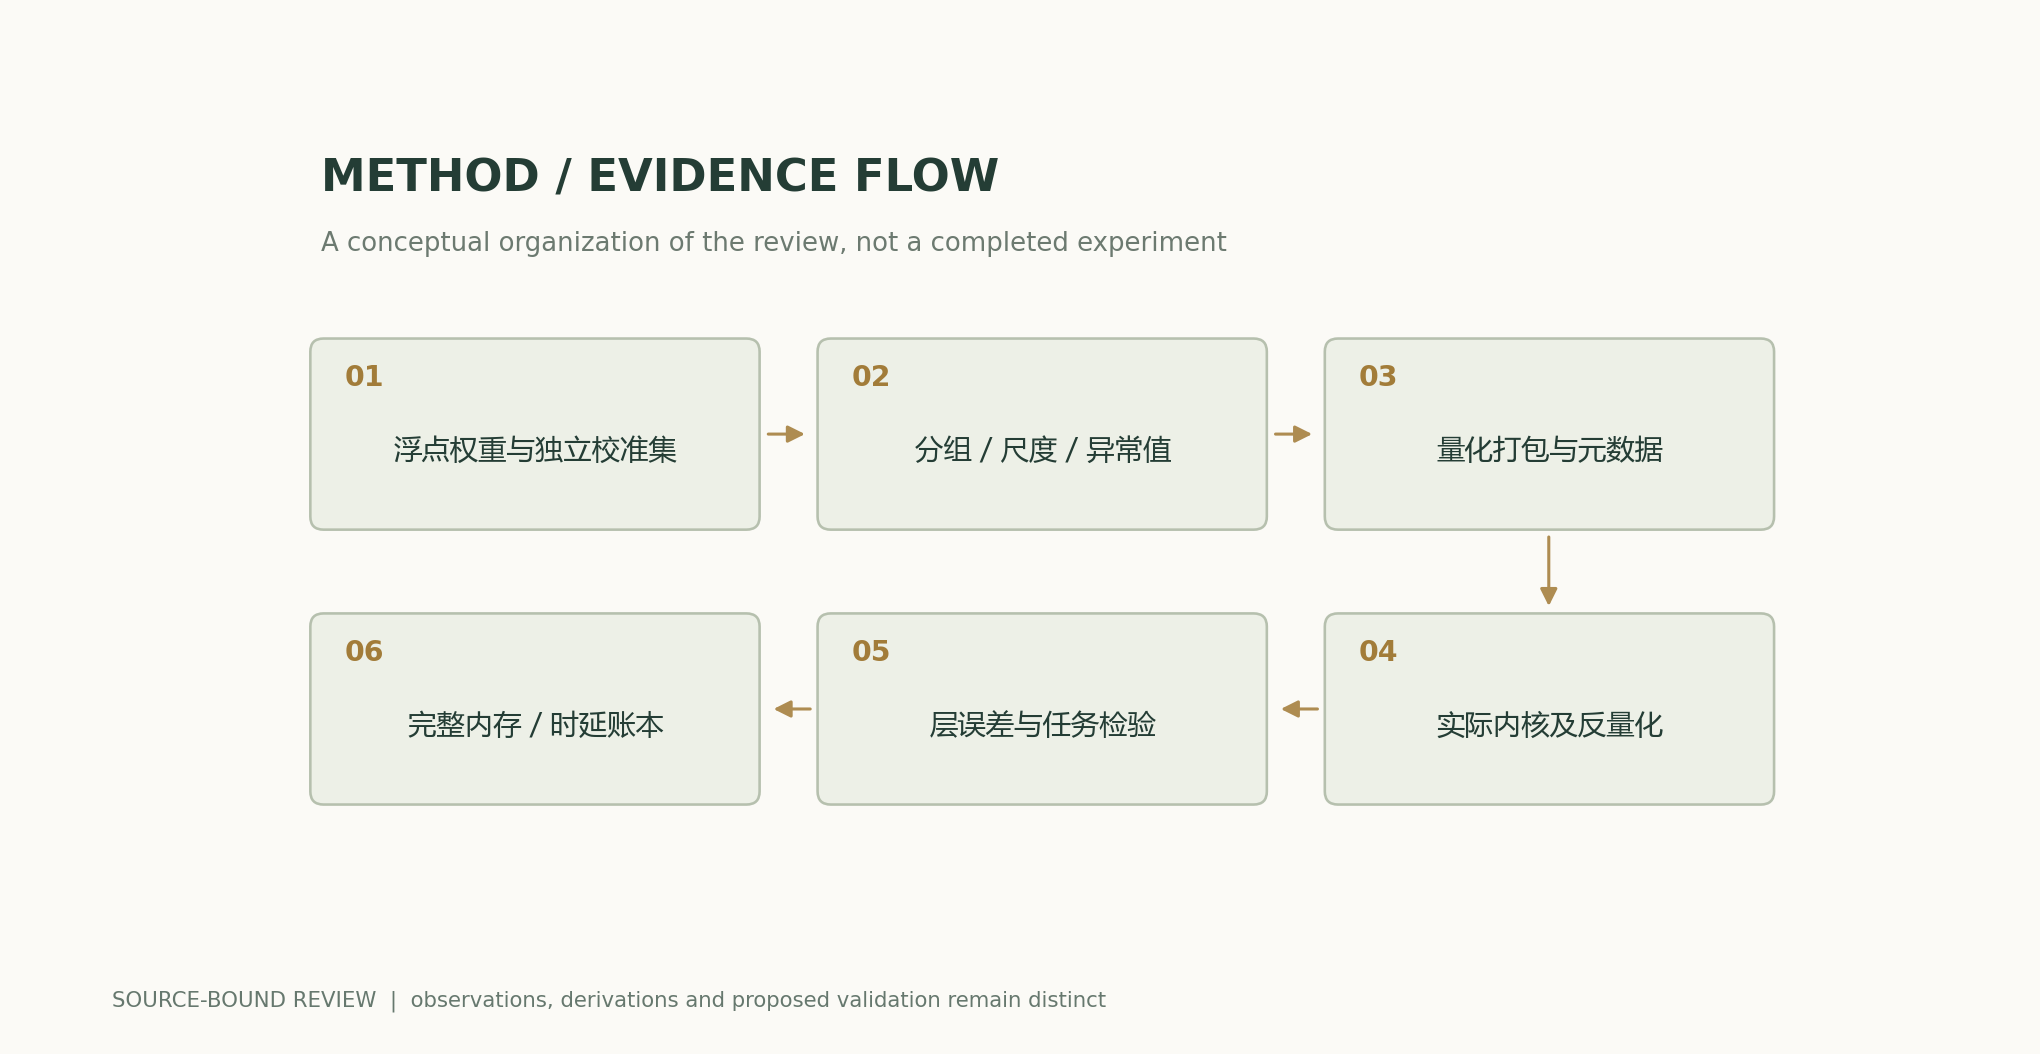
解析図と数値例
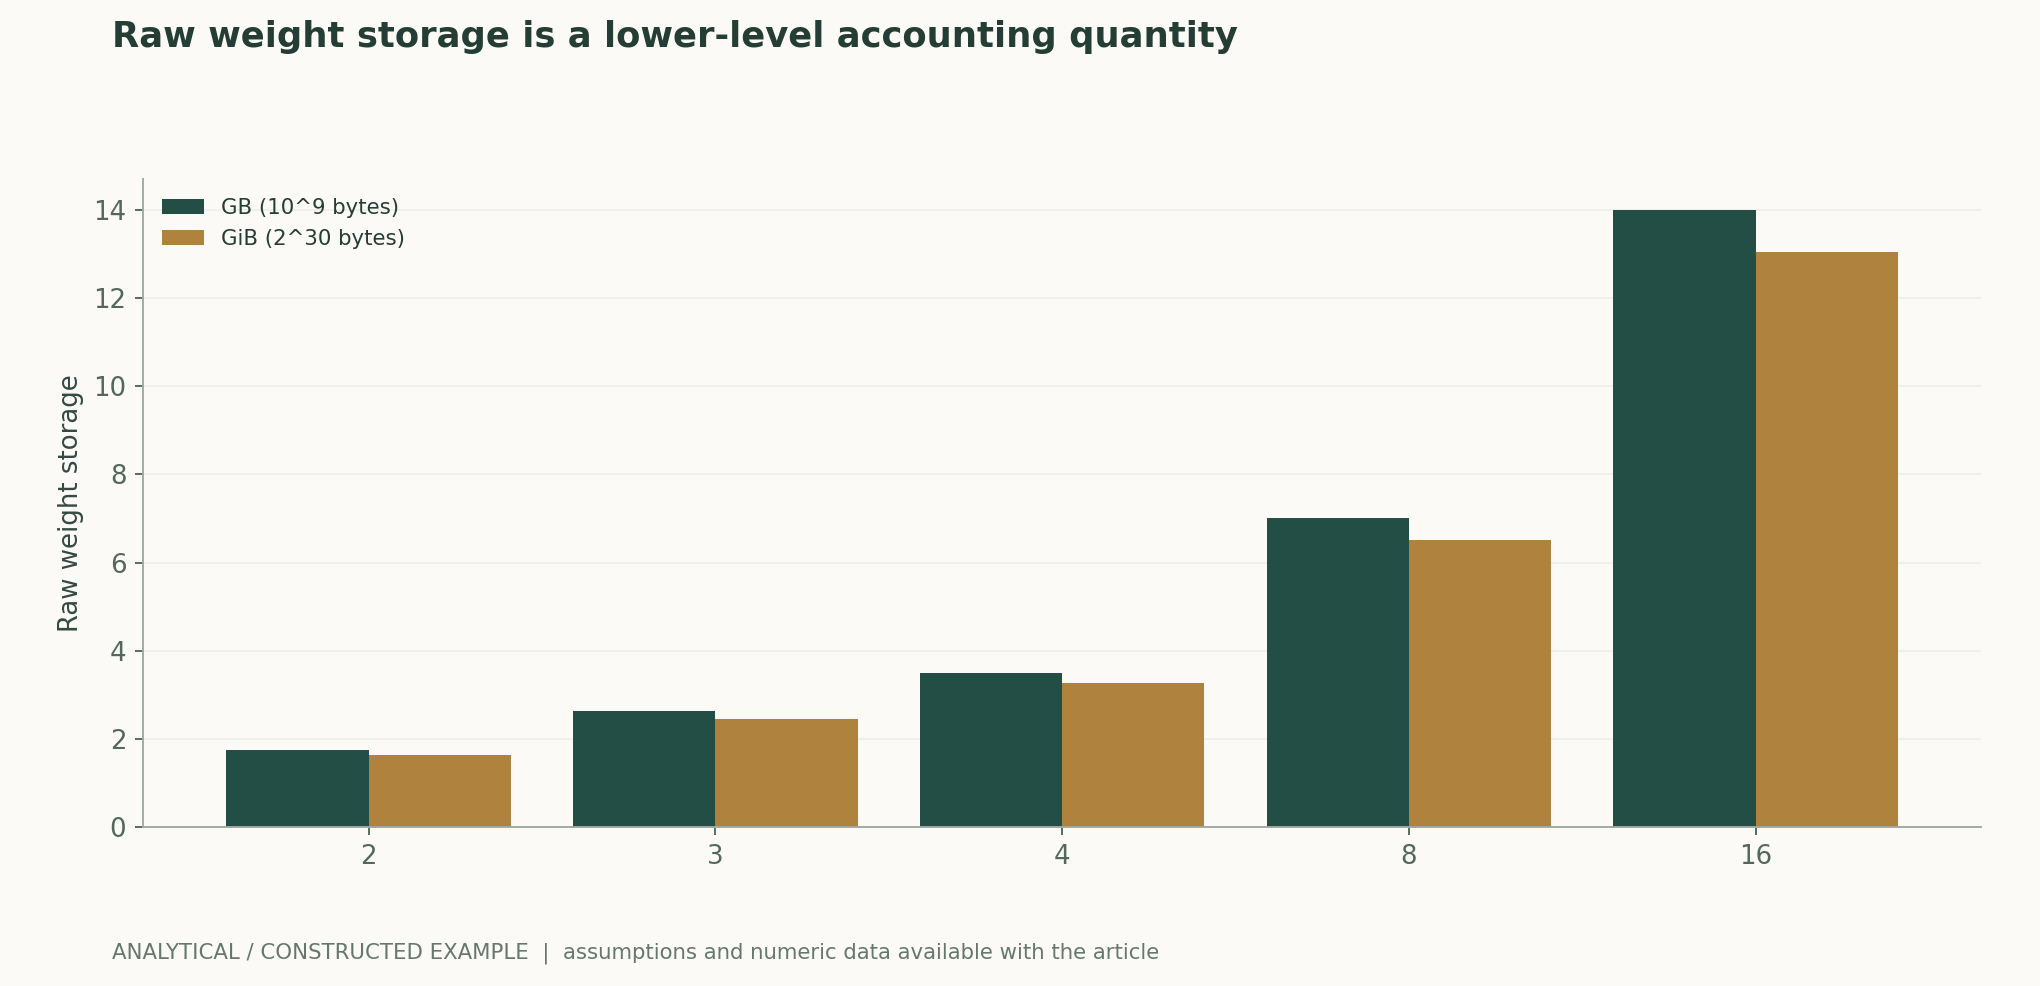
再計算可能な計算例
7×10^9個の重みを4ビットで理想的にパッキングすると、3.5 GB、約3.260 GiBとなる。グループごとのスケール、非量子化層、KV、ワークスペースはまだ含まれておらず、デプロイに必要なデバイスメモリ全体とは呼べない。
手法の比較
| 手法または判断 | 統制変数と測定 | 破綻する条件と解釈 |
|---|---|---|
| 重みの量子化 | グループ化、スケール、非量子化層、配置を明示する | ファイルサイズは実行時のピークデバイスメモリと等しくない |
| 活性値の量子化 | 外れ値と較正分布の変化を独立に測定する | 重みの低ビット化の結果を活性値へ外挿することはできない |
| 誤差推定 | 層の再構成とタスク品質の両方を測定する | 重みの平均MSEは入力の方向を考慮しない |
| 性能測定 | ハードウェア、カーネル、バッチサイズ、長さを固定する | バイト数の削減は同比率の高速化を保証しない |
再検証と実験の計画
- 浮動小数点ベースライン、トークナイザ、独立した較正・検証の分割を固定し、出典とハッシュを記録する。
- 重み、活性値、KVの精度とグループ化パラメータを漏れなく記録し、浮動小数点のまま保持するすべての層を列挙する。
- 実際のファイルのバイト数、スケールのメタデータ、逆量子化ワークスペース、デバイスのピークメモリを集計する。
- 層の出力誤差、パープレキシティ、タスク成功、低頻度の失敗を個別に測定し、単一の指標ですべてを代替しない。
- 異なる長さ、言語、入力分布で較正の転移を検証し、成績が最も悪い層別区分を保存する。
- 固定したカーネルとハードウェアでプリフィルとデコードの時間測定を独立に反復し、品質制約の下での利得を報告する。
適用範囲と限界
- 実際のモデル量子化やデバイス上の高速化に関する実測はない。
- 一様誤差近似は任意の重み分布に適用できるわけではない。
- 重みの生のバイト数にはKVとワークスペースが含まれない。
- 較正集合外の品質は別途検証する必要がある。
一次資料と主張の対応
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, , , · 2022-10-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, , , , , , , , , · 2023-06-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, , , , , · 2022-11-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、列挙した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿について独立した査読や独自のモデル実験を行った記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙図と科学図は区別している。科学図は公開された数式と明示された仮定から計算し、原著論文の結果にはすべて帰属先を明記している。
著者、版、訂正履歴 · /guides/quantization-low-bit-inference/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・版履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770