
Resumen
Un «modelo de 4 bits» no es una descripción completa que permita reproducir un experimento: los pesos, las activaciones y la caché KV pueden utilizar precisiones distintas, y las escalas de grupo, los puntos cero y el tratamiento de valores atípicos también modifican los resultados. Partiendo del error de cuantización escalar, este artículo explica por qué el efecto de un mismo error de los pesos sobre las salidas del modelo depende de la distribución de entrada, y examina después las distintas etapas que abordan GPTQ, AWQ y SmoothQuant. Los gráficos adjuntos solo contabilizan el almacenamiento bruto de los pesos y el error bajo supuestos delimitados; no presentan factores de aceleración ni calidad en las tareas que no se hayan medido.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
Traducción del resumen original en inglés
La inferencia de pocos bits se analiza mediante el error de cuantización, la calibración y la contabilidad de memoria. La compresión exclusiva de los pesos, la cuantización de activaciones y la precisión de la caché KV son intervenciones distintas. Los gráficos analíticos presentan el almacenamiento bruto y una aproximación de error uniforme, no mediciones de exactitud en las tareas ni de velocidad. Describimos pruebas sobre cambios en la distribución de calibración, valores atípicos, sobrecarga de metadatos y núcleos reales del dispositivo.
1. Un formato de cuantización comprende más que el ancho de bits
La cuantización afín uniforme transforma números reales en un rango finito de enteros y después los reconstruye mediante una escala y un punto cero. Un formato concreto también debe especificar el rango con signo, la dirección de agrupación, el tamaño de grupo, la precisión de las escalas, las reglas de redondeo y el método de recorte. Una agrupación más fina suele adaptarse mejor a los rangos locales de valores, pero requiere más metadatos. Por tanto, una misma etiqueta de 4 bits puede corresponder a distintos números efectivos de bytes y errores. La disposición de empaquetado de los pesos y los núcleos del hardware también influyen en la posibilidad de calcular directamente; que el archivo comprimido sea pequeño no demuestra que durante la ejecución no se necesiten búferes de descuantización.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
2. El error de los pesos se amplifica mediante la covarianza de entrada
En una capa lineal, una perturbación de los pesos ΔW produce un error de salida ΔWx, cuya magnitud cuadrática esperada depende de las estadísticas de segundo orden de la entrada. Los errores de los pesos en ciertas direcciones pueden ser pequeños y, aun así, producir cambios importantes en la salida porque la entrada tiene gran magnitud en esas direcciones. GPTQ utiliza información asociada a las entradas de calibración para abordar aproximadamente el problema de reconstrucción de capas; AWQ destaca el tratamiento de los pesos teniendo en cuenta las activaciones. Estos métodos no demuestran que el error sea pequeño para todas las entradas, sino que realizan aproximaciones dentro de un contexto de calibración dado. La evaluación debe incluir longitudes, tareas e idiomas ajenos al conjunto de calibración para comprobar los desajustes estadísticos.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
3. Los valores atípicos de las activaciones cambian la dificultad de cuantización
Unos pocos valores grandes en las activaciones pueden obligar a ampliar el rango de cuantización y reducir la resolución de la mayoría de los valores ordinarios. SmoothQuant traslada la dificultad de cuantización entre pesos y activaciones mediante un reescalado equivalente de operaciones lineales adyacentes; la transformación equivalente no elimina por sí misma el error de recuantización. Deben registrarse los parámetros de escalado y el procedimiento de calibración, y examinarse entradas largas y distribuciones atípicas. Almacenar solo los pesos con pocos bits y calcular también las activaciones con pocos bits son estrategias diferentes; las conclusiones sobre la calidad de la primera no demuestran la calidad de la segunda.[3] SmoothQuant: Accurate and Efficient Post-Training Quant
4. El ahorro de memoria requiere una contabilidad completa y desglosada
El almacenamiento bruto de los pesos puede calcularse exactamente a partir del número de parámetros y el ancho de bits, pero la memoria durante la ejecución también incluye escalas, puntos cero, capas sin cuantizar, espacio de trabajo, activaciones y caché KV. Los contextos largos pueden hacer que KV sea el componente dominante, por lo que la memoria total del dispositivo no necesariamente sigue disminuyendo de forma proporcional al reducir el ancho de bits de los pesos. Los 7B parámetros del gráfico son únicamente un ejemplo de recuento de 7×10^9 escalares; GB y GiB se presentan por separado para evitar confusiones de unidades. Toda conclusión sobre el pico de memoria sigue requiriendo mediciones en dispositivos reales y bajo condiciones reales de tamaño de lote.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr[3] SmoothQuant: Accurate and Efficient Post-Training Quant
5. La calibración y la validación deben separarse estrictamente
Las muestras de calibración se utilizan para seleccionar escalas o aproximar las estadísticas de entrada, mientras que las muestras de validación sirven para estimar la calidad en distribuciones no vistas. Ajustar continuamente el tamaño de grupo y los umbrales de valores atípicos a partir del conjunto de prueba ya supone utilizarlo para el desarrollo. Se recomienda fijar un conjunto de calibración independiente, definir de antemano los estratos de tareas y longitudes, y conservar ejemplos de fallos y salidas de referencia en coma flotante. En tareas de seguridad o veracidad factual, también deben examinarse los errores poco frecuentes, en lugar de comparar únicamente una perplejidad media. El informe final tras seleccionar entre varias configuraciones de cuantización debe indicar el presupuesto de búsqueda.[1] GPTQ: Accurate Post-Training Quantization for Generativ[2] AWQ: Activation-aware Weight Quantization for LLM Compr
6. Las mejoras de velocidad dependen de núcleos ejecutables
El almacenamiento de pocos bits puede aliviar la presión sobre el ancho de banda, pero también aumentar los costes de desempaquetado, descuantización y conversión de formatos. La decodificación con lotes pequeños, el prellenado con lotes grandes y los distintos tipos de hardware presentan cuellos de botella diferentes, por lo que la clasificación por velocidad puede cambiar. Los experimentos deben separar la carga, el prellenado, la decodificación token a token y la latencia de extremo a extremo, y registrar el tamaño de lote, la longitud, la precisión y la versión del núcleo. La contabilidad de bytes de este artículo solo establece una cota inferior del almacenamiento, y la aproximación de ruido uniforme solo explica la resolución; ninguna sustituye las mediciones en el dispositivo ni las comprobaciones de calidad en las tareas.[1] GPTQ: Accurate Post-Training Quantization for Generativ[3] SmoothQuant: Accurate and Efficient Post-Training Quant
Ecuaciones fundamentales y derivaciones
(1) s es la escala y z es el punto cero; las reglas de agrupación, redondeo y recorte deben indicarse explícitamente.
LaTeX
\hat w=s\left[\operatorname{clip}(\operatorname{round}(w/s)+z,q_{\min},q_{\max})-z\right](2) Relación exacta de segundo orden con un error de pesos fijo, que muestra que las estadísticas de entrada modifican el error de salida.
LaTeX
\mathbb E\|\Delta W x\|_2^2=\operatorname{tr}(\Delta W\,\mathbb E[xx^\top]\,\Delta W^\top)(3) La primera ecuación no incluye metadatos; la segunda requiere supuestos como la ausencia de saturación y un error aproximadamente uniforme, y no puede aplicarse a pesos arbitrarios de modelos.
LaTeX
M_{\mathrm{raw}}=Nb/8,\qquad \operatorname{Var}(e)\approx\Delta^2/12Flujo de métodos y evidencia
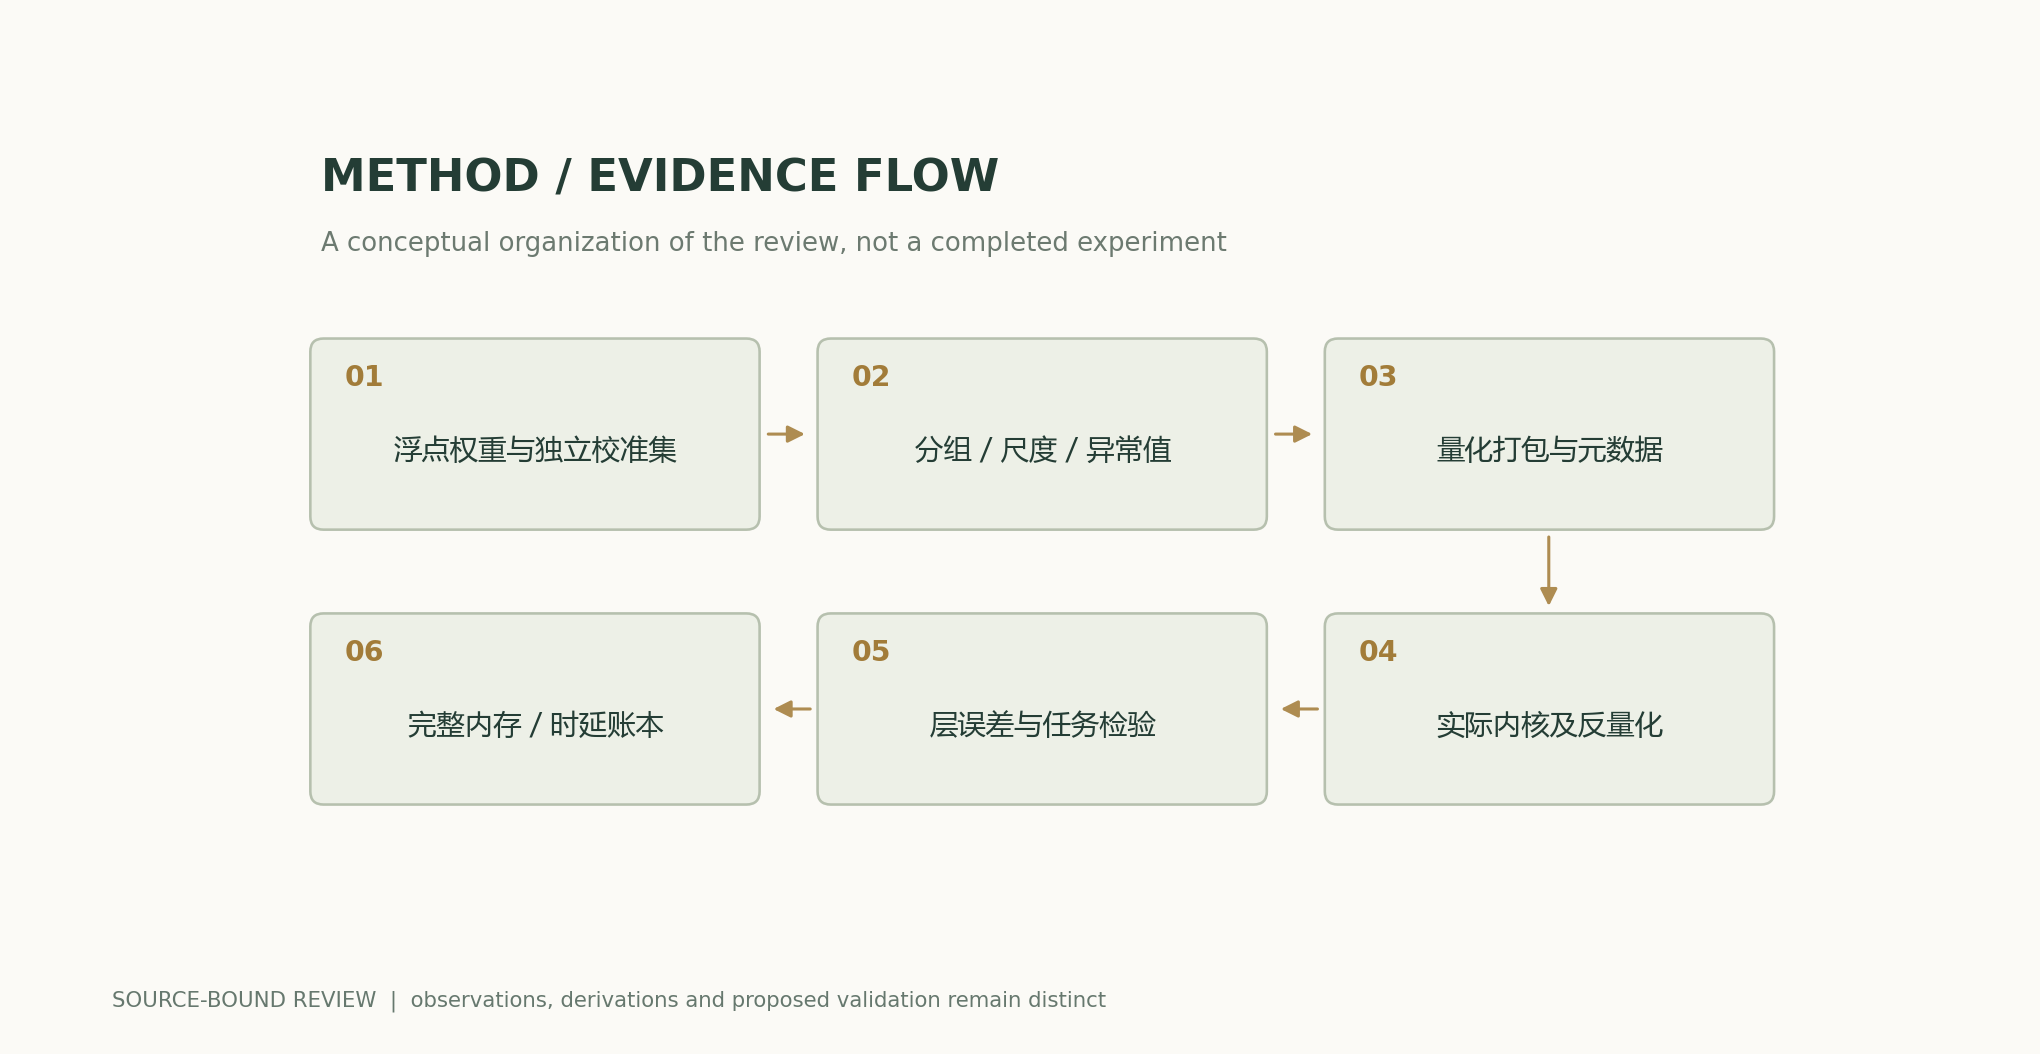
Gráficos analíticos y ejemplos numéricos
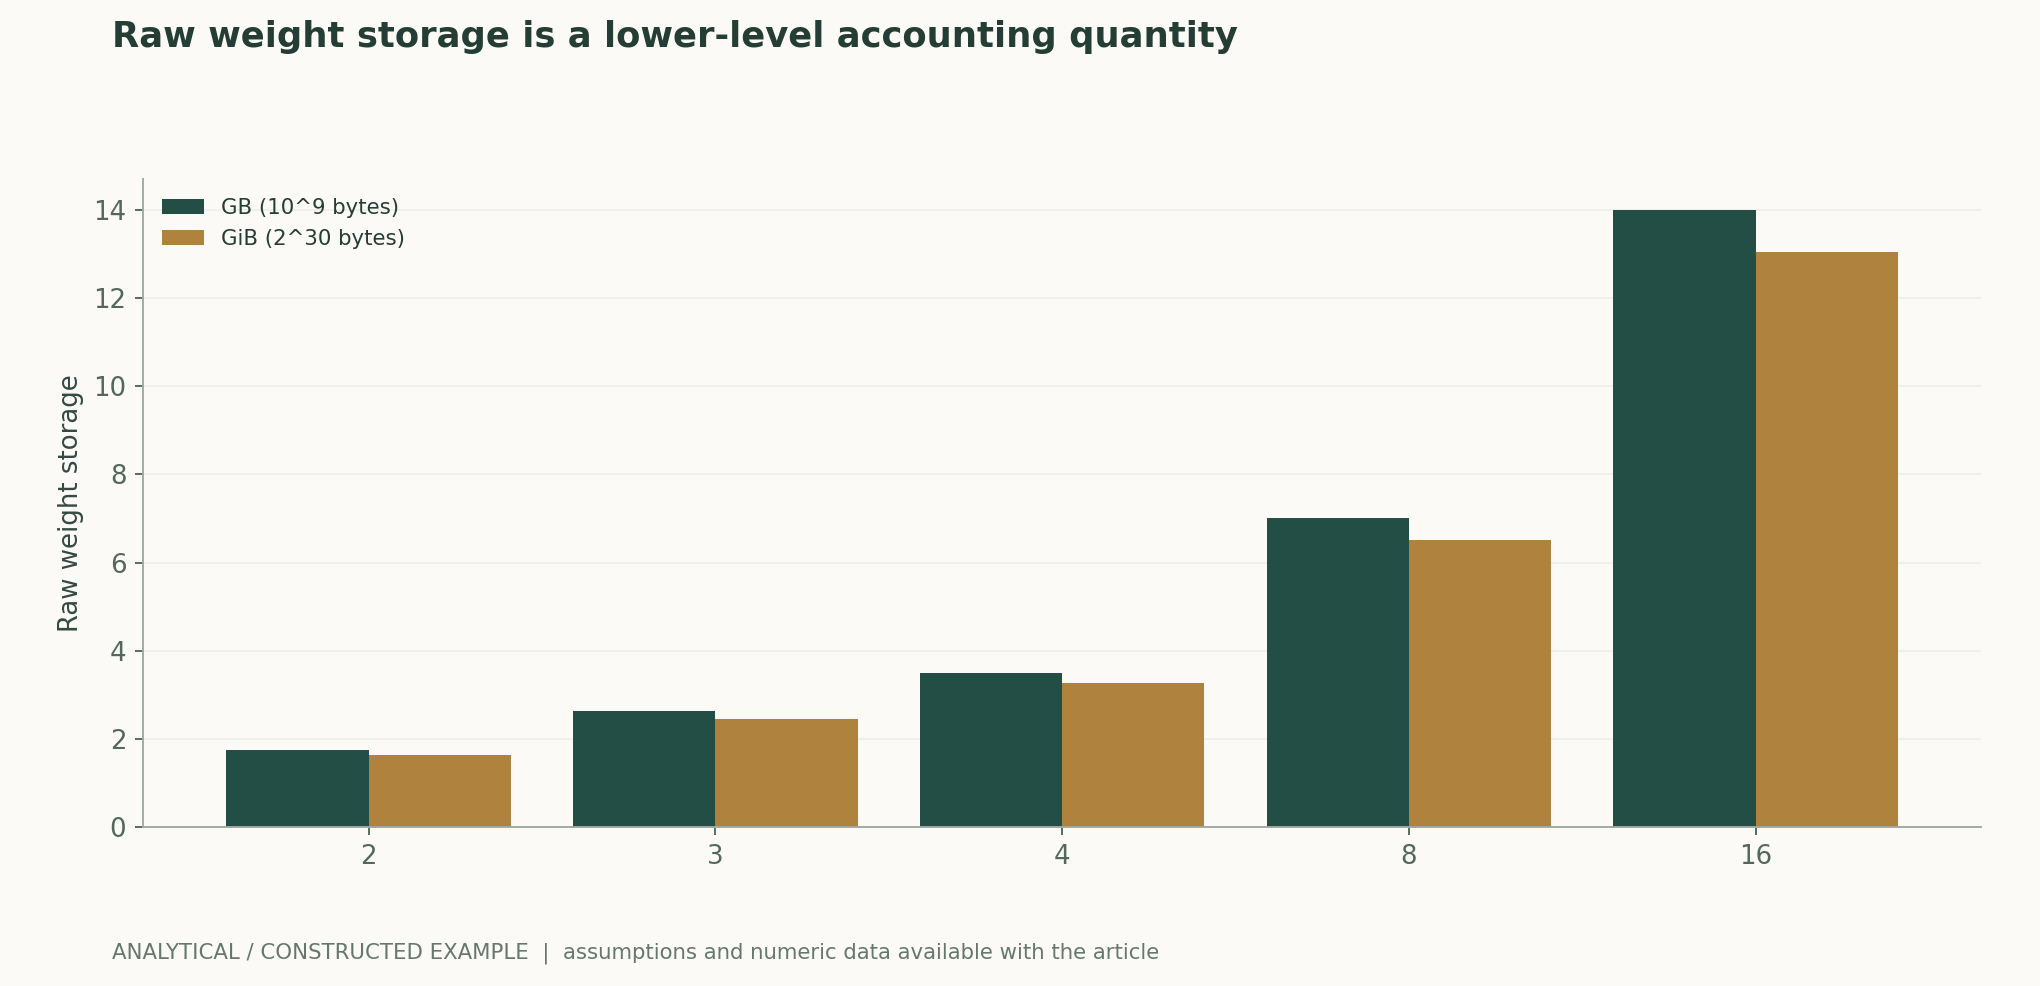
Ejemplo resuelto que permite repetir el cálculo
7×10^9 pesos empaquetados idealmente a 4 bits ocupan 3.5 GB, aproximadamente 3.260 GiB. Aún no se incluyen las escalas de grupo, las capas sin cuantizar, KV ni el espacio de trabajo, por lo que no puede considerarse la memoria total del dispositivo necesaria para el despliegue.
Comparación de métodos
| Método o evaluación | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Cuantización de pesos | Especificar agrupación, escalas, capas sin cuantizar y disposición | El tamaño del archivo no equivale al pico de memoria del dispositivo durante la ejecución |
| Cuantización de activaciones | Medir de forma independiente los valores atípicos y los cambios en la distribución de calibración | Los resultados de pesos con pocos bits no pueden extrapolarse a las activaciones |
| Estimación del error | Medir tanto la reconstrucción de capas como la calidad en las tareas | El MSE medio de los pesos ignora las direcciones de entrada |
| Medición del rendimiento | Fijar el hardware, los núcleos, el tamaño de lote y la longitud | Reducir los bytes no garantiza una aceleración proporcional |
Plan de verificación y experimentación
- Fijar la referencia en coma flotante, el tokenizador y la partición independiente de calibración y validación; registrar las fuentes y los hashes.
- Registrar íntegramente las precisiones de pesos, activaciones y KV y los parámetros de agrupación; enumerar todas las capas conservadas en coma flotante.
- Contabilizar los bytes reales de los archivos, los metadatos de las escalas, el espacio de trabajo de descuantización y el pico de memoria del dispositivo.
- Medir por separado el error de salida de las capas, la perplejidad, el éxito en las tareas y los fallos poco frecuentes; no sustituir todos ellos por una única métrica.
- Comprobar la transferencia de la calibración entre distintas longitudes, idiomas y distribuciones de entrada, y conservar los estratos con peores resultados.
- Repetir de forma independiente las mediciones de tiempo de prellenado y decodificación con núcleos y hardware fijos, y presentar las mejoras sujetas a restricciones de calidad.
Ámbito de aplicación y limitaciones
- No hay mediciones de cuantización de modelos reales ni de aceleración en dispositivos.
- La aproximación de error uniforme no es aplicable a distribuciones arbitrarias de pesos.
- Los bytes brutos de los pesos no incluyen KV ni el espacio de trabajo.
- La calidad fuera del conjunto de calibración requiere validación independiente.
Correspondencia entre fuentes primarias y afirmaciones
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, , , · 2022-10-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, , , , , , , , , · 2023-06-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, , , , , · 2022-11-18Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una petición HEAD reciente devuelve 200 y el ETag no cambia. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se mantiene separada de las figuras científicas; estas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versión e historial de correcciones · /guides/quantization-low-bit-inference/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770