
Resumen: qué sigue siendo desconocido tras el direccionamiento
La transposición guiada por ARN conecta el reconocimiento de secuencias con la integración de la carga y ofrece una vía de inserción programable distinta de los mecanismos convencionales de corte y reparación. Sin embargo, una unión correcta no garantiza que la unión del otro extremo también lo sea, que la carga esté íntegra, que su orientación se ajuste al diseño ni que no existan copias adicionales. Este artículo organiza el direccionamiento al objetivo, la integridad estructural y las consecuencias celulares en un espacio conjunto de resultados, centrándose en por qué las tasas de integración habituales pueden sobreestimar los productos verdaderamente completos y en cómo comprobar esta discrepancia mediante evidencia vinculable.[1] RNA-guided DNA insertion with CRISPR-associated transpo[2] Transposon-encoded CRISPR–Cas systems direct RNA-guided
Traducción del resumen original en inglés
Las transposasas asociadas a CRISPR desacoplan el direccionamiento guiado por ARN de la reparación convencional impulsada por nucleasas. Comparamos el direccionamiento y la inserción como etapas medibles por separado, derivamos un registro de integridad conjunta y un indicador diagnóstico de la entropía de los sitios de inserción, y describimos cómo la evidencia vinculada a una misma molécula puede distinguir la integración prevista de uniones locales aparentemente prometedoras.
Qué evidencia aportan los dos estudios originales
Strecker y sus colaboradores investigaron sistemas CRISPR vinculados a elementos transponibles, mientras que Klompe y sus colaboradores demostraron otra clase de mecanismo de integración guiada por ARN. En conjunto, respaldan la viabilidad de utilizar el reconocimiento mediante ARN para dirigir la inserción de ADN, aunque difieren en sus componentes, desplazamientos de inserción y características de los productos. Este artículo no convierte directamente los resultados de sistemas bacterianos en capacidades generales de los mamíferos, ni proporciona secuencias de carga, formulaciones de administración o condiciones de ejecución experimental.[1] RNA-guided DNA insertion with CRISPR-associated transpo[2] Transposon-encoded CRISPR–Cas systems direct RNA-guided
Considerar el reconocimiento y la inserción como módulos distintos
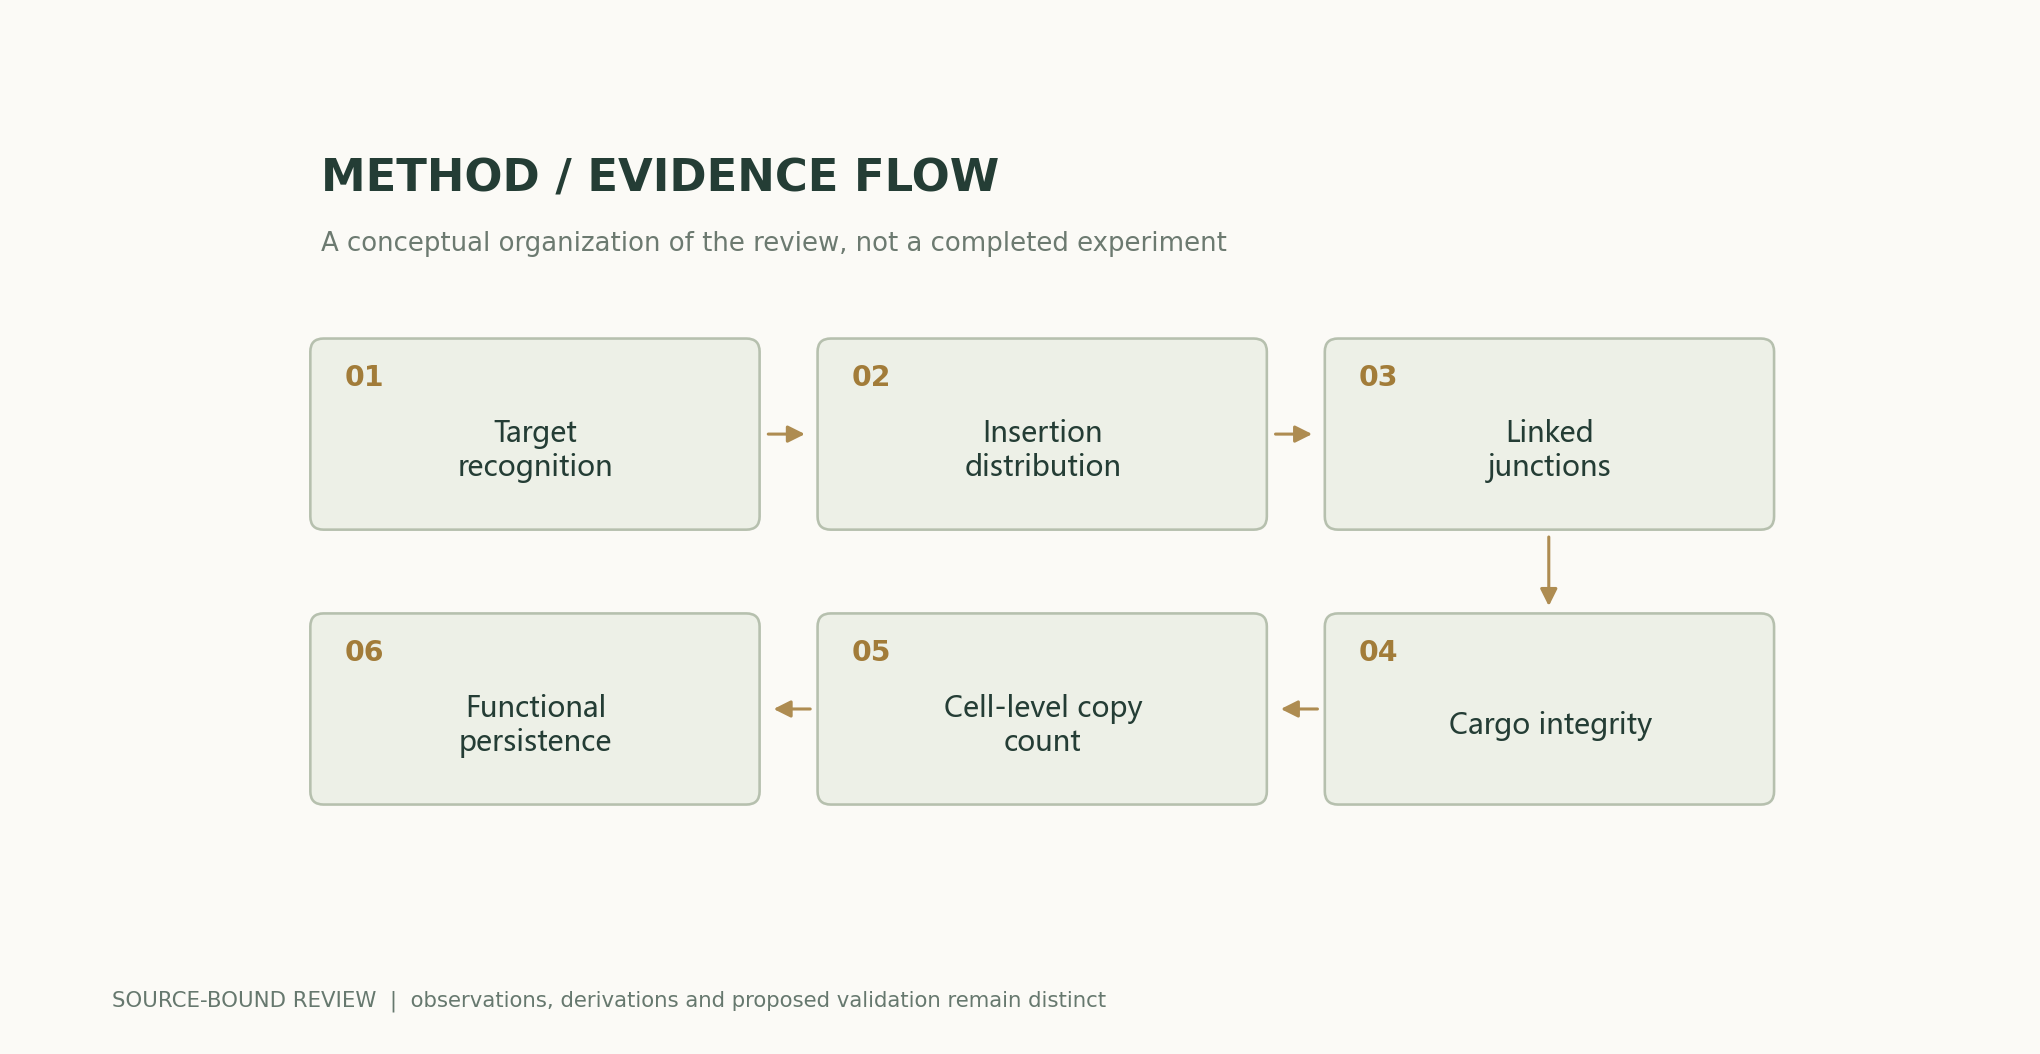
En un modelo mecanístico abstracto, el módulo de reconocimiento delimita primero la región candidata cercana al objetivo, y el módulo de transposición determina después la posición efectiva de unión, la orientación y la estructura del producto. Por tanto, no basta con evaluar la actividad fuera del objetivo únicamente mediante la similitud de la secuencia guía; incluso tras una unión exitosa, la inserción física puede seguir una distribución. Los estudios modulares deberían medir por separado la llegada del reconocimiento, la ocurrencia de la inserción y la finalización del producto, para identificar el nivel en el que aparece el cuello de botella, en lugar de atribuir todos los fallos a un «ARN guía deficiente».作者分析与复核建议 / Author analysis
El producto para calcular la corrección conjunta debe utilizar probabilidades condicionales
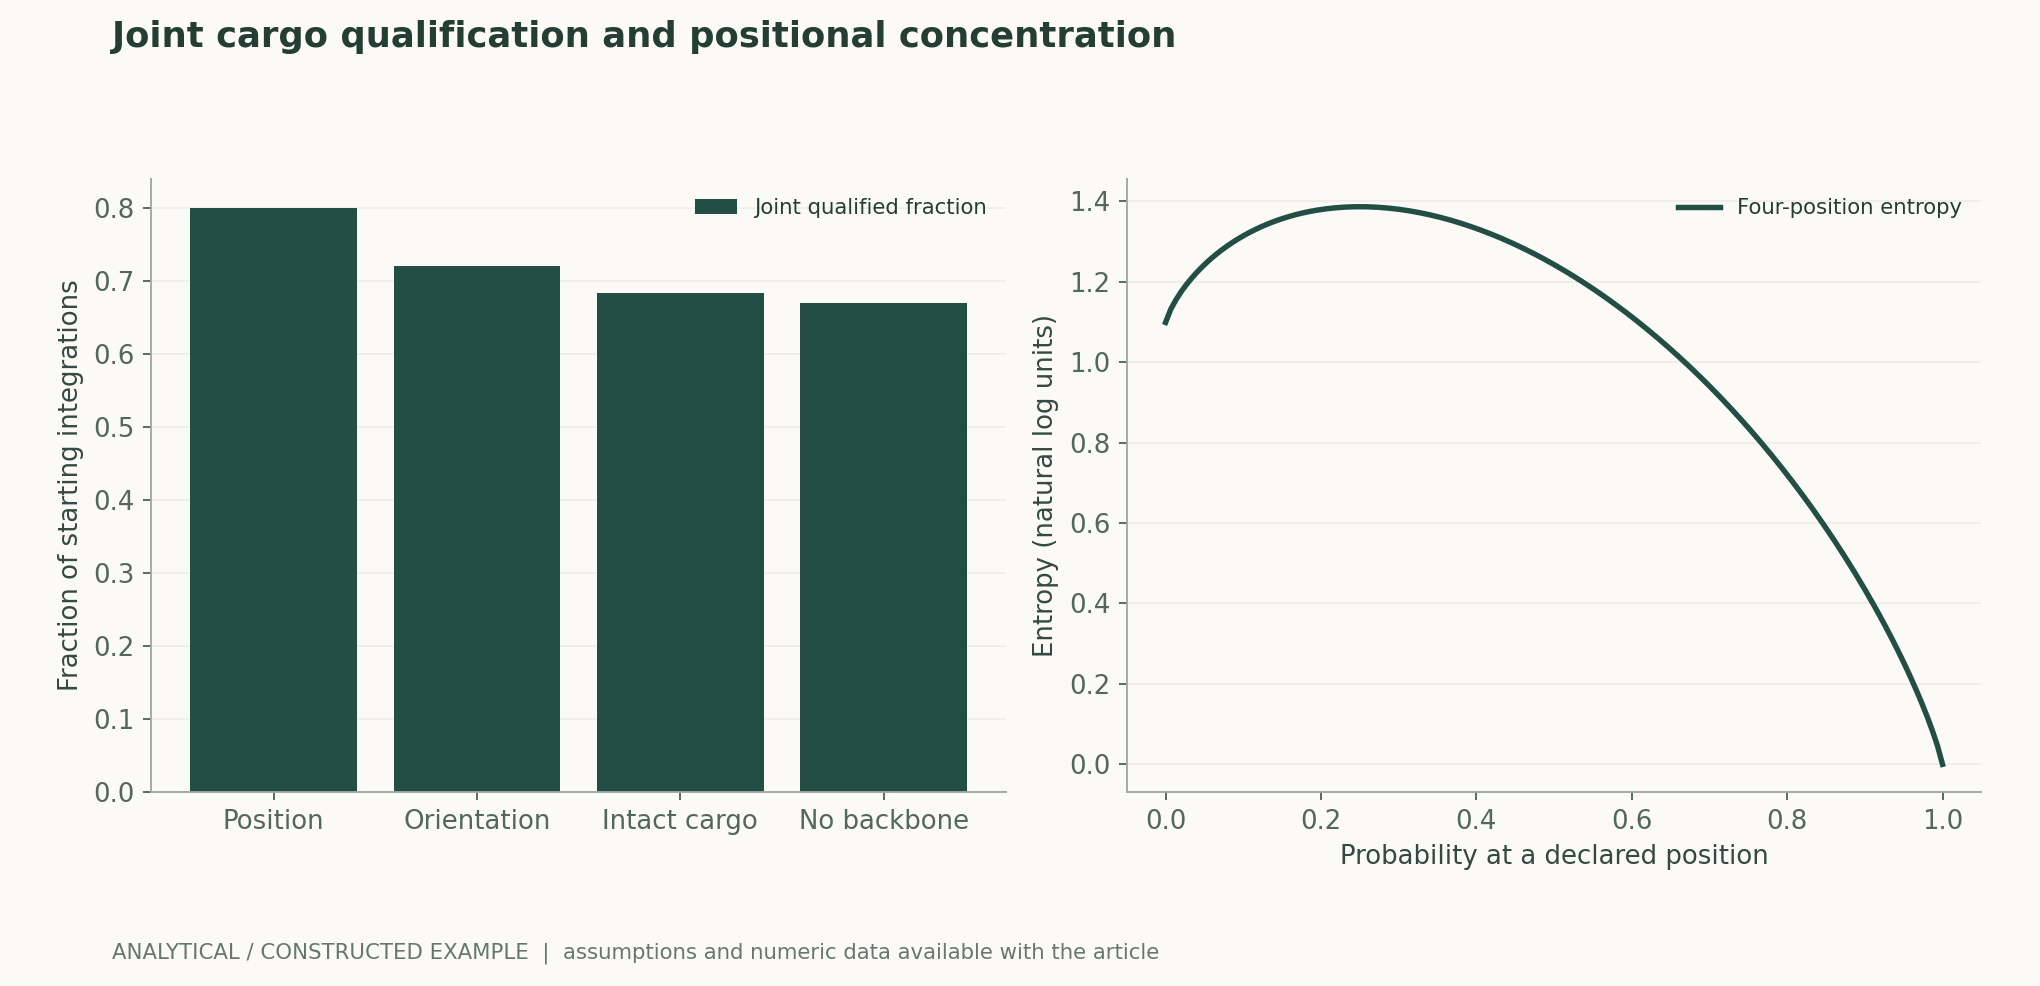
Este artículo define un producto plenamente conforme como aquel que satisface simultáneamente cuatro condiciones: posición, orientación, integridad y ausencia de esqueleto vectorial no deseado. Si se suponen probabilidades condicionales sucesivas de 0.8, 0.9, 0.95 y 0.98, la proporción conjunta es 0.67032. Aunque cada indicador individual sea elevado, el conjunto alcanza solo aproximadamente 67%. La figura es únicamente un ejemplo construido de esta cadena de probabilidades; multiplicar directamente cuatro proporciones marginales procedentes de muestras distintas carece, por lo general, de fundamento.作者分析与复核建议 / Author analysis
Por qué no basta con combinar las PCR de ambos extremos
Supongamos que algunas moléculas solo son correctas en el extremo izquierdo y otras solo en el derecho. Ambos ensayos darían resultados positivos, aunque podría no existir ninguna carga completamente correcta. La evaluación debe vincular los extremos izquierdo y derecho, el interior de la carga y las relaciones de adyacencia genómica a una misma molécula, o declarar explícitamente la falta de vinculación. Incluso cuando ambos extremos son correctos, las deleciones internas, las cargas en tándem o el esqueleto vectorial replicado requieren discriminación adicional. Que distintas mediciones cubran conjuntamente la información no equivale a que demuestren conjuntamente las propiedades de una misma entidad.作者分析与复核建议 / Author analysis
El desplazamiento de inserción es una distribución, no una media
Los estudios originales muestran una relación estructurada entre las posiciones de inserción y los sitios de reconocimiento. Comunicar un desplazamiento medio oculta la multimodalidad, las colas largas o los pocos eventos distantes. Este artículo recomienda presentar conjuntamente el histograma completo de las coordenadas relativas al objetivo, la proporción dentro de una ventana permitida predefinida y las moléculas cuya posición no puede determinarse. Si solo se muestra la posición más frecuente, el lector no puede estimar la carga de eventos fuera de la ventana ni comparar dos sistemas con la misma media, pero con colas de distinta forma.[1] RNA-guided DNA insertion with CRISPR-associated transpo[2] Transposon-encoded CRISPR–Cas systems direct RNA-guided
Usos y usos indebidos de la entropía posicional
La entropía de Shannon de la distribución de los sitios de inserción puede resumir la dispersión posicional, pero una entropía baja no implica un direccionamiento correcto. Si un sistema concentra las inserciones en una posición equivocada, su entropía también puede aproximarse a cero. Por ello, deben comunicarse por separado la «probabilidad de caer dentro de la ventana permitida» y la «entropía de la distribución condicional dentro de la ventana». La comparación entre distribuciones uniformes y concentradas de la figura solo ilustra la dispersión; no simula ninguna proteína de transposición ni permite inferir riesgos genómicos o cambios funcionales.作者分析与复核建议 / Author analysis
Longitud de la carga y sesgo de selección en la recuperación completa
Los fragmentos largos son más difíciles de cubrir por completo que los cortos, y la secuenciación y la amplificación pueden retener preferentemente productos anómalos más cortos. Considerar como población únicamente las moléculas recuperadas con éxito impide comparar de manera equitativa cargas de diferentes longitudes. Un reanálisis viable debería estratificar por moléculas iniciales, longitud de fragmento resoluble y causa del fallo, y utilizar objetos de calibración de estructura conocida para estimar la probabilidad de detección. Sin una calibración dependiente de la longitud, las conclusiones sobre integridad deben limitarse a la parte observable.作者分析与复核建议 / Author analysis
Copias múltiples y nivel unicelular
Una célula que contiene una integración en el objetivo y otra adicional puede clasificarse como un éxito al contabilizar por sitio objetivo; sin embargo, los resultados a nivel celular difieren de los obtenidos a nivel de reacción individual. Debe comunicarse la distribución del número de copias por célula o clon y su asociación con la posición. Un número medio de copias igual a uno tampoco significa que todas las células tengan una copia: una mezcla de cero y dos puede producir la misma media. Los datos posteriores a la selección clonal tampoco representan directamente a la población inicial.作者分析与复核建议 / Author analysis
Integración de fondo y alcance detectable
Los controles sin guía, con una guía no coincidente o sin un módulo esencial pueden ayudar a distinguir las uniones de fondo de los resultados dependientes de la guía, pero no abarcan todos los eventos potenciales. Algunas regiones genómicas son difíciles de alinear, y las regiones repetitivas pueden no permitir un mapeo único. Este artículo recomienda enumerar por separado las uniones que no pueden asignarse de forma unívoca y evaluar su proporción en cada condición; excluir todos los alineamientos ambiguos puede subestimar sistemáticamente los eventos complejos.作者分析与复核建议 / Author analysis
Optimización de candidatos y pruebas independientes
Si se examinan múltiples combinaciones de componentes en un mismo sitio favorable para la integración, es probable que la combinación finalmente óptima esté adaptada a ese contexto local. Evaluar la generalización requiere reservar de antemano familias de sitios, configuraciones de carga y lotes independientes. Si un modelo se entrena con lecturas de unión de la misma procedencia, la partición debe realizarse por molécula original y grupo experimental; no se deben asignar aleatoriamente dos lecturas del mismo evento a entrenamiento y prueba. De lo contrario, la exactitud podría reflejar principalmente el reconocimiento repetido.作者分析与复核建议 / Author analysis
De la señal de unión a la función de expresión
Una carga estructuralmente correcta puede mostrar una expresión diferente, interferencia transcripcional o silenciamiento en una nueva posición. Tampoco puede inferirse a la inversa la corrección de la estructura de integración a partir de la intensidad de expresión, porque las cargas parciales o las plantillas no integradas pueden generar señales. Los estudios deben medir por separado los criterios de valoración estructurales y funcionales, y después vincularlos mediante una misma molécula o linaje. En las herramientas de investigación, el resultado funcional valida la utilidad; en las aplicaciones a largo plazo, también es necesario evaluar de forma independiente la persistencia temporal y la selección celular.作者分析与复核建议 / Author analysis
Cuándo no se puede simplificar suponiendo independencia
La orientación, la integridad y la retención del esqueleto vectorial pueden compartir mecanismos y estar correlacionadas. Este artículo utiliza una cadena de probabilidades condicionales para evitar suponer que estos eventos son independientes; cada paso requiere el denominador real correspondiente a los casos en que se ha cumplido el paso anterior. Si los datos disponibles solo contienen proporciones marginales, pueden utilizarse cotas probabilísticas para establecer un intervalo admisible de la proporción conjunta, en lugar de fabricar un producto excesivamente preciso. La insuficiencia de datos conjuntos debe constituir por sí misma un resultado, no un vacío que rellene el modelo.作者分析与复核建议 / Author analysis
El valor de comunicar los datos ausentes y los fallos
Los resultados no medibles, la ausencia de integración, los productos estructuralmente no conformes y los que no cumplen los requisitos funcionales deben mantenerse en categorías distintas. Solo así puede determinarse si las mejoras posteriores aumentan realmente los productos conformes o simplemente facilitan la lectura de los casos exitosos. Las comparaciones entre métodos también deben revelar la proporción excluida por cada método y sus motivos. Si una combinación parece tener una tasa de éxito mayor, pero también presenta más moléculas indeterminadas, es necesario explicar primero el mecanismo de ausencia de datos antes de hablar de un rendimiento superior.作者分析与复核建议 / Author analysis
Alcance de las figuras recalculables
El modelo numérico de este artículo consta de cuatro probabilidades condicionales y distribuciones posicionales artificiales; no incorpora un genoma real, cinética de transposasas ni mediciones celulares. Su valor consiste en hacer comprobable la proposición de que «varios indicadores individuales elevados no pueden sustituir un criterio de valoración conjunto». Cualquier persona puede modificar las probabilidades condicionales, recalcular el rendimiento y comprobar que la entropía sigue siendo baja cuando los eventos se concentran en una posición equivocada. Este contraejemplo impone restricciones a las métricas de evaluación, pero no constituye un veredicto empírico sobre un sistema concreto.作者分析与复核建议 / Author analysis
Proposiciones de investigación y condiciones de refutación
Una proposición que merece comprobarse es si, con cobertura completa de la misma molécula y una clasificación uniforme de los datos ausentes, la optimización de un componente puede aumentar de forma sostenida la proporción conjunta de inserciones conformes, y si esa mejora depende de una carga o ventana objetivo determinada. Podrían refutarla un aumento de la señal dentro de la ventana sin incremento de los productos completos, o una ventaja que solo apareciera en clones después de la selección. Definir de antemano estas condiciones de fallo ayuda a evitar que todas las observaciones se interpreten como apoyo al modelo.作者分析与复核建议 / Author analysis
Paquete mínimo de investigación intercambiable
Un estudio comparable debe adjuntar los identificadores de las moléculas originales, las coordenadas exactas del objetivo, la ventana permitida, un esquema de la estructura de la carga, la versión del clasificador, un registro de denominadores y lotes independientes. Los materiales compartidos pueden contener únicamente datos resumidos legalmente públicos y no sensibles, pero deben bastar para recalcular las proporciones clave y rastrear las exclusiones. Este artículo adjunta datos construidos analíticamente y código; no presenta las recomendaciones de diseño como experimentos de integración ya realizados.作者分析与复核建议 / Author analysis
Conclusión: de un punto positivo a una entidad completa
El avance de la transposición guiada por ARN reside en establecer una interfaz programable entre reconocimiento e integración; una evaluación de ingeniería fiable exige reunir nuevamente la posición, la orientación, la integridad y las consecuencias celulares en una misma entidad. Conservar la distribución completa de resultados ofrece mayor poder explicativo que la tasa de uniones positivas más llamativa. Los próximos avances importantes deberían reflejarse en una calidad conjunta del producto verificable en distintos contextos, y no solo en mejores métricas tras restringir el análisis al denominador más favorable.作者分析与复核建议 / Author analysis
Ecuaciones fundamentales y derivaciones
(1) Cadena condicional conjunta; T indica posición, O orientación, C integridad y B ausencia de esqueleto vectorial no deseado.
LaTeX
P(T,O,C,B)=P(T)P(O\mid T)P(C\mid T,O)P(B\mid T,O,C)(2) La entropía posicional solo cuantifica la dispersión; no demuestra que la posición sea correcta.
LaTeX
H(p)=-\sum_j p_j\log p_j(3) Cota inferior de la probabilidad conjunta cuando solo se dispone de datos marginales; no se pueden multiplicar las probabilidades marginales.
LaTeX
P(\cap_{i=1}^{m} A_i)\geq\max(0,\sum_i P(A_i)-(m-1))(4) Tasa de conformidad en la población inicial, separada de la proporción entre los clones después de la selección.
LaTeX
Y_{\rm start}=N_{\rm qualified}/N_{\rm starting}Flujo de métodos y evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto recalculable
La tasa de conformidad conjunta de las cuatro condiciones es 0.8×0.9×0.95×0.98=0.67032. Con una distribución uniforme entre cuatro posiciones, la entropía es ln4; si todo se concentra en una posición, es 0, incluso si esa posición es incorrecta.
Comparación de métodos
| Método o criterio de medición | Restricción directa | Evidencia aún necesaria |
|---|---|---|
| Detección de una sola unión | Adyacencia en un extremo | El otro extremo y la estructura interna |
| Detección independiente de ambos extremos | Señales marginales de ambos extremos | Vinculación a una misma molécula |
| Cobertura de moléculas largas | Adyacencia de la carga completa | Sesgos de longitud y alineamiento |
| Distribución de sitios | Ventana y cola larga | Número de copias y función celulares |
| Célula individual/clon | Combinaciones intracelulares | Sesgos de selección y crecimiento |
| Resultado funcional | Fenotipo relacionado con el uso | Estructura de integración y persistencia a largo plazo |
Plan de verificación y experimentación
- Fijar la ventana objetivo y los criterios de estructura completa.
- Definir tres denominadores: inicial, recuperado y conforme.
- Preservar la vinculación molecular de los extremos izquierdo y derecho y la estructura interna.
- Enumerar por separado los resultados que no pueden localizarse o cubrirse por completo.
- Calcular la proporción conjunta y la cadena de probabilidades condicionales.
- Realizar comparaciones controladas estratificadas por sitio, carga y lote.
- Comprobar si la estructura, el número de copias y la función están vinculados a la misma entidad.
- Publicar las reglas de clasificación con su versión, los datos resumidos y todas las causas de fallo.
Ámbito de aplicación y limitaciones
- Este artículo no produjo nuevos experimentos de integración.
- Las probabilidades condicionales son ejemplos analíticos, no medidas del rendimiento del sistema.
- La entropía posicional no puede representar la seguridad.
- Los resultados bacterianos iniciales citados no equivalen directamente a capacidades en células humanas.
- Una cobertura limitada no demuestra la ausencia de eventos adicionales en todo el genoma.
Evidencia de los estudios originales y ámbito de aplicación
| Resultado del estudio original | Ámbito de aplicación | Fuente y ubicación |
|---|---|---|
| El reconocimiento mediante ARN puede acoplarse a la inserción por transposición. | Los sistemas bacterianos originales, componentes y sitios específicos. | Inserción de ADN guiada por ARN mediante transposasas asociadas a CRISPRResumen; Fig. 5 |
| Otra clase de sistemas asociados a CRISPR logra la integración dirigida. | El desplazamiento, la orientación y la configuración de la inserción dependen del sistema. | Los sistemas CRISPR–Cas codificados por transposones dirigen la integración de ADN guiada por ARNResumen; distribuciones de sitios de inserción |
Preguntas de investigación que merece la pena comprobar
- ¿La optimización de componentes aumenta el rendimiento conjunto de productos completos?
- ¿Cómo modifica la longitud de la carga la ausencia de datos en la medición?
- ¿Cómo se asocian la integración dirigida y las copias adicionales a nivel celular?
Fuentes primarias y correspondencia con las afirmaciones
- RNA-guided DNA insertion with CRISPR-associated transposasesJonathan Strecker, Alim Ladha, Zachary Gardner, Jonathan L. Schmid-Burgk, Kira S. Makarova, Eugene V. Koonin, et al. · 2019-07-05Abstract; Fig. 5
- Transposon-encoded CRISPR–Cas systems direct RNA-guided DNA integrationSanne E. Klompe, Phuc L. H. Vo, Tyler S. Halpin-Healy, Samuel H. Sternberg · 2019-06-12Abstract; integration-site distribution
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autoría, versión y fuentes
Revisión de investigación documentada con fuentes y análisis original redactados por Codex (IA). Los experimentos de los artículos originales corresponden a los equipos de investigación originales; los cálculos de este artículo solo comprueban las ecuaciones indicadas y los supuestos explícitos. Este sitio aún no dispone de una revisión por pares independiente de este artículo ni de registros de modelos originales, experimentos clínicos o experimentos físicos correspondientes a él.
Primera publicación: estudio temático en profundidad sobre evidencia científica interdisciplinaria; mantiene las fronteras entre las fuentes de cada sección, la evidencia de los estudios originales y el análisis del autor.
La portada conceptual fue generada por ImageGen. Las figuras científicas se trazaron con el código y los archivos numéricos adjuntos; sus leyendas detallan los supuestos y los criterios de medición.
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Python · Código recalculable · Historial de publicación y versiones
Revisión de la fuente: 500575872cce7c4b9c4062a12bb0692eb580c2da