
摘要:定位之后还有哪些未知
RNA引导转座把序列识别与载荷整合连接起来,为可编程插入提供了不同于传统切割修复的路线。但一个正确连接点不能保证另一端连接正确,也不能保证载荷完整、方向符合设计或没有额外拷贝。本文将目标定位、结构完整性和细胞层后果组织成联合结果空间,重点分析常用整合率为什么可能高估真正完整产物,以及如何用可关联证据检验这一差异。[1] RNA-guided DNA insertion with CRISPR-associated transpo[2] Transposon-encoded CRISPR–Cas systems direct RNA-guided
English abstract
CRISPR-associated transposases decouple RNA-guided targeting from conventional nuclease-driven repair. We compare targeting and insertion as separate measurable stages, derive a joint integrity ledger and an insertion-site entropy diagnostic, and outline how molecule-linked evidence can distinguish intended integration from attractive local junctions.
两项原始研究提供什么证据
Strecker等研究了与转座元件相连的CRISPR系统,Klompe等展示了另一类RNA引导整合机制。它们共同支持利用RNA识别来引导DNA插入的可行性,同时具有不同组分、插入偏移及产物特征。本文不把细菌体系的研究结果直接改写为哺乳动物通用能力,也不提供载荷序列、递送配方或实验操作条件。[1] RNA-guided DNA insertion with CRISPR-associated transpo[2] Transposon-encoded CRISPR–Cas systems direct RNA-guided
把识别与插入看成不同模块
在抽象机制中,识别模块首先约束目标附近的候选区域,转座模块再决定实际连接位置、方向和产物结构。因此只用引导序列相似性评价脱靶并不充分;结合成功之后,物理插入仍可能具有分布。模块化研究应该分别测量识别到达、插入发生和产物完成,判断瓶颈发生在哪一层,而不是把所有失败归入“引导RNA不好”。作者分析与复核建议 / Author analysis
联合正确率的乘积必须是条件概率
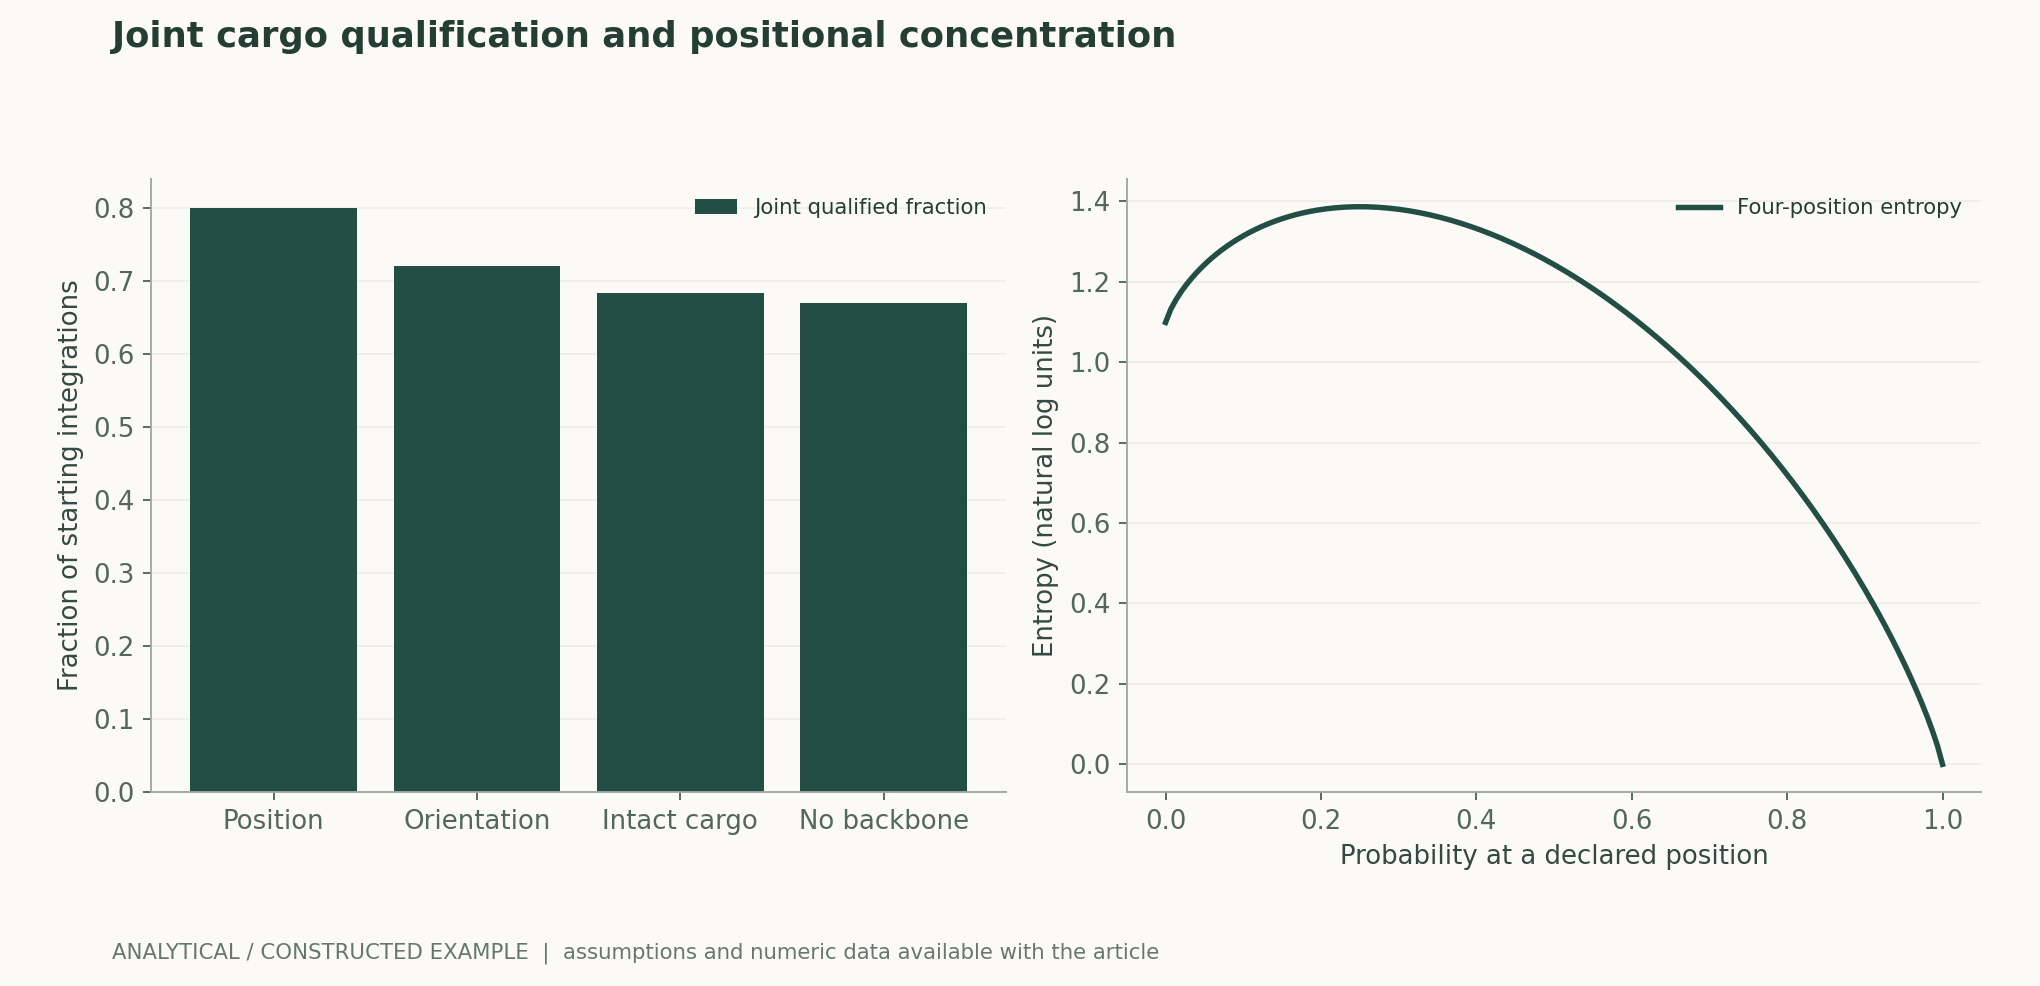
本文把完全合格产物定义为位置、方向、完整性及无不需要骨架四个条件同时成立。若依次条件概率是假定的0.8、0.9、0.95和0.98,联合比例为0.67032。每个单项都较高,整体仍只有约67%。图中只是这一概率链的构造示例;若使用来自不同样本的四个边际比例,直接相乘通常没有依据。作者分析与复核建议 / Author analysis
为什么两端PCR不能简单拼接
假设一部分分子只有左端正确,另一部分只有右端正确,两种检测都会给出阳性,却可能不存在完整正确载荷。评价必须让左右端、载荷内部与基因组邻接关系绑定到同一分子,或明确声明关联缺口。即使两端正确,内部缺失、串联载荷或复制骨架仍需要额外分辨。不同测量共同覆盖信息,和共同证明同一个对象,是两回事。作者分析与复核建议 / Author analysis
插入偏移是分布而不是一个平均数
原研究表明插入位置与识别位点之间存在结构化关系。报告一个平均偏移会隐藏多峰、长尾或少数远距离事件。本文建议同时展示目标相对坐标的完整直方图、预先允许窗口内的比例及无法定位分子。若只展示最常见的位置,读者无法估计窗口外负担,也无法比较两个具有相同均值却不同尾部形态的系统。[1] RNA-guided DNA insertion with CRISPR-associated transpo[2] Transposon-encoded CRISPR–Cas systems direct RNA-guided
位置熵的用途与误用
插入位点分布的Shannon熵可以总结位置分散程度,但熵低不等于目标正确。一个系统若集中插入错误位置,熵也可能接近零。因此应把“落在允许窗口内的概率”和“窗口内条件分布的熵”分开报告。图中比较均匀与集中分布只是说明分散性;它不模拟任何转座蛋白,也不推出基因组风险或功能改变。作者分析与复核建议 / Author analysis
载荷长度与完整回收的选择偏差
长片段比短片段更难完整覆盖,测序与扩增可能优先保留较短异常产物。把只成功回收的分子作为总体,会使不同长度载荷无法公平比较。可行的重分析应按起始分子、可分辨片段长度和失败原因分层,并用已知结构的校准对象估计检测概率。若没有长度依赖校准,完整性结论只能限于可观察部分。作者分析与复核建议 / Author analysis
多拷贝与单细胞层级
一个细胞包含一次目标整合与一次额外整合,在按目标位点统计时可能被归为成功;但细胞层的结果与单次反应层并不相同。应报告每个细胞或克隆的拷贝分布及其与位置的关联。平均拷贝为一也不能说明每个细胞都是一拷贝,零与二的混合能够得到同样均值。克隆筛选后的数据还不能直接代表起始群体。作者分析与复核建议 / Author analysis
背景整合与可检测范围
无引导、非匹配引导和缺少关键模块的对照,可以帮助区分背景连接与引导依赖结果,但对照并不覆盖所有潜在事件。基因组某些区域难比对,重复区域也可能无法唯一定位。本文建议把无法唯一归属的连接独立列出,并评估它们在各条件中的比例;把模糊比对全部排除,可能系统性低估复杂事件。作者分析与复核建议 / Author analysis
候选优化与独立测试
如果多个组分组合都在同一个易整合位点筛选,最终最优组合很可能适应这个局部背景。外推评价需要预先保留位点家族、载荷构型与独立批次。若训练模型使用相同来源的连接读段,划分应按原始分子和实验组进行,不能把同一事件的两段读数随机分到训练和测试。否则准确率可能主要反映重复识别。作者分析与复核建议 / Author analysis
从接头信号到表达功能
结构正确的载荷仍可能在新位置出现不同表达、转录干扰或沉默。表达强度也不能反向证明整合结构正确,因为部分载荷或非整合模板可能产生信号。研究应将结构终点与功能终点分别测量,再通过同一分子或谱系建立联系。对于研究工具,功能输出是用途验证;对于长期应用,还需要独立评估随时间的保持与细胞选择。作者分析与复核建议 / Author analysis
何时不能用独立假设简化
方向、完整性与骨架残留可能具有共同机制,彼此相关。本文用条件概率链避免把这些事件假定独立;每一步都需要前一步已成立时的实际分母。若现有数据只有边际比例,可以用概率界给出联合比例的允许区间,而不制造一个过于精确的乘积值。联合数据不足本身应成为结果,而不是被模型填补掉的空白。作者分析与复核建议 / Author analysis
报告缺失与失败的价值
无法测量、未整合、结构不合格和功能不达标应保存在不同类别。这样才能判断后续改进是增加了真实合格产物,还是只让成功对象更容易被读出。多方法比较还应披露每条方法筛去的比例及原因。若某个组合成功率看似更高,却有更多不可判定分子,需要先解释缺失机制,再讨论性能领先。作者分析与复核建议 / Author analysis
可复算图的范围
本文数值模型由四个条件概率和人为位置分布组成,没有真实基因组、转座酶动力学或细胞测量。其价值是让“多个高单项指标不能替代联合终点”成为可检查的命题。任何人都能改变条件概率、重新计算产率,并检验熵指标在错误位置集中时仍会很低。这种反例对评价指标有约束,却不是对某个系统的实测裁决。作者分析与复核建议 / Author analysis
研究命题与可证伪条件
值得检验的命题是:在同分子完整覆盖及相同缺失归类下,某个组分优化能否持续提高合格插入的联合比例;其改进是否依赖特定载荷或目标窗口。反证可以是窗口内信号增加但完整产物不增加,或只在筛选后克隆中出现优势。预先定义这种失败条件,有助于避免所有观察都被解释为支持模型。作者分析与复核建议 / Author analysis
最小可交换研究包
一次可比较的研究应附原始分子标识、准确目标坐标、允许窗口、载荷结构图、分类器版本、分母账本和独立批次。共享材料可以只包含合法公开且不敏感的摘要数据,但必须足以重算关键比例并追踪排除项。本文附带的是解析构造数据与代码,并没有把设计建议写成已经完成的整合实验。作者分析与复核建议 / Author analysis
结论:从单点阳性到完整对象
RNA引导转座的突破在于将识别和整合形成可编程接口;可信的工程评价则需要把位置、方向、完整性和细胞后果重新合在同一对象上。保留完整结果分布,比一个最漂亮的接头阳性率更有解释力。下一步重要进展应体现在跨背景可复核的联合产物质量,而不只是缩小到最有利分母后的指标提升。作者分析与复核建议 / Author analysis
核心公式与推导
(1) 联合条件链;T位置、O方向、C完整性、B不带不需要骨架。
LaTeX
P(T,O,C,B)=P(T)P(O\mid T)P(C\mid T,O)P(B\mid T,O,C)(2) 位置熵只量化分散,不能证明位置正确。
LaTeX
H(p)=-\sum_j p_j\log p_j(3) 只有边际数据时的联合概率下界,不能将边际相乘。
LaTeX
P(\cap_{i=1}^{m} A_i)\geq\max(0,\sum_i P(A_i)-(m-1))(4) 起始群体合格率,与筛选后克隆比例分开。
LaTeX
Y_{\rm start}=N_{\rm qualified}/N_{\rm starting}方法与证据流程
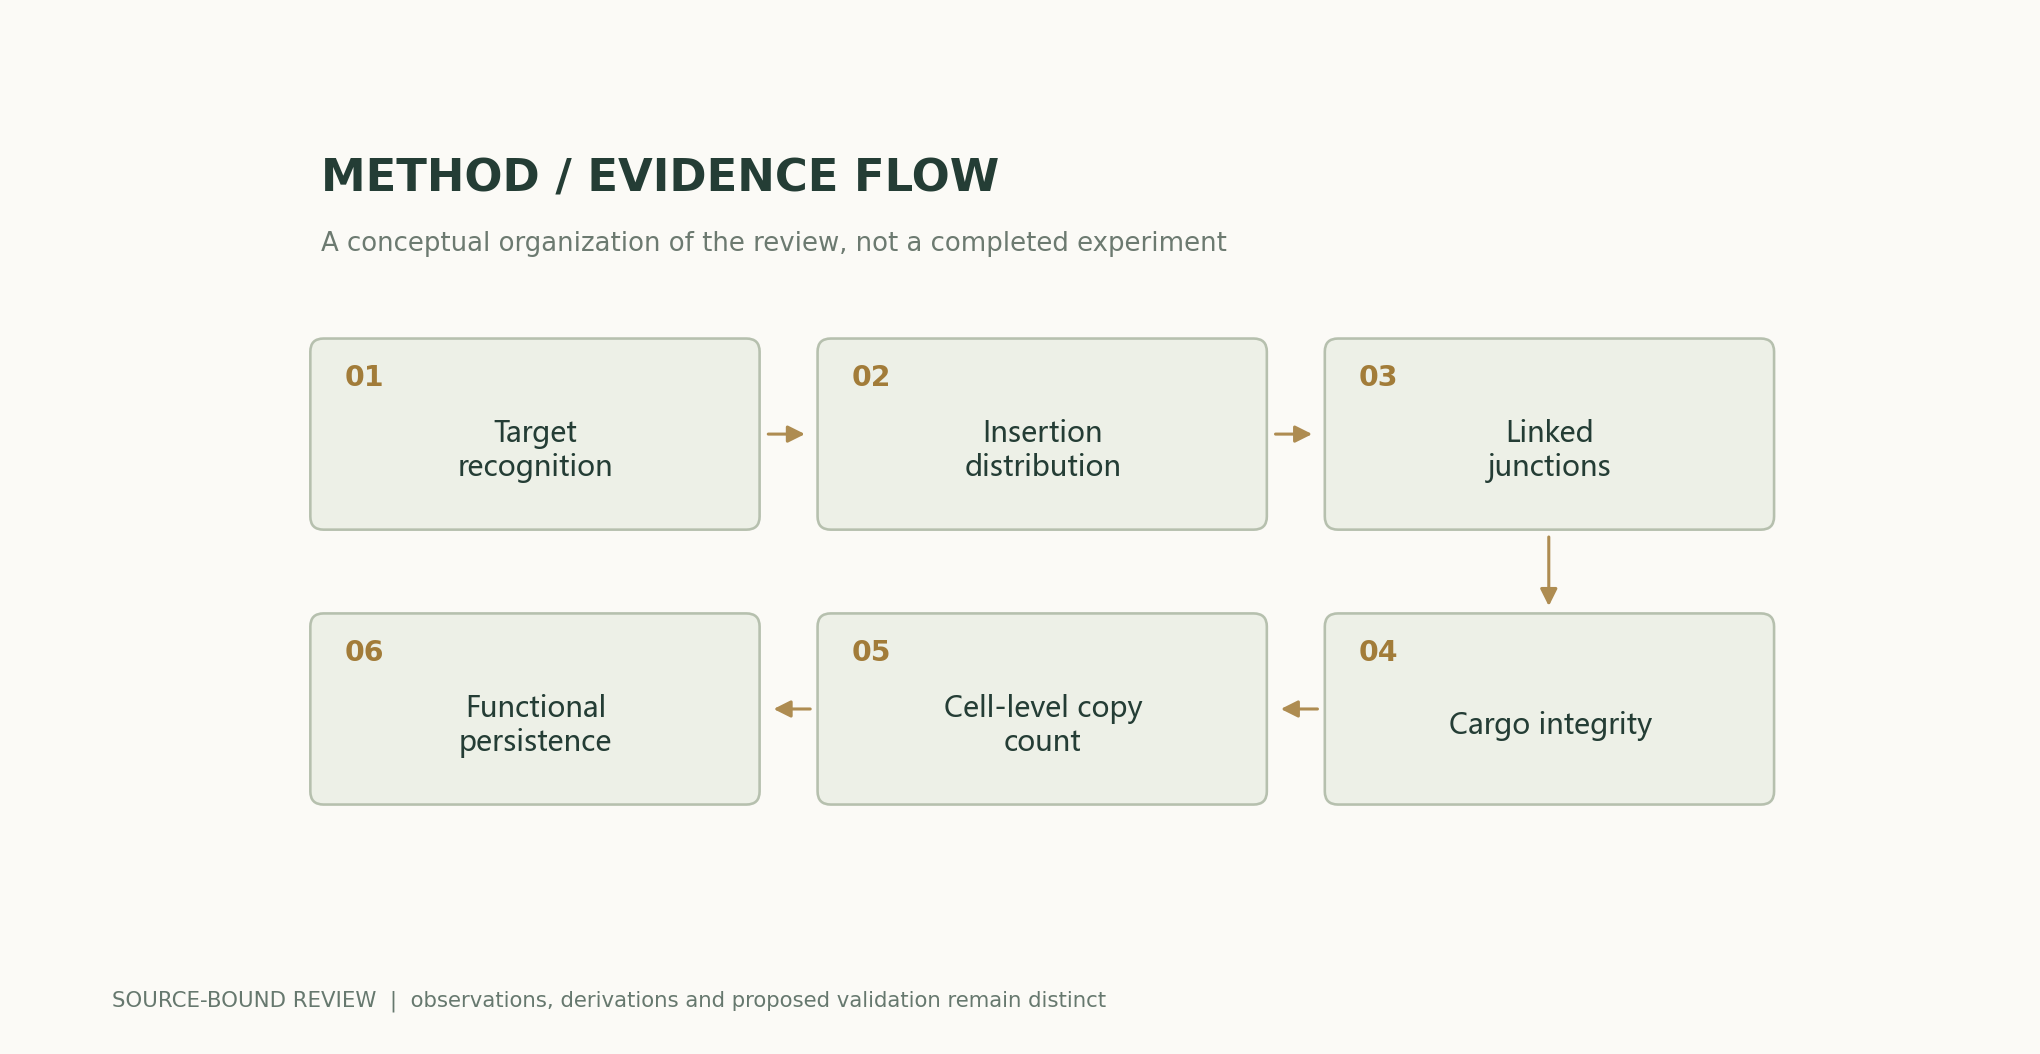
解析图与数值示例
可复算例题
四条件联合合格率0.8×0.9×0.95×0.98=0.67032。四位置均匀时熵ln4;全部集中在一个位置时为0,即使该位置错误。
方法比较
| 方法或口径 | 直接约束 | 仍需补足的证据 |
|---|---|---|
| 单连接点检测 | 一端邻接 | 另一端与内部结构 |
| 双端独立检测 | 两端边际信号 | 同一分子的关联 |
| 长分子覆盖 | 完整载荷邻接 | 长度及比对偏差 |
| 位点分布 | 窗口和长尾 | 细胞拷贝与功能 |
| 单细胞/克隆 | 细胞内组合 | 筛选与增长偏差 |
| 功能输出 | 用途相关表型 | 整合结构及长期保持 |
复核与实验方案
- 固定目标窗口与完整结构标准。
- 定义起始、回收和合格三个分母。
- 保留左右端和内部结构的分子关联。
- 单列无法定位和无法完整覆盖结果。
- 计算联合比例及条件概率链。
- 按位点、载荷和批次分层对照。
- 核查结构、拷贝与功能是否同对象绑定。
- 发布版本化分类规则、摘要数据及全部失败原因。
适用范围与局限
- 本文未产生任何新整合实验。
- 条件概率为解析示例,不是系统性能。
- 位置熵不能代表安全性。
- 所引初始细菌结果不直接等于人体细胞能力。
- 有限覆盖不能证明全基因组无额外事件。
原研究证据与适用范围
| 原研究结果 | 适用范围 | 来源与位置 |
|---|---|---|
| RNA识别可与转座插入耦合。 | 原细菌系统、特定组分和位点。 | RNA-guided DNA insertion with CRISPR-associated transposasesAbstract; Fig. 5 |
| 另一类CRISPR相关系统实现定向整合。 | 插入偏移、方向和构型与体系相关。 | Transposon-encoded CRISPR–Cas systems direct RNA-guided DNA integrationAbstract; insertion-site distributions |
值得检验的研究问题
- 组分优化是否提高完整联合产率?
- 载荷长度如何改变测量缺失?
- 目标整合与额外拷贝在细胞层如何关联?
一手来源与主张对应
- RNA-guided DNA insertion with CRISPR-associated transposasesJonathan Strecker, Alim Ladha, Zachary Gardner, Jonathan L. Schmid-Burgk, Kira S. Makarova, Eugene V. Koonin, et al. · 2019-07-05Abstract; Fig. 5
- Transposon-encoded CRISPR–Cas systems direct RNA-guided DNA integrationSanne E. Klompe, Phuc L. H. Vo, Tyler S. Halpin-Healy, Samuel H. Sternberg · 2019-06-12Abstract; integration-site distribution
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
Codex(AI)撰写的有来源研究综述与原创解析。原论文实验归原研究团队;本文计算仅检验所列公式和明示假设。 本站尚无本篇独立同行评审或原创模型、临床及物理实验记录。
首次发布:跨学科科学证据深度专题;保留逐节来源、原研究证据与作者解析的边界。
概念封面由 ImageGen 生成。科学图由随文代码与数值文件绘制,图注逐项说明假设与测量口径。
封面与科学图来源 · 数据、来源与假设 · Python · 可复算代码 · 发布与版本记录
Source revision: 500575872cce7c4b9c4062a12bb0692eb580c2da