
Resumen
La robustez no es una propiedad incondicional de un modelo, sino una conclusión limitada en relación con las capacidades del atacante, el conjunto de perturbaciones y la definición de la tarea. Este artículo deriva la perturbación de peor caso de un modelo lineal bajo un presupuesto de norma infinito, analiza la acumulación en dimensiones altas y las diferencias entre normas, y después aborda el entrenamiento adversario, el compromiso con la exactitud natural y el enmascaramiento de gradientes. Las figuras muestran sensibilidad analítica, no ataques contra servicios reales ni mediciones de exactitud.[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A[3] Theoretically Principled Trade-off between Robustness a
Traducción del resumen original en inglés
La robustez adversaria se define en relación con un modelo de amenaza, un conjunto de perturbaciones y un procedimiento de evaluación. Derivamos la perturbación lineal exacta de peor caso bajo un presupuesto de norma infinito y la contrastamos con una restricción de norma euclídea. Las curvas analíticas en función de la dimensión no son tasas de éxito de ataques. La evaluación adaptativa y el estudio de los compromisos entre exactitud natural y robusta siguen siendo requisitos empíricos.
1. El modelo de amenaza debe preceder a los resultados de los ataques
Se debe especificar qué sabe el atacante, qué entradas puede modificar, la magnitud de los cambios, el presupuesto de consultas y los criterios de éxito. Las perturbaciones de norma pequeña en imágenes, los cambios naturales de distribución y las reformulaciones semánticas son amenazas distintas y no pueden sustituirse entre sí. Si las restricciones del ataque no guardan relación con el uso real, incluso unas pruebas rigurosas pueden responder a la pregunta equivocada. Este artículo aborda las matemáticas de métodos publicados y las pruebas de aceptación de defensas; no ejecuta ataques contra ningún servicio de terceros.[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A
2. La acumulación lineal revela la sensibilidad en dimensiones altas
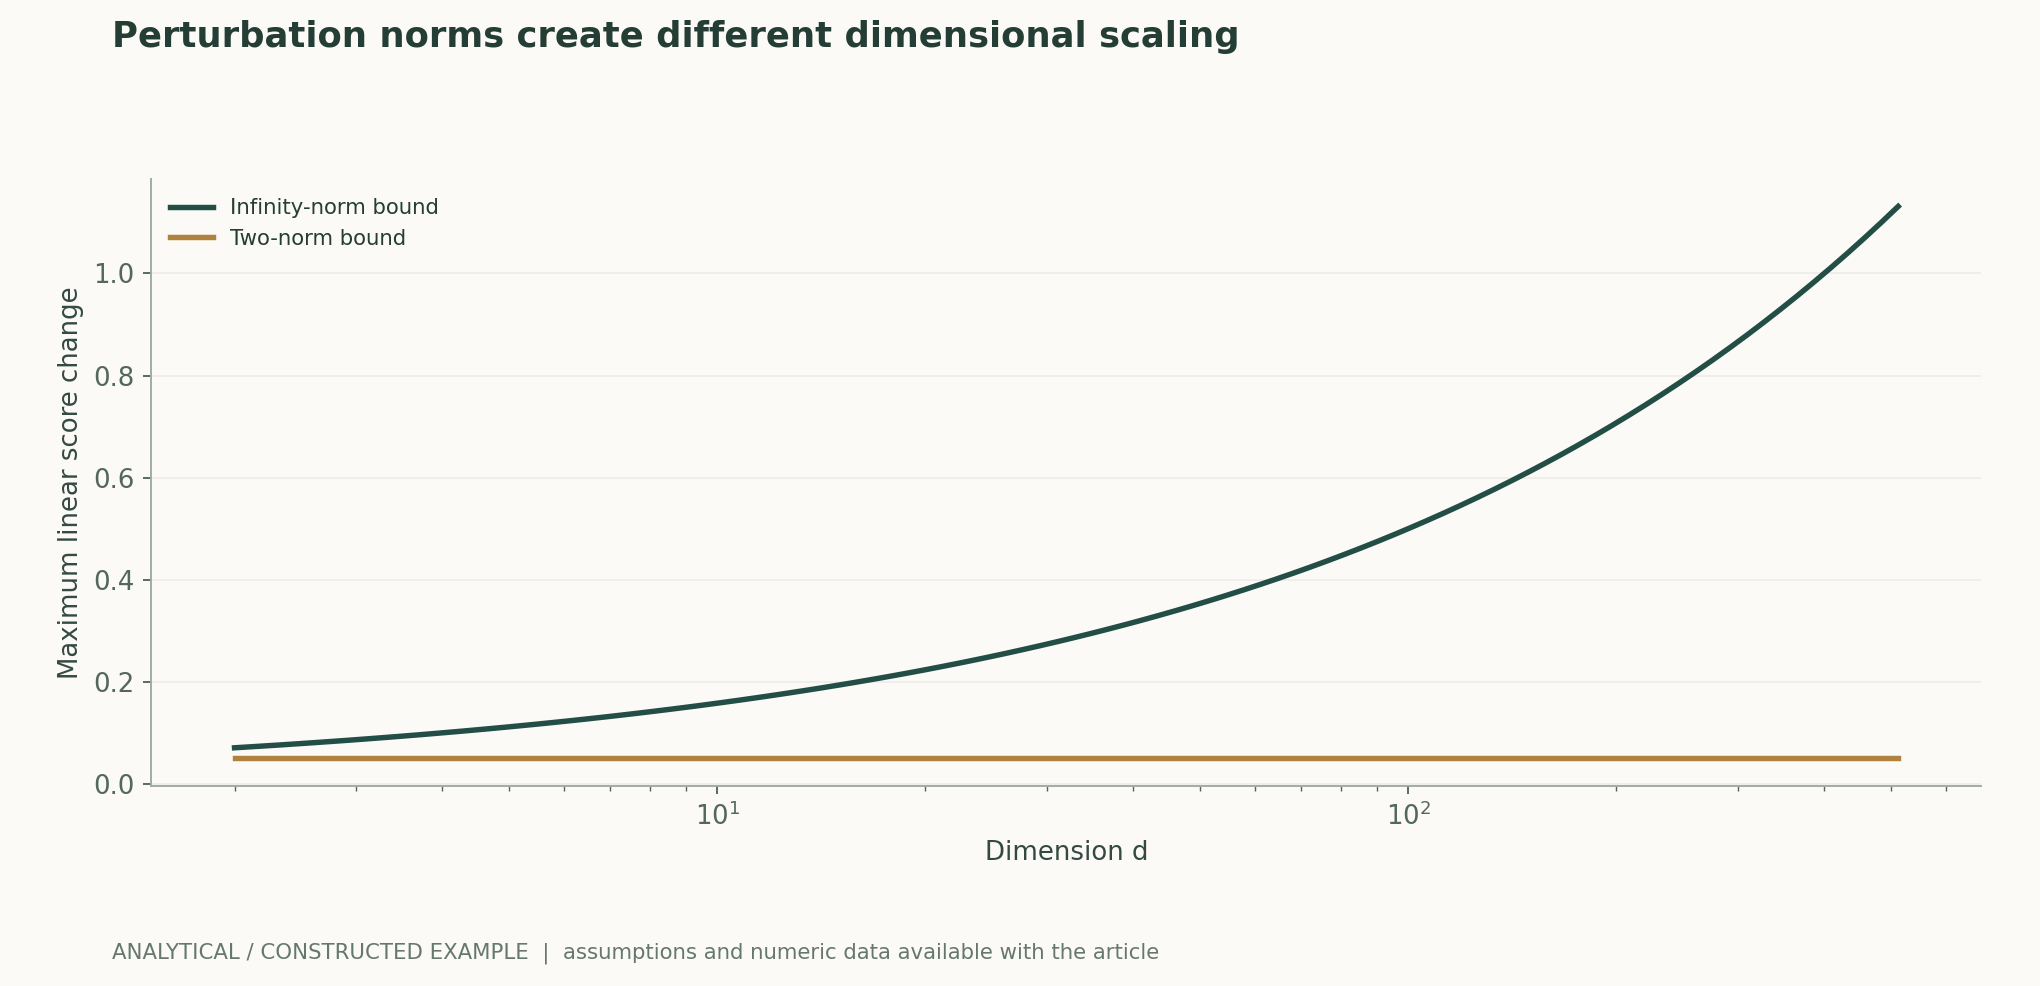
Para la puntuación lineal w transpuesta por x, una perturbación cuya norma infinito no supere ε puede modificar cada coordenada en la dirección del signo de w; el cambio máximo de puntuación es ε multiplicado por la norma uno de w. Si la norma euclídea de w se fija en 1 y sus componentes se distribuyen uniformemente entre d dimensiones, esta cantidad es ε√d; bajo un presupuesto de norma euclídea, el cambio máximo es ε. La figura solo presenta esta relación determinista: no implica que las redes neuronales fallen necesariamente al mismo ritmo ni que los presupuestos de distintas normas tengan la misma intensidad perceptiva.[1] Explaining and Harnessing Adversarial Examples
3. El entrenamiento adversario es optimización anidada, no inmunidad universal
La optimización robusta busca entradas peores dentro del conjunto de perturbaciones permitido y después actualiza el modelo para reducir la pérdida. La búsqueda interna suele ser solo aproximada; el número de pasos, la inicialización y la proyección sobre el conjunto de restricciones influyen tanto en el entrenamiento como en las pruebas de aceptación. Utilizar el mismo ataque durante el entrenamiento y la evaluación puede provocar sobreajuste a un método de búsqueda concreto. Se debe fijar el conjunto de amenazas, utilizar una evaluación independiente más potente o adaptativa e informar del presupuesto computacional. Aunque mejoren los resultados bajo una norma, no se puede afirmar robustez frente a todas las variaciones naturales o amenazas semánticas.[2] Towards Deep Learning Models Resistant to Adversarial A
4. El fracaso de un ataque no equivale a demostrar la seguridad
Los gradientes inestables, la aleatorización, el preprocesamiento no diferenciable o el truncamiento numérico pueden impedir que un algoritmo de ataque encuentre un fallo sin eliminar las entradas que lo provocan. Se requieren múltiples puntos de partida, distintos números de pasos y comprobaciones adaptativas adecuadas a la estructura de la defensa, así como verificar que los resultados se comporten razonablemente al aumentar el presupuesto. Las anomalías entre los resultados de caja blanca y caja negra, o que un ataque de un solo paso supere a uno de varios pasos, deben motivar una revisión. Las cotas certificadas y los resultados de ataques empíricos son tipos de evidencia distintos y no deben confundirse.[2] Towards Deep Learning Models Resistant to Adversarial A[1] Explaining and Harnessing Adversarial Examples
5. La exactitud natural y la robusta deben comunicarse conjuntamente
TRADES estudia la relación entre el error natural y el error robusto y propone un objetivo de entrenamiento correspondiente. El compromiso real depende de los datos, el modelo, las perturbaciones y el método de entrenamiento; esto no permite afirmar que todos los enfoques tengan una misma proporción fija de pérdida. Los informes deben mostrar curvas conjuntas para distintos hiperparámetros y conservar muestras naturales, casos difíciles y subgrupos, evitando seleccionar únicamente la mejor cifra de robustez y ocultar el deterioro en el uso habitual.[3] Theoretically Principled Trade-off between Robustness a
6. Una aceptación fiable exige fallos reproducibles y declaraciones de alcance
Se deben fijar el modelo, el preprocesamiento, el presupuesto de amenaza y la definición de éxito, y guardar los resultados de cada muestra de prueba controlada junto con las perturbaciones que puedan mostrarse legalmente. Primero se verifica la implementación del ataque en un modelo pequeño y después se ejecuta repetidamente sobre el modelo objetivo. Las conclusiones finales se limitan a los conjuntos, presupuestos y datos evaluados, y se enumeran las variaciones naturales o semánticas aún no cubiertas. Este artículo no realiza ataques reales, entrenamiento ni certificación; solo ofrece una derivación lineal y un marco de pruebas de aceptación.[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A[3] Theoretically Principled Trade-off between Robustness a
Ecuaciones fundamentales y derivaciones
(1) Resultado exacto para una función lineal: la perturbación óptima sigue el signo de w en cada coordenada; no es una fórmula general del error global de una red.
LaTeX
\max_{\|\delta\|_\infty\le\epsilon}w^\top\delta=\epsilon\|w\|_1(2) Dirección de un solo paso bajo la linealización local de la pérdida; las pruebas reales también requieren gestionar las restricciones y el intervalo válido de entrada.
LaTeX
\delta_{\mathrm{FGSM}}=\epsilon\operatorname{sign}(\nabla_x\mathcal L)(3) Objetivo de optimización robusta; la búsqueda numérica interna no obtiene automáticamente el máximo global.
LaTeX
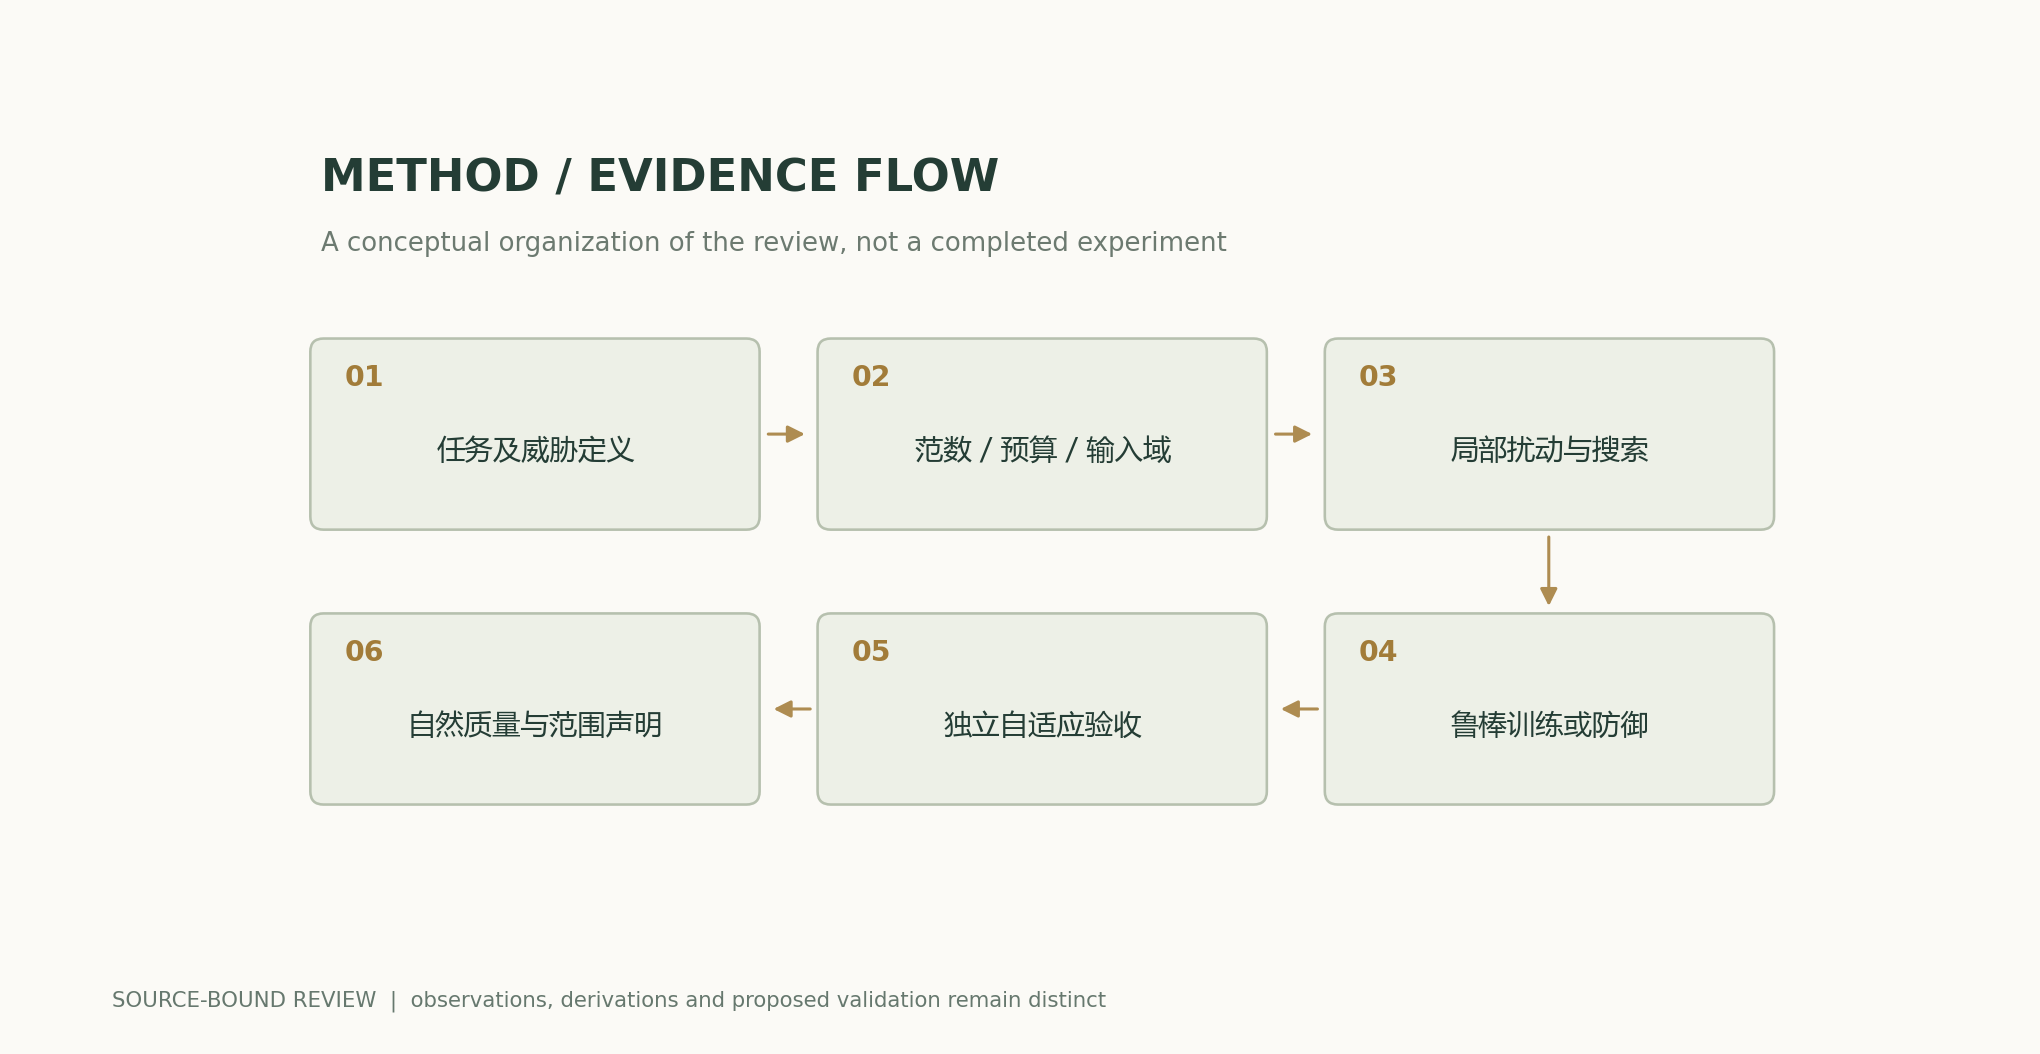
\min_\theta\mathbb E_{(x,y)}\max_{\delta\in S}\mathcal L(f_\theta(x+\delta),y)Flujo metodológico y de evidencia
Figuras analíticas y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Cuando d=100, el cambio lineal máximo bajo un presupuesto de norma infinito de 0.05 es 0.5, mientras que el cambio bajo un presupuesto de norma euclídea de 0.05 es 0.05. Las dos restricciones permiten conjuntos distintos y no pueden tratarse como capacidades de ataque equivalentes.
Comparación de métodos
| Método o valoración | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Amenaza restringida por norma | Fijar la norma, ε y el intervalo válido de entrada | Distintas normas no representan la misma capacidad de ataque |
| Ataques empíricos | Múltiples puntos de partida y presupuestos adaptativos | No encontrar un contraejemplo no demuestra su inexistencia |
| Entrenamiento adversario | Ataques independientes y pruebas de regresión con datos naturales | Las amenazas del entrenamiento no abarcan todas las variaciones |
| Informe de robustez | Presentación conjunta de calidad, coste y ámbito de aplicación | Una única tasa de éxito no puede representar una seguridad universal |
Plan de verificación y experimentación
- Definir claramente el alcance autorizado de las pruebas, el conjunto de amenazas, el presupuesto de consultas y los criterios de éxito.
- Fijar el modelo, el preprocesamiento y la aleatoriedad, y comprobar primero los resultados analíticos en un modelo pequeño.
- Utilizar una evaluación independiente con múltiples puntos de partida y presupuestos, adaptada a la estructura de la defensa.
- Comprobar la monotonía respecto al presupuesto y las anomalías de gradiente y numéricas para descartar artefactos debidos al enmascaramiento.
- Informar conjuntamente de la exactitud natural, las métricas de robustez, los subgrupos y el coste computacional.
- Conservar los fallos reproducibles y las declaraciones de alcance; no extrapolar a amenazas no evaluadas ni afirmar una seguridad universal.
Ámbito de aplicación y limitaciones
- La sensibilidad lineal no es una tasa de éxito de ataques contra redes.
- No se realizaron ataques contra servicios reales.
- Los ataques empíricos no pueden sustituir a la certificación.
- Las conclusiones deben limitarse al conjunto de amenazas.
Fuentes primarias y afirmaciones correspondientes
- Explaining and Harnessing Adversarial Examples, , · 2014-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Towards Deep Learning Models Resistant to Adversarial Attacks, , , , · 2017-06-19Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Theoretically Principled Trade-off between Robustness and Accuracy, , , , , · 2019-01-24Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión independiente por pares ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutiliza una página ya leída cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual y los diagramas científicos se mantienen separados; las figuras científicas se calculan a partir de ecuaciones publicadas y supuestos explícitos, y se atribuyen todos los resultados procedentes de artículos originales.
Autor, versión e historial de correcciones · /guides/robustness-adversarial/v1/
Fuentes de la portada y las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770