
摘要
鲁棒性不是一个脱离条件的模型属性,而是针对攻击者能力、扰动集合和任务定义的有限结论。本文推导线性模型在无穷范数预算下的最坏扰动,分析高维累积和范数区别,再讨论对抗训练、自然准确率折中与梯度遮蔽。图示是解析敏感度,不是针对真实服务的攻击或准确率测量。[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A[3] Theoretically Principled Trade-off between Robustness a
English abstract
Adversarial robustness is defined relative to a threat model, perturbation set and evaluation procedure. We derive the exact worst-case linear perturbation under an infinity-norm budget and contrast it with a two-norm constraint. Analytical dimension curves are not attack success rates. Adaptive evaluation and clean-robust tradeoffs remain empirical requirements.
1. 威胁模型必须先于攻击结果
应说明攻击者知道什么、能改哪些输入、改动大小、查询预算和成功标准。图像中的小范数扰动、自然分布变化和语义改写是不同威胁,不能互相替代。若攻击约束与真实用途无关,即使测试很严格也可能回答错问题。本文讨论公开方法的数学与防御验收,不对任何第三方服务实施攻击。[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A
2. 线性累积揭示高维敏感度
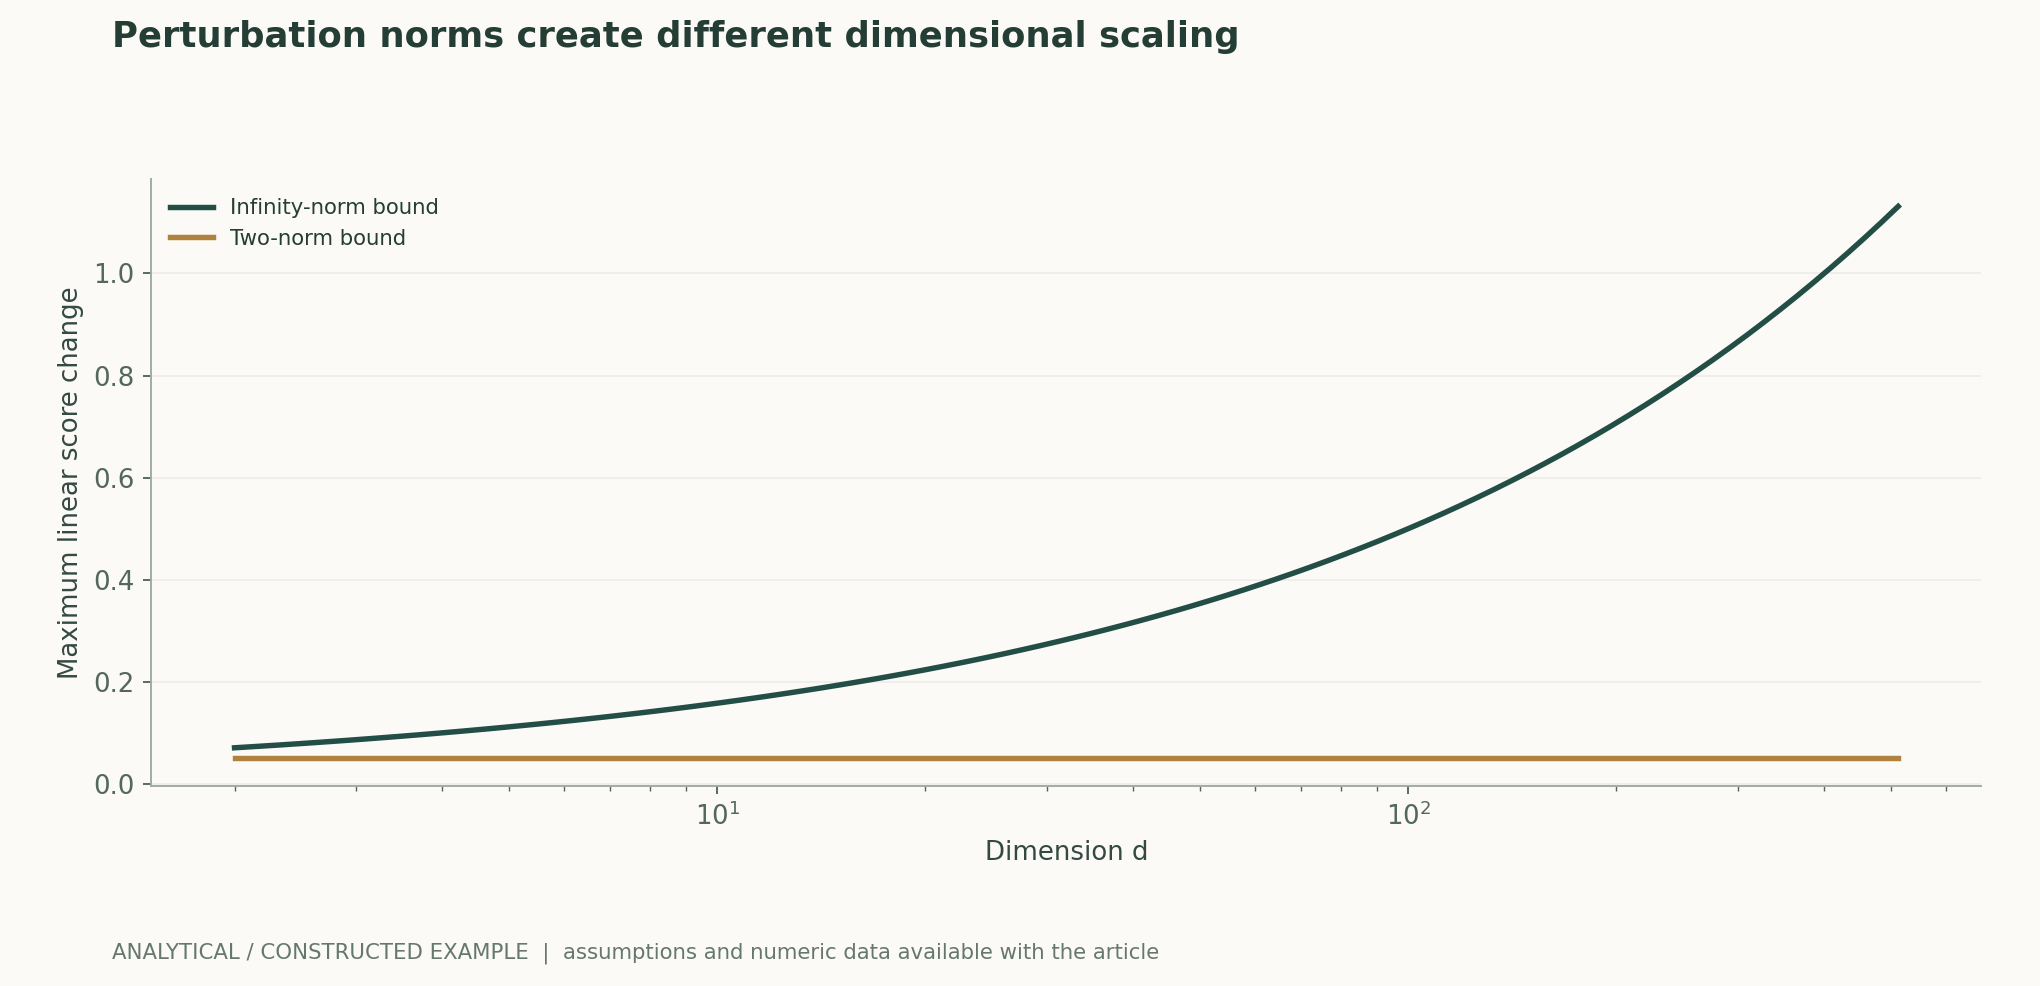
对线性得分w转置x,无穷范数不超过ε的扰动可令每个坐标沿w符号变化,最大得分变化为ε乘w的一范数。若w的二范数固定为1且均匀分布到d维,该量为ε√d;二范数预算下的最大变化则为ε。图中只展示这个确定性关系,不代表神经网络必然按同样速率失败,也不代表不同范数预算具有相同感知强度。[1] Explaining and Harnessing Adversarial Examples
3. 对抗训练是嵌套优化而非通用免疫
鲁棒优化在允许扰动集合中寻找较坏输入,再更新模型降低损失。内层搜索通常只是近似,步数、初始化和约束投影都会影响训练与验收。训练攻击与测试攻击相同,可能造成对特定搜索方式的过拟合。应固定威胁集合,使用独立更强或自适应的评估,并报告计算预算。即便某范数下结果改善,也不能宣称对所有自然变化或语义威胁鲁棒。[2] Towards Deep Learning Models Resistant to Adversarial A
4. 攻击失败不等于证明安全
梯度不稳定、随机化、不可微预处理或数值截断,可能让一个攻击器找不到失败,却没有消除失败输入。需要多起点、不同步数和适合防御结构的自适应检查,并核对增加预算时结果是否合理。白盒与黑盒结果反常、单步强于多步等现象应触发复核。认证界限与经验攻击结果属于不同证据,不能混称。[2] Towards Deep Learning Models Resistant to Adversarial A[1] Explaining and Harnessing Adversarial Examples
5. 自然准确率与鲁棒准确率要联合报告
TRADES研究自然误差与鲁棒误差之间的关系,并提出相应训练目标。实际折中依赖数据、模型、扰动和训练方式;不能据此宣称所有方案存在同一个固定损失比例。报告应画出不同超参数下的联合曲线,保留自然样本、难例和子群,避免只挑一个最好鲁棒数字而隐藏正常使用退化。[3] Theoretically Principled Trade-off between Robustness a
6. 可靠验收需要可重复失败与范围声明
冻结模型、预处理、威胁预算与成功定义,保存每个受控测试样本的结果及合法可展示扰动。先在小模型上核对攻击实现,再对目标模型多次运行。最终结论限定到测过的集合、预算和数据,并列出尚未覆盖的自然或语义变化。本文没有进行真实攻击、训练或认证,只提供线性推导与验收框架。[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A[3] Theoretically Principled Trade-off between Robustness a
核心公式与推导
(1) 线性函数的精确结果,最优扰动沿w逐坐标符号;不是一般网络全局误差公式。
LaTeX
\max_{\|\delta\|_\infty\le\epsilon}w^\top\delta=\epsilon\|w\|_1(2) 损失局部线性化下的单步方向,实际测试还需约束和有效输入范围处理。
LaTeX
\delta_{\mathrm{FGSM}}=\epsilon\operatorname{sign}(\nabla_x\mathcal L)(3) 鲁棒优化目标;内层数值搜索不自动得到全局最大值。
LaTeX
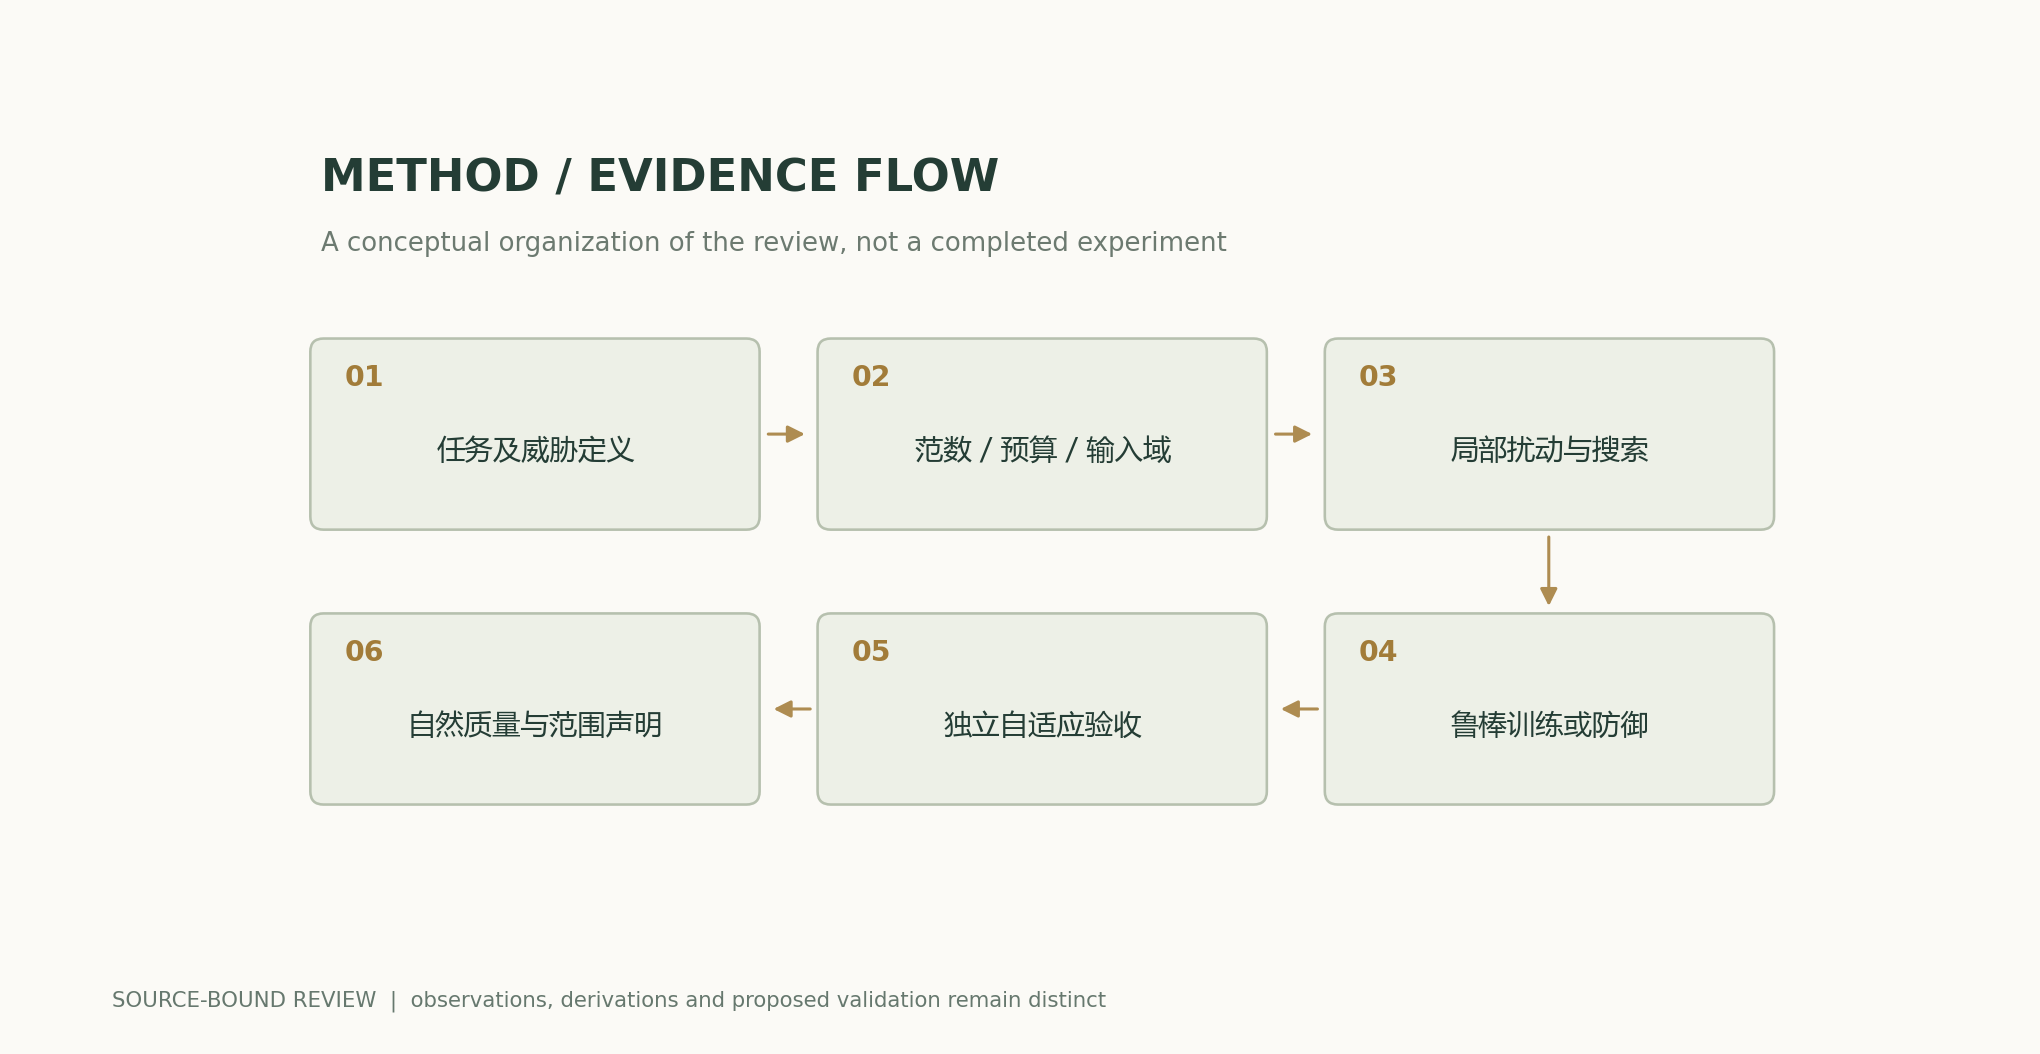
\min_\theta\mathbb E_{(x,y)}\max_{\delta\in S}\mathcal L(f_\theta(x+\delta),y)方法与证据流程
解析图与数值示例
可复算例题
d=100时,无穷范数预算0.05的最大线性变化0.5,二范数预算0.05的变化0.05。两个约束允许的集合不同,不能当作同等攻击能力。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 范数威胁 | 固定范数、ε和有效输入范围 | 不同范数不是相同攻击能力 |
| 经验攻击 | 多起点和自适应预算 | 找不到反例不证明不存在 |
| 对抗训练 | 独立攻击及自然数据回归 | 训练威胁不覆盖所有变化 |
| 鲁棒报告 | 质量、成本与适用范围联合 | 单一成功率无法代表普遍安全 |
复核与实验方案
- 明确授权测试范围、威胁集合、查询预算和成功标准。
- 冻结模型、预处理与随机性,先核对小模型解析结果。
- 使用多起点、多预算和适配防御结构的独立评估。
- 检查预算单调性、梯度与数值异常,排除遮蔽造成的假象。
- 同时报告自然准确率、鲁棒指标、子群与计算成本。
- 保存可重复失败及范围声明,不外推未测威胁或宣称通用安全。
适用范围与局限
- 线性敏感度不是网络攻击成功率。
- 没有对真实服务实施攻击。
- 经验攻击不能替代认证。
- 结论必须限定威胁集合。
一手来源与主张对应
- Explaining and Harnessing Adversarial Examples, , · 2014-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Towards Deep Learning Models Resistant to Adversarial Attacks, , , , · 2017-06-19Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Theoretically Principled Trade-off between Robustness and Accuracy, , , , , · 2019-01-24Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/robustness-adversarial/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770