
要旨
頑健性は、条件から独立したモデルの属性ではなく、攻撃者の能力、摂動集合、タスクの定義に対する限定的な結論である。本稿では、無限大ノルム予算の下で線形モデルの最悪摂動を導出し、高次元での累積とノルム間の違いを分析したうえで、敵対的訓練、自然データ上の正解率とのトレードオフ、勾配マスキングを論じる。図は解析的な感度を示すものであり、実サービスに対する攻撃や正解率の測定ではない。[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A[3] Theoretically Principled Trade-off between Robustness a
原文の英語要旨の日本語訳
敵対的頑健性は、脅威モデル、摂動集合、評価手順に対して定義される。無限大ノルム予算の下で線形モデルの厳密な最悪摂動を導出し、二乗和平方根ノルムによる制約と対比する。次元に対する解析的な曲線は攻撃成功率ではない。適応的評価と、自然データ上の性能と頑健性のトレードオフの検証は、依然として実証上の要件である。
1. 脅威モデルは攻撃結果に先立って定めなければならない
攻撃者が何を知り、どの入力を変更できるか、変更の大きさ、クエリ予算、成功基準を明示すべきである。画像における小ノルム摂動、自然な分布変化、意味的な書き換えは異なる脅威であり、相互に代替できない。攻撃制約が実際の用途と無関係であれば、厳格な試験であっても誤った問いに答えている可能性がある。本稿は公開手法の数学と防御の受入評価を論じるものであり、第三者のサービスへの攻撃は一切実施しない。[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A
2. 線形的な累積が高次元の感度を明らかにする
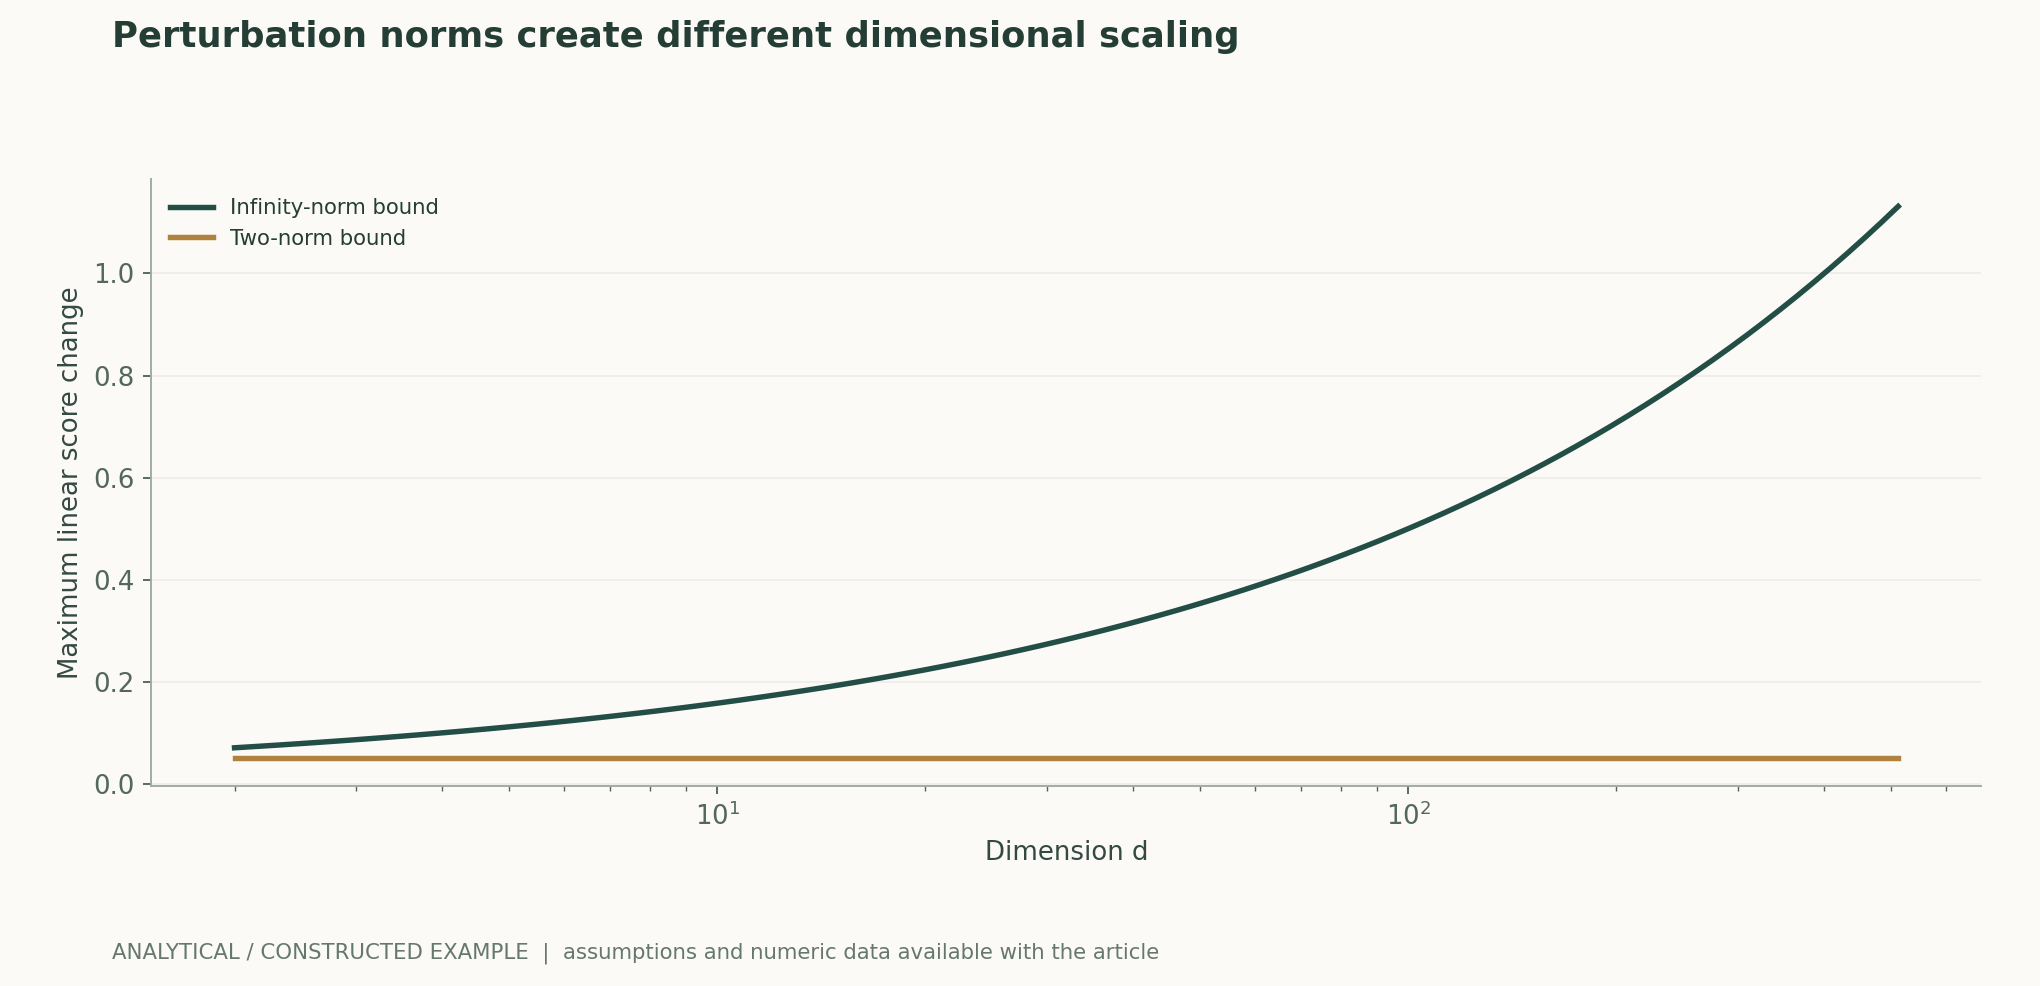
線形スコアであるwの転置とxの積に対して、無限大ノルムがε以下の摂動は、各座標をwの符号に沿って変化させることができ、最大スコア変化はεとwの絶対値和ノルムの積となる。wの二乗和平方根ノルムを1に固定し、各成分をd次元に均等に配分すると、この量はε√dとなる。一方、二乗和平方根ノルム予算の下での最大変化はεである。図はこの決定論的関係のみを示しており、ニューラルネットワークが必ず同じ速度で失敗することも、異なるノルムの予算が同じ知覚的強度を持つことも意味しない。[1] Explaining and Harnessing Adversarial Examples
3. 敵対的訓練は入れ子型最適化であり、普遍的な免疫ではない
頑健最適化は、許容摂動集合の中でより悪い入力を探索し、その後、損失を低減するようモデルを更新する。内側の探索は通常、近似にすぎず、ステップ数、初期化、制約集合への射影はいずれも訓練と受入評価に影響する。訓練時と試験時に同じ攻撃を用いると、特定の探索方法への過適合が生じる可能性がある。脅威集合を固定し、独立した、より強力な評価または適応的評価を用い、計算予算を報告すべきである。あるノルムで結果が改善しても、あらゆる自然な変化や意味的脅威に対する頑健性を主張することはできない。[2] Towards Deep Learning Models Resistant to Adversarial A
4. 攻撃の失敗は安全性の証明ではない
勾配の不安定性、ランダム化、微分不可能な前処理、数値的な切り捨てにより、失敗を引き起こす入力が除去されていなくても、攻撃アルゴリズムが失敗を発見できなくなる場合がある。複数の初期点、異なるステップ数、防御構造に適した適応的検査を用い、予算を増やした際の結果が妥当かどうかを確認する必要がある。ホワイトボックスとブラックボックスの結果の異常や、単一ステップ攻撃が複数ステップ攻撃を上回る現象は、再検証の契機とすべきである。認証された境界と経験的攻撃の結果は異なる種類の証拠であり、混同してはならない。[2] Towards Deep Learning Models Resistant to Adversarial A[1] Explaining and Harnessing Adversarial Examples
5. 自然データ上の正解率と頑健正解率は併せて報告する必要がある
TRADESは自然誤差と頑健誤差の関係を研究し、それに対応する訓練目的を提案している。実際のトレードオフはデータ、モデル、摂動、訓練方法に依存するため、すべての手法に共通する固定の損失比率が存在すると主張することはできない。報告では、異なるハイパーパラメータの下で両者の関係を示す曲線を描き、自然サンプル、難例、部分集団を保持すべきである。最良の頑健性の数値だけを選び、通常利用における性能低下を隠すことは避けなければならない。[3] Theoretically Principled Trade-off between Robustness a
6. 信頼できる受入評価には再現可能な失敗と範囲の明示が必要である
モデル、前処理、脅威予算、成功の定義を固定し、管理された各試験サンプルの結果と、適法に提示できる摂動を保存する。まず小規模モデルで攻撃の実装を確認し、その後、対象モデルに対して複数回実行する。最終的な結論は試験した集合、予算、データに限定し、未検証の自然な変化や意味的変化を列挙する。本稿は実際の攻撃、訓練、認証を行っておらず、線形モデルの導出と受入評価の枠組みのみを提供する。[1] Explaining and Harnessing Adversarial Examples[2] Towards Deep Learning Models Resistant to Adversarial A[3] Theoretically Principled Trade-off between Robustness a
主要な数式と導出
(1) 線形関数に対する厳密な結果であり、最適摂動は各座標でwの符号に従う。一般のネットワークの大域的誤差を表す式ではない。
LaTeX
\max_{\|\delta\|_\infty\le\epsilon}w^\top\delta=\epsilon\|w\|_1(2) 損失を局所的に線形化した場合の単一ステップの方向であり、実際の試験では制約と有効な入力範囲への対処も必要となる。
LaTeX
\delta_{\mathrm{FGSM}}=\epsilon\operatorname{sign}(\nabla_x\mathcal L)(3) 頑健最適化の目的関数。内側の数値探索が自動的に大域的最大値を得るわけではない。
LaTeX
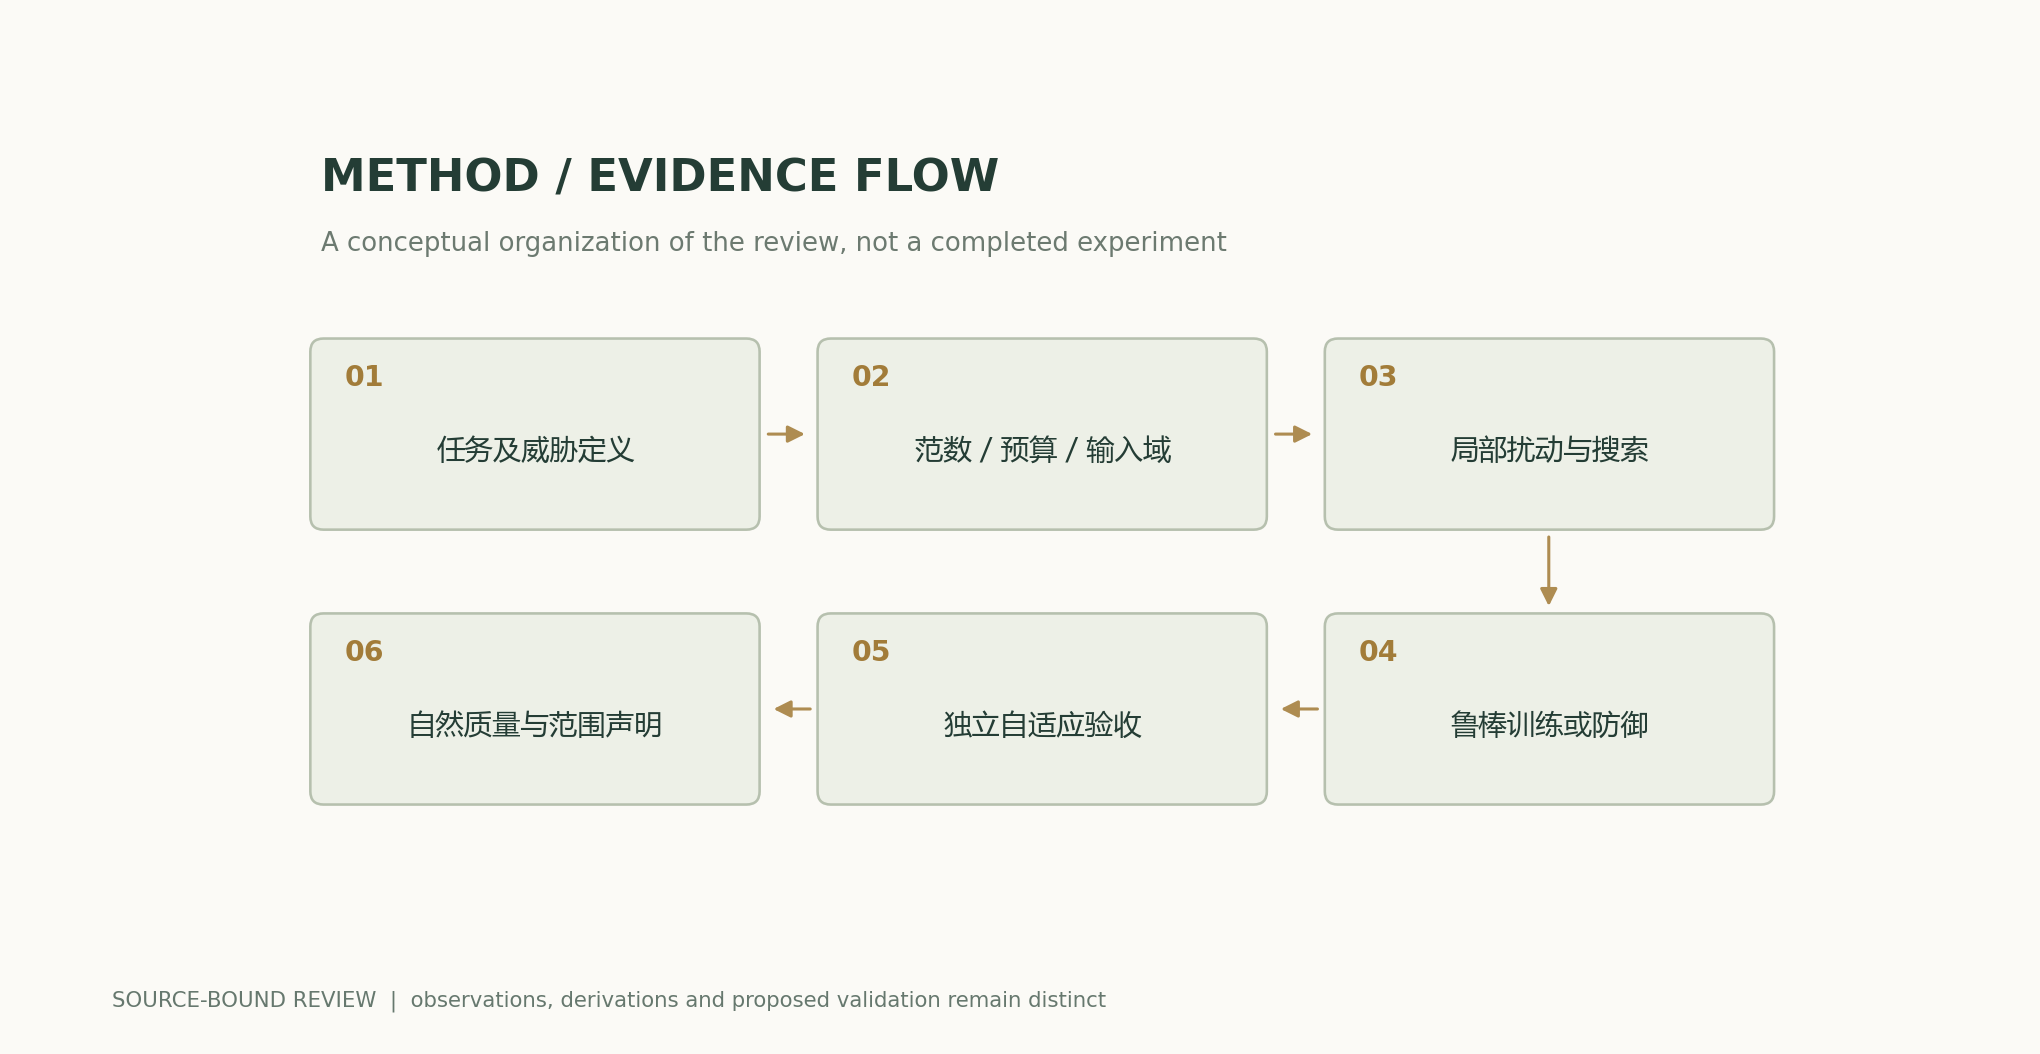
\min_\theta\mathbb E_{(x,y)}\max_{\delta\in S}\mathcal L(f_\theta(x+\delta),y)方法と証拠のフロー
解析図と数値例
再計算可能な例題
d=100のとき、無限大ノルム予算0.05における最大線形変化は0.5であり、二乗和平方根ノルム予算0.05における変化は0.05である。両制約が許容する集合は異なるため、同等の攻撃能力として扱うことはできない。
手法の比較
| 手法または判断 | 制御変数と測定 | 失敗条件と解釈 |
|---|---|---|
| ノルム制約付きの脅威 | ノルム、ε、有効な入力範囲を固定する | 異なるノルムは同じ攻撃能力を意味しない |
| 経験的攻撃 | 複数の初期点と適応的予算 | 反例が見つからないことは、その不存在の証明ではない |
| 敵対的訓練 | 独立した攻撃と自然データ上の回帰テスト | 訓練時の脅威はすべての変化を網羅しない |
| 頑健性の報告 | 品質、コスト、適用範囲を併せて報告する | 単一の成功率で普遍的な安全性を表すことはできない |
検証と実験の計画
- 許可された試験範囲、脅威集合、クエリ予算、成功基準を明確にする。
- モデル、前処理、ランダム性を固定し、まず小規模モデルで解析結果を確認する。
- 複数の初期点と予算を用い、防御構造に適応した独立評価を実施する。
- 予算に対する単調性、勾配および数値の異常を確認し、マスキングによる見かけ上の効果を排除する。
- 自然データ上の正解率、頑健性指標、部分集団、計算コストを併せて報告する。
- 再現可能な失敗と範囲の記述を保存し、未試験の脅威への外挿や普遍的な安全性の主張を行わない。
適用範囲と限界
- 線形感度はネットワークへの攻撃成功率ではない。
- 実サービスに対する攻撃は実施していない。
- 経験的攻撃は認証の代替にはならない。
- 結論は脅威集合に限定しなければならない。
一次資料と主張の対応
- Explaining and Harnessing Adversarial Examples, , · 2014-12-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Towards Deep Learning Models Resistant to Adversarial Attacks, , , , · 2017-06-19Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Theoretically Principled Trade-off between Robustness and Accuracy, , , , , · 2019-01-24Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者、版、出典
AI支援による研究レビュー。Codex(AI)が、掲載した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿に対する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前版の内容を維持している。
概念的な表紙と科学図は区別している。科学図は公開された数式と明示的な仮定から計算し、原論文の結果にはすべて帰属を明記している。
著者、版、訂正履歴 · /guides/robustness-adversarial/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開と版の履歴
出典の改訂版: 6251a250b27bb8b449f59b392f81abd355383770