
Resumen
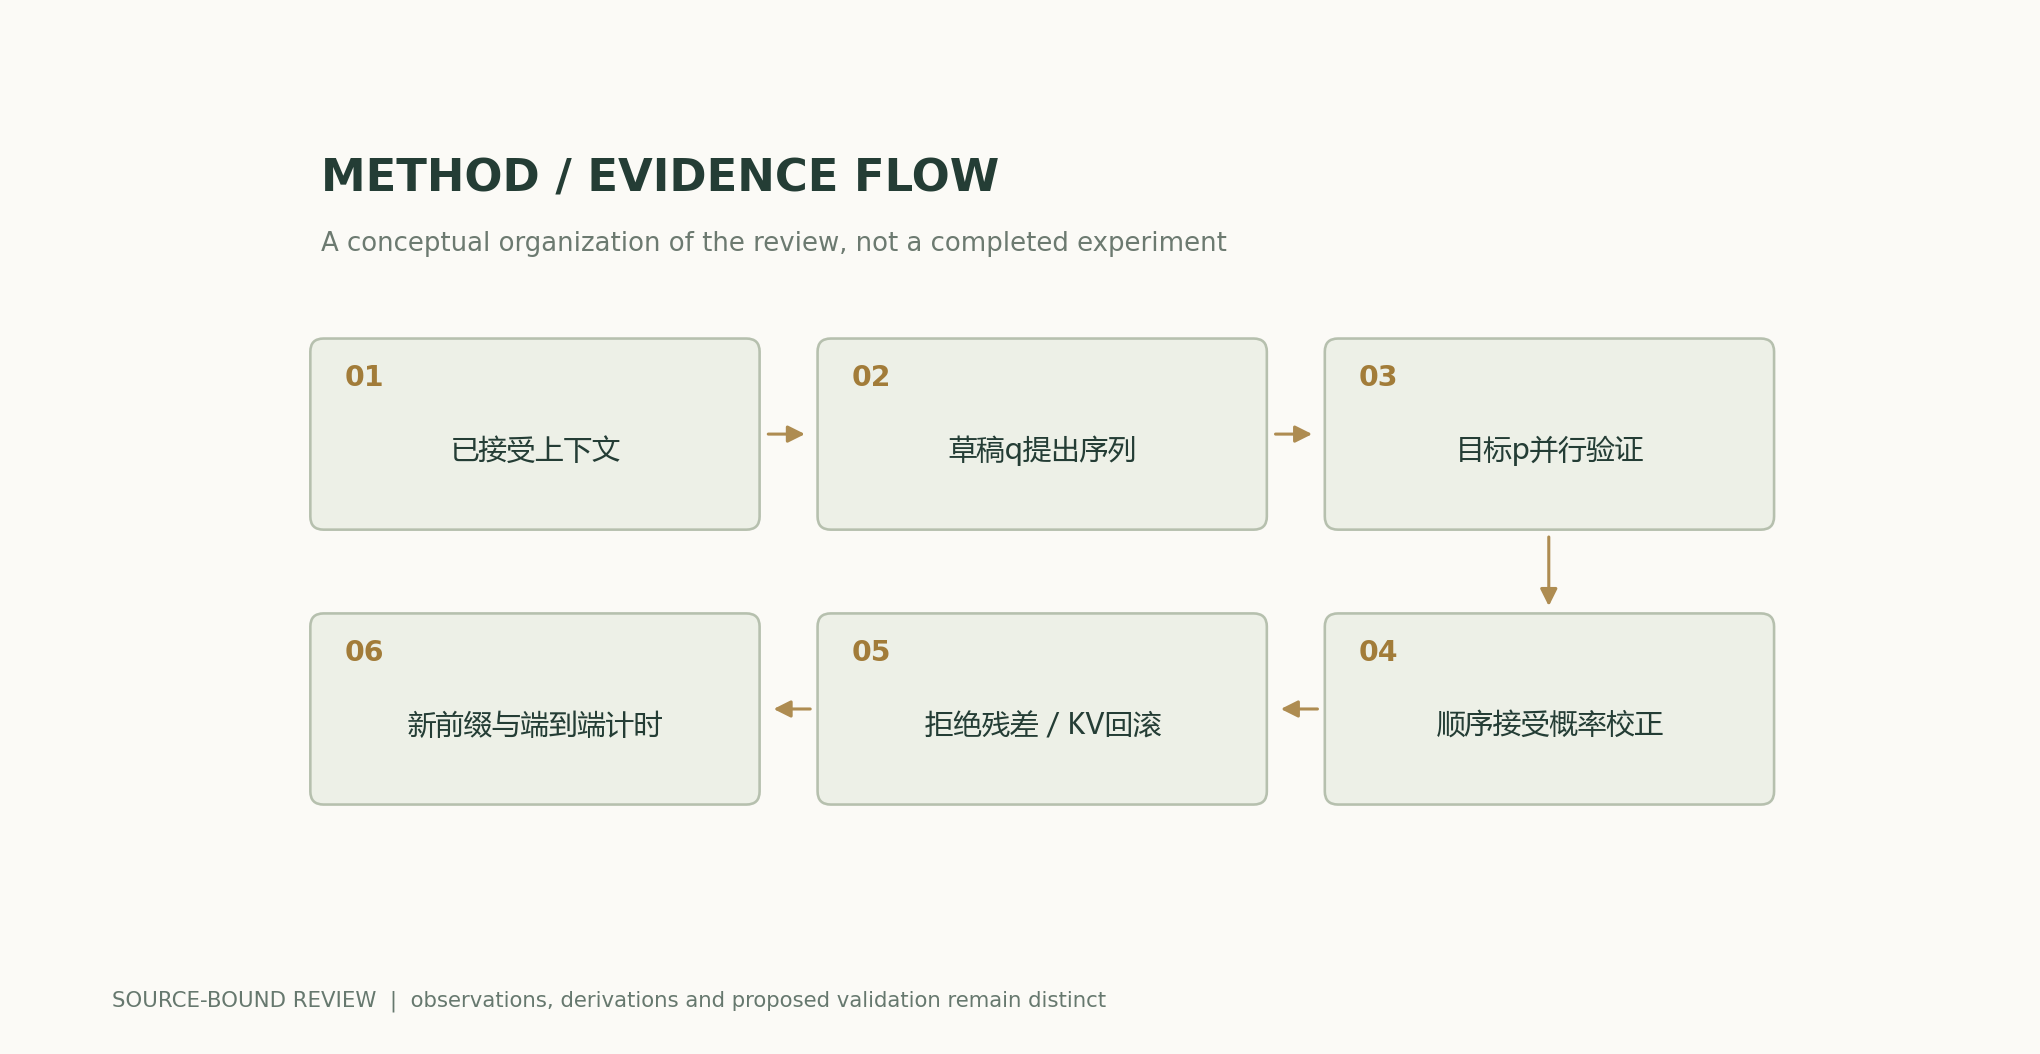
La decodificación especulativa utiliza primero un modelo borrador de bajo coste para proponer varios tokens y luego los verifica mediante el modelo objetivo, preservando la distribución objetivo bajo reglas adecuadas de aceptación y muestreo residual. Este artículo deriva cómo se asigna la masa de probabilidad de un solo paso y analiza por separado la corrección distribucional y la aceleración del sistema. El modelo analítico de costes supone explícitamente una tasa de aceptación constante por paso y un coste unitario de verificación del modelo objetivo; solo sirve para explicar los compromisos y no constituye una medición en un dispositivo. El plan de verificación incluye la temperatura, el muestreo truncado, las condiciones de parada y la precisión numérica.[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula[3] Attention Is All You Need
Traducción del resumen en inglés
La decodificación especulativa se estudia como una corrección exacta de la distribución bajo probabilidades objetivo y reglas de muestreo explícitamente concordantes. Derivamos la masa aceptada y la distribución residual y, a continuación, analizamos un modelo idealizado de costes con aceptación constante. Las razones de velocidad representadas son escenarios analíticos, no mediciones de hardware. La temperatura, el truncamiento, la precisión numérica y la semántica de parada deben comprobarse como parte de la corrección.
1. El borrador es una propuesta, no la respuesta final
Sean p la distribución objetivo y q la distribución del borrador. No basta con que el modelo borrador sea de bajo coste: también debe solaparse suficientemente con la distribución objetivo en el contexto actual; de lo contrario, se rechazarán numerosas propuestas. Las distribuciones posteriores de un borrador de varios tokens dependen del prefijo. Una vez que la verificación llega al primer rechazo, el resto del borrador deja de tener el mismo prefijo aceptado. La implementación debe utilizar las probabilidades condicionales correctas, en lugar de filtrar todas las posiciones de forma independiente y concatenar los resultados. Las reglas reales de muestreo del modelo objetivo también forman parte de la definición de p.[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
2. La aceptación y el residuo recuperan conjuntamente las probabilidades objetivo
Un token candidato extraído de q se acepta con probabilidad min(1,p/q), lo que produce una masa de probabilidad aceptada de min(p,q). La masa objetivo no cubierta es la parte positiva de [p-q]; tras un rechazo, es necesario muestrear de esta distribución residual normalizada para completar la distribución objetivo. Esta corrección explica por qué no se puede sustituir arbitrariamente un token rechazado por otro de alta probabilidad, ni considerar directamente la tasa de aceptación del borrador como calidad de salida. Las implementaciones reales deben tratar correctamente las probabilidades nulas y la precisión numérica; si p y q difieren en temperatura o en el soporte tras el truncamiento, la corrección debe basarse en las distribuciones reales después del procesamiento.[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
3. La equivalencia distribucional no implica trayectorias aleatorias idénticas
El muestreo especulativo correcto y el muestreo paso a paso del modelo objetivo pueden tener la misma distribución de salida sin generar necesariamente cadenas exactamente iguales con la misma semilla, porque consumen números aleatorios en distinto orden. Las pruebas deben comenzar calculando distribuciones exactas para vocabularios pequeños y secuencias cortas, comparando las frecuencias de numerosas muestras con el error estadístico y, después, comprobando la semántica del modelo completo. En la decodificación voraz, el criterio de equivalencia es diferente; para top-k o top-p, también deben coincidir los puntos en los que se aplican el truncamiento y la renormalización. No se puede declarar correcta una implementación solo por la similitud de unos pocos ejemplos de texto.[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
4. El beneficio esperado procede de avanzar varios pasos con una sola verificación
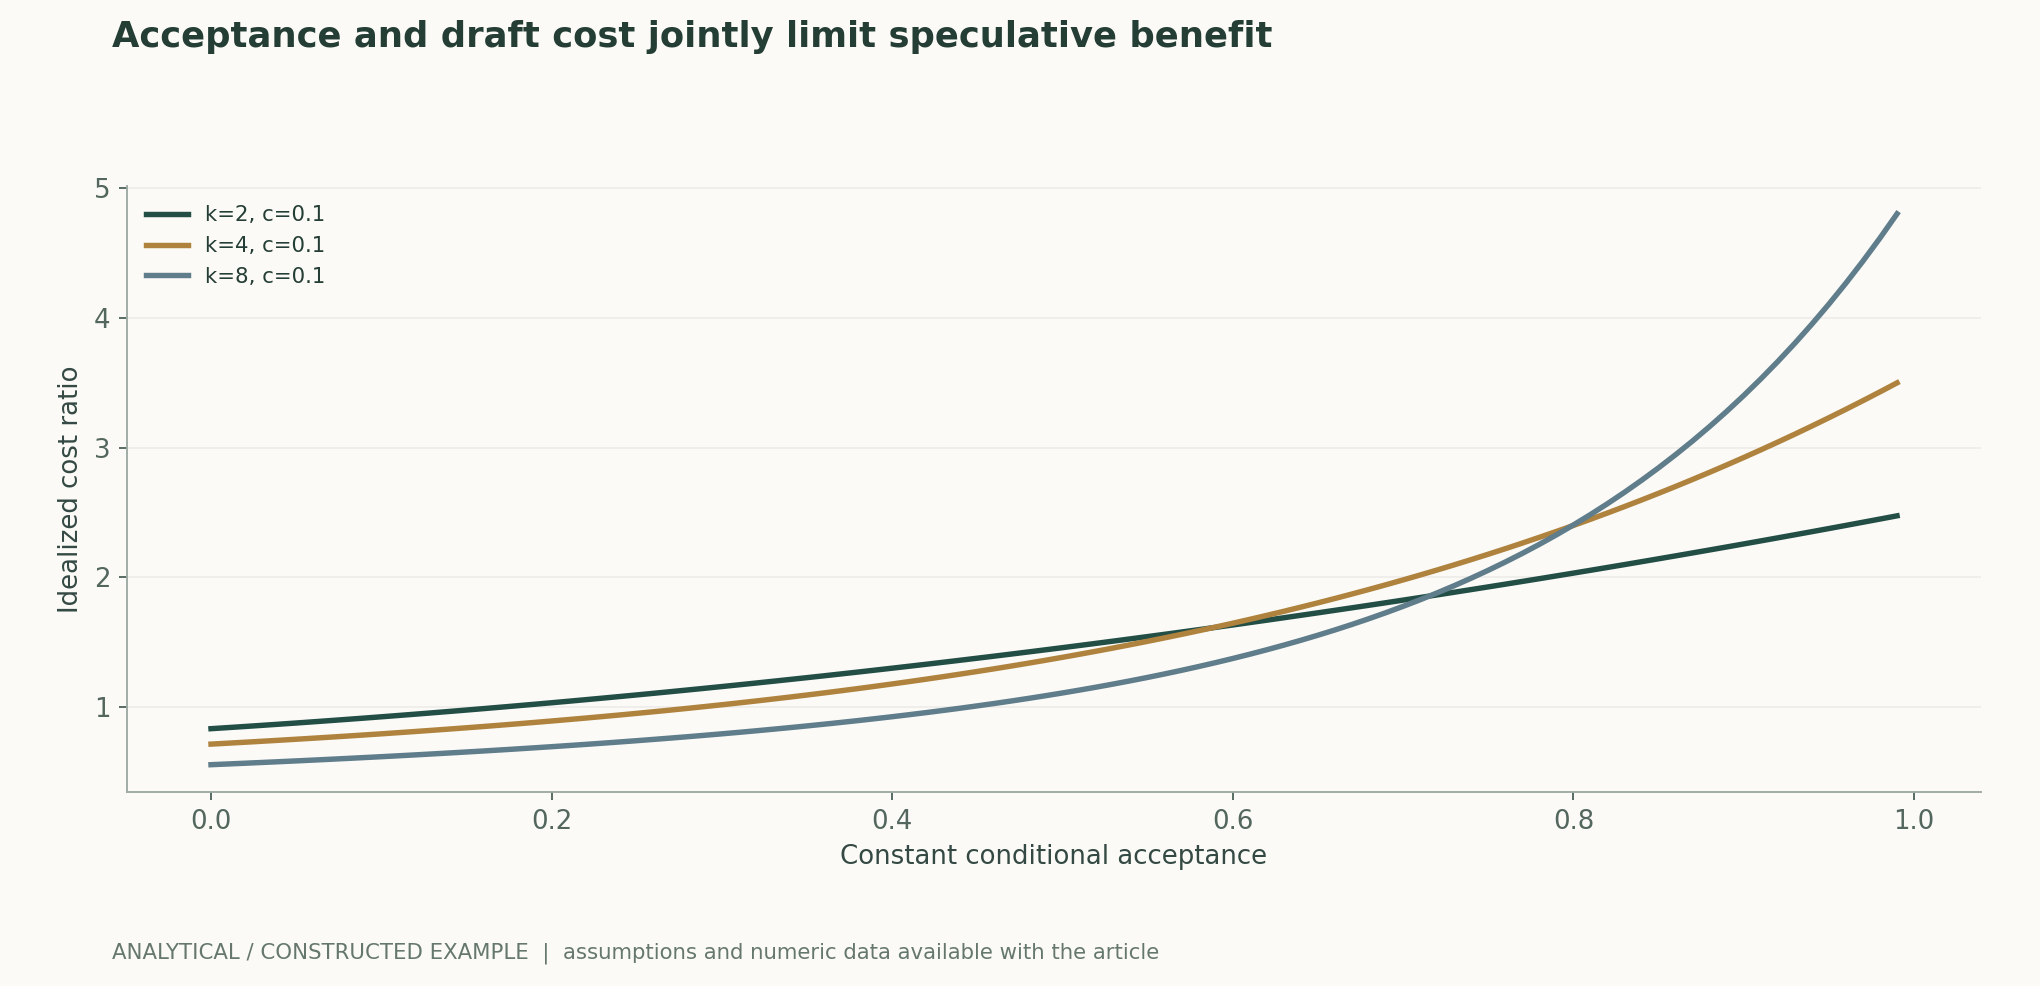
Bajo el supuesto idealizado de una tasa de aceptación α constante e independiente, un borrador de longitud k permite que una verificación del modelo objetivo avance, en promedio, 1+α+…+α^k tokens. Sin embargo, la generación del borrador, el aumento de la longitud de verificación del modelo objetivo, la copia de memoria y la sincronización también tienen costes. Si el coste del borrador es elevado o la tasa de aceptación es baja, el sistema puede ser más lento. La figura fija el coste de una verificación del modelo objetivo en 1 y el coste por token del borrador en 0.1, y representa únicamente las razones condicionadas a este modelo; el coste real de verificación no es constante y debe volver a medirse en el dispositivo y con los tamaños de lote previstos.[1] Fast Inference from Transformers via Speculative Decodi
5. El procesamiento por lotes y la gestión de KV modifican la longitud óptima del borrador
Los borradores más largos aumentan el número potencial de pasos de avance, pero también el cálculo, el almacenamiento temporal de KV y la reversión tras un rechazo. En el procesamiento continuo por lotes, las solicitudes presentan distintas longitudes aceptadas, lo que introduce costes de planificación y relleno; cuando varias solicitudes comparten un dispositivo, el beneficio por solicitud puede no coincidir con el rendimiento global. Deben medirse por separado el tiempo hasta el primer token, la velocidad de decodificación en régimen estable, la latencia de cola y la memoria, abarcando salidas tanto cortas como largas. La selección dinámica de la longitud del borrador también requiere registrar las reglas de decisión; no se debe informar únicamente del intervalo más favorable después de examinar los resultados.[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula[3] Attention Is All You Need
6. La corrección y el rendimiento requieren validaciones independientes
Primero deben validarse la distribución, los tokens de parada, la longitud máxima, la cancelación de solicitudes y la reversión de KV; después, el coste de extremo a extremo. Una implementación correcta en términos distribucionales puede seguir viéndose afectada por la precisión o por la implementación del muestreo; si una implementación rápida modifica la distribución objetivo, debe recibir una denominación y una evaluación independientes como otro algoritmo aproximado. Todas las comparaciones de rendimiento deben mantener fijos el modelo objetivo, la configuración de muestreo, la distribución de entradas y las restricciones del servicio. En este artículo no se ejecutaron modelos borrador ni objetivo. Los gráficos basados en ecuaciones solo sustentan la relación entre tasa de aceptación y coste idealizado, no ningún factor real de aceleración.[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
Ecuaciones principales y derivaciones
(1) Los candidatos proceden de q; esta distribución de propuestas no propone posiciones donde q es nula. La masa aceptada es solo una parte de la probabilidad objetivo.
LaTeX
a(x)=\min\{1,p(x)/q(x)\},\qquad q(x)a(x)=\min\{p(x),q(x)\}(2) Distribución de corrección tras el rechazo; cuando el denominador es nulo, ambas distribuciones son iguales y no se necesita esta rama de rechazo.
LaTeX
r(x)=\frac{[p(x)-q(x)]_+}{\sum_y[p(y)-q(y)]_+}(3) Modelo idealizado con tasa de aceptación constante e independiente y coste unitario de verificación. La figura utiliza c=0.1; los costes de verificación, procesamiento por lotes y KV en hardware real deben medirse por separado.
LaTeX
\mathbb E[L]=\sum_{i=0}^{k}\alpha^i,\qquad S_{\mathrm{toy}}=\frac{\sum_{i=0}^{k}\alpha^i}{1+kc}Flujo metodológico y de evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que permite repetir los cálculos
En el modelo idealizado, con α=0.8 y k=4, el avance medio es de 3.3616 tokens, el coste es 1.4 y la razón es aproximadamente 2.401; con α=0.2, la razón es aproximadamente 0.893, por lo que no hay beneficio. El coste real de verificación y el procesamiento por lotes no son constantes.
Comparación de métodos
| Método o valoración | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Corrección de probabilidades | Comprobar la aceptación y el residuo con p y q después del procesamiento | Omitir el residuo modifica la distribución objetivo |
| Reproducibilidad aleatoria | Comprobar la distribución en lugar de limitarse a comparar textos generados con la misma semilla | La igualdad de distribuciones no requiere trayectorias aleatorias idénticas |
| Longitud del borrador | Medir conjuntamente la longitud aceptada y todos los costes adicionales | Un borrador más largo no garantiza mayor velocidad |
| Servicio en producción | Presentar por separado el rendimiento, la latencia de cola, la cancelación y la reversión de KV | El beneficio idealizado de una solicitud no representa el beneficio por lotes |
Plan de verificación y experimentación
- Fijar las versiones de los modelos objetivo y borrador, la temperatura, top-k/top-p y la semántica de parada.
- Construir un vocabulario pequeño que pueda enumerarse exhaustivamente y comprobar, elemento por elemento, que la masa aceptada más la residual sea igual a p.
- Realizar pruebas de frecuencia con secuencias cortas e informar del número de muestras y del error estadístico, en lugar de limitarse a examinar el texto.
- Cubrir casos límite como probabilidad nula, distribuciones iguales, rechazo en el primer paso, aceptación total y tokens de parada.
- Fijar las longitudes de entrada y salida y el tamaño del lote, y medir los tiempos de borrador, verificación, KV, planificación y extremo a extremo.
- Comprobar individualmente la cancelación y la reversión, e informar de las modificaciones aproximadas por separado de las implementaciones que preservan la distribución objetivo.
Ámbito de aplicación y limitaciones
- No hay mediciones de aceleración en modelos ni en hardware.
- La tasa de aceptación constante es solo un supuesto del modelo.
- Las transformaciones de muestreo y la precisión afectan a la corrección de la distribución.
- La planificación del servicio puede modificar los parámetros óptimos.
Correspondencia entre fuentes primarias y afirmaciones
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Accelerating Large Language Model Decoding with Speculative Sampling, , , , , · 2023-02-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y coincide el ETag. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se presenta por separado de las figuras científicas; estas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autor, versiones e historial de correcciones · /guides/speculative-decoding/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770