
要旨
投機的デコーディングでは、まず低コストのドラフトモデルが複数のトークンを提案し、次にターゲットモデルが検証する。適切な受理規則と残差サンプリング規則の下では、ターゲット分布が保持される。本稿では単一ステップの確率質量がどのように配分されるかを導出し、分布の正しさとシステムの高速化を分けて論じる。解析的コストモデルは、各ステップの受理率が一定であり、ターゲット検証コストが単位化されていることを明示的に仮定する。このモデルはトレードオフの説明のみに用いるものであり、実機測定ではない。温度、打ち切りサンプリング、停止条件、数値精度はいずれも検証計画に含める。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula[3] Attention Is All You Need
原文の英語要旨の日本語訳
投機的デコーディングを、ターゲット確率とサンプリング規則を明示的に整合させた条件下での厳密な分布補正として検討する。受理される確率質量と残差分布を導出した後、受理率が一定の理想化されたコストモデルを解析する。図示した速度比は解析上のシナリオであり、ハードウェアの測定値ではない。温度、打ち切り、数値精度、停止セマンティクスは、正しさの検証の一環として試験しなければならない。
1. ドラフトは提案であり、最終回答ではない
ターゲット分布をp、ドラフト分布をqとする。ドラフトモデルは低コストであるだけでは不十分であり、現在の文脈においてターゲット分布と十分に重なっていなければ、多数の提案が棄却される。複数トークンのドラフトにおける後続の分布は接頭辞に依存するため、検証が最初の棄却に到達すると、それ以降のドラフトは同じ受理済み接頭辞を持たなくなる。実装は正しい条件付き確率に従って処理する必要があり、すべての位置を独立に選別して連結するだけではならない。ターゲットモデルの実際のサンプリング規則もpの定義に含まれる。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
2. 受理と残差が共同でターゲット確率を復元する
qから得た候補トークンを確率min(1,p/q)で受理すると、受理された確率質量はmin(p,q)となる。未充足のターゲット確率質量は[p-q]の正の部分であり、棄却時にこの残差を正規化した分布からサンプリングすることで、初めてターゲット分布を補完できる。この補正により、棄却時に任意の高確率トークンに置き換えてはならない理由、およびドラフト受理率をそのまま出力品質とみなしてはならない理由が説明される。実際の実装ではゼロ確率と数値精度を正しく扱う必要がある。pとqの温度や打ち切り後の台が一致しない場合は、処理後の実際の分布に基づいて補正しなければならない。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
3. 分布の等価性は同一の乱数軌跡を意味しない
正しい投機的サンプリングとターゲットモデルによる逐次サンプリングは、同じ出力分布を持ち得るが、乱数の消費順序が異なるため、同じシードでも完全に同一の文字列を生成するとは限らない。試験ではまず小規模な語彙と短い系列について厳密な分布を計算し、大量のサンプルから得られる頻度を統計誤差と照らして比較した後、完全なモデルのセマンティクスを確認すべきである。貪欲デコーディングでは等価性の基準が異なる。top-kやtop-pでは、打ち切りと再正規化を適用する位置も一致させる必要がある。少数のテキスト例が似ているだけで実装が正しいと宣言してはならない。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
4. 期待される利益は一度の検証で複数ステップ進むことから生じる
受理率αが一定で、各受理事象が独立であるという理想化された条件の下では、長さkのドラフトにより、一度のターゲット検証で平均1+α+…+α^kトークン進める。ただし、ドラフト生成、ターゲット検証長の増加、メモリコピー、同期にもコストがかかる。ドラフトのコストが高い場合や受理率が低い場合には、システムはかえって遅くなり得る。図では、一度のターゲット検証コストを1、ドラフトのトークン当たりコストを0.1とし、このモデルの条件に依存する比のみを示す。実際の検証コストは一定ではなく、対象デバイスとバッチサイズで改めて測定しなければならない。[1] Fast Inference from Transformers via Speculative Decodi
5. バッチ処理とKV管理が最適なドラフト長を変える
ドラフトを長くすると潜在的な進行ステップ数が増える一方、計算、一時的なKV保存、棄却後のロールバックも増える。連続バッチ処理ではリクエストごとに受理長が異なるため、スケジューリングとパディングのコストが生じる。複数のリクエストがデバイスを共有する場合、単一リクエストの利益が全体のスループットと一致するとは限らない。最初のトークンまでの遅延、定常状態のデコード速度、テールレイテンシ、メモリを個別に測定し、短い出力と長い出力の両方を対象とすべきである。ドラフト長を動的に選択する場合も、その意思決定規則を記録する必要があり、結果を見た後で最も有利な範囲だけを報告してはならない。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula[3] Attention Is All You Need
6. 正しさと性能は別々に検証する必要がある
まず分布、停止トークン、最大長、リクエストのキャンセル、KVのロールバックを検証し、その後にエンドツーエンドのコストを検証する。分布上正しい実装でも、精度やサンプリングの実装の影響を受け得る。高速な実装がターゲット分布を変更する場合には、別の近似アルゴリズムとして独立に命名・評価しなければならない。すべての性能比較では、ターゲットモデル、サンプリング設定、入力分布、サービス上の制約を固定すべきである。本稿ではドラフトモデルもターゲットモデルも実行していない。数式に基づく図が裏づけるのは受理率と理想的コストの関係のみであり、実際の高速化倍率を裏づけるものではない。[1] Fast Inference from Transformers via Speculative Decodi[2] Accelerating Large Language Model Decoding with Specula
主要な数式と導出
(1) 候補はqから得られる。qがゼロとなる位置は、この提案分布からは提案されない。受理された確率質量はターゲット確率の一部にすぎない。
LaTeX
a(x)=\min\{1,p(x)/q(x)\},\qquad q(x)a(x)=\min\{p(x),q(x)\}(2) 棄却後の補正分布。分母がゼロの場合は両分布が等しく、この棄却分岐は不要である。
LaTeX
r(x)=\frac{[p(x)-q(x)]_+}{\sum_y[p(y)-q(y)]_+}(3) 受理率が一定かつ独立で、検証コストが単位コストである場合の理想モデル。図ではc=0.1を用いる。実際のハードウェアにおける検証、バッチ処理、KVのコストは別途測定する。
LaTeX
\mathbb E[L]=\sum_{i=0}^{k}\alpha^i,\qquad S_{\mathrm{toy}}=\frac{\sum_{i=0}^{k}\alpha^i}{1+kc}手法とエビデンスの流れ
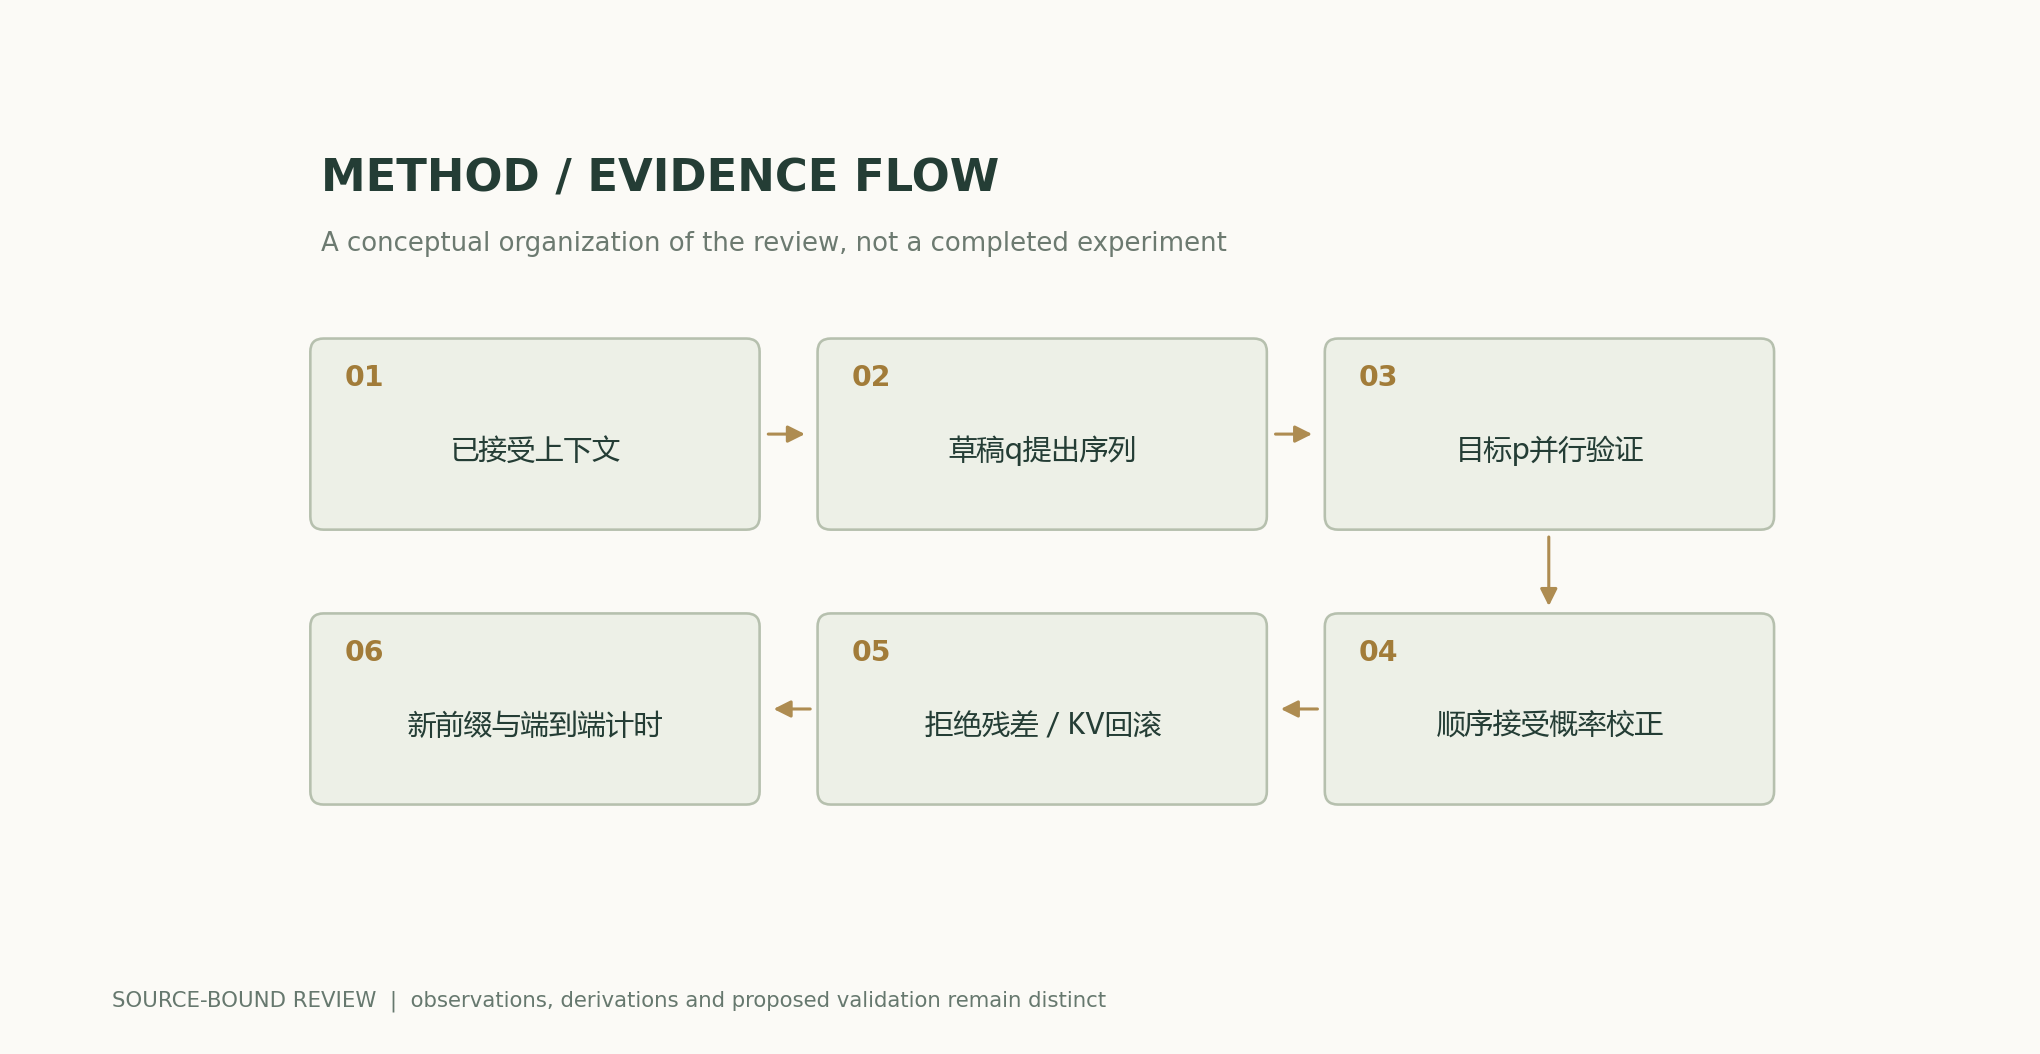
解析図と数値例
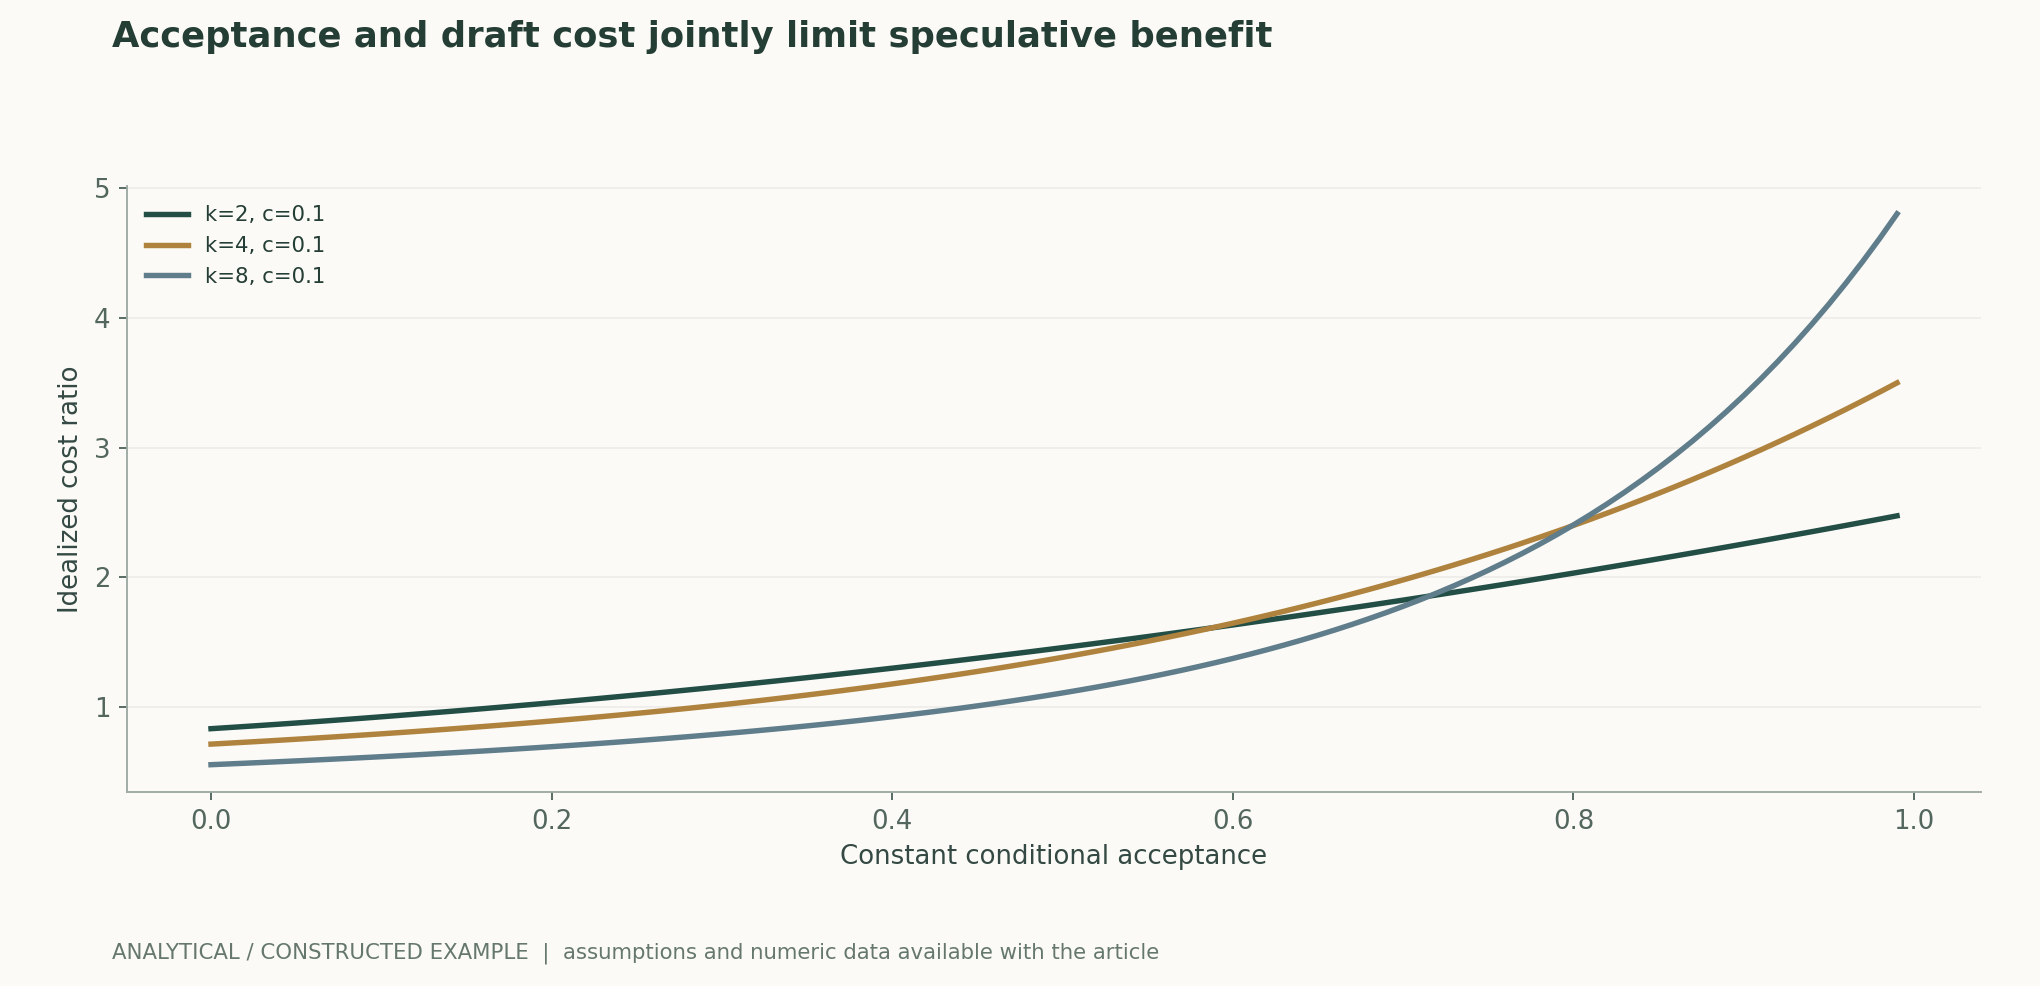
再計算可能な計算例
理想モデルでは、α=0.8、k=4のとき平均3.3616トークン進み、コストは1.4、比は約2.401となる。α=0.2のとき比は約0.893であり、かえって利益が得られない。実際の検証コストとバッチ処理は一定ではない。
手法の比較
| 手法または判断 | 統制変数と測定 | 失敗条件と解釈 |
|---|---|---|
| 確率補正 | 処理後のp、qに対して受理と残差を照合する | 残差を省略するとターゲット分布が変わる |
| 乱数に関する再現性 | 同じシードのテキストを比較するだけでなく、分布を検定する | 分布が等しくても乱数軌跡が同一である必要はない |
| ドラフト長 | 受理長とすべての追加オーバーヘッドを併せて測定する | ドラフトを長くしても高速になるとは限らない |
| 本番サービス | スループット、テールレイテンシ、キャンセル、KVロールバックを別々に報告する | 単一リクエストの理想的な利益は、バッチ処理の利益を表さない |
検証・実験計画
- ターゲットモデルとドラフトモデルのバージョン、温度、top-k/top-p、停止セマンティクスを固定する。
- 全数列挙が可能な小規模語彙を構成し、受理された確率質量と残差質量の和がpに等しいことを項目ごとに確認する。
- 短い系列で頻度検定を行い、テキストを見るだけでなく、サンプル数と統計誤差を報告する。
- ゼロ確率、分布の一致、最初のステップでの棄却、全受理、停止トークンなどの境界ケースを網羅する。
- 入出力長とバッチサイズを固定し、ドラフト、検証、KV、スケジューリング、エンドツーエンドの時間を測定する。
- キャンセルとロールバックを項目ごとに確認し、近似的な変更はターゲット分布を保持する実装と分けて報告する。
適用範囲と限界
- モデルやハードウェアの高速化に関する実測はない。
- 受理率一定はモデル上の仮定にすぎない。
- サンプリング変換と精度は分布補正に影響する。
- サービスのスケジューリングは最適パラメータを変え得る。
一次資料と主張の対応
- Fast Inference from Transformers via Speculative Decoding, , · 2022-11-30Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Accelerating Large Language Model Decoding with Speculative Sampling, , , , , · 2023-02-02Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が、記載した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿に関する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが一致する場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持する。
概念的な表紙画像と科学図は区別する。科学図は公開された数式と明示された仮定に基づいて計算し、原論文の結果にはすべて帰属を明記する。
著者、バージョン、訂正履歴 · /guides/speculative-decoding/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開・バージョン履歴
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770