
Resumen
Los modelos de espacio de estados resumen el historial mediante un estado recurrente, mientras que los mecanismos selectivos permiten que los coeficientes de actualización varíen con la entrada, ofreciendo una organización del modelado de secuencias largas distinta de la atención completa. Partiendo de la discretización de sistemas continuos, este artículo analiza cómo la dependencia de la entrada modifica la interpretación convolucional y después examina las diferencias entre el barrido paralelo, el estado de decodificación y la memoria de entrenamiento. Las figuras comparan únicamente el recuento de elementos del estado y el crecimiento de las claves y los valores KV con las dimensiones declaradas; no constituyen evidencia de la velocidad real del hardware ni de la capacidad para contextos largos.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient[3] Attention Is All You Need
Traducción del resumen en inglés
Los modelos selectivos de espacio de estados se examinan a través de su actualización recurrente del estado y sus restricciones de implementación. La selección dependiente de la entrada rompe la interpretación como convolución fija, al tiempo que permite un cálculo basado en barrido. Distinguimos el estado de decodificación acotado de las activaciones de entrenamiento y comparamos únicamente las fórmulas declaradas del tamaño del estado. De los gráficos analíticos no se infiere ninguna exactitud de los modelos de lenguaje, tasa de procesamiento ni superioridad en contextos largos.
1. El estado recurrente es un cuello de botella para la información histórica
Los sistemas lineales de espacio de estados comprimen las entradas pasadas en un estado de dimensión finita y generan después las salidas a partir de ese estado. La discretización de un sistema de tiempo continuo produce los coeficientes de recurrencia; el tamaño del paso discreto, la estructura de los parámetros y la estabilidad determinan conjuntamente cómo decae o se conserva la información. A diferencia de la atención, que almacena KV en cada posición, un estado de dimensión fija no sigue creciendo con la longitud decodificada, pero tampoco puede conservar intacta una cantidad arbitraria de detalles históricos independientes. Un estado pequeño es una propiedad estructural; su suficiencia para completar una tarea requiere comprobación, y la calidad de la memoria no puede inferirse solo de la complejidad.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[3] Attention Is All You Need
2. La selección dependiente de la entrada cambia la interpretación como convolución fija
Cuando los coeficientes de recurrencia son fijos, un sistema lineal puede desarrollarse como una convolución sobre las entradas históricas. El mecanismo de selección clave de Mamba hace que algunos parámetros dependan de la entrada actual, permitiendo al modelo ajustar la retención y el olvido según el contenido; en ese caso, ya no puede describirse toda la secuencia simplemente mediante un único núcleo de convolución fijo. Debe distinguirse la recurrencia matemática del estado de las proyecciones, los mecanismos de compuerta, la convolución local y la normalización presentes en la red real. Extraer una sola ecuación lineal no representa por completo la arquitectura, y las comparaciones también deben igualar el número total de parámetros y el presupuesto de entrenamiento.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta
3. El barrido organiza la recurrencia como un cálculo paralelizable
Una formulación recurrente no significa que el entrenamiento deba ejecutarse necesariamente de forma secuencial, token por token. Las transformaciones afines del estado pueden organizarse en un barrido según reglas de composición, pero la velocidad real también depende de los kernels fusionados, las lecturas y escrituras de memoria y el dispositivo. El diseño del barrido selectivo debe evitar escribir estados intermedios enormes de nuevo en la memoria de alto ancho de banda, por lo que la complejidad algorítmica y la organización de la entrada/salida deben analizarse conjuntamente. Mamba-2 profundiza en las conexiones estructurales entre el espacio de estados y la atención, pero esto no implica que ambos sean completamente equivalentes en todos sus parámetros, capacidades expresivas o tareas.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient
4. Un estado de decodificación constante no implica una memoria de entrenamiento constante
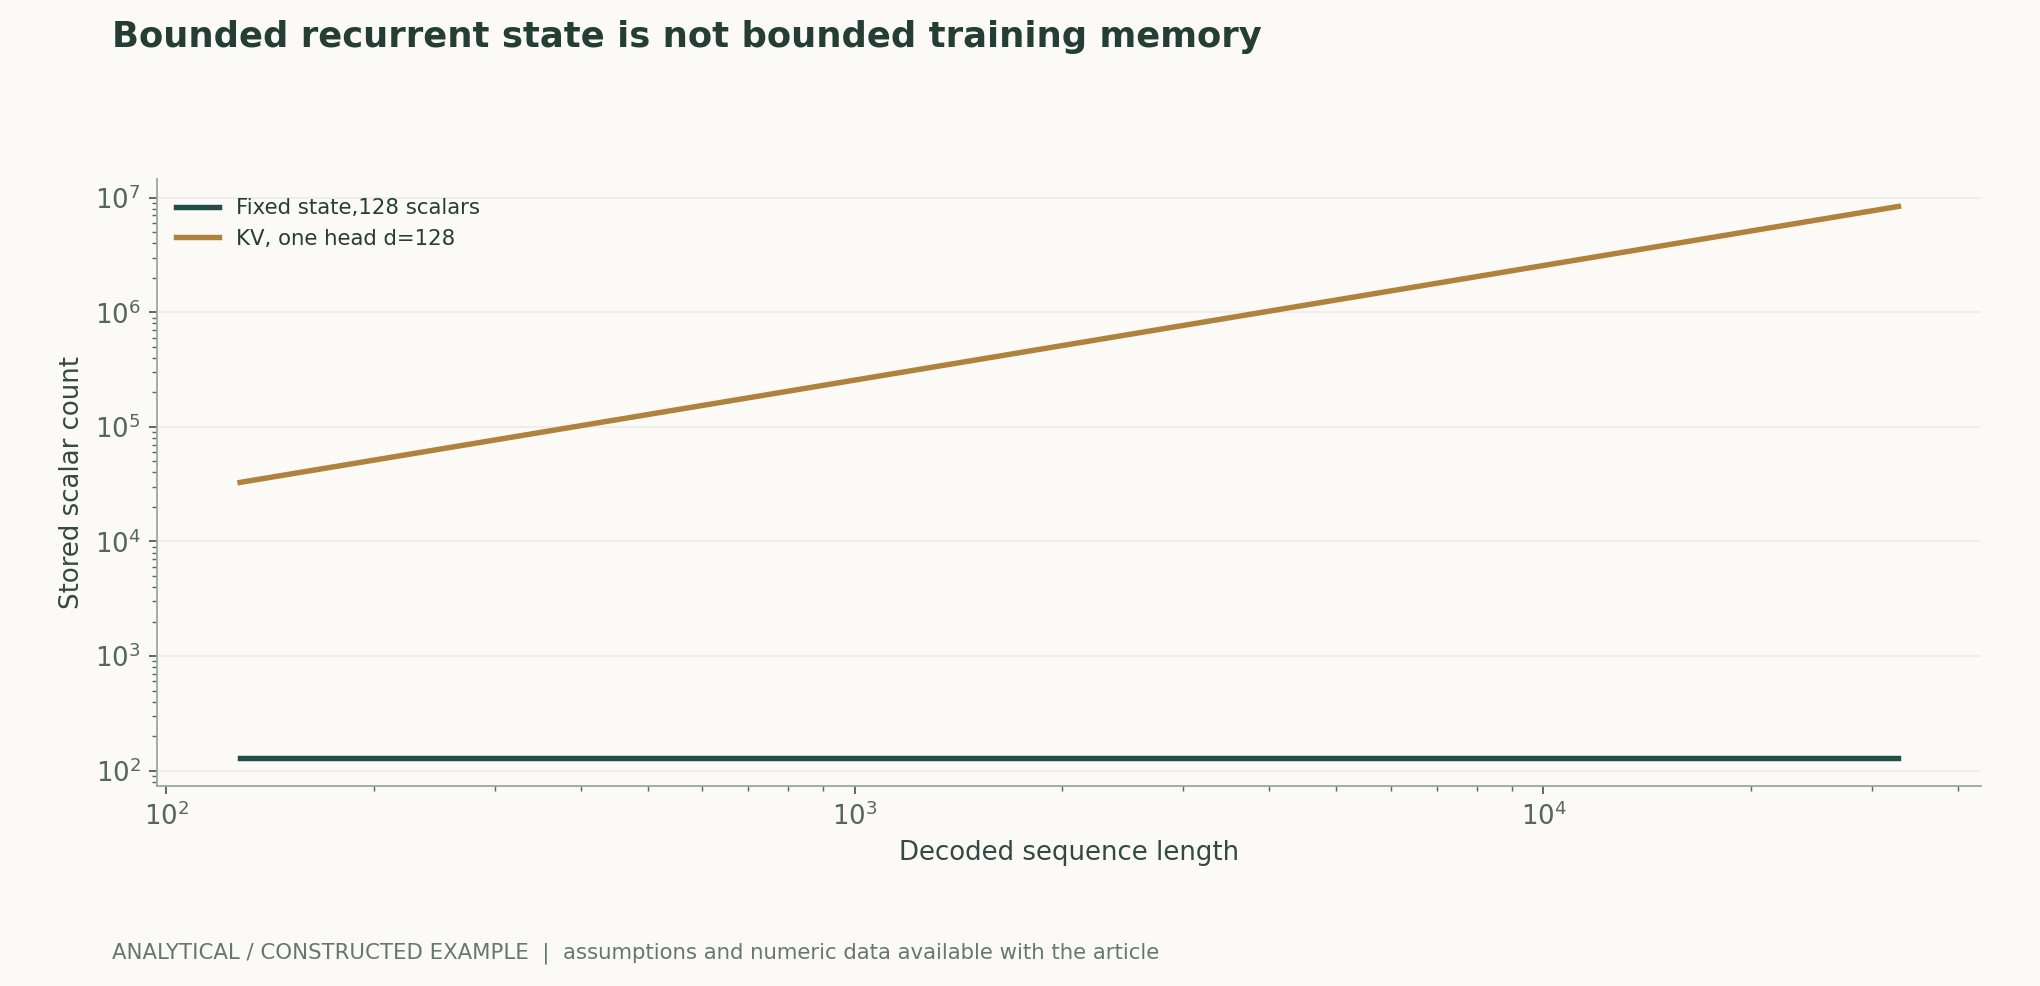
Con una arquitectura fija, el estado recurrente en línea puede ser independiente de la longitud del historial; el entrenamiento debe gestionar además las entradas, salidas, gradientes y magnitudes intermedias que pueden almacenarse o recalcularse en cada posición. El tamaño del lote, el número de capas y la dimensión de los canales también aumentan el tamaño del estado. La figura compara un estado de dimensión 128 con el recuento de KV por posición únicamente para aislar la variable longitud. Describirlo directamente como «memoria constante del modelo» ignoraría los parámetros, las activaciones de entrenamiento, los espacios de trabajo temporales y los búferes de salida. El pico real de memoria debe medirse por separado en las fases de prellenado, entrenamiento y decodificación.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta
5. La evaluación de secuencias largas debe distinguir memoria, recuperación y composición
Procesar entradas muy largas a bajo coste no equivale a utilizar de forma fiable toda la información que contienen. La predicción local, el seguimiento del estado a grandes distancias, la recuperación desde posiciones arbitrarias y la composición de múltiples evidencias imponen requisitos diferentes a la estructura de la memoria. Deben controlarse la posición de la información, la cantidad de interferencias, la similitud de los valores y la longitud de entrenamiento, y presentarse curvas de calidad en función de la longitud. Las arquitecturas híbridas también deben especificar qué capas utilizan atención y cuáles recurrencia; no pueden atribuirse todos sus resultados a un solo tipo de módulo.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient[3] Attention Is All You Need
6. La interpretación experimental debe corresponder a la granularidad de la arquitectura
Las ablaciones adecuadas incluyen parámetros fijos frente a parámetros dependientes de la entrada, la dimensión del estado, el mecanismo de selección y la implementación de los kernels; debe modificarse un único factor cada vez y observarse después la calidad y los costes del sistema. Para evaluar la estabilidad numérica, deben comprobarse el rango del estado, la precisión y la acumulación de errores en secuencias largas. Las ecuaciones y los recuentos presentados aquí permiten verificar el significado de la actualización y su dependencia de la longitud, pero no se entrenó ningún modelo ni se demostró una superioridad general de los métodos recurrentes sobre la atención. Las conclusiones de la investigación deben limitarse a las tareas, longitudes y hardware efectivamente evaluados.[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient
Ecuaciones y derivaciones fundamentales
(1) Esta es una abstracción de la actualización central del espacio de estados; el modelo completo también incluye módulos como proyecciones y compuertas. Los coeficientes selectivos pueden depender de la entrada.
LaTeX
h_t=\bar A_t h_{t-1}+\bar B_t x_t,\qquad y_t=C_t h_t(2) Expresión de discretización con la entrada constante durante un paso; la forma integral no exige que A sea invertible. Cuando existe dependencia de la entrada, debe interpretarse según la parametrización real.
LaTeX
\bar A=\exp(\Delta A),\qquad\bar B=\left(\int_0^\Delta\exp(sA)\,ds\right)B(3) La asociatividad de las transformaciones afines permite la organización mediante barrido; por sí sola no garantiza que una implementación concreta logre aceleración en hardware.
LaTeX
(A_2,b_2)\circ(A_1,b_1)=(A_2A_1,A_2b_1+b_2)Flujo del método y de la evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto que puede recalcularse
Con 8192 posiciones, KV comprende 2097152 escalares en este ejemplo limitado, y el estado recurrente comprende 128 escalares. Ambos difieren en representación y arquitectura, por lo que esta proporción no puede tomarse como una comparación de la memoria o la capacidad del modelo completo.
Comparación de métodos
| Método o juicio | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| SSM de coeficientes fijos | Verificar las condiciones de discretización y desarrollo convolucional | Con dependencia de la entrada, el núcleo de convolución deja de ser fijo |
| Estado de decodificación | Contar con número de capas, canales y dimensión del estado fijos | No incluye las activaciones de entrenamiento ni la memoria total |
| Barrido paralelo | Medir los kernels y la entrada/salida en el dispositivo real | La complejidad lineal no puede convertirse directamente en latencia |
| Capacidad para contextos largos | Separar las tareas de recuperación, seguimiento y composición | Poder procesar entradas largas no implica utilizarlas eficazmente |
Plan de verificación y experimentación
- Fijar el número total de parámetros, los datos, el presupuesto de entrenamiento y el tokenizador, y especificar si la arquitectura es híbrida.
- Registrar la dimensión del estado, la parametrización del paso discreto, las compuertas y la versión del kernel.
- Comparar la recurrencia paso a paso en secuencias cortas con los resultados del barrido y medir los errores con distintas precisiones.
- Medir por separado el pico de memoria y el tiempo del entrenamiento, el prellenado y la decodificación en línea.
- Medir curvas de calidad según la longitud, la posición de la información, la cantidad de interferencias y el tipo de tarea.
- Realizar ablaciones de la selección dependiente de la entrada, la dimensión del estado y los módulos, conservando registros de las tareas fallidas y de la estabilidad.
Ámbito de aplicación y limitaciones
- El recuento de elementos del estado no es el uso de memoria del acelerador por parte del modelo completo.
- No se realizaron entrenamientos de modelos de lenguaje ni mediciones de velocidad de dispositivos.
- Un estado fijo puede constituir un cuello de botella de información.
- El rendimiento en distintas tareas no puede ordenarse directamente a partir de la complejidad.
Fuentes primarias y afirmaciones correspondientes
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces, · 2023-12-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality, · 2024-05-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
Cita y exportación del artículo
BibTeXRISCSL JSONTXTArtículo JSON
Autor, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el artículo y realizó las derivaciones analíticas basándose en la bibliografía primaria enumerada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El texto principal, las ecuaciones, las fuentes y los datos de las figuras científicas conservan el contenido de la versión anterior.
La portada conceptual se mantiene separada de los diagramas científicos; las figuras científicas se calculan a partir de ecuaciones públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Historial de autoría, versiones y correcciones · /guides/state-space-mamba/v1/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770