
要旨
状態空間モデルは再帰状態によって履歴を要約し、選択的機構は更新係数を入力に応じて変化させることで、完全な注意機構とは異なる長系列モデリングの構成を提供する。本稿では連続システムの離散化から出発し、入力依存性が畳み込みによる解釈をどのように変えるかを分析したうえで、並列スキャン、デコード状態、学習メモリの相違を論じる。図は明示した次元のもとで状態の要素数とKVの増加のみを比較しており、実際のハードウェア速度や長文脈処理能力の証拠にはならない。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient[3] Attention Is All You Need
英語要旨の日本語訳
選択的状態空間モデルを、再帰的な状態更新と実装上の制約を通じて検討する。入力依存の選択は固定畳み込みという見方を成立しなくする一方で、スキャンに基づく計算を可能にする。有界なデコード状態と学習時の活性値を区別し、明示した状態サイズの式のみを比較する。解析図から、言語モデルの精度、スループット、長文脈での優位性を推論することはない。
1. 再帰状態は過去の情報のボトルネックとなる
線形状態空間システムは過去の入力を有限次元の状態に圧縮し、その状態から出力を生成する。連続時間システムを離散化すると再帰係数が得られ、離散化のステップ幅、パラメータ構造、安定性が共同で情報の減衰と保持を決定する。各位置のKVを保存する注意機構と異なり、固定次元の状態はデコード済みの長さとともに増加し続けることはないが、任意の数の独立した過去の詳細をそのまま保存することもできない。状態が小さいことは構造上の特徴であり、タスクの遂行に十分かどうかは検証を要する。計算量だけから記憶の質を推論することはできない。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[3] Attention Is All You Need
2. 入力依存の選択は固定畳み込みによる解釈を変える
再帰係数が固定されている場合、線形システムは過去の入力に対する畳み込みとして展開できる。Mambaの中核となる選択機構は一部のパラメータを現在の入力に依存させ、内容に応じた保持と忘却の調整を可能にする。この場合、単一の固定畳み込みカーネルで系列全体を単純に記述することはできなくなる。数学的な状態再帰と、実際のネットワークにおける射影、ゲーティング、局所畳み込み、正規化は区別すべきである。単一の線形式だけを取り出してもアーキテクチャ全体を完全には表せず、比較では総パラメータ数と学習予算も揃える必要がある。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta
3. スキャンは再帰を並列化可能な計算として構成する
再帰形式であることは、学習を必ずトークンごとに逐次実行しなければならないことを意味しない。アフィン状態変換は合成規則に従ってスキャンとして構成できるが、実際の速度は融合カーネル、メモリの読み書き、デバイスにも依存する。選択的スキャンでは巨大な中間状態を高帯域幅メモリへ書き戻すことを避ける設計が必要であり、アルゴリズムの計算量と入出力の構成を併せて分析しなければならない。Mamba-2は状態空間と注意機構の構造的な関係をさらに研究しているが、両者がすべてのパラメータ、表現能力、タスクにおいて完全に等価であることを意味しない。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient
4. デコード状態が一定でも学習メモリが一定とは限らない
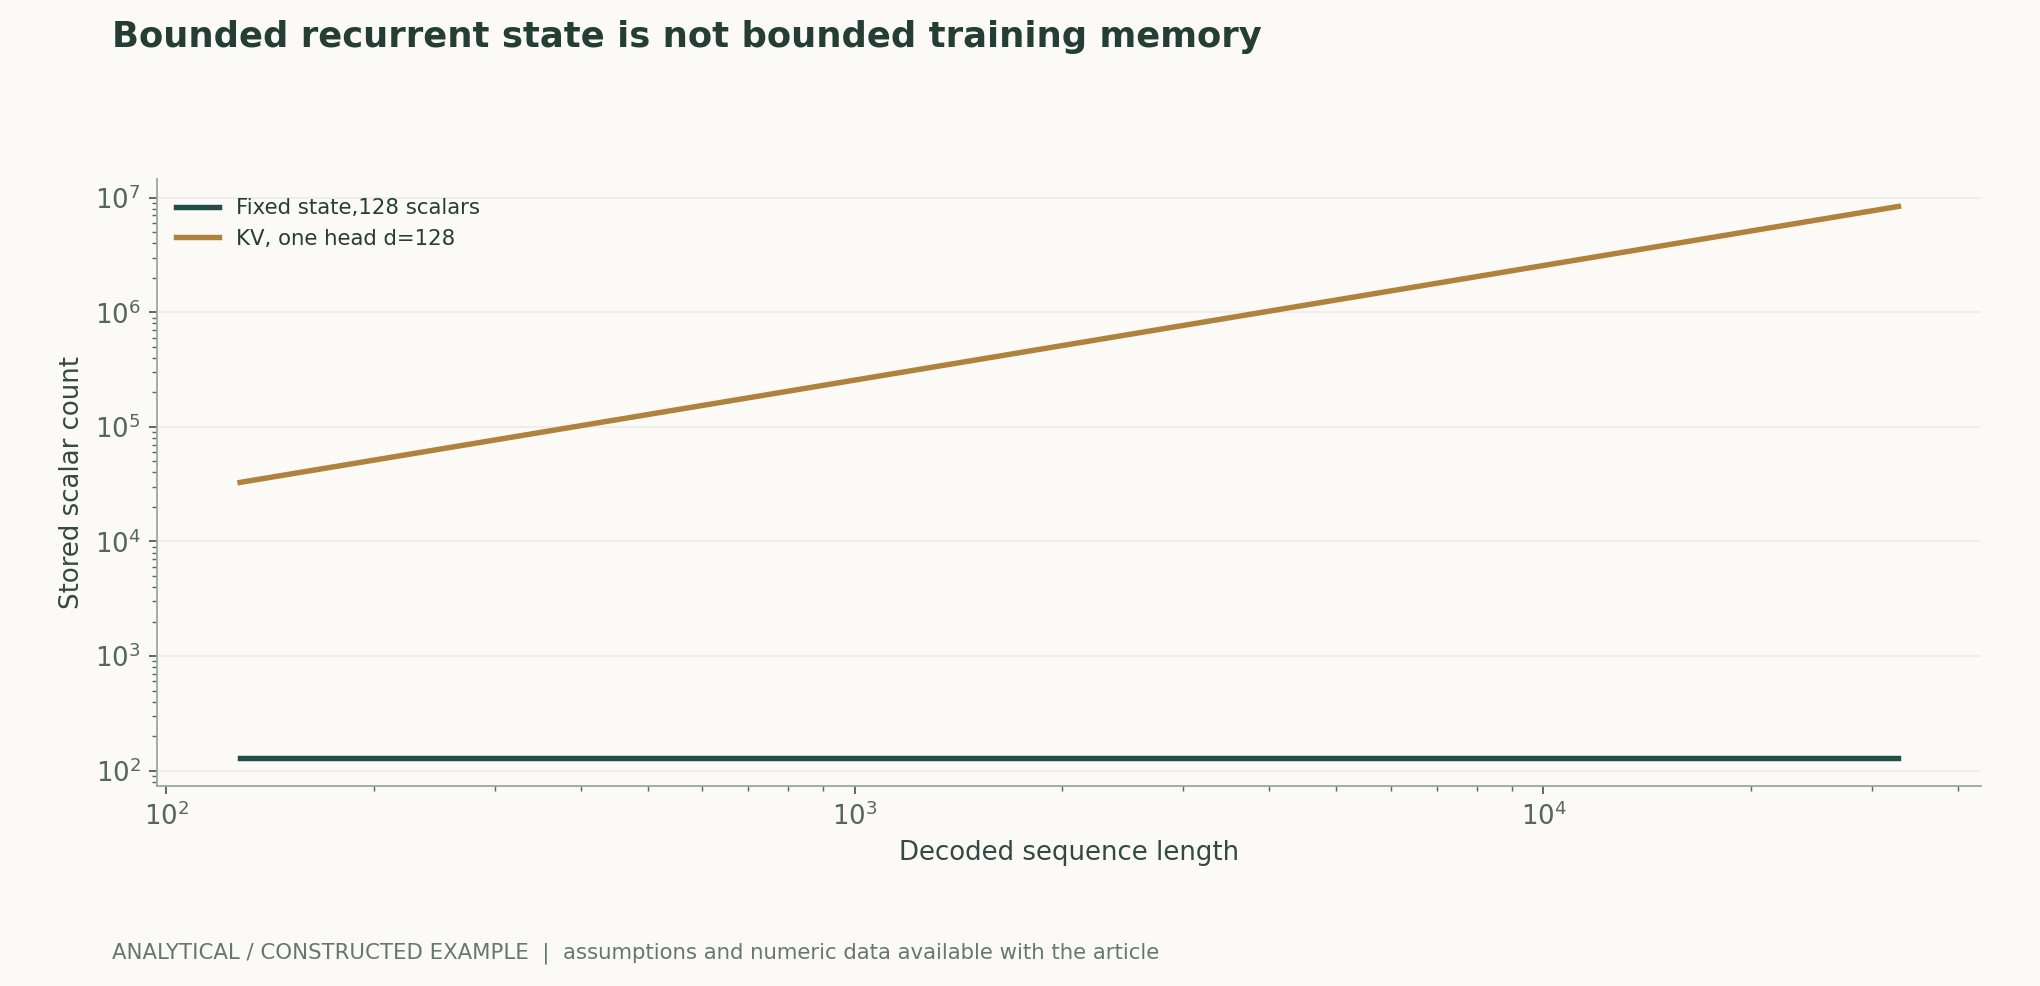
アーキテクチャが固定されていれば、オンラインの再帰状態は履歴長に依存しない場合がある。一方、学習では各位置の入力、出力、勾配に加えて、保存または再計算される可能性のある中間量も扱う必要がある。バッチサイズ、層数、チャネル次元も状態サイズを増大させる。図では128次元の状態と位置ごとのKVの要素数を比較しているが、これは長さという変数のみを切り分けるためである。これをそのまま「モデルのメモリは一定」と表現すると、パラメータ、学習時の活性値、一時作業領域、出力バッファを見落とすことになる。実際のピークメモリ使用量は、プリフィル、学習、デコードの各段階で個別に測定すべきである。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta
5. 長系列の評価では記憶、検索、組み合わせを区別すべきである
非常に長い入力を低コストで処理できることは、その中のすべての情報を確実に利用できることを意味しない。局所的な予測、長距離にわたる状態追跡、任意の位置からの検索、複数の証拠の組み合わせは、記憶構造に異なる要件を課す。情報の位置、妨害情報の量、値の類似性、学習時の系列長を統制し、長さに応じた品質の変化を示す曲線を報告する必要がある。ハイブリッドアーキテクチャについても、どの層が注意機構を用い、どの層が再帰を用いるかを明示すべきであり、その結果を一方の種類のモジュールだけに帰することはできない。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient[3] Attention Is All You Need
6. 実験の解釈はアーキテクチャの粒度と一致させる必要がある
適切なアブレーションの対象には、固定パラメータと入力依存パラメータ、状態次元、選択機構、カーネル実装が含まれる。一度に変更する要因を一つに限定し、品質とシステムコストを観察する。数値安定性については、状態の値域、精度、長系列における誤差の累積を確認すべきである。本稿の数式と要素数は、更新の意味と長さへの依存性を検証するために利用できるが、モデルの学習は実施しておらず、再帰的手法が注意機構より一般的に優れていることを証明したわけでもない。研究上の結論は、実際に測定したタスク、長さ、ハードウェアに限定すべきである。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient
主要な数式と導出
(1) これは状態空間の中核的な更新を抽象化したものであり、完全なモデルには射影やゲーティングなどのモジュールも含まれる。選択的な係数は入力に依存しうる。
LaTeX
h_t=\bar A_t h_{t-1}+\bar B_t x_t,\qquad y_t=C_t h_t(2) 一つのステップ内で入力を一定とする離散化の表現であり、積分形式はAの可逆性を必要としない。入力依存の場合は、実際のパラメータ化に即して解釈する必要がある。
LaTeX
\bar A=\exp(\Delta A),\qquad\bar B=\left(\int_0^\Delta\exp(sA)\,ds\right)B(3) アフィン変換の結合性によってスキャンとしての構成が可能になるが、それ自体が特定の実装でハードウェアによる高速化を保証するわけではない。
LaTeX
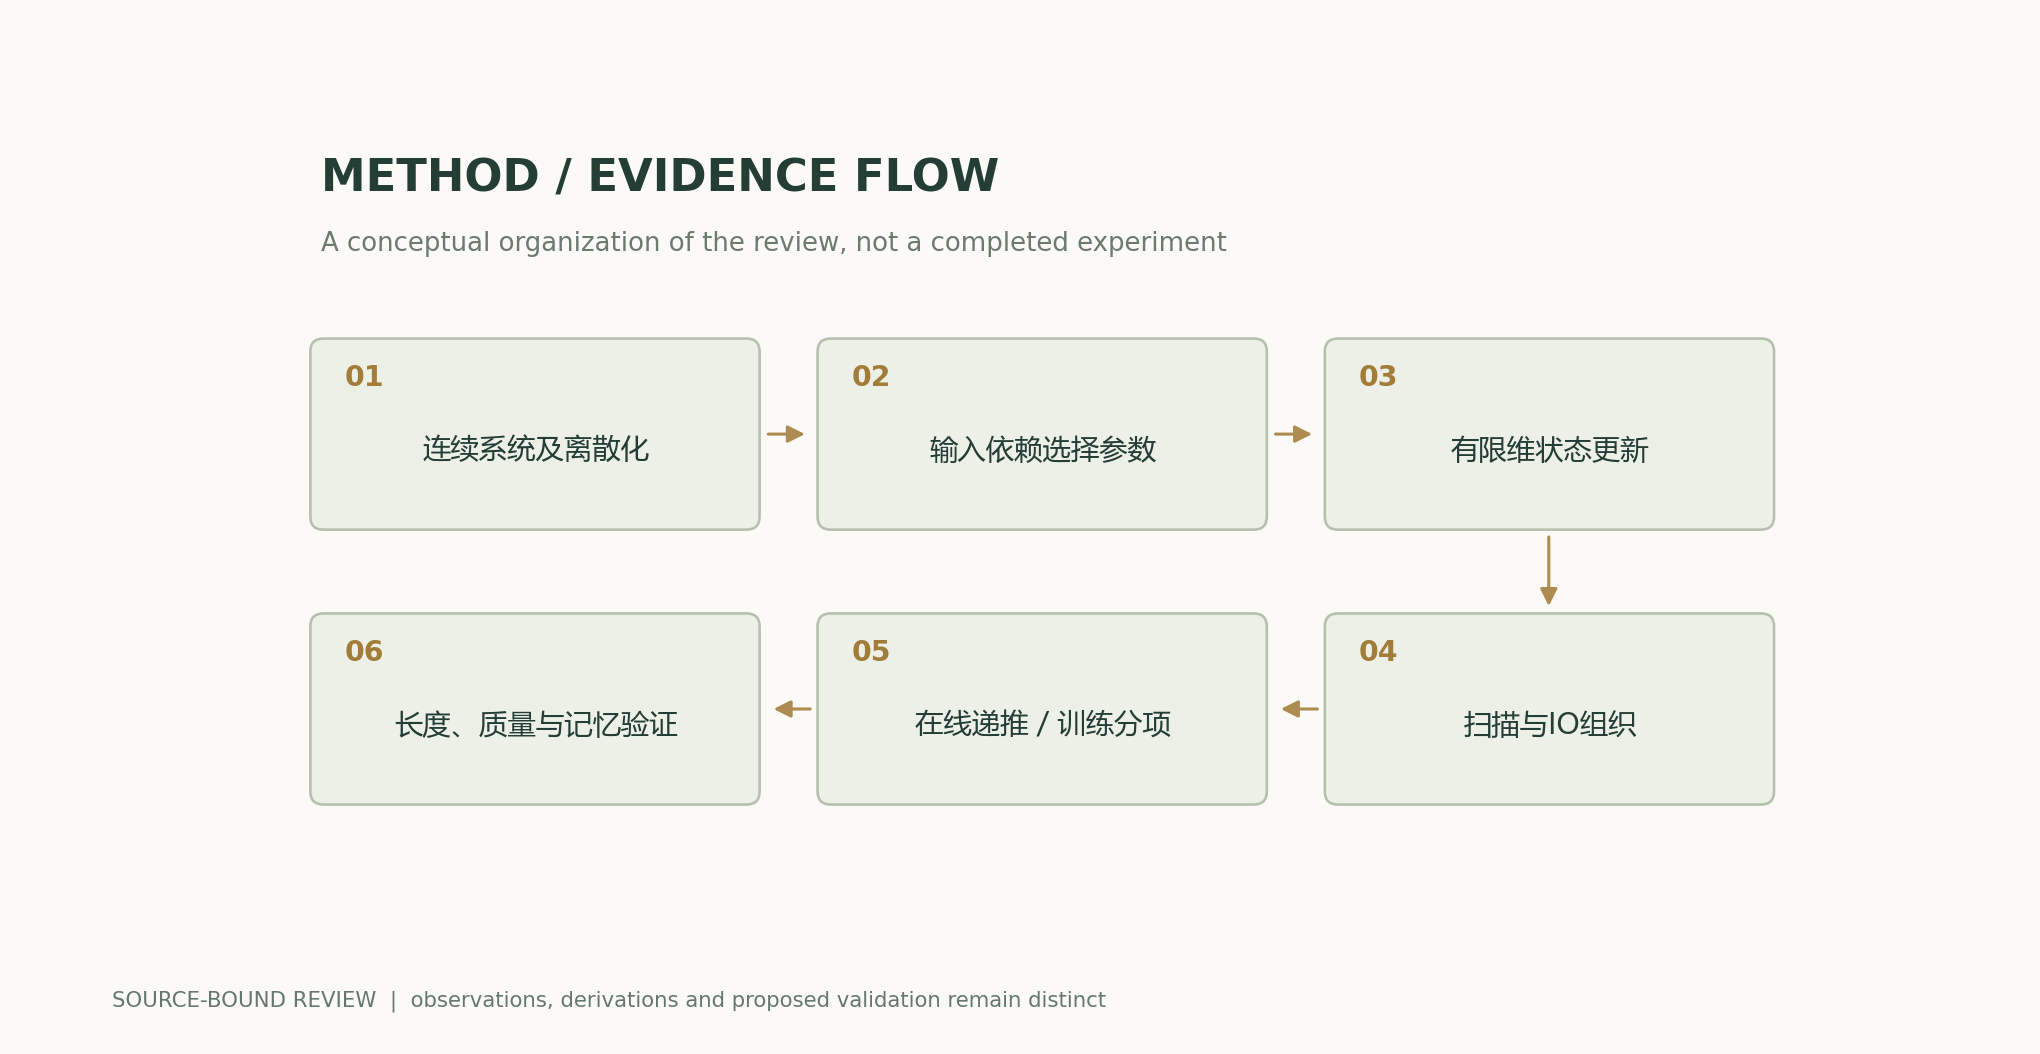
(A_2,b_2)\circ(A_1,b_1)=(A_2A_1,A_2b_1+b_2)方法と証拠の流れ
解析図と数値例
再計算可能な例題
位置数が8192の場合、この限定的な例ではKVは2097152個のスカラー、再帰状態は128個のスカラーとなる。両者は表現とアーキテクチャが異なるため、この比率をモデル全体のメモリや能力の比較とみなすことはできない。
手法の比較
| 手法または判断 | 統制変数と測定 | 成立しない条件と解釈 |
|---|---|---|
| 固定係数SSM | 離散化と畳み込み展開の条件を確認する | 入力依存になると固定畳み込みカーネルではなくなる |
| デコード状態 | 層数、チャネル数、状態次元を固定して要素数を数える | 学習時の活性値やメモリ全体を含まない |
| 並列スキャン | 実際のデバイスでカーネルと入出力を測定する | 線形計算量をそのままレイテンシに換算することはできない |
| 長文脈処理能力 | 検索、追跡、組み合わせのタスクを分ける | 長い入力を処理できることは有効に利用できることを意味しない |
検証と実験の計画
- 総パラメータ数、データ、学習予算、トークナイザを固定し、ハイブリッドアーキテクチャかどうかを明示する。
- 状態次元、離散化ステップ幅のパラメータ化、ゲーティング、カーネルのバージョンを記録する。
- 短い系列に対する逐次的な再帰計算とスキャンの結果を照合し、異なる精度で誤差を測定する。
- 学習、プリフィル、オンラインデコードそれぞれのピークメモリ使用量と時間を個別に集計する。
- 長さ、情報の位置、妨害情報の量、タスクの種類ごとに品質曲線を測定する。
- 入力依存の選択、状態次元、モジュールのアブレーションを行い、失敗したタスクと安定性の記録を残す。
適用範囲と限界
- 状態の要素数はモデル全体のアクセラレータメモリ使用量ではない。
- 言語モデルの学習やデバイスの速度測定は実施していない。
- 固定状態は情報のボトルネックとなる可能性がある。
- 異なるタスクにおける性能の順位を計算量から直接決めることはできない。
一次資料と主張の対応
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces, · 2023-12-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality, · 2024-05-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
引用と原稿のエクスポート
著者、バージョン、出典
AI支援による研究レビュー。Codex(AI)が記載された一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿に対する独立した査読や独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学図のデータは前バージョンの内容を維持する。
概念的な表紙と科学的な図解は分離している。科学図は公開された数式と明示された仮定に基づいて計算され、原論文の結果にはすべて帰属先を明記している。
著者、バージョン、訂正の記録 · /guides/state-space-mamba/v1/
表紙と科学図の出典 · データ、出典、仮定 · 公開とバージョンの記録
ソースのリビジョン: 6251a250b27bb8b449f59b392f81abd355383770