
摘要
状态空间模型用递推状态总结历史,选择性机制让更新系数随输入变化,为长序列建模提供了不同于完整注意力的组织方式。本文从连续系统离散化出发,分析输入依赖如何改变卷积解释,再讨论并行扫描、解码状态与训练内存之间的区别。图示仅比较声明维度下的状态计数与KV增长,不能作为真实硬件速度或长上下文能力证据。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient[3] Attention Is All You Need
English abstract
Selective state-space models are examined through their recurrent state update and implementation constraints. Input-dependent selection breaks the fixed convolution view while enabling a scan-based computation. We distinguish bounded decoding state from training activations and compare only declared state-size formulas. No language-model accuracy, throughput or long-context superiority is inferred from the analytical plots.
1. 递推状态是一种历史信息瓶颈
线性状态空间系统把过去输入压缩进有限维状态,再从状态生成输出。连续时间系统离散化后得到递推系数;离散步长、参数结构和稳定性共同决定信息如何衰减或保留。与保存每个位置KV的注意力不同,固定维状态不会随已解码长度持续增加,但它也不能原样保存任意多独立历史细节。状态小是结构特征,是否足以完成任务仍需检验,不能仅从复杂度推断记忆质量。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[3] Attention Is All You Need
2. 输入依赖选择改变了固定卷积解释
当递推系数固定时,线性系统可以展开成对历史输入的卷积。Mamba的关键选择机制让部分参数依赖当前输入,使模型能够按内容调整保留与遗忘;这时不再能简单使用一个固定卷积核描述全部序列。应区分数学上的状态递推和实际网络中的投影、门控、局部卷积及归一化。只抽取一个线性公式无法完整代表整个架构,比较也应匹配总参数和训练预算。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta
3. 扫描把递推组织成可并行计算
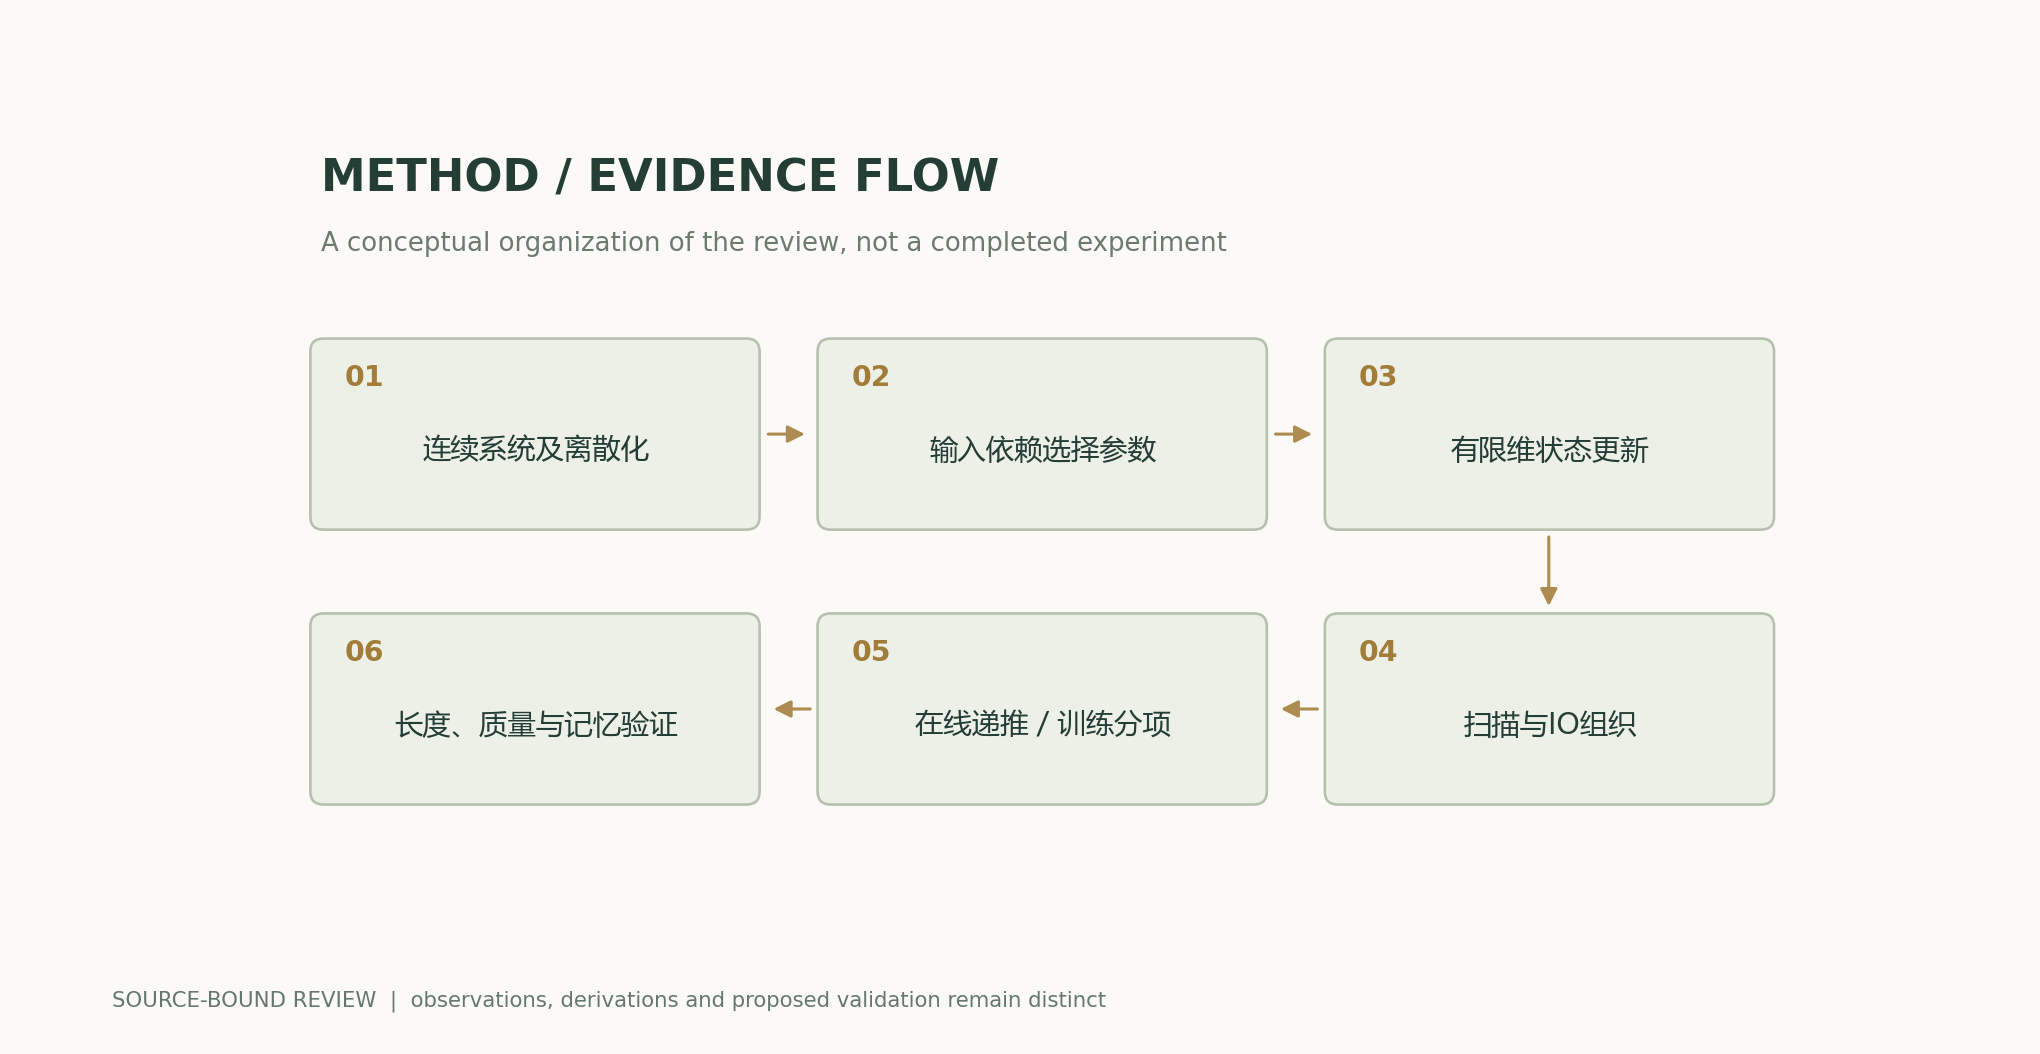
递推形式不意味着训练一定只能逐token串行执行。仿射状态变换可以按组合规则组织扫描,但实际速度还取决于融合内核、内存读写和设备。选择性扫描的设计要避免把巨大的中间状态写回高带宽内存,因此算法复杂度与IO组织必须一起分析。Mamba-2进一步研究状态空间与注意力之间的结构联系,但不意味着二者在所有参数、表达能力或任务上完全等价。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient
4. 解码状态常数不等于训练内存常数
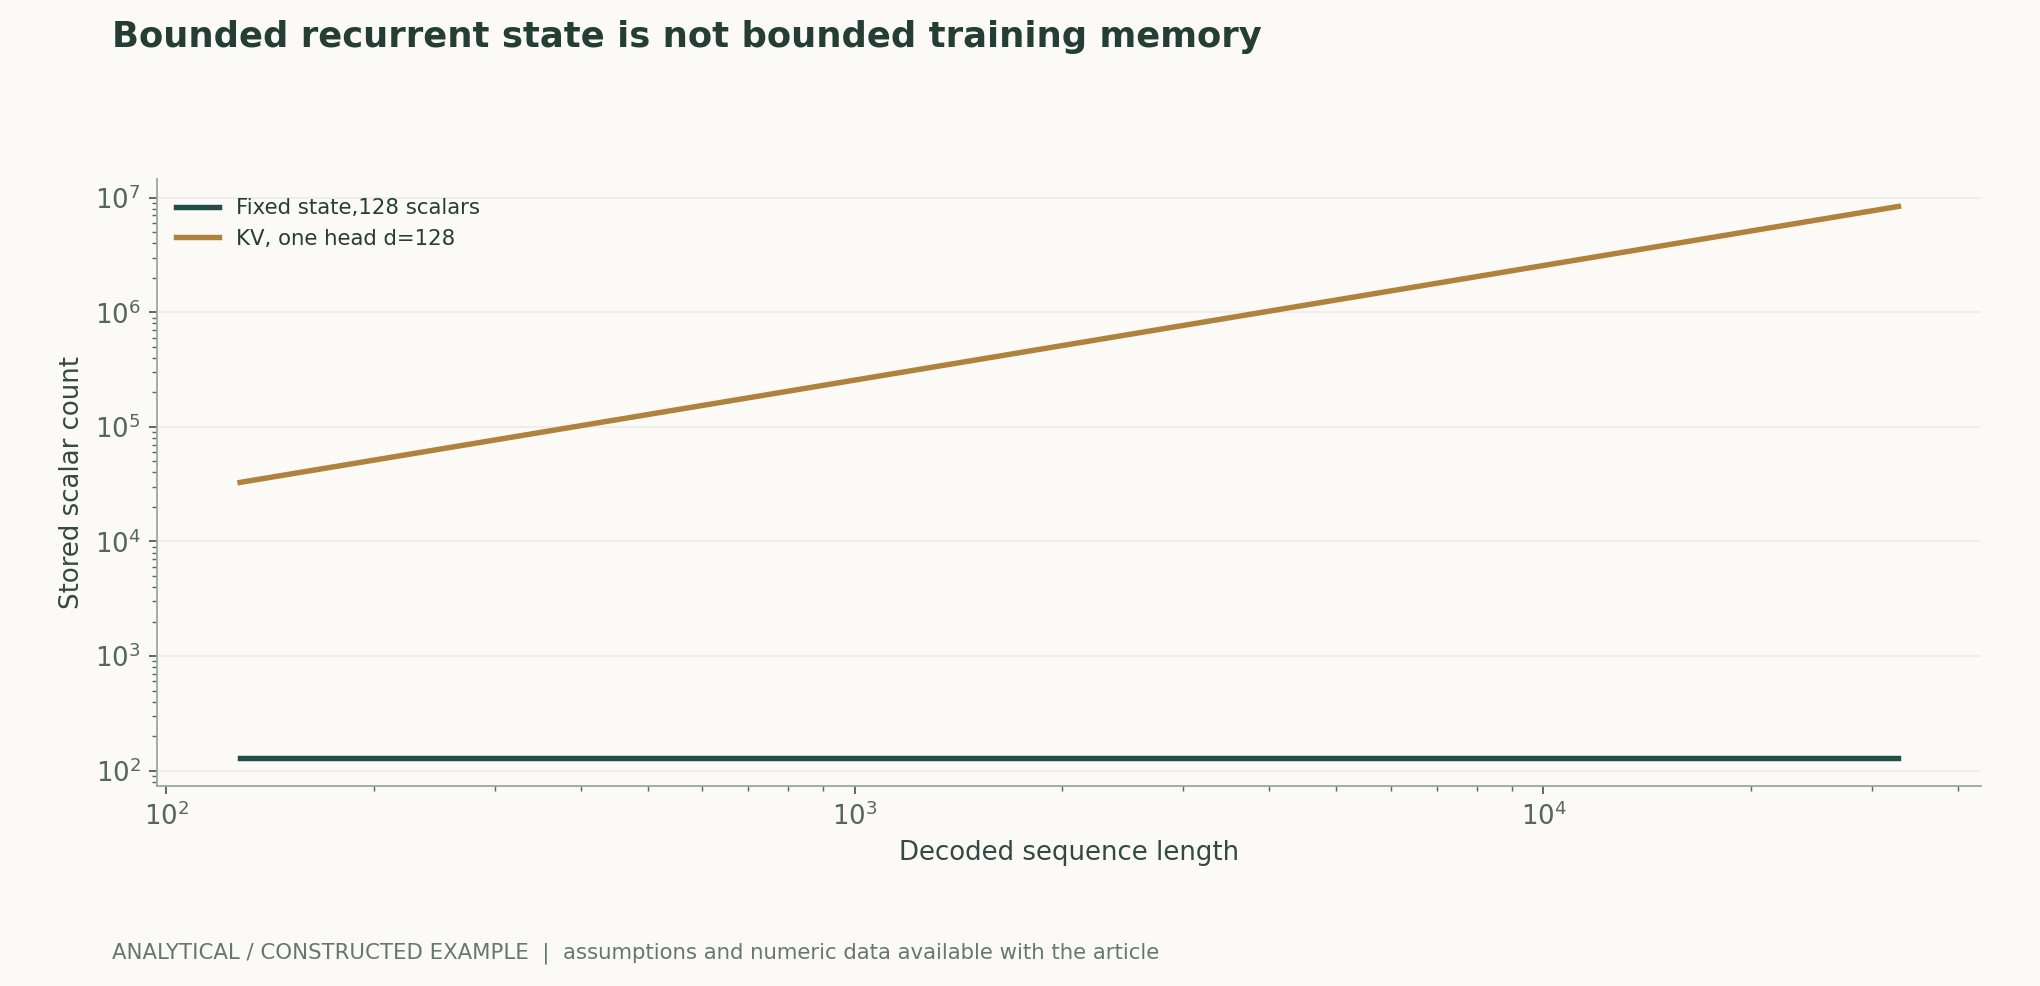
固定架构的在线递推状态可与历史长度无关;训练还要处理各位置的输入、输出、梯度以及可能保存或重算的中间量。批量、层数和通道维也会放大状态。图中把一个128维状态与逐位置KV计数对比,只是隔离长度这一变量。若把它直接写成“模型内存恒定”,就忽略了参数、训练激活、临时工作区和输出缓存。真实峰值应在预填充、训练和解码三个阶段分别测量。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta
5. 长序列评估应区分记忆、检索和组合
低成本处理很长输入不等于能可靠使用其中所有信息。局部预测、跨长距离状态跟踪、任意位置检索和多项证据组合对记忆结构的要求不同。需要控制信息位置、干扰量、值的相似性和训练长度,并报告质量随长度变化的曲线。混合架构也应说明哪些层使用注意力、哪些层使用递推,不能把混合结果全部归因于其中一种模块。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient[3] Attention Is All You Need
6. 实验解释必须与架构粒度一致
合适的消融包括固定参数与输入依赖参数、状态维度、选择机制及内核实现;同一时间只改变一个因素,再观察质量和系统成本。对数值稳定性,应检查状态范围、精度与长序列误差累积。本文给出的公式和计数能够核对更新含义与长度依赖,但没有训练模型,也没有证明递推方法普遍优于注意力。研究结论应限定于实际测过的任务、长度和硬件。[1] Mamba: Linear-Time Sequence Modeling with Selective Sta[2] Transformers are SSMs: Generalized Models and Efficient
核心公式与推导
(1) 这是状态空间核心更新的抽象;完整模型还包括投影、门控等模块。选择性系数可依赖输入。
LaTeX
h_t=\bar A_t h_{t-1}+\bar B_t x_t,\qquad y_t=C_t h_t(2) 在一步内输入保持不变的离散化表达;积分形式不要求A可逆。输入依赖时需按实际参数化解释。
LaTeX
\bar A=\exp(\Delta A),\qquad\bar B=\left(\int_0^\Delta\exp(sA)\,ds\right)B(3) 仿射变换的结合性支持扫描组织;它本身不保证某个实现获得硬件加速。
LaTeX
(A_2,b_2)\circ(A_1,b_1)=(A_2A_1,A_2b_1+b_2)方法与证据流程
解析图与数值示例
可复算例题
在8192位置时,此限定例子的KV为2097152标量,递推状态为128标量。两者表达和架构不同,不能把该比例当作全模型内存或能力比较。
方法比较
| 方法或判断 | 控制变量与测量 | 失效条件及解释 |
|---|---|---|
| 固定系数SSM | 核对离散化与卷积展开条件 | 输入依赖后不再是固定卷积核 |
| 解码状态 | 固定层、通道和状态维度计数 | 不包含训练激活和全部内存 |
| 并行扫描 | 测内核、IO和实际设备 | 线性复杂度不能直接换算时延 |
| 长上下文能力 | 分开检索、跟踪和组合任务 | 能处理长输入不等于有效使用 |
复核与实验方案
- 固定总参数、数据、训练预算及分词器,明确是否为混合架构。
- 保存状态维度、离散步长参数化、门控及内核版本。
- 用小序列逐步递推对照扫描结果,测不同精度的误差。
- 分别统计训练、预填充和在线解码的峰值内存及时间。
- 按长度、信息位置、干扰量和任务类型测质量曲线。
- 消融输入依赖选择、状态维和模块,保留失败任务及稳定性记录。
适用范围与局限
- 状态计数不是全模型显存。
- 未进行语言模型训练或设备测速。
- 固定状态可能形成信息瓶颈。
- 不同任务不能由复杂度直接排序。
一手来源与主张对应
- Mamba: Linear-Time Sequence Modeling with Selective State Spaces, · 2023-12-01Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality, · 2024-05-31Abstract; 原文方法、理论和实验章节见作者原始论文链接
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
引用与文稿导出
BibTeXRISCSL JSONTXTArticle JSON
作者、版本与来源
AI辅助研究综述;Codex(AI)依据所列一手文献撰写并进行解析推导。 本站没有本篇独立同行评审或原创模型实验记录。
阅读器性能修订:新近 HEAD 返回 200 且 ETag 相同时也复用已读页面。正文、公式、来源和科学图的数据保持上一版本内容。
概念封面与科学图解分开;科学图由公开公式和明示假设计算,原始论文结果均注明归属。
作者、版本与更正记录 · /guides/state-space-mamba/v1/
Source revision: 6251a250b27bb8b449f59b392f81abd355383770