
الملخص
ينبع تأثير آلية الانتباه من بنية تفاعل المعلومات، وكذلك من تنظيم التدريب القابل للتوازي. لكن البنية والمؤثرات ذات الفاصلة العائمة والتنفيذ على العتاد ليست موضوعًا بحثيًا واحدًا. تبدأ هذه المقالة من انتباه الجداء النقطي المُحجَّم، ثم تشتق كيفية تجنّب التطبيع على مستوى الكتل للتخزين الصريح لجميع الدرجات، وتقارن أنماط نمو مصفوفة الدرجات أثناء التدريب وذاكرة KV المؤقتة أثناء فك الترميز. وعلى هذا الأساس، تضع خطة تحقق تبدأ باختبار تكافؤ المخرجات والتدرجات، ثم تقيس زمن الاستجابة واستخدام ذاكرة المسرّع. وتعتمد الاستنتاجات على شروط التسلسل والأبعاد والدقة والجهاز، ولا تعمّم نتائج نواة محسّنة بعينها باعتبارها دليلًا على تفوق بنية ما بصورة عامة.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Longformer: The Long-Document Transformer
ترجمة الملخص الإنجليزي
تميّز هذه المراجعة بين الانتباه بوصفه مؤثرًا رياضيًا، وجدولة تنفيذه، والاعتماد التسلسلي في التوليد ذاتي الانحدار. وتشتق علاقة تكرارية مستقرة لدالة softmax على مستوى الكتل، وتفصل تخزين الدرجات عن نمو ذاكرة KV المؤقتة، وتقترح مقارنات للأداء تبدأ بالتحقق من التكافؤ. وجميع الأمثلة العددية مكونات تحليلية، وليست قياسات لأداء النموذج من البداية إلى النهاية.
1. تحديد عنق الزجاجة الذي يجري تغييره أولًا
تحتاج نماذج التسلسل التكرارية عادةً، داخل العينة الواحدة، إلى تحديث الحالة تباعًا عبر المواضع الزمنية. ويستكمل Transformer الأصلي معلومات الترتيب بتمثيلات الموضع، ثم يتيح لمواضع متعددة تبادل المحتوى عبر الانتباه. وهو يقصّر مسارات المعلومات بين المواضع المتباعدة، ويوسّع إمكانات التوازي بين المواضع أثناء التدريب. ومع ذلك، يظل فك الترميز ذاتي الانحدار معتمدًا على الرموز المولّدة سابقًا؛ فإمكان موازاة التدريب لا يعني إمكان توليد الإجابة كاملةً في الوقت نفسه.[1] Attention Is All You Need
2. تمثل Q وK وV أدوارًا حسابية
يمكن كتابة انتباه الجداء النقطي المُحجَّم على الصورة تُنتج Q وK درجات المطابقة، وتطبّع softmax هذه الدرجات، ثم تُستخدم لترجيح V. وتتيح آلية تعدد الرؤوس إجراء هذه العملية بصورة منفصلة في فضاءات إسقاط فرعية مختلفة، ثم دمج النتائج. تصف هذه الأسماء أدوار المتجهات في الحساب، ولا تعني أن النموذج يمتلك وحدات «أسئلة» أو «ذاكرة» أو «فهم» تقابل الإدراك البشري مباشرةً.[1] Attention Is All You Need
3. يجب الحفاظ على السياق التجريبي لأرقام الأداء
أفادت تجارب الترجمة من الإنجليزية إلى الألمانية في WMT 2014 في الورقة الأصلية بأن Transformer big حقق 28.4 BLEU. يرتبط هذا الرقم بإعدادات محددة للبيانات وتجزئة النص إلى رموز والتدريب وفك الترميز والتقييم، ولا يمثل دليلًا على قدرات النماذج اللغوية الحديثة العامة الأغراض. ولا تقارن هذه المقالة درجات الترجمة من الإنجليزية إلى الفرنسية بين أوراق مختلفة: إذ تختلف الصياغات في ملخصات النسخ المتاحة وجداولها ومتونها، وخلطها سيولّد استنتاجات تبدو دقيقة دون أساس.[1] Attention Is All You Need
4. لماذا يكون السياق الطويل مكلفًا
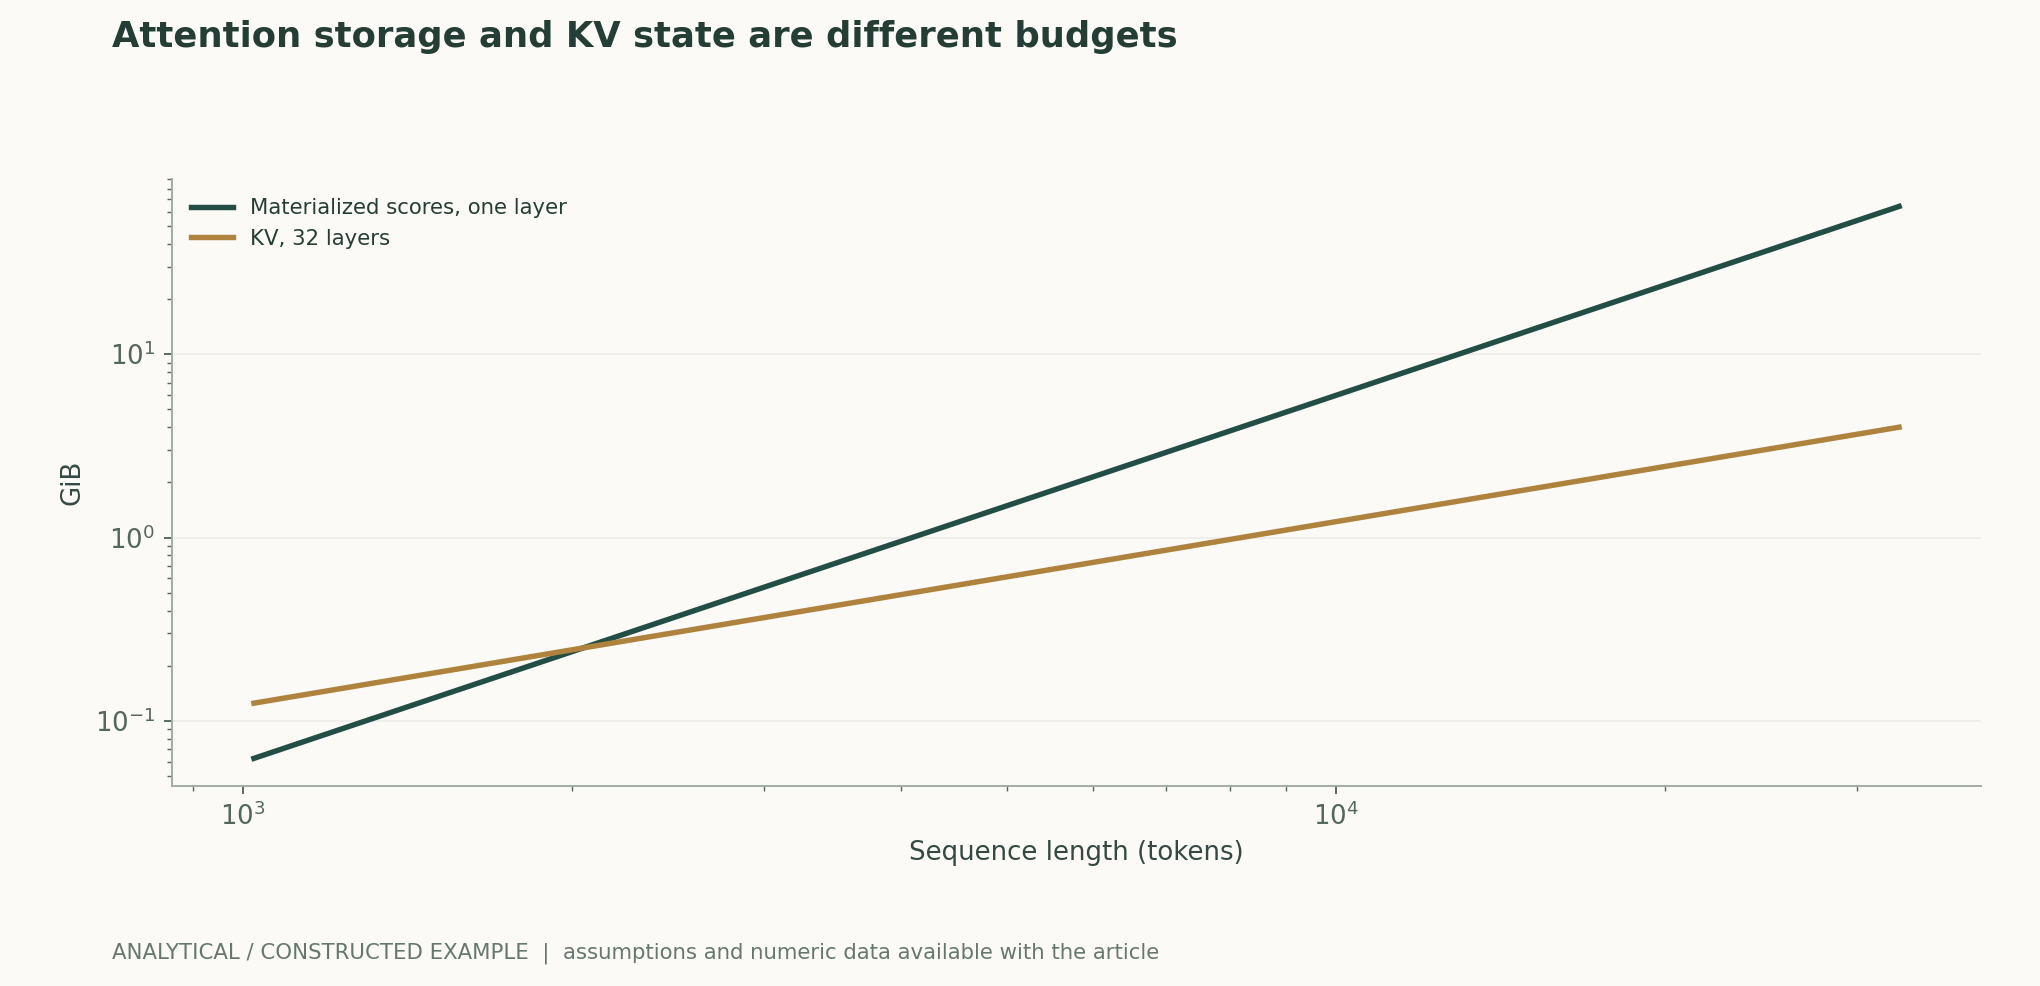
ينشئ الانتباه الكامل، على تسلسل طوله n،من الأزواج. وإذا خُزِّنت درجات float32 صراحةً لطبقة واحدة ورأس واحد، فإن عدد البايتات هو، وتؤدي مضاعفة الطول إلى زيادة هذا الحد أربعة أضعاف. ويستخدم الشكل 2 في هذه النسخة إعدادًا آخر محددًا بوضوح: درجات FP16 لعدد 32 من الرؤوس، مع مقارنتها بصورة منفصلة بذاكرة مؤقتة لعدد 32 من الطبقات و8 من رؤوس KV؛ ولا يجوز دمج هذين الحسابين بوصفهما ذروة واحدة لاستخدام ذاكرة المسرّع. ويجب احتساب التدرجات والإسقاطات والتنشيطات ومساحات عمل النواة بصورة منفصلة.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. نوعان من التحسين يجيبان عن سؤالين مختلفين
يغيّر Longformer المواضع التي تحتاج إلى التفاعل، ويعالج المستندات الطويلة باستخدام نوافذ محلية وانتباه عالمي انتقائي. أما FlashAttention فيعيد ترتيب الحساب وفق التسلسل الهرمي للذاكرة، ويستخدم التقسيم إلى كتل والدمج لتقليل الوصول إلى ذاكرة المسرّع ذات النطاق الترددي العالي، مع الحفاظ على الانتباه الدقيق وفق تعريفه. يعدّل الأول بنية الاتصالات؛ ويحسّن الثاني طريقة تنفيذ الحساب نفسه. ولا يجوز وصف تحسين الإدخال والإخراج بأنه أزال جميع العمليات ذات النمو التربيعي.[3] Longformer: The Long-Document Transformer[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
6. مثال تحليلي قابل للتحقق
كمثال لحساب تخزين درجات float32 لطبقة واحدة ورأس واحد، تتطلب الأطوال 512 و1024 و2048 و4096 على الترتيب 1 و4 و16 و64 MiB،بايت. يختلف هذا عن إعداد الشكل 2 في هذه النسخة؛ فالأرقام مشتقة من الصيغ وليست قياسات فعلية على GPU. وإذا عالج التنفيذ البيانات على شكل كتل دون إعادة كتابة جميع الدرجات إلى الذاكرة ذات النطاق الترددي العالي، فستتغير الذروة الفعلية، ولذلك يجب التحقق من استراتيجية التنفيذ قبل تفسير الاتجاه.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
7. كيف ينبغي مقارنة طريقة «أسرع»
توصي هذه المقالة بالإبلاغ بصورة منفصلة عن طول عينات التدريب، وحجم الدفعة، والدقة، والجهاز، والإحماء، والإنتاجية، وزمن الاستجابة حتى أول رمز، وذروة استخدام ذاكرة المسرّع، وإجراء المقارنة تحت هدف جودة واحد. فإذا اقتطعت إحدى الطريقتين السياق بينما احتفظت الأخرى بكامل المدخلات، فإن فرق السرعة يتضمن تغيرًا في المهمة؛ وإذا استخدمت إحداهما نواة مدمجة والأخرى تنفيذًا مباشرًا، فلا يمكن أيضًا إرجاع الفرق كله إلى البنية. وهذه توصية لتصميم التجارب، وليست نتيجة تجريبية جديدة لهذه المقالة.作者分析与复核建议 / Author analysis
حد حسابي يسهل إغفاله
بالنسبة إلى درجات الانتباه، لا يصف هذا الحد إلا التفاعلات بين المواضع؛ أما الإسقاطات وشبكات التغذية الأمامية لكل موضع فلها تكاليفها الحسابية الخاصة. وعند تثبيت طول التسلسل، تؤدي زيادة البعد الخفي إلى تغيير الأوزان النسبية لهذه الحدود؛ وعند تثبيت البعد، تجعل إطالة التسلسل أزواج المواضع أكثر أهمية. ولذلك لا تكفي عبارة «الانتباه ذو تعقيد تربيعي» وحدها للتنبؤ بنسبة الزمن التي يستغرقها كل جزء من النموذج بأكمله. ينبغي أولًا تحديد أبعاد النموذج ومدخلاته، ثم تفسير نتائج تحليل الأداء الفعلية.作者分析与复核建议 / Author analysis
8. الإحصاءات الكافية لدالة softmax على مستوى الكتل
بالنسبة إلى صف من الدرجات، قد يؤدي حساب مجموع القيم الأسية مباشرةً بسهولة إلى تجاوز النطاق العددي؛ وطرح القيمة العظمى يغيّر تمثيل التطبيع فقط، ولا يغيّر الاحتمالات. وعند معالجة كتلة جديدة، لا يلزم الاحتفاظ بجميع الدرجات السابقة، بل يكفي الاحتفاظ بالقيمة العظمى الجارية m، ومقام التطبيع l، والمجموع الموزون u قبل القسمة على المقام. وبعد توحيد الكتلتين الجديدة والسابقة وفق القيمة العظمى الجديدة m′، تُعاد موازنة المقادير المتراكمة السابقة بعامل exp(m−m′). ويتحول البسط والمقام معًا، ثم تعطي u/l مخرج هذا الصف. يفسّر هذا الاشتقاق لماذا لا يستلزم تقليل التنقل إلى ذاكرة المسرّع ومنها تغيير اتصالات الانتباه؛ لكن ترتيب جمع أعداد الفاصلة العائمة يتغير، ولذلك يجب مع ذلك التحقق من التكافؤ العددي ضمن السماحية المتفق عليها.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
9. ينبغي نمذجة ذاكرة التدريب والذاكرة المؤقتة لفك الترميز بصورة منفصلة
ينمو التخزين الصريح للدرجات مع عدد أزواج المواضع؛ أما ذاكرة KV المؤقتة فتحتفظ بمفاتيح المواضع السابقة وقيمها لكل طبقة. وبافتراض L من الطبقات، وn من المواضع، وh_kv من رؤوس KV، وبُعد d_h لكل رأس، وb بايت لكل قيمة قياسية، يبلغ حجم الذاكرة المؤقتة تقريبًا 2Lnh_kv d_h b. ولا تشمل هذه الصيغة الأوزان ومساحات العمل وتجزؤ ذاكرة المُخصِّص. ويمكن لتقليل عدد رؤوس KV أن يخفض هذا الحد، لكن لا يجوز الاستناد إلى ذلك للقول إن عمليات الانتباه أثناء التدريب تنخفض بالنسبة نفسها. وينبغي تحليل أداء الملء المسبق للموجّهات الطويلة، وفك الترميز ذي الخطوات القصيرة، والطلبات المتزامنة كلًّا على حدة، بدل الاكتفاء بمتوسط واحد بوحدة رمز/ثانية.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
10. لماذا تنتقل اختناقات الحساب مع تغير عبء العمل
في نموذج roofline المثالي، لا يمكن أن يقل زمن التشغيل عن max(F/القدرة الحسابية,B/عرض النطاق)، حيث F هو عدد العمليات وB هو عدد البايتات المنقولة فعليًا. ويؤثر الدمج والتقسيم إلى كتل أساسًا في B؛ أما تقليل الاتصالات فيؤثر أساسًا في F وفي القدرة التمثيلية للنموذج. وتخضع النوى الفعلية أيضًا لقيود الإطلاق والمزامنة والإشغال وأشكال الموترات، لذا فإن هذا الحد الأدنى ليس أداة للتنبؤ بالأداء. فقد تؤدي زيادة حجم الدفعة مثلًا إلى توزيع كلفة قراءة الأوزان على عناصر أكثر، لكنها قد تستنفد سعة KV أولًا؛ كما قد يغيّر ازدياد طول التسلسل التقسيم الأمثل إلى كتل. وينبغي الاستناد إلى تحليل أداء الجهاز لدعم الحكم بأن «عنق الزجاجة قد انتقل»، بدل استنتاج عامل التسريع مباشرةً من التعقيد التقاربي.[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Longformer: The Long-Document Transformer
11. تمثيل المدى البعيد لا يعني تلقائيًا إمكان الاستفادة منه
يحدد ترميز الموضع كيفية دخول المواضع النسبية في درجات المطابقة، ويحدد نمط الاتصالات ما إذا كان وصول المعلومات ممكنًا، بينما تحدد بيانات التدريب والمهمة ما إذا كان النموذج يستخدم الأدلة فعلًا. ويمكن للبناء الدوراني في RoPE تمثيل الإزاحة النسبية في الجداء الداخلي، لكن ذلك وحده لا يضمن الموثوقية عند تجاوز أطوال التدريب. وينبغي، كحد أدنى عند التحقق باستخدام نصوص طويلة، تغيير موضع الدليل، وعدد العناصر المشتتة، والمسافة بين الأدلة المطلوب دمجها كلٌّ على حدة، وفحص ظهور اختصارات تعتمد فقط على قرائن محلية. ويجب الإبلاغ بصورة منفصلة عن الحد الأقصى للطول، والقدرة على استقبال المدخلات، والسياق الفعّال اللازم لإتمام المهمة.[4] RoFormer: Enhanced Transformer with Rotary Position Emb[3] Longformer: The Long-Document Transformer
الصيغ الأساسية والاشتقاقات
(1) تمثل m أعلى درجة بين المواضع التي عولجت، وتمثل l مقام التطبيع المقابل. وتُحدِّث الكتلة الجديدة المرجع المشترك أولًا ثم تُضاف إلى التراكم، ولذلك لا يلزم حفظ مصفوفة الدرجات السابقة.
LaTeX
m'=\max(m,\max_j s_j),\quad l'=e^{m-m'}l+\sum_j e^{s_j-m'}(2) تمثل u القيمة الموزونة قبل القسمة على المقام. ويجب إعادة تحجيم البسط والمقام بالتزامن؛ إذ إن مجرد جمع مخرجات الكتل بعد تطبيع كل منها يفقد الأوزان بين الكتل، ولا ينتج الانتباه الكامل.
LaTeX
u'=e^{m-m'}u+\sum_j e^{s_j-m'}v_j,\qquad o=u'/l'(3) هذا تقدير تحليلي للذاكرة التي يشغلها تخزين القيم القياسية مؤقتًا، وليس لذاكرة المسرّع التي تشغلها عملية الاستدلال بأكملها. ويجب احتساب حجم الدفعة، والمشاركة بين طلبات متعددة، وكتل الصفحات، والبيانات الوصفية للتكميم بصورة منفصلة.
LaTeX
M_{\mathrm{KV}}=2Lnh_{\mathrm{kv}}d_hbسير المنهج والأدلة
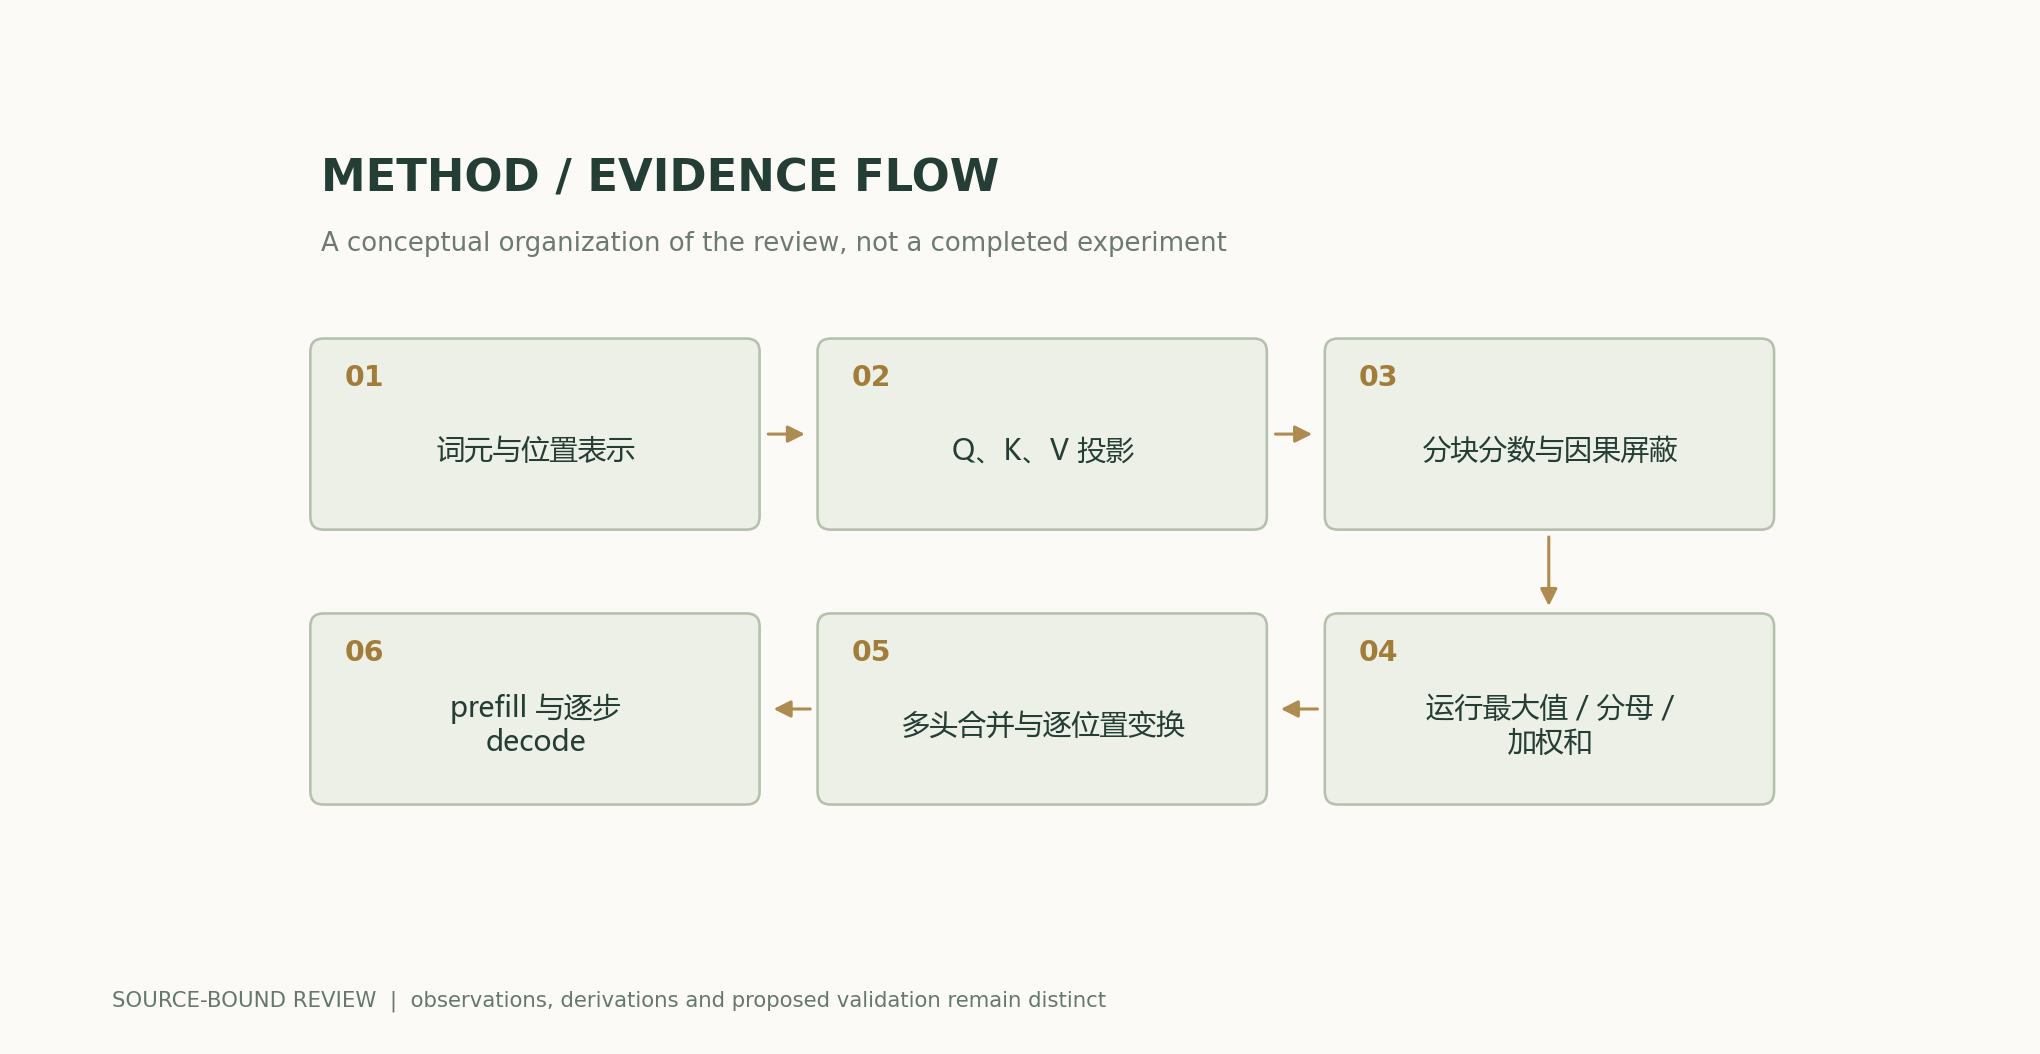
رسوم تحليلية وأمثلة عددية
مثال محلول يمكن إعادة حسابه
عند 8192 رمز، تشغل مصفوفة الدرجات لطبقة واحدة تضم 32 رأسًا 4 GiB؛ وتشغل الذاكرة المؤقتة لعدد 32 من الطبقات و8 من رؤوس KV مقدار 1 GiB. وهما يرتبطان بدورتي حياة مختلفتين، لذلك لا يجوز اعتبار هذا الشكل قياسًا لذروة استخدام ذاكرة المسرّع أو لاختبار سرعة FlashAttention.
مقارنة الطرق
| الطريقة أو الحكم | المتغيرات المضبوطة والقياسات | شروط الإخفاق وتفسيرها |
|---|---|---|
| انتباه دقيق على مستوى الكتل | تثبيت الأوزان والقناع والدقة والمدخلات، ومقارنة أخطاء المخرجات والتدرجات | يتطلب اختلاف ترتيب عمليات الفاصلة العائمة سماحية عددية؛ ولا يجوز تفسير التكافؤ على أنه تطابق تام في أنماط البتات |
| اتصالات متناثرة | تثبيت التدريب والهدف المتعلق بالجودة، وتغيير النافذة والمواضع العالمية | بعد إزالة اتصالات، لا يعود المؤثر هو نفسه |
| تحسين ذاكرة KV المؤقتة | الإبلاغ بصورة منفصلة عن الملء المسبق، وفك الترميز، وحجم الدفعة، وأقصى طول مقيم في الذاكرة | صِغَر الذاكرة المؤقتة لا يعني أن جميع المراحل أسرع |
| توسيع السياق الطويل | تصنيف الاختبارات بحسب موضع الدليل والمسافة بين الأدلة المراد دمجها، مع الاحتفاظ بضوابط من نصوص قصيرة | نجاح قراءة مدخل طويل لا يعني نجاح إنجاز مهمة بعيدة المدى |
خطة التحقق والتجارب
- ثبّت مجموعة من الأوزان وتسلسل الرموز والقناع والبذرة العشوائية؛ وسجّل الدقة والجهاز وإصدار النواة، وعطّل الانتقال التلقائي إلى تنفيذ بديل إذا كان سيغيّر موضوع المقارنة.
- قارن أولًا الأخطاء المطلقة والنسبية في مخرجات المرور الأمامي والخسارة والتدرجات، واستخدم عند الحاجة حسابًا صغير الأبعاد بدقة أعلى مرجعًا.
- اختبر نطاقًا من أطوال التسلسل وأحجام الدفعات كلًّا على حدة؛ وعند كل نقطة، أجرِ الإحماء أولًا، ثم قِس الزمن مع مزامنة الجهاز، وسجّل كلفة الترجمة البرمجية الأولى بصورة منفصلة.
- سجّل بصورة منفصلة زمن الاستجابة حتى أول رمز في الملء المسبق وتوزيع زمن الاستجابة لكل رمز في فك الترميز، ولا تستخدم المتوسط العام لإخفاء الفروق بين المراحل.
- قِس بالتزامن ذروة استخدام العملية لذاكرة المسرّع، والذاكرة التي يحتفظ بها المُخصِّص، وإشغال KV؛ فالرسوم التحليلية لا توفر سوى مرجع لرتبة مقدار كل مكوّن على حدة.
- أدرج مهام يقع فيها الدليل في البداية والوسط والنهاية؛ وإذا غيّرت الطريقة الأسرع الاتصالات، وجب الإبلاغ كذلك عن التغير في جودة أداء المهمة.
نطاق التطبيق والقيود
- لا تشمل أحجام التخزين التحليلية التدرجات والأوزان وتجزؤ ذاكرة المُخصِّص.
- يجب قياس زمن التشغيل فعليًا على الجهاز المستهدف؛ ولا يمكن استخراجه مباشرةً من منحنيات الشكل.
- ينبغي مقارنة أنماط الاتصالات المختلفة تحت قيود الجودة نفسها.
- لم تُدرِّب هذه المقالة نموذجًا جديدًا ولم تضف اختبارًا معياريًا جديدًا للأداء.
مطابقة الادعاءات بالمصادر الأولية
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Longformer: The Long-Document TransformerBeltagy et al. · 2020-04-10v2 abstract and architecture description
- RoFormer: Enhanced Transformer with Rotary Position Embedding, , , , , · 2021-04-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
الاستشهاد وتصدير المقالة
BibTeXRISCSL JSONTXTJSON المقالة
المؤلف والإصدار والمصادر
مراجعة بحثية بمساعدة الذكاء الاصطناعي؛ تولّى Codex، وهو نظام ذكاء اصطناعي، الكتابة والاشتقاقات التحليلية استنادًا إلى المراجع الأولية المذكورة. لا يملك هذا الموقع سجلًا لمراجعة أقران مستقلة لهذه المقالة أو لتجارب أصلية على النماذج تخصها.
تعديل أداء القارئ: تُعاد أيضًا الاستفادة من الصفحات المقروءة عندما يعيد طلب HEAD حديث الحالة 200 وتبقى قيمة ETag كما هي. يحتفظ المتن والصيغ والمصادر وبيانات الرسوم العلمية بمحتوى الإصدار السابق.
الغلاف المفاهيمي منفصل عن الرسوم العلمية؛ وتُحسب الرسوم العلمية انطلاقًا من صيغ منشورة وافتراضات مصرّح بها، مع إسناد جميع نتائج الأوراق الأصلية إلى مصادرها.
سجل المؤلف والإصدارات والتصحيحات · /guides/transformer-attention/v5/
مصادر الغلاف والرسوم العلمية · البيانات والمصادر والافتراضات · سجل النشر والإصدارات
مراجعة المصدر: 6251a250b27bb8b449f59b392f81abd355383770