
要旨
注意機構の影響は、情報の相互作用構造だけでなく、並列化可能な学習の構成にも由来する。ただし、アーキテクチャ、浮動小数点演算子、ハードウェア上の実行は、同一の研究対象ではない。本稿はスケーリング付き内積注意を出発点として、ブロック単位の正規化が全スコアの明示的な保存をいかに回避するかを導出し、学習時のスコア行列とデコーディング時のKVキャッシュの増大則を比較する。そのうえで、まず出力と勾配の等価性を検証し、その後に遅延とデバイスメモリ使用量を測定する検証計画を構築する。結論は系列、次元、精度、デバイスの条件に依存し、特定の最適化カーネルの結果を普遍的なアーキテクチャの優位性へ外挿しない。[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Longformer: The Long-Document Transformer
英文要旨の日本語訳
本レビューは、数学的演算子としての注意機構を、その実行スケジュールおよび自己回帰生成における逐次依存性と区別する。安定したブロック単位softmaxの漸化式を導出し、スコアの保存とKVキャッシュの増大を分け、等価性の検証を先行させる性能比較を提案する。すべての数値例は解析的な構成要素であり、モデルのエンドツーエンド性能の実測値ではない。
1. まず、変更対象となるボトルネックを明確にする
再帰型系列モデルでは、通常、一つのサンプル内で時間位置に沿って状態を逐次更新する必要がある。原型のTransformerは位置表現によって順序情報を補い、注意機構を通じて複数の位置間で内容を交換させる。これにより、離れた位置間の情報経路が短縮され、学習時に位置をまたいで並列化できる範囲も広がる。ただし、自己回帰デコーディングは依然として既に生成されたトークンに依存する。学習を並列化できることは、回答全体を同時に生成できることを意味しない。[1] Attention Is All You Need
2. Q・K・Vは計算上の役割である
スケーリング付き内積注意は次のように表せる QとKが適合スコアを形成し、softmaxがスコアを正規化した後、Vに重み付けを行う。マルチヘッド機構では、異なる射影部分空間でこの操作をそれぞれ実行し、その結果を統合する。これらの名称は計算におけるベクトルの役割を表すものであり、モデルが人間の認知に直接対応する「問い」「記憶」「理解」のモジュールを備えていることを意味しない。[1] Attention Is All You Need
3. 性能値には実験の文脈を保持しなければならない
原論文のWMT 2014英独翻訳実験では、Transformer bigが28.4 BLEUを達成したと報告されている。この数値は、特定のデータ、トークン化、学習、デコーディング、評価設定に対応するものであり、現代の汎用言語モデルの能力を証明するものではない。本稿では、異なる論文間で英仏翻訳のスコアを比較しない。アクセス可能な版の要旨、表、本文には異なる記述があり、それらを混用すると、根拠のない精密な結論を生み出すことになるためである。[1] Attention Is All You Need
4. 長いコンテキストはなぜ高コストなのか
全結合の注意機構は、長さnの系列に対しての位置対を形成する。一層・一ヘッドのfloat32スコアを明示的に保存する場合、バイト数はとなり、長さが二倍になるとこの項は四倍になる。本版の図2では、別の明示的な設定として、32ヘッドのFP16スコアを用い、32層・8個のKVヘッドのキャッシュと個別に比較している。これら二つの計数を同一のピークデバイスメモリ使用量として混同してはならない。勾配、射影、活性値、カーネルのワークスペースは別途集計する必要がある。[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. 二つの最適化は異なる問いに答える
Longformerは相互作用が必要な位置を変更し、局所ウィンドウと選択的な大域的注意を用いて長文書を処理する。一方、FlashAttentionは記憶階層を考慮して計算を再配置し、ブロック化と融合によって高帯域幅デバイスメモリへのアクセスを削減しつつ、自らが定義する厳密な注意計算を保持する。前者は接続構造を調整し、後者は同じ計算の実行方法を最適化する。IO最適化を、二次の計算量をすべて解消したものと呼んではならない。[3] Longformer: The Long-Document Transformer[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
6. 検証可能な解析例
一層・一ヘッドのfloat32スコアの計数例として、長さ512、1024、2048、4096では、それぞれ1、4、16、64 MiBが必要となり、バイトとなる。これは本版の図2の設定とは異なる。数値は数式から求めたものであり、GPUでの実測値ではない。実装がブロック単位で処理し、全スコアを高帯域幅メモリに書き戻さない場合、実際のピーク値は変わる。そのため、傾向を解釈する前に実行戦略を確認する必要がある。[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
7. 「より高速な」手法をどう比較すべきか
本稿では、学習サンプル長、バッチサイズ、精度、デバイス、ウォームアップ、スループット、最初のトークンまでの遅延、ピークデバイスメモリ使用量を個別に報告し、同一の品質目標の下で比較することを推奨する。一方の手法がコンテキストを切り詰め、他方が入力全体を保持する場合、速度差にはタスクの変更が含まれる。一方が融合カーネルを使い、他方が素朴な実装を使う場合も、その差をすべてアーキテクチャに帰することはできない。これは実験設計上の提案であり、本稿による新たな実験結果ではない。作者分析与复核建议 / Author analysis
見落とされやすい計算上の境界
注意スコアの の項が表すのは位置間の相互作用のみであり、射影と位置ごとのフィードフォワード処理にはそれぞれ独自の計算コストがある。系列長を固定した場合、隠れ次元を大きくするとこれらの項の相対的な比重が変わる。次元を固定した場合には、系列を長くするほど位置対の重要性が増す。したがって、「注意機構の計算量は二次である」という記述だけでは、モデル全体の各部分が実行時間に占める割合を予測できない。まずモデルの次元と入力を明示し、そのうえで実際のプロファイリング結果を解釈すべきである。作者分析与复核建议 / Author analysis
8. ブロック単位softmaxの十分統計量
スコアの一行について、指数関数の和を直接計算するとオーバーフローしやすい。最大値を差し引いても、変わるのは正規化の表現だけであり、確率は変わらない。新しいブロックを処理する際には、過去の全スコアを保持する必要はなく、逐次最大値m、正規化の分母l、分母で除算する前の重み付き和uだけを保持すればよい。新旧のブロックを新しい最大値m′にそろえた後、過去の累積量をexp(m−m′)で再スケーリングする。分母と分子を同時に変換し、最後にu/lによってその行の出力を得る。この導出は、デバイスメモリとの往復を減らしても注意機構の接続を変更する必要がない理由を説明する。ただし、浮動小数点の加算順序は変わるため、数値的等価性は合意した許容誤差に従って検証しなければならない。[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
9. 学習時のメモリとデコーディング時のキャッシュは分けてモデル化すべきである
スコアの明示的な保存容量は位置対の数に応じて増加する。一方、KVキャッシュは各層で過去の位置のキーと値を保持する。層数をL、位置数をn、KVヘッド数をh_kv、各ヘッドの次元をd_h、スカラー当たりのバイト数をbとすると、キャッシュ容量はおよそ2Lnh_kv d_h bとなる。この式には、重み、ワークスペース、アロケータの断片化は含まれない。KVヘッド数を減らせばこの項は小さくできるが、それを根拠に学習時の注意演算も同じ割合で減少すると主張することはできない。長いプロンプトのprefill、短いステップのdecode、並行リクエストはそれぞれ個別にプロファイリングすべきであり、単一の平均token/sのみを報告すべきではない。[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
10. 計算のボトルネックはなぜワークロードとともに移行するのか
理想化されたrooflineモデルでは、実行時間は少なくともmax(F/計算性能,B/帯域幅)によって下から制約される。ここでFは演算量、Bは実際に転送されるバイト数である。融合とブロック化は主にBに影響し、接続の削減は主にFとモデルの表現力に影響する。実際のカーネルは起動、同期、占有率、テンソル形状による制約も受けるため、この下界は性能予測器ではない。例えば、バッチサイズの増加は重み読み出しのコストを分散できる一方で、KV容量を先に飽和させる可能性がある。系列長の増加によって最適なブロック分割が変わる場合もある。「ボトルネックが移行した」という判断はデバイスのプロファイリングによって裏付けるべきであり、漸近計算量から直接高速化倍率を推定すべきではない。[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Longformer: The Long-Document Transformer
11. 長距離の表現は長距離での利用可能性を自動的に意味しない
位置符号化は相対位置が適合スコアにどのように反映されるかを決め、接続パターンは情報が到達可能かどうかを決める。また、学習データとタスクは、モデルが実際に根拠を利用するかどうかを左右する。RoPEの回転構成は内積の中で相対変位を表現できるが、それだけで学習時の長さを超えた領域での信頼性が保証されるわけではない。長文の検証では、少なくとも根拠の位置、妨害項目の数、組み合わせる必要のある根拠間の距離をそれぞれ変化させ、局所的な手掛かりのみに依存するショートカットが生じていないか確認すべきである。長さの上限、入力を受け付ける能力、タスク遂行に有効なコンテキストは、分けて報告しなければならない。[4] RoFormer: Enhanced Transformer with Rotary Position Emb[3] Longformer: The Long-Document Transformer
主要な数式と導出
(1) mは処理済み位置の最大スコア、lは対応する正規化の分母である。新しいブロックでは、まず共通の基準を更新してから累積するため、過去のスコア行列を保存する必要がない。
LaTeX
m'=\max(m,\max_j s_j),\quad l'=e^{m-m'}l+\sum_j e^{s_j-m'}(2) uは分母で除算する前の重み付き値である。分子と分母は同時に再スケーリングしなければならない。各ブロックを正規化した後の出力を単に加算するだけでは、ブロック間の重みが失われ、完全な注意計算は得られない。
LaTeX
u'=e^{m-m'}u+\sum_j e^{s_j-m'}v_j,\qquad o=u'/l'(3) これはキャッシュされたスカラー値の解析的な記憶容量であり、推論プロセス全体のデバイスメモリ使用量ではない。バッチサイズ、複数リクエスト間の共有、ページブロック、量子化メタデータは別途計上する必要がある。
LaTeX
M_{\mathrm{KV}}=2Lnh_{\mathrm{kv}}d_hb手法とエビデンスの流れ
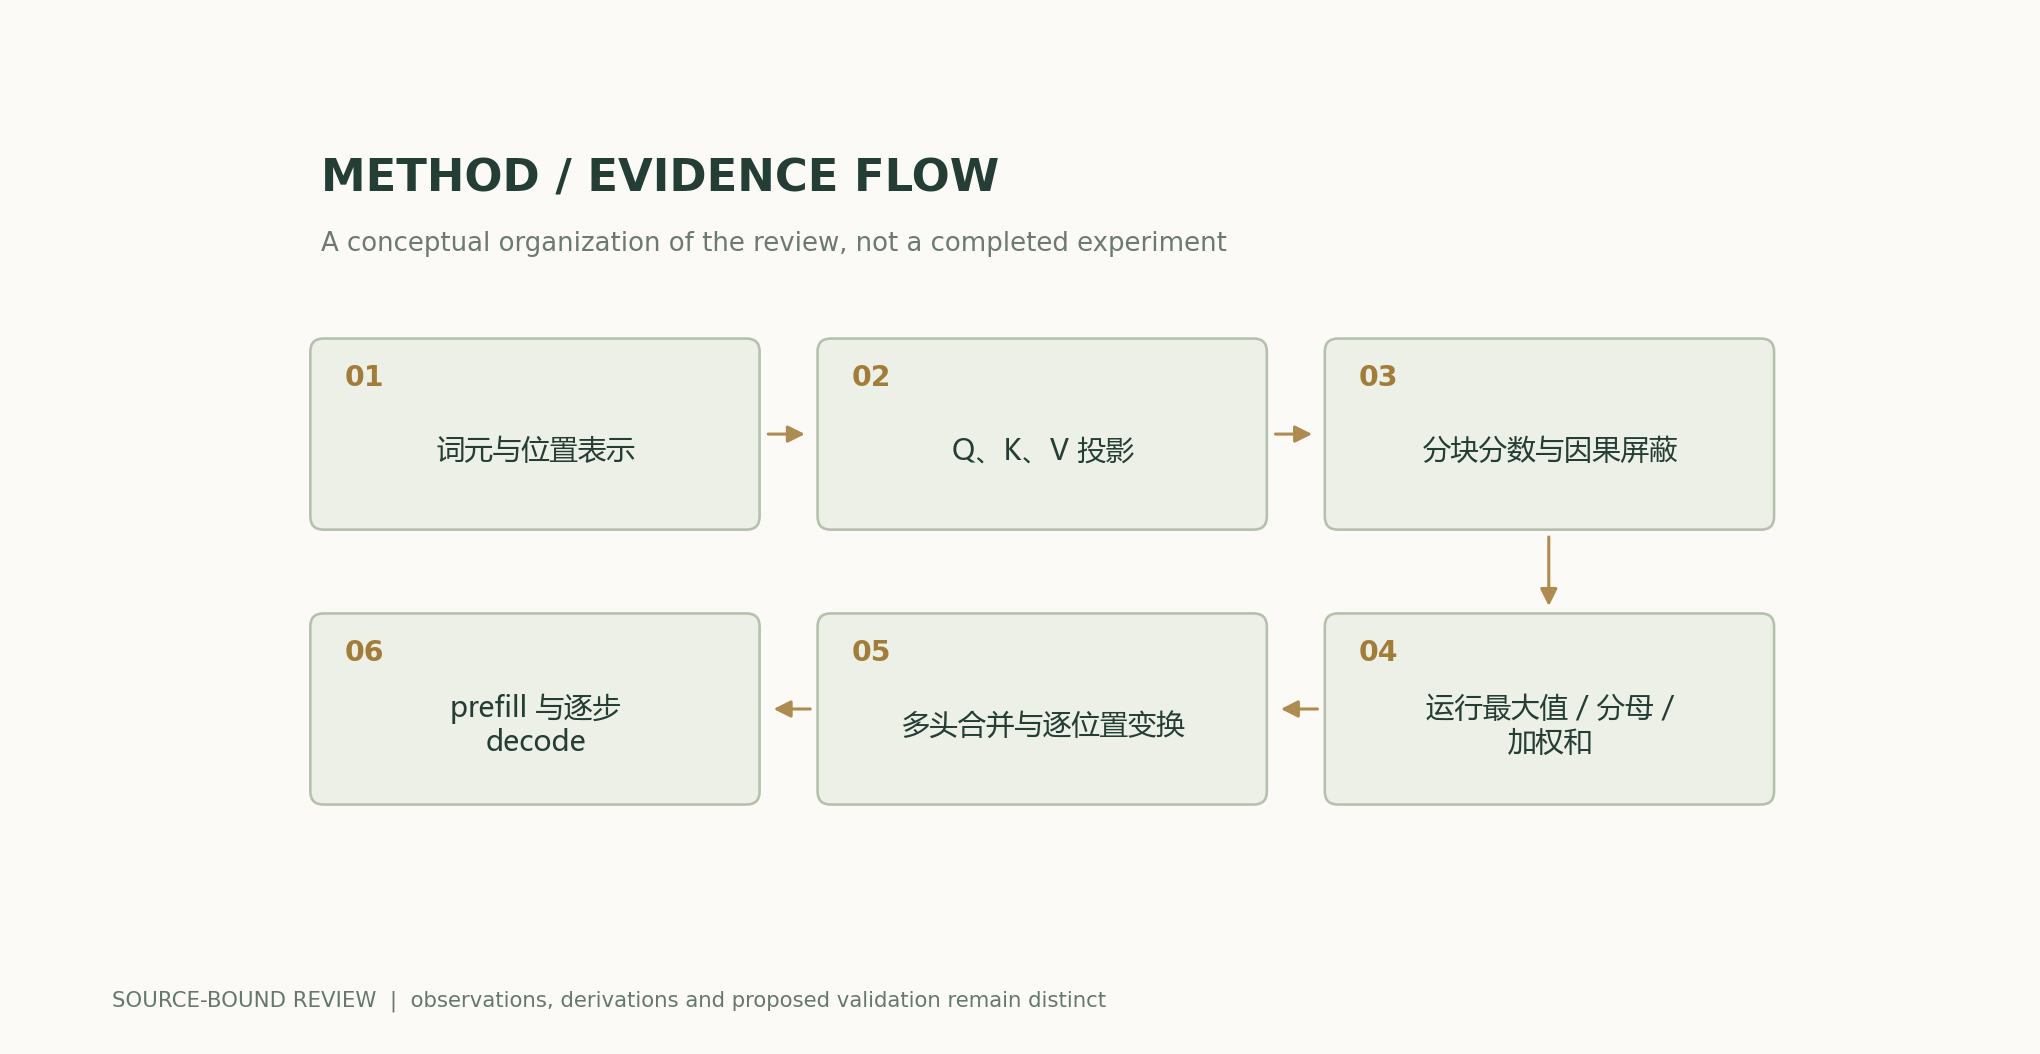
解析図と数値例
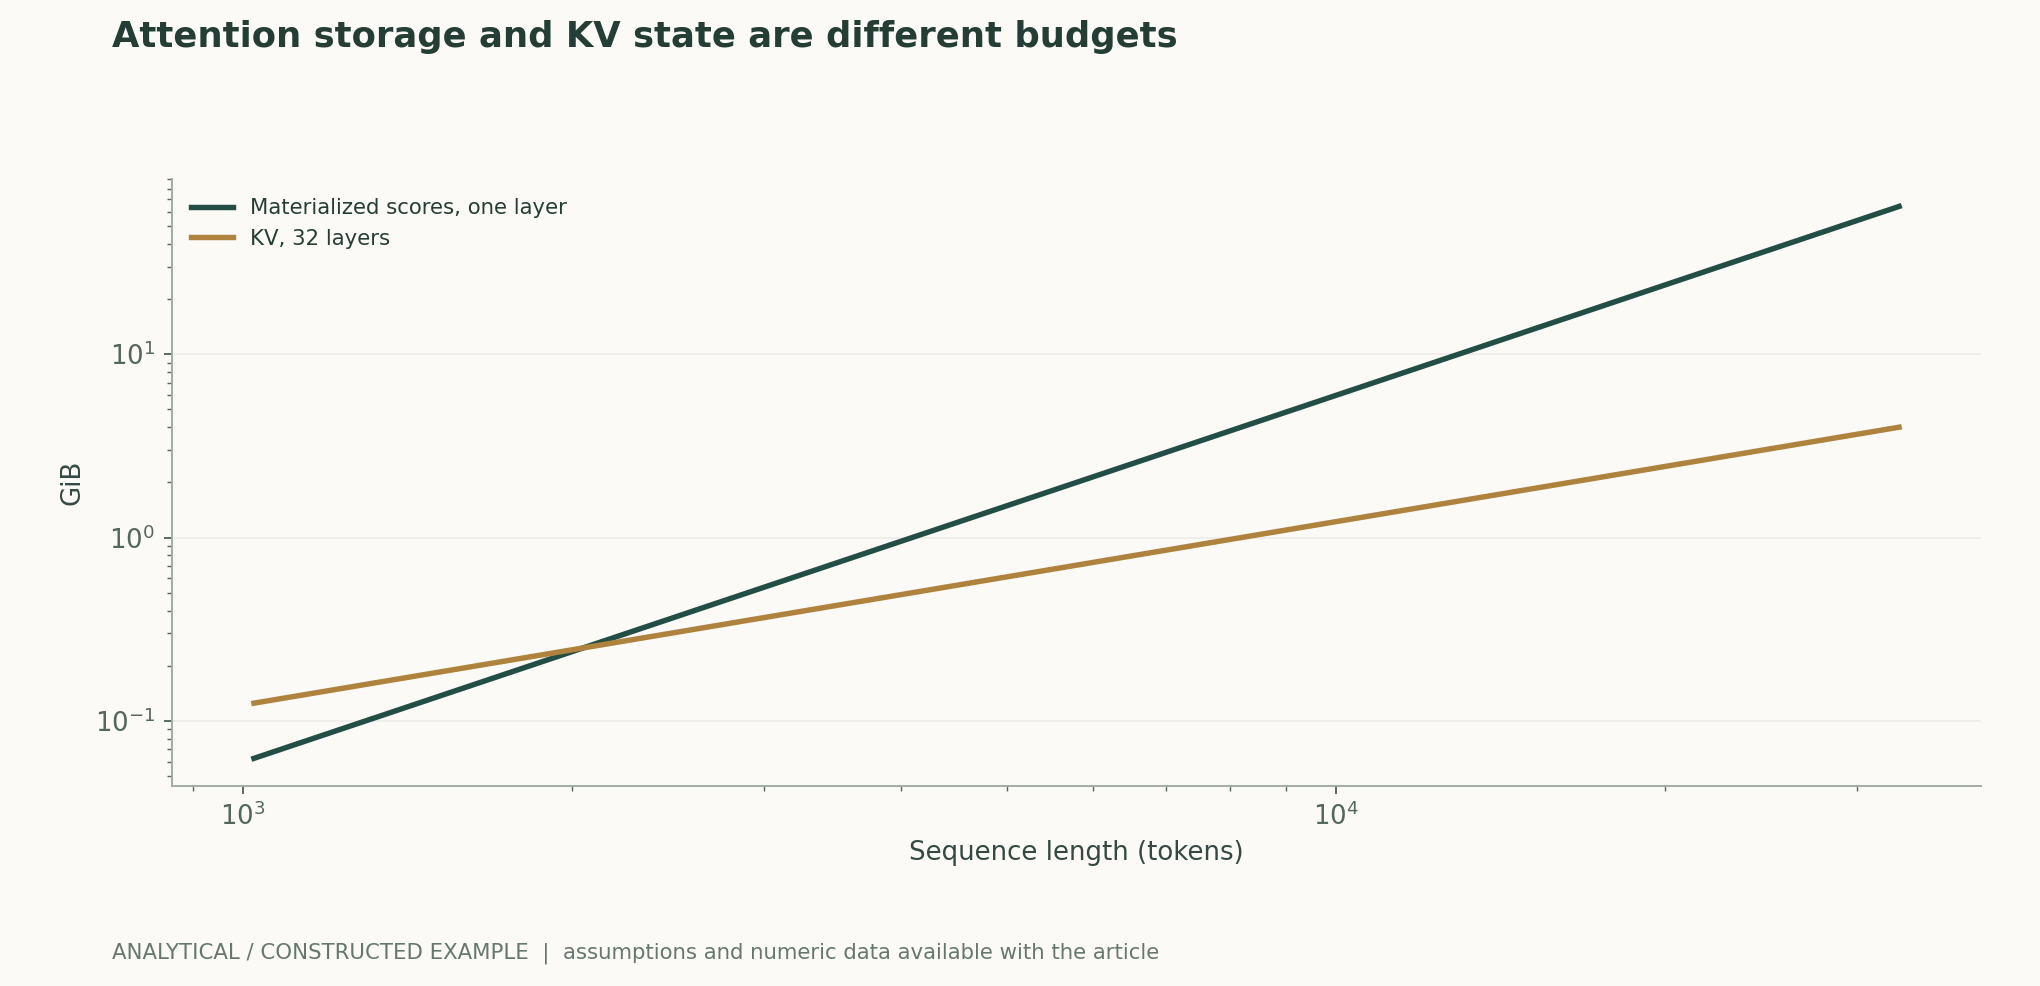
再計算可能な例題
8192トークンでは、一層・32ヘッドのスコア行列は4 GiBとなり、32層・8個のKVヘッドのキャッシュは1 GiBとなる。両者のライフサイクルは異なるため、本図をピークデバイスメモリ使用量やFlashAttentionの速度測定として扱うことはできない。
手法の比較
| 手法または判断 | 統制変数と測定 | 成立しなくなる条件と解釈 |
|---|---|---|
| 厳密なブロック単位の注意計算 | 重み、マスク、精度、入力を固定し、出力と勾配の誤差を比較する | 浮動小数点演算の順序が異なるため許容誤差が必要であり、完全に同一のビットパターンを意味すると解釈してはならない |
| 疎な接続 | 学習と品質目標を固定し、ウィンドウと大域的注意を行う位置を変更する | 接続を除去した後は、もはや同じ演算子ではない |
| KVキャッシュの最適化 | prefill、decode、バッチサイズ、最大常駐長を分けて報告する | キャッシュが小さいことは、すべての段階が高速であることを意味しない |
| 長コンテキストへの拡張 | 根拠の位置と組み合わせる根拠間の距離で層別化し、短文の対照条件を維持する | 長い入力を読み込めることは、長距離タスクを遂行できることではない |
検証と実験の計画
- 一組の重み、トークン列、マスク、乱数シードを固定する。精度、デバイス、カーネルのバージョンを記録し、比較対象を変えてしまう自動フォールバックを無効にする。
- まず順伝播の出力、損失、勾配の絶対誤差と相対誤差を比較し、必要に応じて、より高精度の小規模計算を参照値とする。
- 系列長とバッチサイズをそれぞれ走査する。各測定点でまずウォームアップを行い、次にデバイスを同期して時間を測定する。初回コンパイルのオーバーヘッドは別途記録する。
- prefillの最初のトークンまでの遅延と、decodeのトークンごとの遅延分布を分けて記録し、全体平均で段階間の差を覆い隠さない。
- プロセスのピークデバイスメモリ使用量、アロケータの予約量、KV占有量を併せて測定する。解析図は、個々の項の規模を示す目安にすぎない。
- 根拠が冒頭・中間・末尾に位置するタスクを加える。高速な手法が接続を変更する場合は、タスク品質の変化も併せて報告しなければならない。
適用範囲と限界
- 解析的な記憶容量には、勾配、重み、アロケータの断片化を含めていない。
- 実行時間は対象デバイスで実測する必要があり、図の曲線から直接求めることはできない。
- 異なる接続パターンは、同一の品質制約の下で比較すべきである。
- 本稿では、新たなモデルの学習や性能ベンチマークの追加は行っていない。
一次資料と主張の対応
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Longformer: The Long-Document TransformerBeltagy et al. · 2020-04-10v2 abstract and architecture description
- RoFormer: Enhanced Transformer with Rotary Position Embedding, , , , , · 2021-04-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
引用と原稿のエクスポート
著者・版・出典
AI支援による研究レビュー。Codex(AI)が、記載した一次文献に基づいて執筆し、解析的導出を行った。本サイトには、本稿に対する独立した査読、または独自のモデル実験の記録はない。
リーダーの性能改訂:直近のHEADリクエストが200を返し、ETagが同一である場合にも、既読ページを再利用する。本文、数式、出典、科学的な図のデータは前版の内容を維持している。
概念的な表紙と科学的図解は区別している。科学的な図は公開された数式と明示した仮定に基づいて計算し、原論文の結果にはすべて帰属を明記している。
著者・版・訂正履歴 · /guides/transformer-attention/v5/
表紙と科学的な図の出典 · データ・出典・仮定 · 公開・版履歴
ソースの改訂: 6251a250b27bb8b449f59b392f81abd355383770