
Resumen
La influencia del mecanismo de atención procede tanto de la estructura de interacción de la información como de una organización del entrenamiento que admite paralelismo. Sin embargo, la arquitectura, los operadores en coma flotante y la ejecución en hardware no constituyen un mismo objeto de investigación. Partiendo de la atención por producto escalar escalado, este artículo deriva cómo la normalización por bloques evita almacenar explícitamente todas las puntuaciones y compara los patrones de crecimiento de las matrices de puntuaciones durante el entrenamiento y de las cachés KV durante la decodificación. Con ello establece un protocolo de verificación que comprueba primero la equivalencia de las salidas y los gradientes y después mide la latencia y la memoria del dispositivo. Las conclusiones dependen de las condiciones de secuencia, dimensionalidad, precisión y dispositivo; los resultados de un kernel optimizado concreto no se extrapolan como prueba de superioridad arquitectónica universal.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Longformer: The Long-Document Transformer
Resumen (traducción del resumen en inglés)
Esta revisión distingue la atención como operador matemático de la planificación de su ejecución y de la dependencia secuencial de la generación autorregresiva. Deriva una recurrencia estable de softmax por bloques, separa el almacenamiento de puntuaciones del crecimiento de la caché KV y propone comparaciones de rendimiento que verifican primero la equivalencia. Todos los ejemplos numéricos son componentes analíticos, no mediciones del rendimiento del modelo de extremo a extremo.
1. Identificar primero el cuello de botella que se modifica
Dentro de una misma muestra, los modelos recurrentes de secuencias suelen tener que actualizar sus estados de forma sucesiva a lo largo de las posiciones temporales. El Transformer original complementa la información de orden con representaciones posicionales y permite después que múltiples posiciones intercambien contenido mediante la atención. Esto acorta las rutas de información entre posiciones distantes y amplía las posibilidades de paralelismo entre posiciones durante el entrenamiento. Sin embargo, la decodificación autorregresiva sigue dependiendo de los tokens ya generados; que el entrenamiento pueda paralelizarse no significa que toda la respuesta pueda generarse simultáneamente.[1] Attention Is All You Need
2. Q, K y V son funciones computacionales
La atención por producto escalar escalado puede escribirse como Q y K producen puntuaciones de correspondencia, softmax normaliza esas puntuaciones y los pesos resultantes se aplican a V. El mecanismo de múltiples cabezas realiza esta operación por separado en distintos subespacios de proyección y después combina los resultados. Estos nombres describen la función de los vectores en el cálculo; no implican que el modelo posea módulos de «preguntas», «memoria» o «comprensión» que se correspondan directamente con la cognición humana.[1] Attention Is All You Need
3. Las cifras de rendimiento deben conservar su contexto experimental
El artículo original informa de que Transformer big alcanzó 28.4 BLEU en el experimento de traducción del inglés al alemán de WMT 2014. Esta cifra corresponde a una configuración específica de datos, tokenización, entrenamiento, decodificación y evaluación; no demuestra las capacidades de los modelos de lenguaje modernos de propósito general. Este artículo no compara las puntuaciones de inglés a francés entre distintos trabajos: los resúmenes, las tablas y el cuerpo de las versiones accesibles presentan formulaciones diferentes, y mezclarlas produciría conclusiones con una precisión injustificada.[1] Attention Is All You Need
4. Por qué los contextos largos son costosos
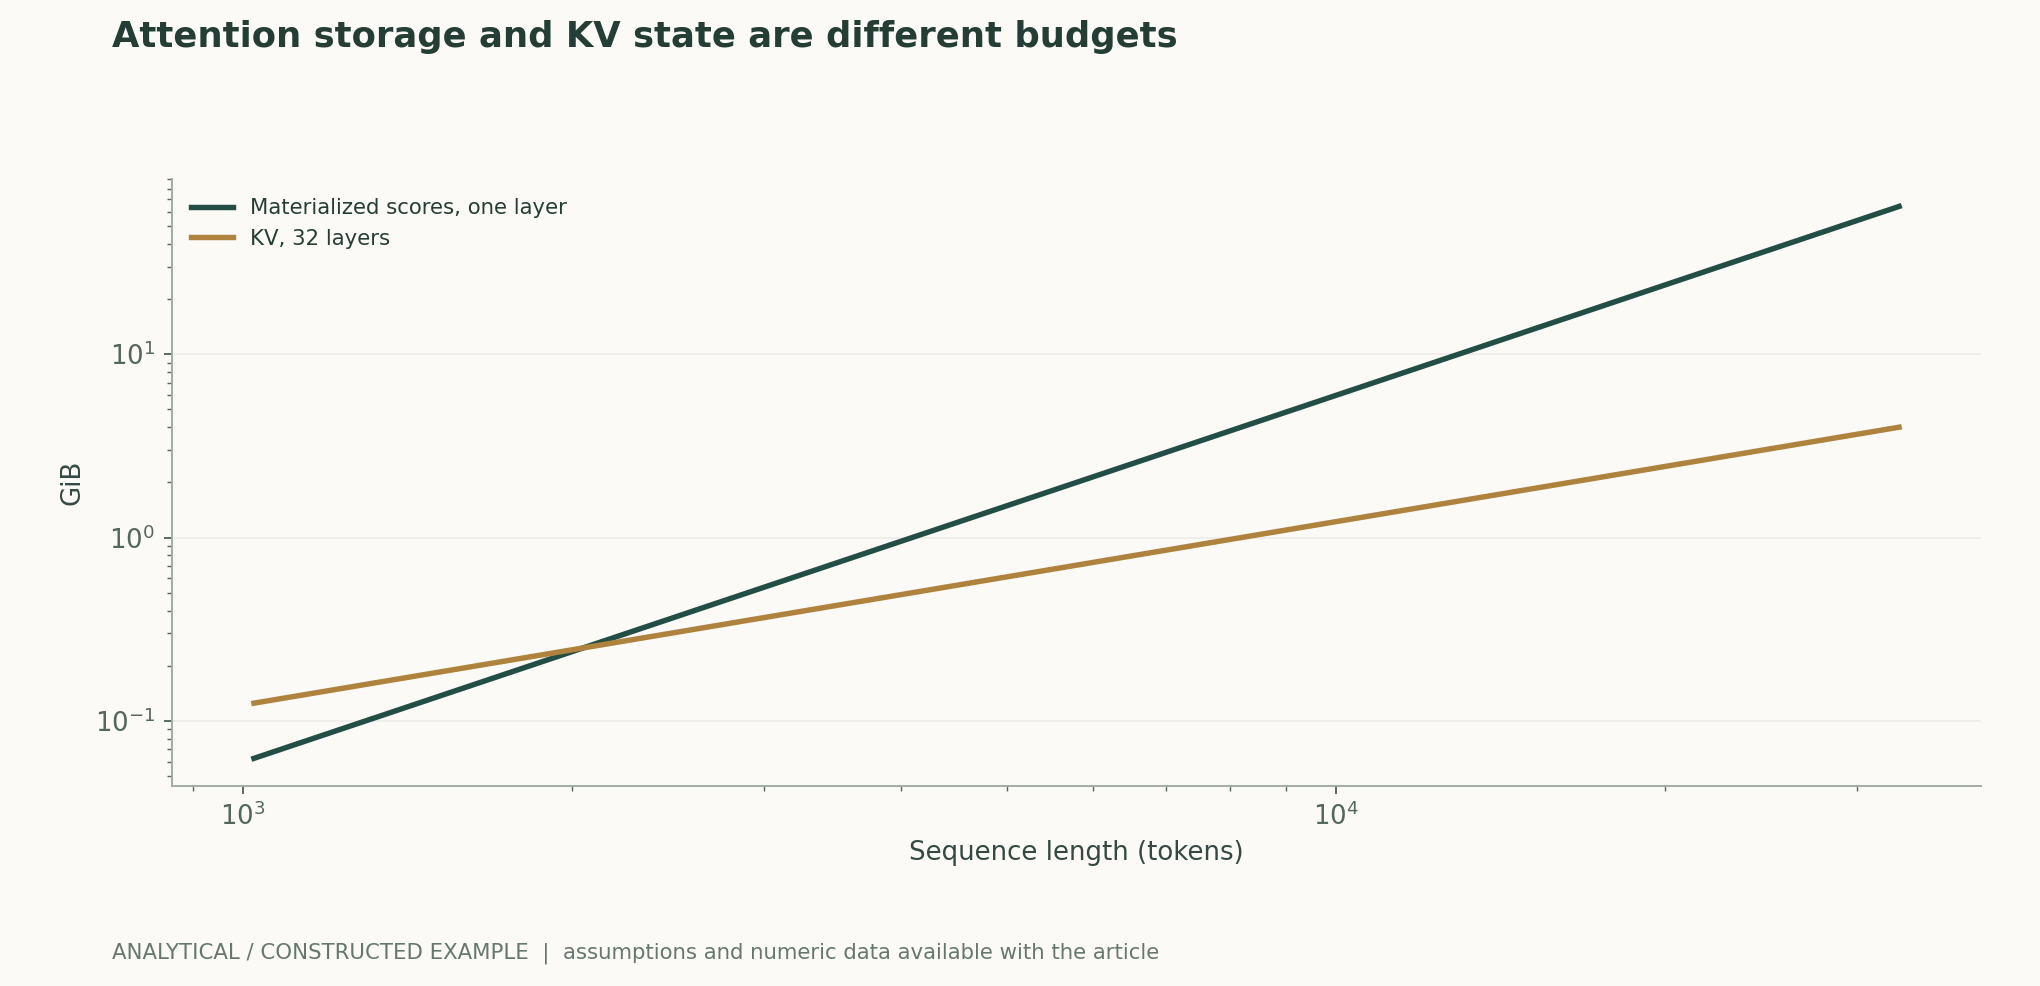
La atención completa establecepares en una secuencia de longitud n. Si se almacenan explícitamente puntuaciones float32 para una sola capa y una sola cabeza, el número de bytes es, y duplicar la longitud cuadruplica este término. La figura 2 de esta versión utiliza otra configuración explícita: puntuaciones FP16 de 32 cabezas, comparadas por separado con una caché de 32 capas y 8 cabezas KV; estos dos cálculos no deben confundirse con un único pico de memoria del dispositivo. Los gradientes, las proyecciones, las activaciones y los espacios de trabajo del kernel deben contabilizarse por separado.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
5. Dos optimizaciones responden a preguntas diferentes
Longformer modifica qué posiciones deben interactuar y procesa documentos largos mediante ventanas locales y atención global selectiva. FlashAttention, en cambio, reorganiza el cálculo en función de la jerarquía de memoria y utiliza la división en bloques y la fusión para reducir los accesos a la memoria del dispositivo de alto ancho de banda, preservando la atención exacta que define. El primero ajusta la estructura de conexiones; el segundo optimiza la forma de ejecutar el mismo cálculo. La optimización de E/S no debe describirse como la eliminación de todo el cálculo cuadrático.[3] Longformer: The Long-Document Transformer[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
6. Un ejemplo analítico verificable
Como ejemplo de contabilización de puntuaciones float32 para una sola capa y una sola cabeza, las longitudes 512, 1024, 2048 y 4096 requieren, respectivamente, 1, 4, 16 y 64 MiB,bytes. Esto difiere de la configuración de la figura 2 de esta versión; las cifras proceden de fórmulas, no de mediciones en GPU. Si la implementación procesa los datos por bloques sin volver a escribir todas las puntuaciones en la memoria de alto ancho de banda, el pico real cambiará; por tanto, debe comprobarse la estrategia de ejecución antes de interpretar la tendencia.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
7. Cómo comparar un método «más rápido»
Este artículo recomienda informar por separado de la longitud de las muestras de entrenamiento, el tamaño del lote, la precisión, el dispositivo, el calentamiento, el rendimiento de procesamiento, el tiempo hasta el primer token y el pico de memoria del dispositivo, y comparar bajo un mismo objetivo de calidad. Si un método trunca el contexto y otro conserva toda la entrada, la diferencia de velocidad incluye un cambio en la tarea; si uno utiliza un kernel fusionado y otro una implementación básica, tampoco puede atribuirse toda la diferencia a la arquitectura. Esta es una recomendación de diseño experimental, no un nuevo resultado experimental de este artículo.作者分析与复核建议 / Author analysis
Un límite computacional fácil de pasar por alto
El término de las puntuaciones de atención solo describe las interacciones entre posiciones; las proyecciones y las operaciones de propagación hacia delante por posición tienen sus propios costes computacionales. Para una longitud de secuencia fija, aumentar la dimensión oculta modifica el peso relativo de estos términos; para una dimensión fija, alargar la secuencia incrementa la importancia de los emparejamientos entre posiciones. Por tanto, la afirmación «la atención tiene complejidad cuadrática» no basta para predecir la proporción del tiempo que consume cada parte del modelo completo. Primero deben especificarse las dimensiones del modelo y las entradas, y después interpretarse los resultados reales del perfilado.作者分析与复核建议 / Author analysis
8. Estadísticos suficientes para softmax por bloques
Para una fila de puntuaciones, calcular directamente la suma de exponenciales puede provocar fácilmente un desbordamiento; restar el máximo solo cambia la representación de la normalización, no las probabilidades. Al procesar un bloque nuevo, no es necesario conservar todas las puntuaciones anteriores: basta con mantener el máximo acumulado m, el denominador de normalización l y la suma ponderada u antes de dividirla por el denominador. Una vez que los bloques anterior y nuevo se expresan respecto del nuevo máximo común m′, los acumuladores anteriores se reescalan mediante exp(m−m′). El denominador y el numerador se transforman simultáneamente, y finalmente u/l proporciona la salida de esa fila. Esta derivación explica por qué reducir las transferencias de ida y vuelta a la memoria del dispositivo no exige modificar las conexiones de atención; sin embargo, el orden de suma en coma flotante cambia, de modo que la equivalencia numérica debe seguir verificándose dentro de una tolerancia acordada.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
9. La memoria de entrenamiento y la caché de decodificación deben modelarse por separado
El almacenamiento explícito de puntuaciones crece con el número de pares de posiciones; la caché KV, en cambio, conserva las claves y los valores de las posiciones anteriores en cada capa. Suponiendo L capas, n posiciones, h_kv cabezas KV, una dimensión d_h por cabeza y b bytes por escalar, la caché ocupa aproximadamente 2Lnh_kv d_h b. Esta expresión no incluye los pesos, los espacios de trabajo ni la fragmentación del asignador. Reducir el número de cabezas KV puede disminuir este término, pero no permite afirmar que las operaciones de atención durante el entrenamiento disminuyan en la misma proporción. Deben perfilarse por separado el prefill de prompts largos, la decodificación en pasos cortos y las solicitudes concurrentes, en lugar de informar únicamente de una media global de tokens/s.[1] Attention Is All You Need[2] FlashAttention: Fast and Memory-Efficient Exact Attenti
10. Por qué los cuellos de botella computacionales se desplazan con la carga de trabajo
En un modelo roofline idealizado, el tiempo de ejecución está acotado inferiormente por max(F/capacidad de cálculo,B/ancho de banda), donde F es el número de operaciones y B la cantidad de bytes realmente transferidos. La fusión y la división en bloques afectan principalmente a B; reducir las conexiones afecta principalmente a F y a la capacidad expresiva del modelo. Los kernels reales también están condicionados por el lanzamiento, la sincronización, la ocupación y las formas de los tensores, por lo que esta cota inferior no es un predictor del rendimiento. Por ejemplo, aumentar el tamaño del lote puede amortizar las lecturas de pesos, pero agotar antes la capacidad de KV; el crecimiento de la secuencia también puede cambiar la división óptima en bloques. La afirmación de que «el cuello de botella se ha desplazado» debe sustentarse en el perfilado del dispositivo, en lugar de inferir factores de aceleración directamente de la complejidad asintótica.[2] FlashAttention: Fast and Memory-Efficient Exact Attenti[3] Longformer: The Long-Document Transformer
11. Representar relaciones a larga distancia no implica automáticamente poder utilizarlas
La codificación posicional determina cómo intervienen las posiciones relativas en las puntuaciones de correspondencia; el patrón de conexiones determina si la información puede llegar a su destino; y los datos de entrenamiento y la tarea determinan si el modelo utiliza realmente la evidencia. La construcción rotacional de RoPE permite expresar desplazamientos relativos mediante productos internos, pero esto por sí solo no garantiza la fiabilidad más allá de las longitudes de entrenamiento. La verificación con textos largos debe, como mínimo, variar por separado la posición de la evidencia, la cantidad de distractores y la distancia entre las evidencias que deben combinarse, y comprobar si aparecen atajos basados únicamente en indicios locales. Deben comunicarse por separado el límite de longitud, la capacidad de aceptar entradas y el contexto efectivo para completar la tarea.[4] RoFormer: Enhanced Transformer with Rotary Position Emb[3] Longformer: The Long-Document Transformer
Fórmulas y derivaciones fundamentales
(1) m es la puntuación máxima de las posiciones ya procesadas y l es el denominador de normalización correspondiente. El bloque nuevo actualiza primero la referencia común y después acumula, por lo que no es necesario conservar la matriz de puntuaciones anterior.
LaTeX
m'=\max(m,\max_j s_j),\quad l'=e^{m-m'}l+\sum_j e^{s_j-m'}(2) u es el valor ponderado antes de dividirlo por el denominador. El numerador y el denominador deben reescalarse simultáneamente; sumar únicamente las salidas normalizadas de cada bloque hace que se pierdan los pesos relativos entre bloques y no permite obtener la atención completa.
LaTeX
u'=e^{m-m'}u+\sum_j e^{s_j-m'}v_j,\qquad o=u'/l'(3) Esta es la ocupación analítica de los escalares almacenados en caché, no la memoria del dispositivo utilizada por todo el proceso de inferencia. El tamaño del lote, el uso compartido entre solicitudes, los bloques de páginas y los metadatos de cuantización deben contabilizarse por separado.
LaTeX
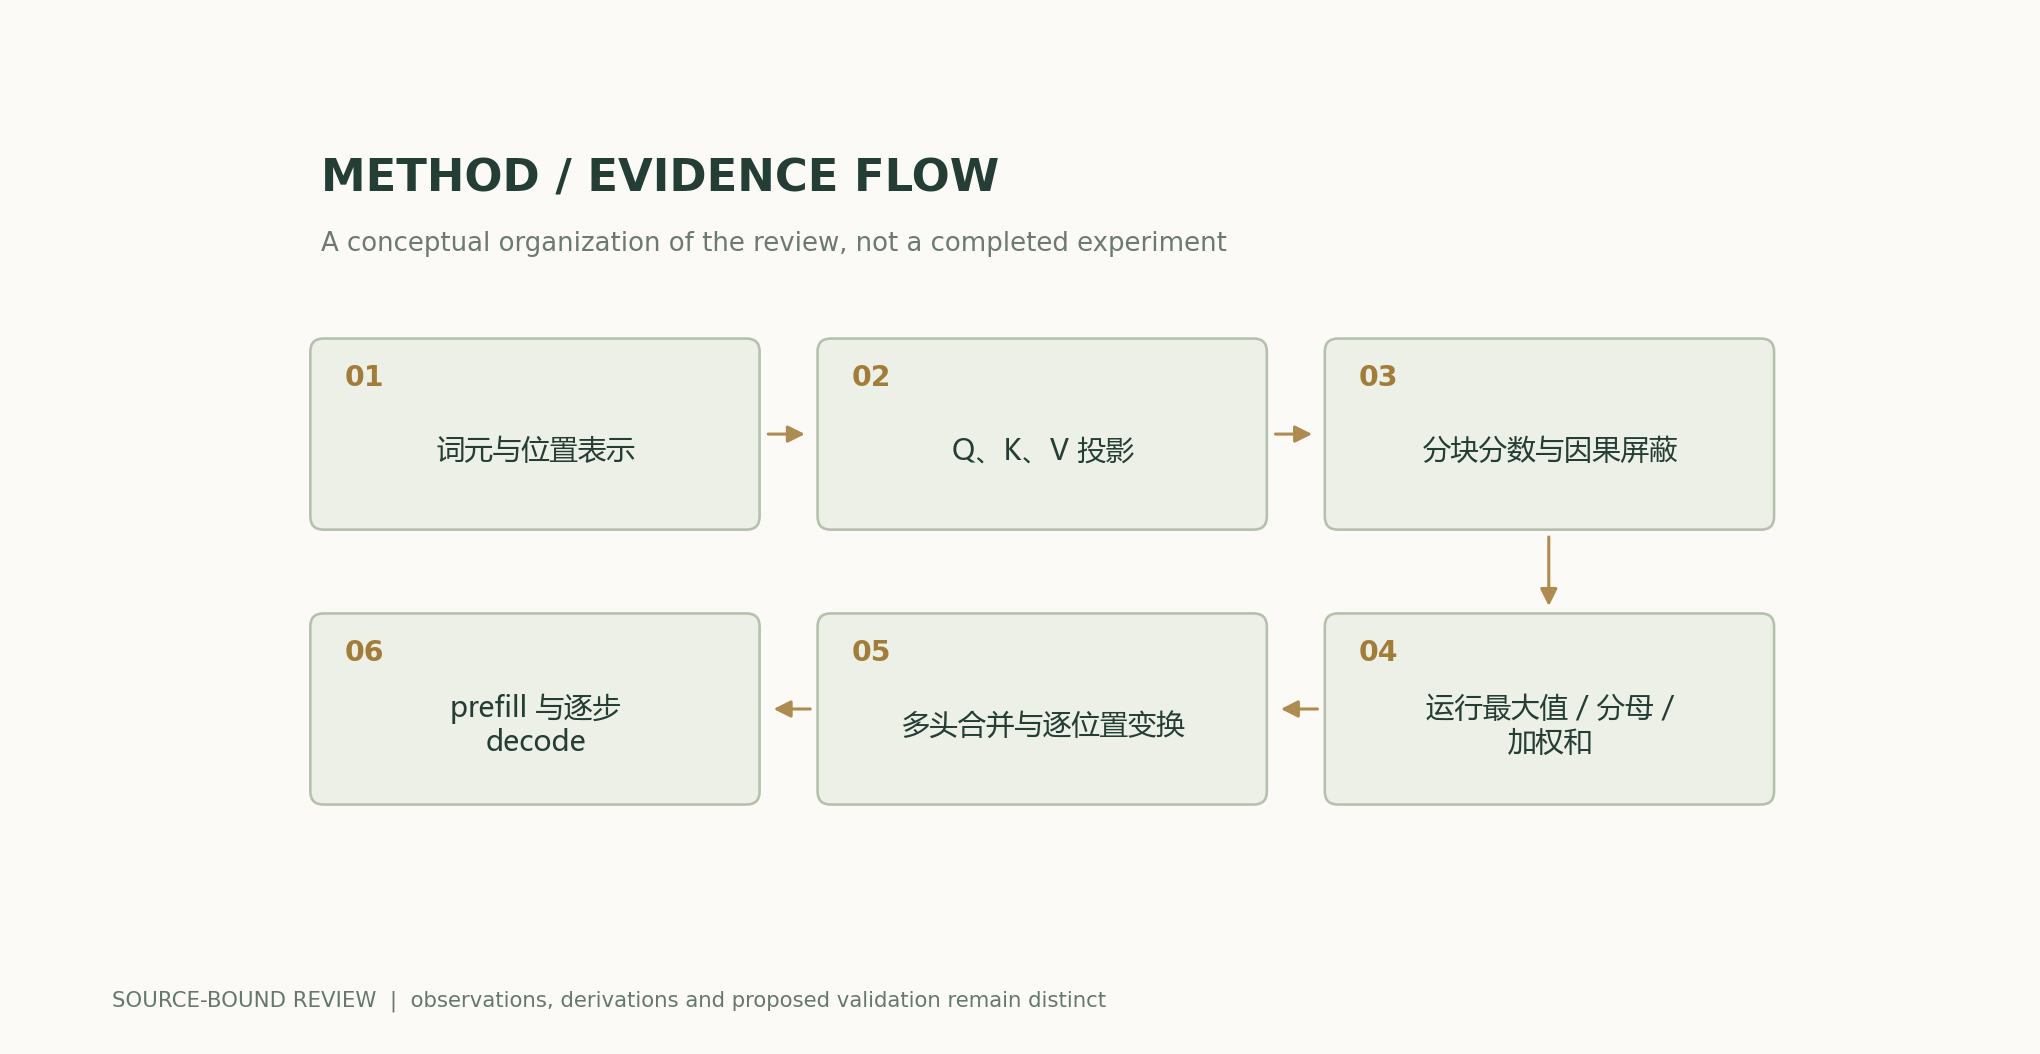
M_{\mathrm{KV}}=2Lnh_{\mathrm{kv}}d_hbFlujo metodológico y de evidencia
Gráficos analíticos y ejemplos numéricos
Ejemplo resuelto cuyo cálculo puede reproducirse
Con 8192 tokens, la matriz de puntuaciones de una sola capa con 32 cabezas ocupa 4 GiB; la caché de 32 capas y 8 cabezas KV ocupa 1 GiB. Sus ciclos de vida son distintos, por lo que esta figura no puede interpretarse como una medición del pico de memoria del dispositivo ni como una prueba de velocidad de FlashAttention.
Comparación de métodos
| Método o valoración | Variables controladas y mediciones | Condiciones de fallo e interpretación |
|---|---|---|
| Atención exacta por bloques | Mantener fijos los pesos, la máscara, la precisión y la entrada; comparar los errores de las salidas y los gradientes | Los distintos órdenes de las operaciones en coma flotante requieren tolerancia; la equivalencia no debe interpretarse como patrones de bits idénticos |
| Conectividad dispersa | Mantener fijos el entrenamiento y el objetivo de calidad; variar la ventana y las posiciones globales | Una vez eliminadas conexiones, ya no se trata del mismo operador |
| Optimización de la caché KV | Informar por separado del prefill, la decodificación, el tamaño del lote y la longitud máxima residente | Una caché menor no implica que todas las fases sean más rápidas |
| Ampliación del contexto largo | Estratificar según la posición de la evidencia y la distancia entre las evidencias que deben combinarse; mantener controles con textos cortos | Aceptar correctamente una entrada larga no equivale a completar una tarea de largo alcance |
Plan de verificación y experimentación
- Fijar un conjunto de pesos, una secuencia de tokens, una máscara y una semilla aleatoria; registrar la precisión, el dispositivo y la versión del kernel, y desactivar las sustituciones automáticas por otras implementaciones que modificarían el objeto de comparación.
- Comparar primero los errores absolutos y relativos de las salidas de la pasada hacia delante, la pérdida y los gradientes, utilizando como referencia un cálculo de pequeñas dimensiones y mayor precisión cuando sea necesario.
- Explorar por separado distintos valores de longitud de secuencia y tamaño del lote; realizar un calentamiento en cada punto y después medir el tiempo con sincronización del dispositivo, registrando por separado el coste de la compilación inicial.
- Registrar por separado el tiempo hasta el primer token del prefill y la distribución de la latencia por token de la decodificación, sin ocultar las diferencias entre fases con una media global.
- Medir conjuntamente el pico de memoria del dispositivo utilizada por el proceso, la memoria reservada por el asignador y la ocupación de KV; los gráficos analíticos solo ofrecen una referencia del orden de magnitud de componentes individuales.
- Incluir tareas cuya evidencia se sitúe al principio, en el medio y al final; si el método más rápido modifica las conexiones, deben comunicarse también los cambios en la calidad de la tarea.
Ámbito de aplicación y limitaciones
- Las estimaciones analíticas de almacenamiento no incluyen los gradientes, los pesos ni la fragmentación del asignador.
- El tiempo de ejecución debe medirse en el dispositivo de destino y no puede obtenerse directamente de las curvas del gráfico.
- Los distintos patrones de conexión deben compararse bajo las mismas restricciones de calidad.
- Este artículo no entrenó un modelo nuevo ni añadió una nueva prueba de rendimiento.
Correspondencia entre afirmaciones y fuentes primarias
- Attention Is All You NeedVaswani et al. · 2017-06-12v7; sections 3-4; Table 2 (EN-DE only)
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-AwarenessDao et al. · 2022-05-27v1; sections 2-3
- Longformer: The Long-Document TransformerBeltagy et al. · 2020-04-10v2 abstract and architecture description
- RoFormer: Enhanced Transformer with Rotary Position Embedding, , , , , · 2021-04-20Abstract; 原文方法、理论和实验章节见作者原始论文链接
Cita y exportación del manuscrito
BibTeXRISCSL JSONTXTJSON del artículo
Autoría, versión y fuentes
Revisión de investigación asistida por IA; Codex (IA) redactó el texto y realizó las derivaciones analíticas a partir de la bibliografía primaria indicada. Este sitio no dispone de registros de revisión por pares independiente ni de experimentos originales con modelos para este artículo.
Revisión del rendimiento del lector: también se reutilizan las páginas ya leídas cuando una solicitud HEAD reciente devuelve 200 y el ETag no cambia. El cuerpo del texto, las fórmulas, las fuentes y los datos de los gráficos científicos conservan el contenido de la versión anterior.
La portada conceptual se presenta por separado de los diagramas científicos; los gráficos científicos se calculan a partir de fórmulas públicas y supuestos explícitos, y todos los resultados de los artículos originales se atribuyen a sus fuentes.
Autoría, versiones e historial de correcciones · /guides/transformer-attention/v5/
Fuentes de la portada y de las figuras científicas · Datos, fuentes y supuestos · Historial de publicación y versiones
Revisión de la fuente: 6251a250b27bb8b449f59b392f81abd355383770