
Resumen
El software concurrente se rige tanto por el modelo de memoria del lenguaje de programación como por el comportamiento permitido de la máquina de destino. Tratar cualquiera de estas capas como un simple entrelazado puede ocultar errores, mientras que utilizar un resultado observado en el hardware para justificar un programa fuente con carreras de datos puede ser igualmente incorrecto. Esta revisión conecta el modelo x86-TSO, los fundamentos del modelo de concurrencia de C++ y su formalización mediante una prueba litmus de almacenamiento en búfer de escrituras. Un modelo operacional finito enumera ejecuciones secuencialmente consistentes y con búferes, y demuestra por qué dos lecturas de cero quedan excluidas en un modelo y se permiten en el otro. Distinguimos entre atomicidad, orden, visibilidad y progreso, y mostramos cómo el razonamiento con release/acquire depende del valor efectivamente observado. Las figuras muestran los resultados permitidos y el crecimiento combinatorio de las planificaciones sin atribuir probabilidades de ocurrencia en el hardware.
Dos modelos median entre el programador y el resultado
Un programador escribe operaciones en el código fuente, un compilador las transforma y un procesador ejecuta instrucciones de máquina bajo un modelo de memoria arquitectónico. El lenguaje fuente y la máquina no tienen por qué exponer comportamientos idénticos. Una compilación correcta debe preservar el contrato del lenguaje utilizando los mecanismos de ordenación disponibles en el destino.
Esta visión por capas es importante porque un experimento de hardware no puede legitimar una carrera de datos en el lenguaje fuente. Un programa puede parecer fiable en un procesador y aun así tener comportamiento indefinido en el nivel del lenguaje. A la inversa, un programa fuente con operaciones atómicas puede exponer legítimamente resultados que sorprendan a quien espere que todas las operaciones participen en un único orden secuencial global. Una explicación rigurosa debe identificar la versión del lenguaje, los tipos de operaciones, las anotaciones de orden, la correspondencia establecida por el compilador y el modelo de máquina antes de interpretar un resultado. [1], [2], [3]
Qué establecen los artículos fundacionales
Sewell y sus colegas presentan un modelo preciso de x86-TSO con una explicación intuitiva basada en búferes de escritura y fundamentos comprobados por máquina. Boehm y Adve explican decisiones clave del modelo de concurrencia de C++, incluido el tratamiento de las carreras de datos y el objetivo de ofrecer garantías útiles para los programas libres de carreras. Batty y sus colegas formalizan la concurrencia de C++ y analizan la relación entre la semántica del lenguaje y su implementación.
Estos artículos motivan un razonamiento preciso, en lugar de afirmar que un modelo histórico constituye una especificación actual completa. Nuestro ejemplo ejecutable es un modelo operacional deliberadamente restringido de dos escrituras, dos lecturas y vaciados FIFO de búferes de escritura. Excluye las instrucciones de lectura-modificación-escritura, los accesos de tamaños mixtos y la memoria de dispositivos, y no abarca todos los detalles del comportamiento indefinido en el nivel del lenguaje. Sus resultados pertenecen a ese modelo, no a todos los procesadores que llevan una etiqueta arquitectónica conocida. [1], [2], [3]
La prueba litmus de almacenamiento en búfer de escrituras
Se inicializan x e y a cero. El hilo A escribe uno en x y después lee y en r_A. El hilo B escribe uno en y y después lee x en r_B. Bajo consistencia secuencial, las cuatro operaciones deben tener un orden total compatible con el orden de programa de cada hilo. Si r_A es cero, la lectura de A precede a la escritura de B. Si r_B es cero, la lectura de B precede a la escritura de A. Al combinar esas restricciones con los dos órdenes de programa se crea un ciclo imposible.
Por tanto, ambas lecturas no pueden ser cero en el modelo secuencialmente consistente. El argumento es una demostración sobre una relación de orden, no una afirmación de que las escrituras se propaguen instantáneamente en el hardware físico. El apéndice enumera los seis entrelazados que preservan el orden de las dos operaciones de cada hilo y confirma la exclusión. La enumeración ofrece un complemento concreto al argumento del ciclo.
Los búferes producen una ejecución permitida diferente
En el modelo con búferes, una escritura entra primero en la cola del hilo que la emite y se hace visible para el otro hilo cuando se vacía a la memoria compartida. Una lectura de una dirección no relacionada puede ejecutarse mientras la escritura anterior permanece en el búfer. Por tanto, ambas escrituras pueden entrar en sus colas, ambas lecturas pueden leer los ceros iniciales de la memoria compartida y ambas colas pueden vaciarse después.
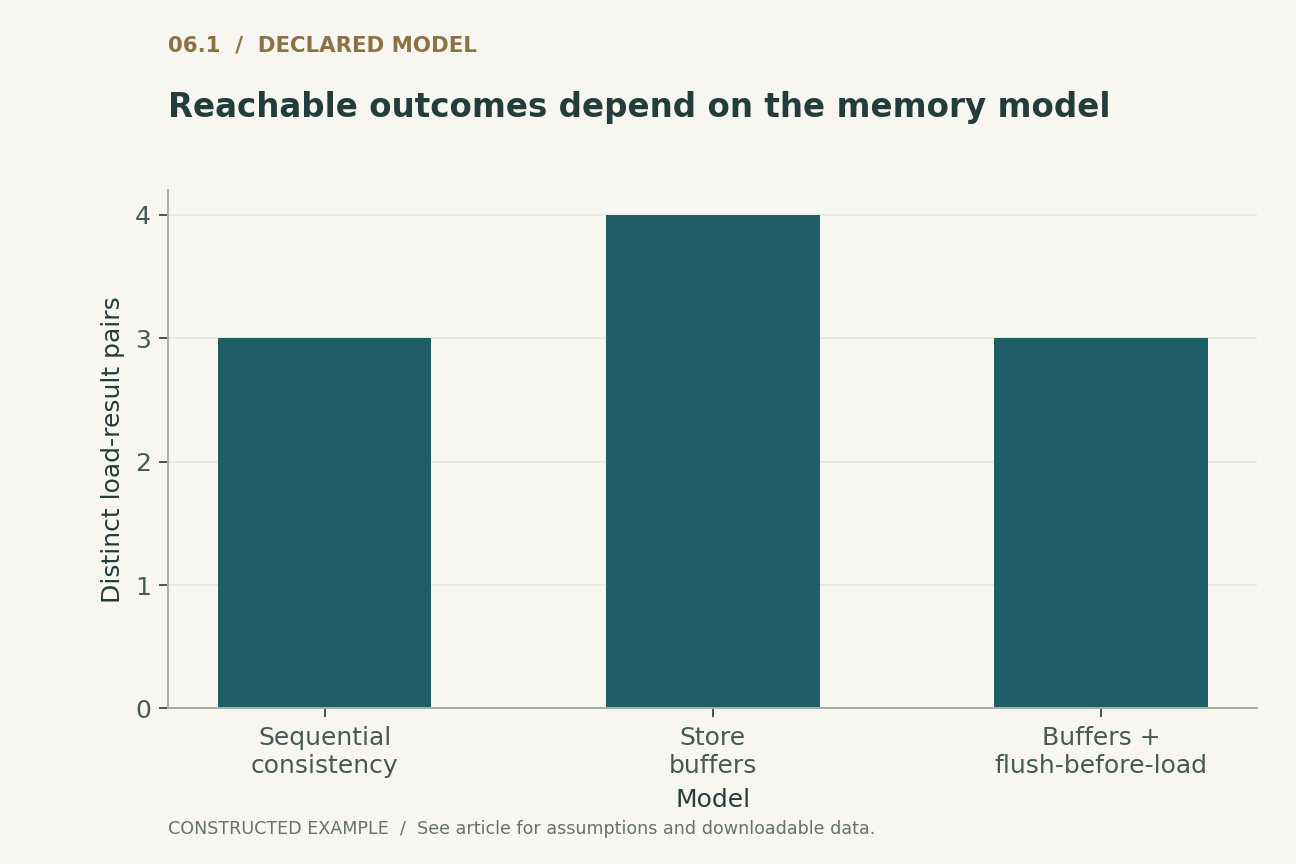
Esta ejecución testigo no requiere que un procesador ejecute instrucciones arbitrarias fuera de orden en el nivel del código fuente. Surge de la distinción entre emitir una escritura y hacerla visible. El comprobador finito añade un evento de vaciado por hilo, exige que cada vaciado siga a su escritura y explora todos los órdenes de eventos legales. Confirma cuatro pares de resultados de lectura alcanzables en este modelo restringido, frente a tres bajo consistencia secuencial. No asigna frecuencias físicas a esos resultados.
La atomicidad y el orden responden a preguntas distintas
Una variable atómica proporciona reglas que impiden que un acceso se comporte como una lectura o escritura ordinaria fragmentada dentro del contexto especificado por el lenguaje. La ordenación controla qué relaciones entre accesos deben cumplirse. Por tanto, las operaciones atómicas con ordenación débil pueden evitar una carrera de datos sin hacer que toda observación entre hilos sea secuencialmente consistente.
Una revisión útil separa varias afirmaciones: el valor no está fragmentado; las actualizaciones de un objeto tienen un orden de modificación coherente; un lector observa determinadas escrituras anteriores; y alguna operación termina finalmente. Ninguna es sinónimo de las demás. Un algoritmo libre de bloqueos puede satisfacer una propiedad de progreso del sistema en su conjunto y, al mismo tiempo, permitir que un hilo sufra inanición. Una anotación de orden de memoria puede establecer visibilidad sin imponer equidad en la planificación. Las comparaciones de rendimiento deben preservar los mismos contratos de corrección y progreso antes de que sus costes puedan compararse de manera significativa.
Release y acquire necesitan una observación que los conecte
Un patrón habitual de publicación escribe los datos y después publica un indicador con semántica release. Un lector carga el indicador con semántica acquire y, si observa la publicación correspondiente tal como la define el lenguaje, puede utilizar la relación de sincronización resultante para razonar sobre los datos. Las palabras release y acquire por sí solas no crean una relación entre operaciones arbitrarias.
Si el lector observa un valor anterior del indicador o accede a los datos antes de la sincronización pertinente, el argumento previsto puede fallar. Reutilizar un indicador a lo largo de varias vidas de objetos introduce preguntas adicionales sobre qué publicación se observó. En una revisión, conviene dibujar las relaciones reales reads-from y de orden, y explicitar los supuestos sobre la vida de los objetos. Esto resulta más fiable que rodear el código de anotaciones aparentemente fuertes y suponer que de ellas se deduce la dependencia prevista. [2], [3]
Una barrera debe cerrar la vía pertinente
Una barrera tiene significado dentro de un modelo de memoria específico y en relación con las operaciones que la rodean. No es una orden universal para hacer visibles todas las escrituras anteriores en todas partes. En el modelo simplificado de búferes de escritura, exigir que la escritura de cada hilo se vacíe antes de su lectura posterior elimina la ejecución testigo con ambas lecturas a cero. Se trata de una transformación explícita del modelo cuyo efecto puede enumerarse.
Trasladar una condición así a código fuente real requiere las reglas del lenguaje y la correspondencia del compilador con el destino. Sustituir una relación de sincronización ausente por una instrucción específica del hardware dentro de código que sigue teniendo carreras puede no restablecer un argumento válido en el nivel del lenguaje. La unidad de análisis correcta es toda la trayectoria desde la semántica del código fuente, pasando por el código generado, hasta la ejecución permitida en el hardware. Una prueba litmus es valiosa precisamente porque mantiene esa trayectoria lo bastante pequeña como para inspeccionarla.
Por qué los recuentos de planificaciones no son probabilidades
La primera figura cuenta los pares de resultados de lectura permitidos bajo tres variantes declaradas: consistencia secuencial, el modelo con búferes y el modelo con búferes y vaciado de escrituras antes de las lecturas. Estos recuentos muestran una diferencia semántica. No son estimaciones de la frecuencia con la que una CPU mostrará cada resultado. La planificación de un procesador real, el estado de la caché, la contención y la salida del compilador determinan una distribución empírica.
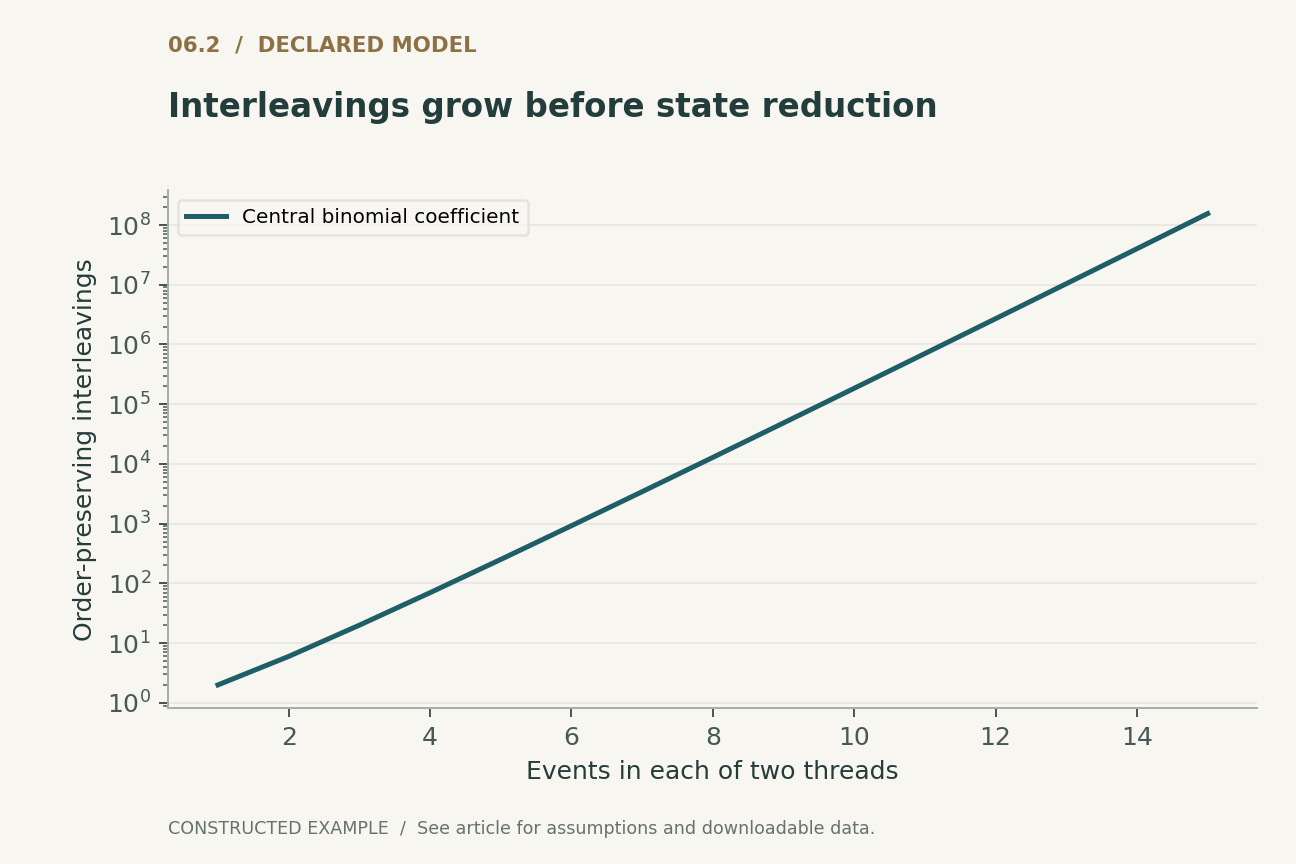
La segunda figura muestra el número de entrelazados de dos hilos con m operaciones ordenadas cada uno, igual al coeficiente binomial central. Para m igual a diez, existen 184,756 entrelazados de este tipo antes de introducir eventos de memoria adicionales. La reducción dinámica por orden parcial y los métodos simbólicos pueden evitar examinar todas las planificaciones equivalentes. La curva explica la necesidad de esos métodos; no es una curva medida del tiempo de ejecución de un comprobador.
Las pruebas deben preservar los límites de observación
Un entorno de pruebas litmus de hardware debe impedir que el compilador elimine o transforme el experimento de formas incompatibles con la semántica prevista del código fuente. Debe registrar el código generado exacto, la versión y las opciones del compilador, el modelo de procesador, las condiciones de funcionamiento, el número de repeticiones y todos los resultados observados. La ausencia de un resultado en una ejecución finita no demuestra que la arquitectura lo prohíba.
Para el código de aplicaciones, las pruebas también deben abarcar la vida de los objetos, la recuperación de memoria, la cancelación y el flujo de control excepcional. Estos aspectos suelen invalidar un argumento de publicación que, por lo demás, es correcto. Un control negativo útil elimina deliberadamente la relación de sincronización en un modelo donde se conoce la ejecución testigo resultante. La prueba demuestra entonces sensibilidad a la propiedad investigada, en lugar de limitarse a ejecutar un bucle de muchas iteraciones que siempre parece tener éxito.
Conclusión: especificar las ejecuciones permitidas
La pregunta productiva en programación concurrente no es si el código suele ejecutarse en orden, sino qué ejecuciones permiten el lenguaje y el destino, y cuáles de ellas puede tolerar el algoritmo. El ejemplo de almacenamiento en búfer de escrituras hace visible esta diferencia con cuatro operaciones y dos eventos de vaciado adicionales.
Los modelos de memoria precisos permiten implementaciones orientadas al rendimiento sin depender de creencias transmitidas informalmente. Su beneficio se pierde cuando la atomicidad, el orden, la visibilidad y el progreso se fusionan en una noción vaga de seguridad entre hilos. Un argumento defendible identifica cada relación necesaria, comprueba la frontera entre compilador y hardware y utiliza las pruebas como observaciones de ese contrato, en lugar de como sustitutos de él.
Ejecutado localmente · Alcance acotado
Modelos litmus enumerados de SC, búferes de escritura y barreras
Modelos operacionales restringidos; no se realizó ninguna prueba de hardware, de implementación de C++ ni de conformidad con un modelo de memoria.
Se superaron 3 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar la ejecución testigo registrada
{
  "sc": [
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "buffered": [
    [
      0,
      0
    ],
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "fenced": [
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "orders": [
    6,
    80,
    20
  ]
}
Descargar los 20 ejemplos ejecutablesLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) El ciclo que sería necesario para que ambas lecturas devolvieran cero bajo consistencia secuencial; ningún orden total estricto puede contenerlo.
(2) Una ejecución testigo permitida en el modelo declarado de búferes de escritura; F denota un vaciado a la memoria compartida.
(3) Dos hilos realizan cada uno m eventos ordenados internamente; se cuentan los entrelazados sintácticos antes de la reducción por equivalencia.
(4) Conjuntos de resultados de lectura para la prueba litmus específica de dos hilos y los modelos operacionales restringidos utilizados aquí.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Pregunta | Contrato pertinente | Inferencia errónea habitual |
|---|---|---|
| ¿Es atómico un acceso? | Semántica de acceso del lenguaje y de la arquitectura | Todos los accesos están ordenados globalmente |
| ¿Se han publicado los datos? | Una relación de sincronización justificada | Cualquier acquire observa cualquier release |
| ¿Es posible un resultado? | Modelo formal de ejecuciones permitidas | Un resultado no observado está prohibido |
| ¿Termina una operación? | Supuestos de progreso y planificación | El orden de memoria garantiza la equidad |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de un sistema de producción ni de hardware. Los modelos finitos ejecutados por separado están documentados en las comprobaciones ejecutables.
- Especificar los modelos exactos de origen y destino antes de ejecutar una prueba litmus.
- Enumerar como control los historiales secuencialmente consistentes de la prueba de almacenamiento en búfer de escrituras.
- Añadir eventos explícitos de escritura y vaciado, y conservar la ejecución testigo con ambas lecturas a cero.
- Añadir la condición declarada de vaciado antes de la lectura y verificar que la ejecución testigo desaparece.
- En los experimentos de hardware, conservar el código generado y los metadatos del entorno.
- Revisar las propiedades de vida de los objetos, recuperación de memoria y progreso por separado de la visibilidad.
Qué establecen las fuentes primarias
Peter Sewell, Susmit Sarkar, Scott Owens et al. · 2010 [1]
Contribución. Un modelo preciso de x86-TSO permite razonar más allá de las descripciones informales ambiguas de los procesadores.
Límite. Su modelo completo contiene más detalles que el pequeño ejemplo de búferes presentado aquí.
Localización en la fuente. Resumen y sección sobre la máquina abstracta.
Hans-J. Boehm, Sarita V. Adve · 2008 [2]
Contribución. El diseño de concurrencia de C++ vincula las garantías útiles con las reglas de carreras y de orden en el nivel del lenguaje.
Límite. El comportamiento observado en el hardware no puede justificar un comportamiento indefinido del código fuente.
Localización en la fuente. Resumen y discusión del diseño del modelo de memoria.
Mark Batty, Scott Owens, Susmit Sarkar et al. · 2011 [3]
Contribución. Una descripción formal de la concurrencia de C++ hace explícitas las ejecuciones candidatas y las cuestiones de compilación.
Límite. El artículo se refiere al diseño del lenguaje modelado y a su alcance declarado.
Localización en la fuente. Resumen y relaciones formales de ejecución.
Límites de este análisis
- El modelo local es una abstracción operacional restringida, no el modelo completo x86-TSO ni el estándar completo de C++.
- No se ejecutó ninguna prueba litmus de hardware ni una batería de pruebas de conformidad del compilador.
- Los recuentos de resultados permitidos no implican ninguna medida de probabilidad.
- Los artículos fuente son resultados históricos fundacionales, no una descripción exhaustiva de las arquitecturas actuales.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso a las fuentes y de versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Observa el lector real la publicación necesaria para el argumento happens-before previsto?
- ¿Qué transformación del compilador o supuesto sobre la vida de los objetos podría invalidar el algoritmo?
- ¿Qué garantía de progreso se requiere además de la corrección del orden de memoria?
Referencias
- Peter Sewell, Susmit Sarkar, Scott Owens et al.. x86-TSO: a rigorous and usable programmer's model for x86 multiprocessors. Communications of the ACM (2010). 10.1145/1785414.1785443.
- Hans-J. Boehm, Sarita V. Adve. Foundations of the C++ concurrency memory model. Proceedings of the 29th ACM SIGPLAN Conference on Programming Language Design and Implementation (2008). 10.1145/1375581.1375591.
- Mark Batty, Scott Owens, Susmit Sarkar et al.. Mathematizing C++ concurrency. Proceedings of the 38th annual ACM SIGPLAN-SIGACT symposium on Principles of programming languages (2011). 10.1145/1926385.1926394.
Acceso a la fuente [1]. Registro primario, resumen y texto accesible seleccionado; no se trata de una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [2]. Registro primario, resumen y texto accesible seleccionado; no se trata de una auditoría exhaustiva del texto completo ni del material suplementario.
Acceso a la fuente [3]. Registro primario, resumen y texto accesible seleccionado; no se trata de una auditoría exhaustiva del texto completo ni del material suplementario.
Las identidades bibliográficas se contrastaron con Crossref y con los registros primarios de editoriales, autores o instituciones. Las notas siguientes sobre acceso a las fuentes y versiones describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y revisado técnicamente por el propio Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan el código Python y los archivos CSV. No son mediciones de productos desplegados ni pruebas comparativas de rendimiento reproducidas.
Este borrador local no cuenta con un registro de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables acotados comprueban los pequeños modelos declarados; no constituyen una verificación formal de los sistemas citados.