
要旨
並行ソフトウェアは、プログラミング言語のメモリモデルと、対象マシンが許容する振る舞いの双方に従う。いずれかの層を単純なインターリーブとして扱うと誤りを見逃すおそれがあり、観測されたハードウェアの結果を用いてデータ競合のあるソースプログラムを正当化することも、同様に不健全となりうる。本レビューでは、ストアバッファリングのリトマステストを通じて、x86-TSOモデル、C++並行性モデルの基礎、およびその形式化を結び付ける。有限の操作的モデルによって逐次一貫な実行とバッファを用いる実行を列挙し、二つの読み取りがともにゼロとなる結果が、一方のモデルでは排除され、他方では許容される理由を示す。原子性、順序、可視性、進行性を区別し、リリース/アクワイアによる推論が実際に観測された値に依存することを示す。図は、許容される結果とスケジュールの組合せ的増大を明らかにするものであり、ハードウェア上での発生確率を主張するものではない。
プログラマと結果の間にある二つのモデル
プログラマがソースの操作を書き、コンパイラがそれらを変換し、プロセッサがアーキテクチャのメモリモデルに従って機械命令を実行する。ソース言語とマシンが、同一の振る舞いを外部に示す必要はない。正しいコンパイルは、対象で利用可能な順序制御機構を用いながら、言語の契約を維持しなければならない。
この階層的な見方が重要なのは、ハードウェア実験によってソース言語のデータ競合を合法化することはできないためである。プログラムはあるプロセッサでは信頼できるように見えても、言語レベルでは未定義動作を持ちうる。逆に、アトミック操作を用いたソースプログラムは、すべての操作が単一の大域的な逐次順序に従うと期待する人にとって意外な結果を、正当に示すことがある。厳密な説明では、結果を解釈する前に、言語の版、操作の種類、順序指定、コンパイラの対応付け、マシンモデルを特定しなければならない。 [1], [2], [3]
基礎的論文が確立したこと
Sewellらは、ストアバッファによる直観的説明と機械検査済みの基礎を備えた、精密なx86-TSOモデルを提示している。BoehmとAdveは、データ競合の扱いや、競合のないプログラムに有用な保証を与えるという目標を含め、C++並行性モデルの主要な設計判断を説明している。BattyらはC++の並行性を形式化し、言語の意味論と実装の関係を分析している。
これらの論文は精密な推論の必要性を示すものであり、歴史的な一つのモデルが現在の完全な仕様であると主張するものではない。本稿の実行可能な例は、二つのストア、二つのロード、およびFIFOストアバッファのフラッシュからなる、意図的に制限された操作的モデルである。読み取り・変更・書き込み命令、異なるサイズのアクセスの混在、デバイスメモリ、および言語レベルの未定義動作の完全な詳細は含まない。その結果が当てはまるのは当該モデルであり、馴染みのあるアーキテクチャ名を冠したすべてのプロセッサではない。 [1], [2], [3]
ストアバッファリングのリトマステスト
xとyをゼロに初期化する。スレッドAはxに一をストアし、その後yをr_Aに読み込む。スレッドBはyに一をストアし、その後xをr_Bに読み込む。逐次一貫性の下では、四つの操作すべてに、各スレッドのプログラム順序と整合する全順序が存在しなければならない。r_Aがゼロならば、Aの読み取りはBのストアに先行する。r_Bがゼロならば、Bの読み取りはAのストアに先行する。これらの制約を二つのプログラム順序と組み合わせると、不可能な循環が生じる。
したがって、逐次一貫なモデルでは、両方の読み取りがゼロになることはない。この議論は順序関係についての証明であり、物理的なハードウェア上で書き込みが瞬時に伝播するという主張ではない。付録では、各スレッドの二つの操作の順序を維持する六つのインターリーブを列挙し、この排除を確認する。この列挙は、循環による議論を具体的に補完する。
バッファがもたらす別の許容実行
バッファを用いるモデルでは、ストアはまず発行元スレッドのキューに入り、共有メモリへフラッシュされた時点で他方のスレッドから見えるようになる。先行するストアがバッファ内に残っている間でも、無関係なアドレスへのロードは実行できる。したがって、両方のストアがそれぞれのキューに入り、両方のロードが共有メモリの初期値であるゼロを読み取り、その後で両方のキューがフラッシュされる実行が可能である。
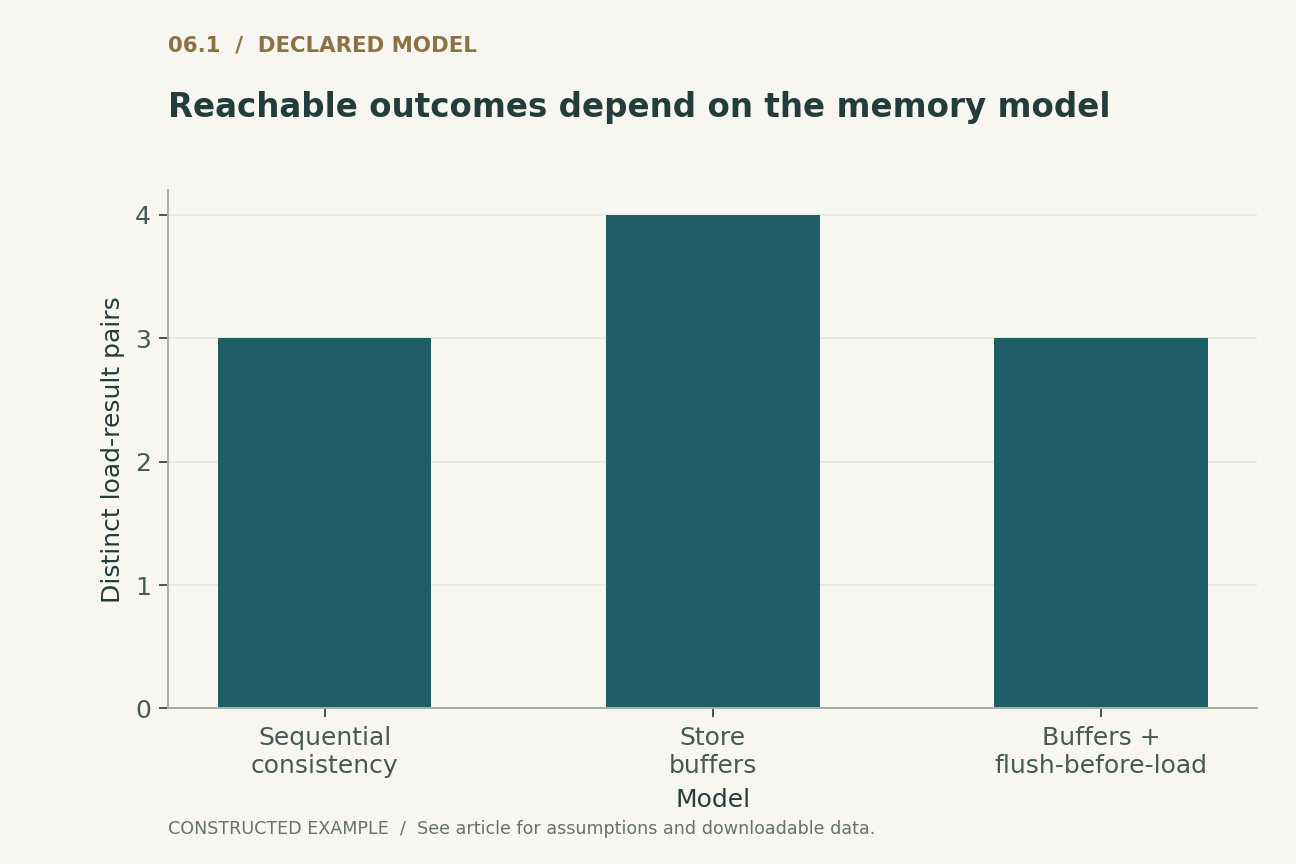
この実行例は、プロセッサがソースレベルで任意の命令を順序外実行することを必要としない。これは、ストアの発行と、そのストアを可視にすることとの違いから生じる。有限検査器は各スレッドに一つのフラッシュイベントを追加し、それぞれのフラッシュが対応するストアの後に起こるよう制約したうえで、合法なイベント順序をすべて探索する。その結果、この制限されたモデルでは四つの読み取り結果の組が到達可能であるのに対し、逐次一貫性の下では三つであることが確認される。これらの結果に物理的な発生頻度を割り当てるものではない。
原子性と順序は異なる問いに答える
アトミック変数は、言語が規定する条件の下で、アクセスが通常の読み取りや書き込みの部分的な分断として振る舞うことを防ぐ規則を提供する。順序制御は、アクセス間でどの関係が成立しなければならないかを定める。したがって、弱い順序指定のアトミック操作は、スレッド間のすべての観測を逐次一貫にすることなく、データ競合を回避できる。
有用なレビューでは、値が部分的に分断されないこと、単一オブジェクトへの更新に整合的な変更順序があること、読み手が特定の先行書き込みを観測すること、そして何らかの操作が最終的に完了することを、それぞれ区別する。いずれも他の主張と同義ではない。ロックフリーアルゴリズムは、システム全体の進行性を満たしながら、あるスレッドの飢餓を許す場合がある。メモリ順序の指定は、スケジューリングの公平性を課すことなく可視性を確立しうる。性能比較でコストを有意義に比較するには、まず同一の正当性と進行性の契約を維持しなければならない。
リリースとアクワイアには両者を結ぶ観測が必要である
一般的な公開パターンでは、ペイロードを書き込んだ後、リリース意味論でフラグを公開する。読み手はアクワイア意味論でフラグをロードし、言語の定義に従って対応する公開を観測した場合、そこから生じる同期関係を用いてペイロードについて推論できる。リリースとアクワイアという語だけで、任意の操作間に関係が生まれるわけではない。
読み手が以前のフラグ値を観測した場合や、必要な同期より前にペイロードへアクセスした場合、意図した議論は成立しない可能性がある。複数のオブジェクトの生存期間にわたってフラグを再利用すると、どの公開を観測したのかという追加の問題が生じる。レビューでは、実際のreads-from関係と順序関係を図示し、生存期間の仮定を明記するべきである。これは、強そうに見える指定をコードの周囲に置き、意図した依存関係が成立すると仮定するよりも信頼できる。 [2], [3]
フェンスは該当する経路を閉じなければならない
フェンスは、特定のメモリモデルの中で、周辺の操作との関係において意味を持つ。あらゆる先行書き込みをあらゆる場所で可視にする普遍的な命令ではない。簡略化したストアバッファモデルでは、各スレッドのストアを後続のロードより前にフラッシュするよう要求すると、両読み取りがゼロとなる実行例は除去される。これは、その効果を列挙によって確認できる、明示的なモデル変換である。
このような条件を実際のソースコードに対応付けるには、言語の規則と、コンパイラによる対象への対応付けが必要である。依然としてデータ競合を含むコードの中で、欠けている同期関係をハードウェア固有の命令に置き換えても、言語レベルで妥当な議論が回復するとは限らない。適切な分析単位は、ソースの意味論から生成コードを経て、許容されるハードウェア実行に至る経路全体である。リトマステストが有用なのは、まさにこの経路を検査可能な小ささに保つためである。
スケジュールの個数が確率ではない理由
最初の図は、逐次一貫性、バッファを用いるモデル、およびロード前にストアをフラッシュするバッファモデルという、明示した三つの変種について、許容される読み取り結果の組を数える。この個数は意味論上の違いを示す。CPUが各結果を示す頻度の推定値ではない。実際のプロセッサのスケジューリング、キャッシュ状態、競合、およびコンパイラ出力が、経験的な分布を決定する。
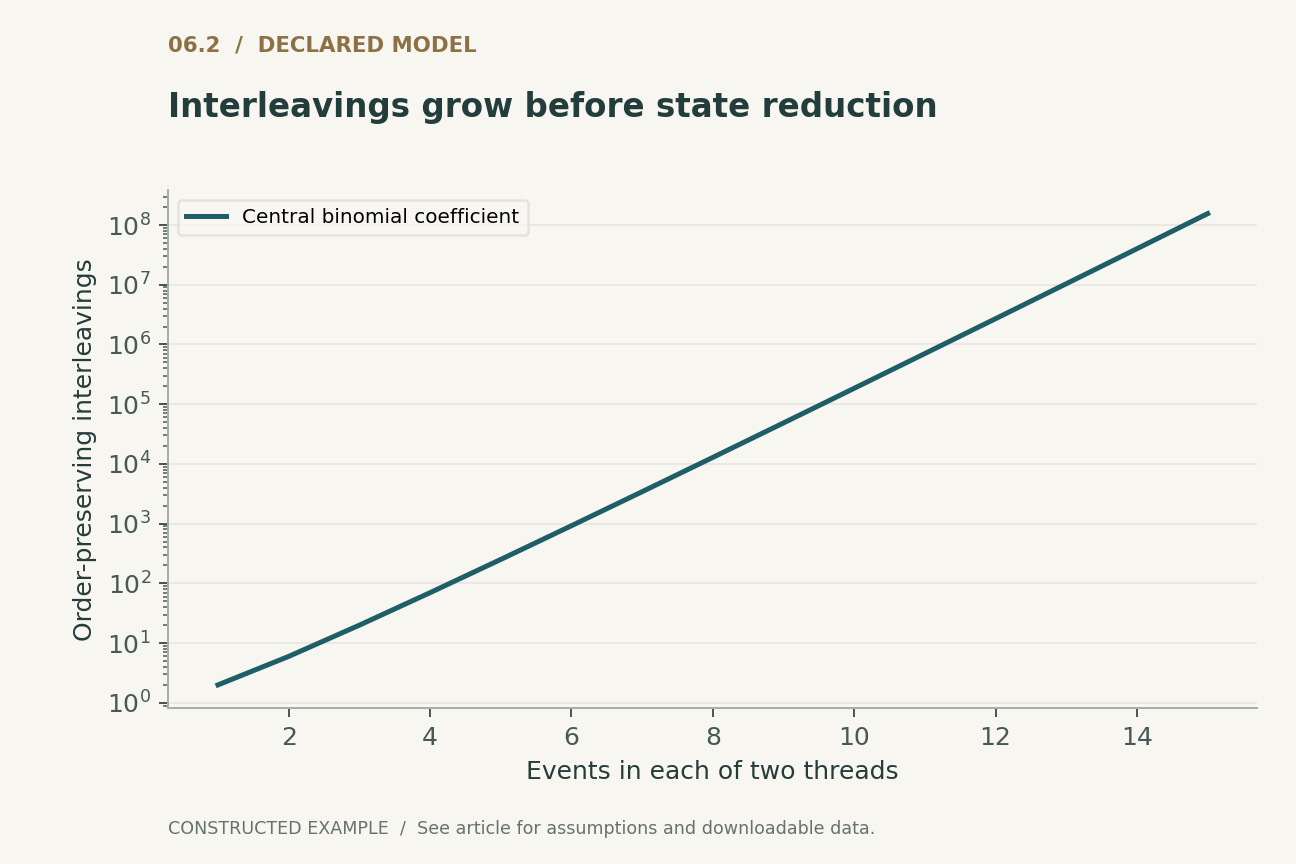
二番目の図は、それぞれm個の順序付けられた操作を持つ二つのスレッドのインターリーブ数を示しており、この数は中央二項係数に等しい。mが十の場合、追加のメモリイベントを導入する前でも、そのようなインターリーブは184,756通り存在する。動的半順序簡約や記号的手法を用いれば、同値なスケジュールをすべて調べることを回避できる。この曲線は、それらの手法が必要とされる理由を示すものであり、検査器の実行時間を測定した曲線ではない。
テストでは観測の境界を維持すべきである
ハードウェアのリトマステスト用ハーネスは、意図したソースの意味論と整合しない形でコンパイラが実験を削除または変換することを防ぐ必要がある。正確な生成コード、コンパイラの版とフラグ、プロセッサのモデル、動作条件、反復回数、および観測されたすべての結果を記録すべきである。有限回の実行である結果が観測されないことは、アーキテクチャがその結果を禁止している証明にはならない。
アプリケーションコードでは、オブジェクトの生存期間、メモリ回収、キャンセル、および例外的な制御フローもテストの対象とすべきである。これらは、それ以外の点では正しい公開の議論をしばしば無効にする。有用な陰性対照は、同期関係を取り除いた結果として生じる実行例が既知のモデルにおいて、その同期関係を意図的に除去するものである。こうすることで、常に成功しているように見える大量反復のループを単に動かすのではなく、調査対象の性質に対するテストの感度を示せる。
結論:許容される実行を明示する
並行プログラミングで生産的な問いは、コードが通常は順序どおりに動くかどうかではなく、言語と対象がどの実行を許容し、そのうちどれをアルゴリズムが許容できるかである。ストアバッファリングの例は、四つの操作と二つの追加フラッシュイベントによって、この違いを可視化する。
精密なメモリモデルは、通説に頼ることなく性能重視の実装を可能にする。原子性、順序、可視性、進行性を、スレッド安全性という一つの曖昧な概念にまとめてしまうと、その利点は失われる。根拠のある議論は、必要な各関係を明示し、コンパイラとハードウェアの境界を確認し、テストを契約の代用品としてではなく、その契約に関する観測として用いる。
ローカルで実行済み · 限定された範囲
SC、ストアバッファ、フェンス付きリトマスモデルの列挙
制限された操作的モデルであり、ハードウェア、C++実装、メモリモデルへの適合性をテストしたものではない。
3件のアサーションに合格。 これらの検査が検証するのは提示した例であり、引用したシステムではない。
記録された実行例を確認
{
  "sc": [
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "buffered": [
    [
      0,
      0
    ],
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "fenced": [
    [
      0,
      1
    ],
    [
      1,
      0
    ],
    [
      1,
      1
    ]
  ],
  "orders": [
    6,
    80,
    20
  ]
}明示された解析モデル
四つの式と明示的な仮定
(1) 逐次一貫性の下で両方の読み取りがゼロを返すために必要となる循環。いかなる狭義全順序もこれを含むことはできない。
(2) 明示されたストアバッファモデルで許容される一つの実行例。Fは共有メモリへのフラッシュを表す。
(3) 二つのスレッドがそれぞれ内部で順序付けられたm個のイベントを実行する。これは同値性による簡約前の構文的なインターリーブを数える。
(4) 本稿で用いる特定の二スレッドのリトマステストと制限された操作的モデルに対する読み取り結果の集合。
構成した例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示されたモデルから計算したものである。引用した研究での観測結果ではない。すべての図に数値データとベクトル版を付属している。


どの証拠がどの問いに答えるのか
| 問い | 関連する契約 | よくある誤った推論 |
|---|---|---|
| アクセスはアトミックか | 言語/アーキテクチャのアクセス意味論 | すべてのアクセスが大域的に順序付けられる |
| データは公開されているか | 根拠のある同期関係 | 任意のアクワイアが任意のリリースを観測する |
| ある結果は可能か | 許容実行の形式モデル | 観測されない結果は禁止されている |
| 操作は完了するか | 進行性とスケジューリングの仮定 | メモリ順序が公平性を保証する |
提案する検証プロトコル
これは評価設計の提案である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検査の節に記録している。
- リトマステストを実行する前に、ソースと対象の正確なモデルを明示する。
- 対照として、ストアバッファリングの逐次一貫な実行履歴を列挙する。
- 明示的なストアイベントとフラッシュイベントを追加し、両読み取りがゼロとなる実行例を保持する。
- 明示したロード前フラッシュ条件を追加し、その実行例が消えることを確認する。
- ハードウェア実験では、生成コードと環境のメタデータを保存する。
- 生存期間、メモリ回収、進行性の性質を、可視性とは分けて検討する。
一次資料が確立したこと
Peter Sewell, Susmit Sarkar, Scott Owens et al. · 2010 [1]
貢献。 精密なx86-TSOモデルは、曖昧で非形式的なプロセッサの説明を超えた推論を支える。
適用範囲の境界。 その完全なモデルには、本稿の小さなバッファの例よりも多くの詳細が含まれる。
資料内の該当箇所。 要旨と抽象機械の節。
Hans-J. Boehm, Sarita V. Adve · 2008 [2]
貢献。 C++の並行性設計は、有用な保証を、言語レベルの競合と順序の規則に結び付ける。
適用範囲の境界。 観測されたハードウェアの振る舞いによって、ソースの未定義動作を正当化することはできない。
資料内の該当箇所。 要旨とメモリモデル設計の議論。
Mark Batty, Scott Owens, Susmit Sarkar et al. · 2011 [3]
貢献。 C++の並行性の形式的記述は、候補実行とコンパイルに関する問題を明示する。
適用範囲の境界。 この論文が扱うのは、モデル化された言語設計と、その明示された範囲である。
資料内の該当箇所。 要旨と形式的な実行関係。
本分析の限界
- ローカルのモデルは制限された操作的抽象化であり、完全なx86-TSOモデルやC++標準ではない。
- ハードウェアのリトマステストやコンパイラ適合性テストスイートは実行していない。
- 許容結果の個数に、確率測度は含意されない。
- 参照した論文は歴史的な基礎成果であり、現在のアーキテクチャを網羅的に記述したものではない。
選定した三つの基礎的な一次資料に焦点を絞った分析的レビューであり、独自の詳解例を含む。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセス範囲と版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- 実際の読み手は、意図したhappens-beforeの議論に必要な公開を観測しているか。
- どのコンパイラ変換や生存期間の仮定が、アルゴリズムを無効にしうるか。
- メモリ順序の正当性に加えて、どのような進行性の保証が必要か。
参考文献
- Peter Sewell, Susmit Sarkar, Scott Owens et al.. x86-TSO: a rigorous and usable programmer's model for x86 multiprocessors. Communications of the ACM (2010). 10.1145/1785414.1785443.
- Hans-J. Boehm, Sarita V. Adve. Foundations of the C++ concurrency memory model. Proceedings of the 29th ACM SIGPLAN Conference on Programming Language Design and Implementation (2008). 10.1145/1375581.1375591.
- Mark Batty, Scott Owens, Susmit Sarkar et al.. Mathematizing C++ concurrency. Proceedings of the 38th annual ACM SIGPLAN-SIGACT symposium on Principles of programming languages (2011). 10.1145/1926385.1926394.
資料[1]へのアクセス。 一次記録、要旨、およびアクセス可能な本文の一部を確認。全文や補足資料の網羅的な監査ではない。
資料[2]へのアクセス。 一次記録、要旨、およびアクセス可能な本文の一部を確認。全文や補足資料の網羅的な監査ではない。
資料[3]へのアクセス。 一次記録、要旨、およびアクセス可能な本文の一部を確認。全文や補足資料の網羅的な監査ではない。
書誌情報の同一性は、Crossrefと、元の出版社、著者、または所属機関の記録に照らして確認した。以下の資料へのアクセス範囲と版に関する注記は、確認範囲を説明するものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を示しており、分析上の構成と提案した評価設計は本記事に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は、明示されたモデルまたは有限の例から計算しており、PythonとCSVを提供している。導入済み製品の測定値や、再現された性能ベンチマークではない。
このローカル草稿には、独立した査読や学術誌での採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検査するものであり、引用したシステムの形式検証ではない。