
Resumen
La robustez es una relación cuantificada entre un predictor y un conjunto permitido de intervenciones. Esta revisión analítica distingue entre la resistencia empírica a los ataques, los objetivos de entrenamiento robusto y los certificados matemáticos. Partiendo de las normas duales, deriva un ejemplo de vulnerabilidad dimensional cuyo margen sin perturbación se mantiene constante; después contrasta esa geometría con los certificados de suavizado gaussiano. Una enumeración finita de vértices comprueba un peor caso lineal exacto, mientras que un contraejemplo con gradiente estacionario muestra por qué una optimización fallida no constituye una demostración. Las curvas adjuntas son cálculos construidos, no resultados de evaluaciones de referencia de redes neuronales. El diseño de evaluación propuesto exige un preprocesamiento explícito, ataques adaptativos, un tratamiento de la incertidumbre y la presentación por separado de la exactitud sin perturbación, la exactitud bajo ataque y la exactitud certificada.
1. Especificar la proposición antes de nombrar la defensa
Afirmar que una red neuronal es robusta resulta incompleto hasta que se especifica qué puede cambiar, qué debe permanecer invariante y a qué entradas se aplica la afirmación. Para un clasificador, una proposición posible establece que toda perturbación permitida de una entrada concreta conserva la clase predicha. Otra establece que un programa de ataque falló sobre una muestra reservada para evaluación. Estas proposiciones tienen cuantificadores distintos: todas las perturbaciones de un conjunto frente a las perturbaciones visitadas por un algoritmo. Además, una predicción sin perturbación debe ser correcta para que su estabilidad local constituya una exactitud robusta útil.
El objeto operativo debe incluir la decodificación, la normalización, el redimensionamiento, el modelo y el posprocesamiento. Un épsilon expresado en coordenadas de píxeles sin procesar no puede trasladarse sin cambios a coordenadas estandarizadas. Dividir una coordenada por una desviación estándar pequeña amplifica su perturbación. Por ello, nuestro análisis trata la representación de entrada como parte del modelo de amenazas, con coordenadas adimensionales salvo que una aplicación proporcione unidades físicas. Cambiar esa representación cambia la afirmación que se evalúa.
2. Por qué puede acumularse un pequeño presupuesto por coordenada
Goodfellow, Shlens y Szegedy introdujeron una explicación lineal de los ejemplos adversarios y una construcción rápida basada en el signo del gradiente. Su argumento motiva un cálculo local útil; no convierte a todas las redes profundas en globalmente lineales ni hace óptimo cada paso basado en el signo.
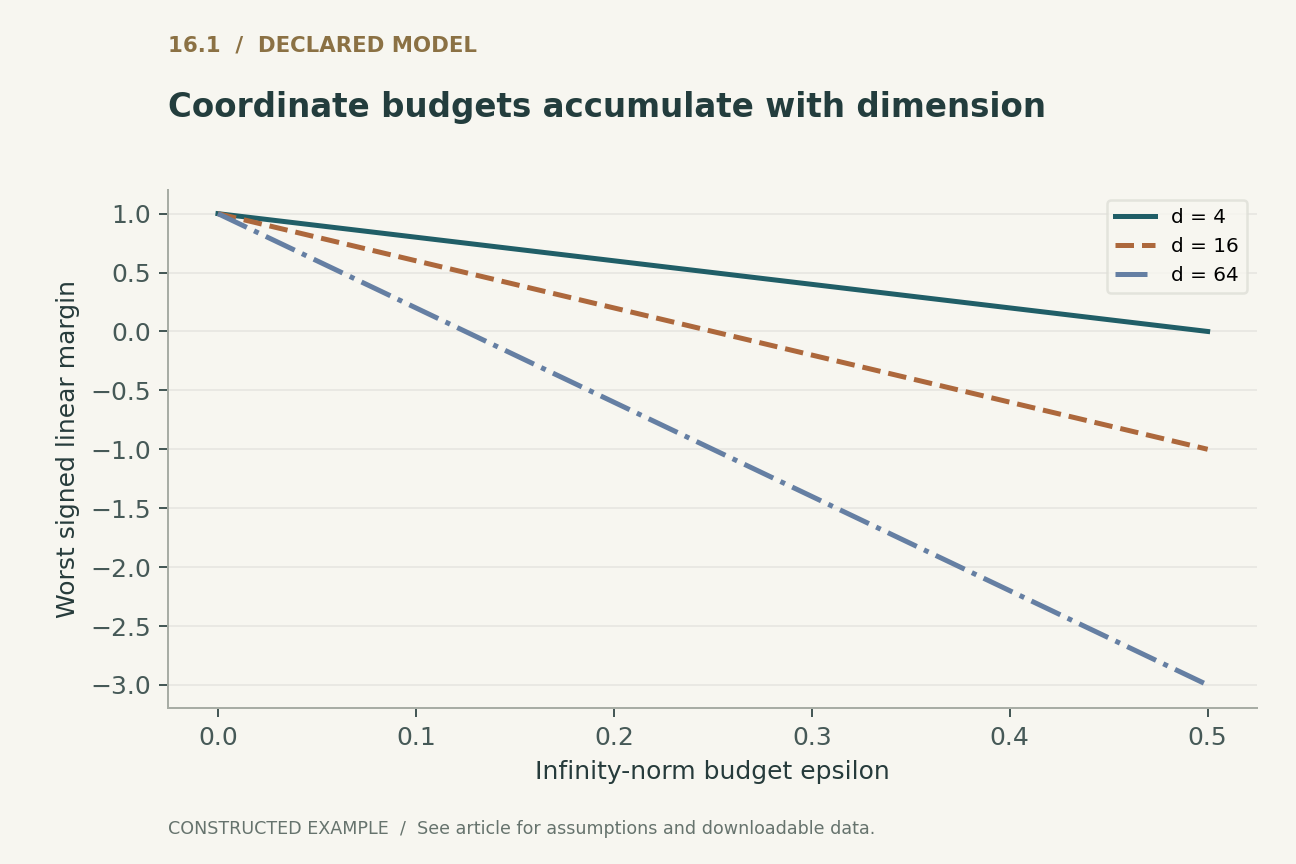
Considérese una puntuación lineal binaria con un margen con signo sin perturbación igual a uno. Elíjase un vector de pesos de dimensión d cuyas entradas sean todas uno dividido por la raíz cuadrada de d, de modo que su norma euclídea permanezca igual a uno. Un atacante al que se permita desplazar cada coordenada en épsilon puede reducir el margen en épsilon multiplicado por la raíz cuadrada de d. Así, un mismo margen sin perturbación y una misma norma euclídea de los pesos coexisten con distintos radios de robustez en norma infinito. Con cuatro coordenadas se alcanza la frontera cuando épsilon vale un medio; con sesenta y cuatro, cuando vale un octavo. La primera figura técnica muestra esta construcción. Cambia la dimensión y el vector de pesos asociado, no la dimensión de una red entrenada fija. El cálculo es un ejemplo geométrico exacto, no una explicación de toda vulnerabilidad observada. [1]
3. Una bola de norma es una hipótesis sobre la aplicación
Una bola de norma infinito limita el mayor cambio de una coordenada; una bola euclídea limita la energía conjunta de esos cambios. Ninguna de las dos descripciones representa automáticamente una equivalencia perceptiva. Una traslación, un cambio de iluminación o una sustitución válida en una secuencia de tokens pueden ser pequeños según una métrica de aplicación y grandes según otra. A la inversa, una perturbación numérica puede permanecer dentro de una bola elegida y, aun así, infringir una restricción física. Añadir una intersección con el dominio de entrada, como una caja de valores de píxel, cambia el problema de optimización factible y puede invalidar una expresión cerrada obtenida sin esas restricciones.
Quien evalúa debe declarar si los ataques son dirigidos, si el atacante conoce los parámetros del modelo y si las consultas están limitadas. Son ejes independientes. El acceso de caja blanca es información sobre el predictor; un radio de perturbación es una restricción sobre sus entradas. Un servicio aleatorizado introduce otra elección: el éxito frente a una única realización aleatoria o frente a su distribución de salidas. Lo segundo no puede inferirse de una respuesta favorable en un solo intento.
4. La optimización robusta y su aproximación numérica
Madry y sus colegas formulan el entrenamiento adversario como una minimización respecto de los parámetros de una pérdida de perturbación en el peor caso. Estudian los ataques de gradiente proyectado como un adversario práctico de primer orden. La maximización numérica interna sigue siendo distinta de una solución exacta del problema interno formal.
Esa distinción crea dos vías de error. Un optimizador interno débil puede proporcionar ejemplos de entrenamiento fáciles, mientras que un optimizador de evaluación débil puede ocultar la vulnerabilidad resultante. Reutilizar una misma configuración de ataque en ambas etapas correlaciona sus fallos. Para una pérdida diferenciable, el ascenso proyectado da un paso en una dirección que aumenta la pérdida y después restablece la factibilidad; el tamaño del paso, la inicialización, la proyección y el presupuesto de reinicios influyen en lo que encuentra. Una auditoría útil conserva, para cada entrada, el ejemplo adversario factible más potente encontrado entre todas las configuraciones probadas. Su exactitud robusta estimada nunca debería aumentar por el mero hecho de añadir otro ataque válido. Si aumenta, conviene investigar el código de agregación o el denominador. [2]
5. Un gradiente nulo no es un certificado local
El ejemplo ejecutable incluye una pérdida unidimensional L(delta) igual a delta al cuadrado en el intervalo de menos uno a uno. El ascenso por gradiente inicializado en cero permanece allí en todos los pasos, aunque ambos extremos tienen una pérdida de uno. Esta construcción elemental no afirma que una defensa concreta tenga esa pérdida. Aísla el fallo lógico de interpretar una búsqueda por gradiente infructuosa como una afirmación universal sobre el conjunto factible.
Los reinicios corrigen este ejemplo concreto, pero un número finito de reinicios no demuestra exhaustividad global para pérdidas no lineales arbitrarias. La precisión numérica y el preprocesamiento no diferenciable pueden crear discrepancias adicionales entre la pasada hacia delante implementada y el gradiente utilizado por un ataque. Una evaluación adaptativa debe dirigirse a la cadena real de predicción y explicar cualquier aproximación del gradiente. También debe mantener comprobaciones de transferencia o sin gradientes cuando sean adecuadas para el presupuesto de acceso declarado. Estas comprobaciones refuerzan la evidencia empírica; aun así, no se convierten tácitamente en certificados formales.
6. Qué certifica el suavizado aleatorizado
Cohen, Rosenfeld y Kolter establecen un certificado de suavizado gaussiano para un clasificador definido por la predicción base más probable bajo ruido gaussiano. Dadas una cota inferior válida para la probabilidad de la clase principal y una cota superior válida para la de la segunda clase, su radio depende de la diferencia entre dos cuantiles de la normal estándar. La garantía se refiere al clasificador suavizado y a las perturbaciones euclídeas, no a cada predicción del modelo base.
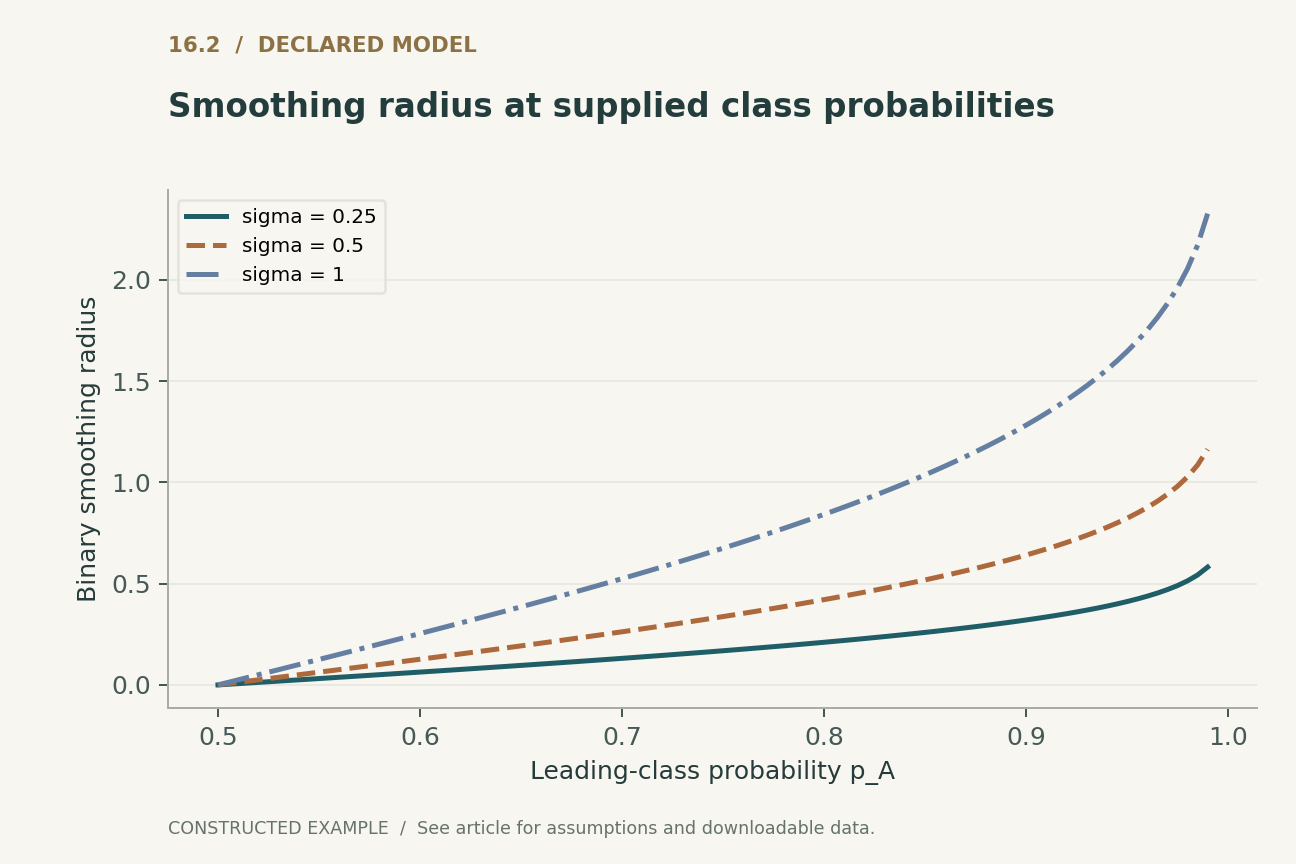
En un caso binario ilustrativo con probabilidades complementarias, la fórmula se reduce a sigma multiplicado por el cuantil normal de la probabilidad principal. Nuestra segunda figura recorre las probabilidades y escalas de ruido suministradas. Estas probabilidades son parámetros, no estimaciones obtenidas de una red. Aumentar sigma manteniendo fija la probabilidad de clase amplía el radio mostrado, pero la probabilidad de clase de un clasificador entrenado generalmente cambia con sigma. Mantenerla fija es un cálculo de sensibilidad, no una prueba de que un ruido arbitrariamente grande mejore una defensa desplegada. Con una probabilidad de un medio, el radio es cero; la identidad de la clase también requiere una convención de desempate. [3]
7. El cómputo de la confianza forma parte de la certificación
Un procedimiento práctico de suavizado observa un número finito de predicciones con ruido. Sustituir probabilidades desconocidas por frecuencias empíricas sin cotas de confianza elimina la protección estadística declarada. La rutina de estimación debe declarar su probabilidad de fallo, el número de muestras, el procedimiento de selección de clase y la regla de abstención. Seleccionar una clase con una muestra y estimar su probabilidad con otra puede facilitar la auditoría del cómputo de la confianza. Si se reutilizan las mismas observaciones, la validez del procedimiento necesita un argumento correspondiente.
La presentación de resultados sobre conjuntos de datos añade una segunda capa. La probabilidad de fallo por entrada de un certificado y la incertidumbre en la fracción poblacional de entradas certificables son cantidades distintas. Una tabla debe indicar el tamaño muestral, el número de casos correctos certificados, la convención del radio y ambas declaraciones de incertidumbre pertinentes. No se deben promediar los radios únicamente de los casos exitosos y presentar ese promedio como representativo de todas las entradas. Las abstenciones y los errores sin perturbación deben seguir visibles en el denominador.
8. Reproducir el modelo finito y cuestionar sus supuestos
Nuestra enumeración de vértices examina las dieciséis combinaciones de signos de los vértices de una caja de norma infinito de cuatro dimensiones para varios radios. Compara la puntuación mínima con signo con la expresión de la norma dual y verifica que la puntuación disminuye monótonamente al aumentar el presupuesto. Como una función lineal sobre una caja alcanza un extremo en un vértice, este cálculo finito comprueba exactamente la instancia construida, salvo por la aritmética de coma flotante. No enumera el espacio de perturbaciones de un modelo neuronal no lineal.
Una segunda comprobación ejecuta explícitamente la secuencia de gradientes inicializada en cero sobre el contraejemplo cuadrático y compara su pérdida con la del extremo. El panel de suavizado tiene un punto de referencia independiente: con una probabilidad principal Phi(1), su certificado binario de probabilidades complementarias equivale a sigma. Estas comprobaciones independientes conectan el texto, las fórmulas y los datos representados. Son deliberadamente lo bastante pequeñas para inspeccionarlas sin datos de entrenamiento ocultos, aceleradores ni infraestructura de evaluación estocástica de referencia.
9. Informar de los compromisos sobre una población común de entradas
Una defensa puede cambiar simultáneamente la exactitud sin perturbación, la latencia, la calibración de la confianza y la tasa de abstención. Una comparación justa fija la población de entradas y presenta juntas estas cantidades. Si un filtro de preprocesamiento descarta los casos difíciles, la exactitud del conjunto retenido debe acompañarse de su cobertura. Si un procedimiento de suavizado requiere muchas evaluaciones del modelo, los costes de tiempo real y de cómputo deben incluir el procedimiento de estimación, no solo una única pasada hacia delante del modelo base.
Los resúmenes por clase importan porque un promedio elevado puede ocultar una categoría débil o una condición de adquisición poco frecuente. Quien evalúa debe distinguir los ejemplos perdidos por errores ordinarios de predicción de los perdidos por el éxito de un ataque o por un fallo de certificación. El entrenamiento robusto puede mejorar algunas de estas cantidades y empeorar otras; la dirección es una cuestión empírica. En particular, no conseguir certificar no demuestra que exista un ejemplo adversario. La región no verificada incluye tanto casos realmente vulnerables como casos en los que el certificado elegido es demasiado laxo.
10. Una afirmación de robustez defendible es un compromiso delimitado
El resultado más útil es una afirmación reproducible con límites identificados: versión de la cadena de procesamiento, escala de entrada, conjunto permitido, definición de éxito, acceso del atacante, población de prueba y procedimiento numérico. Un cambio posterior en el redimensionamiento o la decodificación debe motivar una revisión, porque puede cambiar la geometría que perciben tanto el atacante como el certificado. Un cambio en la taxonomía de etiquetas puede alterar la corrección aunque la estabilidad numérica permanezca intacta.
El análisis presentado respalda tres conclusiones precisas. La geometría de las normas duales puede hacer que la vulnerabilidad por coordenadas aumente mientras el margen sin perturbación permanece fijo. El fracaso de una optimización finita no demuestra la ausencia de un punto adversario. Un certificado válido establece una propiedad local de un predictor especificado bajo supuestos explícitos. Ninguna de estas conclusiones es una afirmación general de seguridad frente al envenenamiento de datos, la extracción de modelos, los documentos maliciosos o el cambio de distribución. Son modelos de amenazas distintos que requieren evidencias distintas. El protocolo propuesto a continuación es un diseño para futuras evaluaciones de modelos neuronales; este artículo solo ha ejecutado las construcciones finitas descritas.
Ejecutado localmente · Alcance delimitado
Extremos lineales en vértices, contraejemplo con gradiente estacionario y cuantil de suavizado
Los 16 vértices de una caja lineal de 4 dimensiones con 51 radios; 20 iteraciones de ascenso sobre delta^2; probabilidades gaussianas suministradas. Sin red entrenada ni evaluación de referencia de ataques.
Se superaron 127 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "dimensions": 4,
  "corners": 16,
  "epsilon_values": 51,
  "margin_at_epsilon_point25": 0.5,
  "gradient_steps": 20,
  "stationary_loss": 0.0,
  "endpoint_loss": 1.0,
  "p_A_at_normal_quantile_1": 0.8413447460685428
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Exacto para una puntuación lineal binaria, etiquetas y en {-1,1}, margen con signo sin perturbación m positivo y una bola de norma sin restricciones adicionales; las restricciones adicionales del dominio pueden cambiar el mínimo.
(2) Objetivo de optimización robusta analizado por Madry y colaboradores; la maximización numérica mediante ataques es una aproximación y no alcanza automáticamente el máximo interno.
(3) Radio de suavizado gaussiano de Cohen y colaboradores para una clase principal con cotas de probabilidad válidas y una brecha positiva; las perturbaciones deben tener una norma euclídea estrictamente inferior a R.
(4) Una opción de ascenso proyectado en norma infinito con tamaño de paso alfa; las operaciones no diferenciables requieren un tratamiento explícito y esta iteración finita no es un certificado.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Evidencia | Establece | No establece |
|---|---|---|
| Exactitud sin perturbación | Corrección en las entradas muestreadas sin perturbar | Estabilidad ante perturbaciones permitidas |
| Exactitud frente al mejor ataque por entrada | Resistencia a la batería de ataques evaluada | Una cota inferior universal para el peor caso |
| Exactitud certificada | Fracción correcta certificada para un radio declarado | Robustez fuera del modelo de amenazas del certificado |
| Cobertura con abstención | Fracción para la que se toma una decisión | Exactitud de los casos omitidos |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna evaluación de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Fijar el modelo, el preprocesamiento, las coordenadas de entrada y la taxonomía de etiquetas antes de seleccionar los presupuestos de ataque.
- Definir el conjunto de perturbaciones, la intersección con el dominio, el conocimiento del atacante, la regla de selección del objetivo y la política de aleatoriedad.
- Evaluar la corrección sin perturbación y conservar el mismo denominador para ataques y certificados.
- Ejecutar configuraciones de ataque adaptativas con reinicios y agregar monótonamente los éxitos por entrada.
- Implementar las cotas de confianza del certificado y las abstenciones, registrando las semillas aleatorias y los presupuestos de fallo.
- Publicar la exactitud por clase, la cobertura, el coste computacional, la incertidumbre y todas las exclusiones del modelo de amenazas.
Qué establecen las fuentes primarias
Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy · 2014 [1]
Contribución. Introduce un ataque basado en el signo del gradiente, motivado por la sensibilidad lineal local.
Límite. Esto no implica linealidad global ni una optimización completa del ataque.
Localización en la fuente. Secciones 3–4.
Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt et al. · 2018 [2]
Contribución. Plantea el aprendizaje robusto como una minimización externa y una maximización adversaria interna.
Límite. Las búsquedas prácticas de primer orden no certifican un peor caso exacto.
Localización en la fuente. Sección 2 y sección 3.
Jeremy Cohen, Elan Rosenfeld, J. Zico Kolter · 2019 [3]
Contribución. Deriva el radio de robustez euclídea de un clasificador con suavizado gaussiano a partir de cotas de probabilidad de clase.
Límite. El certificado se aplica al clasificador suavizado con cotas válidas.
Localización en la fuente. Sección 2, teorema de robustez y procedimiento de certificación.
Límites de este análisis
- Los casos lineales y cuadráticos ejecutados no contienen ninguna red profunda entrenada ni evaluación de referencia de imágenes.
- Las perturbaciones acotadas por norma son hipótesis numéricas y pueden no ajustarse a la semántica de la aplicación.
- Las curvas de suavizado están condicionadas a las probabilidades suministradas; no estiman la respuesta de un clasificador entrenado a los cambios de sigma.
- Las búsquedas finitas de ataques y las poblaciones finitas de prueba no pueden establecer robustez universal fuera de su alcance declarado.
Una revisión analítica centrada en tres fuentes primarias fundamentales seleccionadas, con ejemplos resueltos originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre el acceso a las fuentes y sus versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Cómo debe validarse un conjunto de perturbaciones frente a las invariancias específicas de una aplicación sin utilizar las etiquetas de prueba para ajustarlo?
- ¿Qué factor de relajación del certificado predomina al incluir toda la cadena de decodificación y preprocesamiento?
- ¿Puede hacerse reproducible la selección de ataques y, al mismo tiempo, mantener una evaluación adaptativa frente a debilidades recién descubiertas?
Referencias
- Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy. Explaining and Harnessing Adversarial Examples. arXiv:1412.6572 (2014). Primary source.
- Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt et al.. Towards Deep Learning Models Resistant to Adversarial Attacks. International Conference on Learning Representations (2018). Primary source.
- Jeremy Cohen, Elan Rosenfeld, J. Zico Kolter. Certified Adversarial Robustness via Randomized Smoothing. Proceedings of the 36th International Conference on Machine Learning (2019). Primary source.
Acceso a la fuente [1]. Se inspeccionaron el registro primario y secciones seleccionadas y accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Nota de versión. Prepublicación inicial de 2014; se inspeccionó la versión HTML 3, revisada el 20 de marzo de 2015. Se cita aquí como registro de prepublicación.
Acceso a la fuente [2]. Se inspeccionaron el registro primario y secciones seleccionadas y accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Nota de versión. Año de la conferencia verificado en el PDF primario de OpenReview; también se inspeccionó texto seleccionado en arXiv:1706.06083.
Acceso a la fuente [3]. Se inspeccionaron el registro primario y secciones seleccionadas y accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Las identidades bibliográficas se comprobaron con los registros primarios de editores y autores. Las notas sobre el acceso a las fuentes y sus versiones que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni evaluaciones de referencia de rendimiento reproducidas.
Este borrador local no tiene constancia de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance delimitado comprueban los pequeños modelos declarados; no constituyen una verificación formal de los sistemas citados.