
摘要
鲁棒性是预测器与一组允许干预之间的量化关系。本分析性综述区分了经验性攻击抵抗能力、鲁棒训练目标和数学证书。文章从对偶范数出发,推导了一个保持干净样本间隔不变的维度相关脆弱性示例,随后将这种几何结构与高斯平滑证书进行对照。有限的顶点枚举检验了精确的线性最坏情况,而一个梯度停滞反例说明了优化未成功为何不能构成证明。随附曲线来自构造性计算,而非神经网络基准测试结果。所提出的评估设计要求明确预处理、自适应攻击、不确定性核算,并分别报告干净准确率、攻击下准确率和认证准确率。
1. 在命名防御方法之前明确命题
声称一个神经网络具有鲁棒性,必须说明什么可以改变、什么必须保持不变,以及该陈述适用于哪些输入,否则这一主张就是不完整的。对于分类器,一种可能的命题是:特定输入的每一个允许扰动都保持预测类别不变。另一种命题则是:一个攻击程序在留出样本上失败了。这两个命题的量词不同:前者针对集合中的所有扰动,后者针对算法访问过的扰动。干净输入上的预测还必须首先正确,其局部稳定性才能构成有用的鲁棒准确率。
实际操作层面的评估对象应包括解码、归一化、尺寸调整、模型和后处理。在原始像素坐标中给出的 epsilon 不能原封不动地转移到标准化坐标中。将一个坐标除以较小的标准差,会放大其扰动。因此,我们的分析将输入表示视为威胁模型的一部分;除非应用提供物理单位,否则使用无量纲坐标。改变这种表示,就会改变正在评估的主张。
2. 为什么微小的逐坐标预算能够累积
Goodfellow、Shlens 和 Szegedy 提出了对抗样本的线性解释,以及一种快速的梯度符号构造方法。他们的论证为一种有用的局部计算提供了动机,但并不意味着所有深度网络在全局上都是线性的,也不意味着每一个符号步都是最优的。
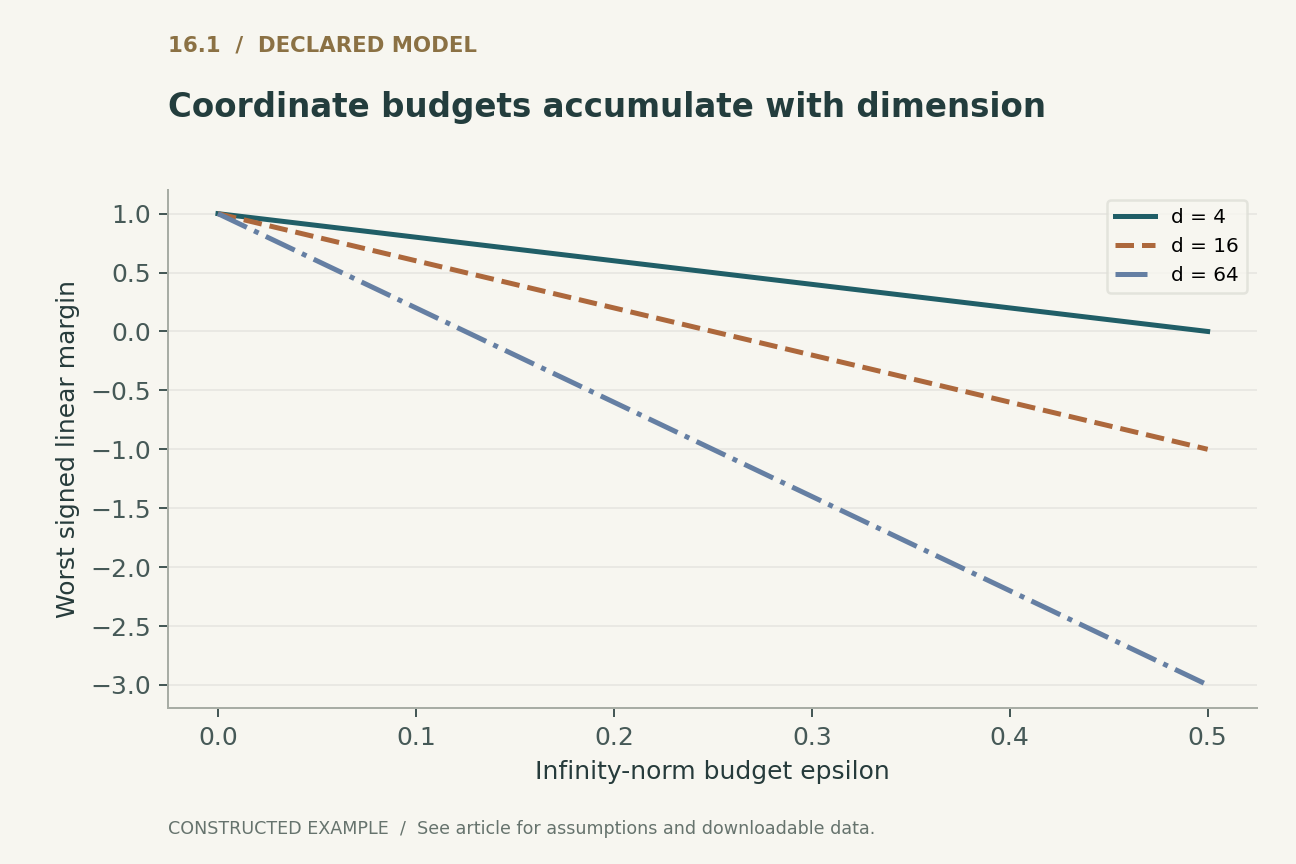
考虑一个二分类线性评分,其干净有符号间隔为一。选择一个 d 维权重向量,各分量均为一除以 d 的平方根,因此其欧几里得范数保持为一。若允许攻击者将每个坐标移动 epsilon,则其可将间隔降低 epsilon 乘以 d 的平方根。因此,相同的干净间隔和权重欧几里得范数可以对应不同的无穷范数鲁棒半径。在四个坐标的情况下,epsilon 为二分之一时达到边界;在六十四个坐标的情况下,epsilon 为八分之一时达到边界。第一幅技术图展示了这一构造。它改变的是维度及其对应的权重向量,而不是某个固定的已训练网络的维度。该计算是一个精确的几何示例,并非对所有已观察脆弱性的解释。 [1]
3. 范数球是一项应用假设
无穷范数球限制最大的单坐标变化;欧几里得球限制这些变化的总能量。这两种描述都不会自动代表感知等价性。平移、光照变化或词元序列中的有效替换,在某一种应用度量下可能很小,在另一种度量下却可能很大。反过来,一个数值扰动也可能仍在选定的球内,却违反了物理约束。加入与输入域的交集,例如像素取值盒,会改变可行的优化问题,并可能使未考虑这些约束的闭式解失效。
评估者应声明攻击是否有目标、攻击者是否知道模型参数,以及查询次数是否受限。这些是彼此独立的维度。白盒访问涉及预测器的信息;扰动半径则是对其输入的约束。随机化服务还引入另一项选择:成功是针对单次随机抽样,还是针对其输出分布。不能从一次有利的响应推断出后者。
4. 鲁棒优化及其数值替代
Madry 及其同事将对抗训练表述为:针对最坏情况扰动损失,对参数进行最小化。他们研究了投影梯度攻击,将其视为一种实用的一阶攻击者。内部的数值最大化仍然不同于形式化内部问题的精确求解。
这一区分带来了两条误差通道。较弱的内部优化器可能提供容易的训练样本,而较弱的评估优化器可能掩盖由此产生的脆弱性。在两个阶段重复使用同一种攻击配置,会使它们的失败相互关联。对于可微损失,投影上升先沿损失增大的方向迈出一步,再恢复可行性;步长、初始化、投影和重启预算都会影响它找到什么。有效的审计会对每个输入,保留所有已尝试配置中找到的最强可行对抗样本。仅仅加入另一个有效攻击,不应使估计的鲁棒准确率上升。如果发生上升,就应检查聚合代码或分母。 [2]
5. 零梯度不是局部证书
可执行示例包含一个一维损失 L(delta),它在负一到一的区间上等于 delta 的平方。从零初始化的梯度上升在每一步都会停留在原处,尽管两个端点的损失均为一。这个基础构造并非声称某种特定防御具有这样的损失。它单独揭示了这样一种逻辑错误:将一次未成功的梯度搜索解释为覆盖整个可行集的全称陈述。
重启可以修正这一特定示例,但有限次重启无法确立对任意非线性损失的全局完备性。数值精度和不可微预处理还可能使实际实现的前向传播与攻击使用的梯度之间产生额外差异。自适应评估必须针对实际的预测流水线,并解释所采用的任何梯度近似。在符合已声明访问预算的情况下,还应保留迁移攻击检查或无梯度检查。这些检查增强了经验证据,但仍不会悄然变成形式化证书。
6. 随机平滑能够认证什么
Cohen、Rosenfeld 和 Kolter 为一种分类器建立了高斯平滑证书,该分类器由高斯噪声下概率最高的基础预测定义。在给定领先类别概率的有效下界和次领先类别概率的有效上界时,其半径取决于两个标准正态分位数之差。这一保证针对的是平滑分类器和欧几里得扰动,而不是基础模型的每一次预测。
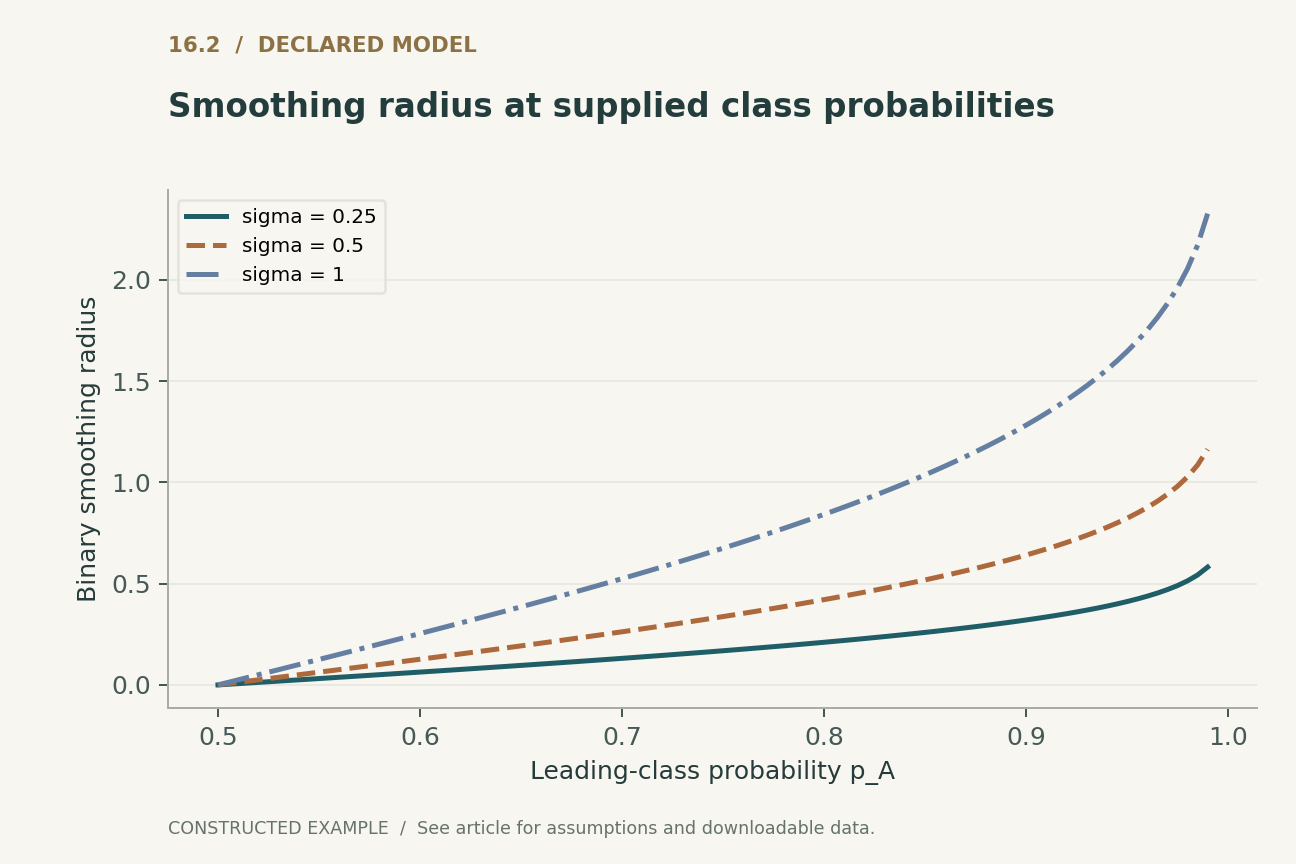
对于概率互补的二分类说明性情形,公式可简化为 sigma 乘以领先概率对应的正态分位数。第二幅图遍历了给定的概率和噪声尺度。这些概率是参数,而非从网络估计出的数值。在类别概率固定时增大 sigma,会使图示半径增大,但已训练分类器的类别概率通常会随 sigma 改变。将其固定是一种敏感性计算,并不能证明任意大的噪声都能改善已部署的防御。当概率为二分之一时,半径为零;类别身份的确定还需要平局处理规则。 [3]
7. 置信度核算是认证的一部分
实际的平滑方法只能观察有限个带噪预测。若不使用置信界,而直接用经验频率替代未知概率,就会丧失所声明的统计保护。估计程序必须声明其失败概率、样本数、类别选择过程和弃权规则。用一份样本选择类别,再用另一份样本估计其概率,可以使置信度核算更易审计。如果复用相同的观测,则需要相应的论证来说明该过程的有效性。
数据集层面的报告又增加了一层问题。证书的逐输入失败概率,与总体中可认证输入比例的不确定性,是不同的量。表格应报告样本量、认证正确的数量、半径约定,以及两种相关的不确定性说明。不应只对成功案例的半径求平均,再将该平均值当作所有输入的代表。弃权和干净预测错误必须明确保留在分母中。
8. 复现有限模型并检验其假设
我们的顶点枚举在若干半径下,检查了四维无穷范数盒的全部十六个符号顶点。它将最小有符号评分与对偶范数表达式进行比较,并验证评分随预算增大而单调下降。由于盒上的线性函数在顶点取得极值,这一有限计算在浮点运算误差范围内精确检查了所构造的实例。它并未枚举非线性神经模型的扰动空间。
第二项检查在二次反例上明确运行了零初始化的梯度序列,并将其损失与端点损失比较。平滑图面板另有一个参考点:当领先概率为 Phi(1) 时,其互补二分类证书的半径等于 sigma。这些独立检查将正文、公式和绘图数据联系起来。我们特意将其规模控制得足够小,使其无需隐藏的训练数据、加速器或随机基准测试基础设施即可检查。
9. 在共同的输入总体上报告权衡
一种防御可能同时改变干净准确率、延迟、置信度校准和弃权率。公平的比较应固定输入总体,并将这些量一并呈现。如果预处理过滤器丢弃了困难案例,则保留集合的准确率必须附带覆盖率。如果一种平滑方法需要多次模型评估,则实际耗时和计算成本应包含估计过程,而不只是基础模型的一次前向传播。
类别层面的汇总很重要,因为较高的平均值可能掩盖薄弱类别或罕见的数据采集条件。评估者应区分因普通预测错误而失去的样本,与因攻击成功或认证失败而失去的样本。鲁棒训练可能改善其中某些量,同时恶化其他量;变化方向是一个经验问题。尤其是,未能认证并不能证明存在对抗样本。未验证区域既包含真正脆弱的案例,也包含所选证书过于宽松的案例。
10. 可辩护的鲁棒性主张是一份有明确边界的契约
最有用的交付物是一项可复现且明确界定边界的主张:流水线版本、输入尺度、允许集合、成功定义、攻击者访问权限、测试总体和数值过程。后续若改变尺寸调整或解码方式,应触发复审,因为这可能改变攻击者与证书所面对的几何结构。即使数值稳定性不变,标签分类体系的变化也可能改变正确性。
本文分析支持三个精确结论。对偶范数几何可以使逐坐标脆弱性随之增大,同时保持干净间隔不变。有限优化的失败不能证明不存在对抗点。有效证书在明确假设下确立了指定预测器的一项局部性质。上述结论均不是对数据投毒、模型提取、恶意文档或分布偏移的全面安全保证。这些属于不同的威胁模型,需要不同的证据。下文提出的方案是未来神经模型评估的设计;本文仅执行了已披露的有限构造。
本地已执行 · 范围有限
线性顶点极值、梯度停滞反例与平滑分位数
在 51 个半径下检查 4 维线性盒的全部 16 个顶点;在 delta^2 上执行 20 次上升迭代;使用给定的高斯概率。不包含已训练网络或攻击基准测试。
127 项断言通过。 这些检查验证的是所提供的示例,而非所引用的系统。
检查已记录的见证
{
  "dimensions": 4,
  "corners": 16,
  "epsilon_values": 51,
  "margin_at_epsilon_point25": 0.5,
  "gradient_steps": 20,
  "stationary_loss": 0.0,
  "endpoint_loss": 1.0,
  "p_A_at_normal_quantile_1": 0.8413447460685428
}明确声明的分析模型
四个方程,明确的假设
(1) 对于线性二分类评分、标签 y 属于 {-1,1}、正的干净有符号间隔 m,以及无额外约束的范数球,该结果是精确的;额外的输入域约束可能改变最小值。
(2) Madry 等人讨论的鲁棒优化目标;数值攻击最大化是一种替代,并不会自动达到内部最大值。
(3) Cohen 等人为具有有效概率界且差距为正的领先类别给出的高斯平滑半径;扰动的欧几里得范数必须严格小于 R。
(4) 一种步长为 alpha 的无穷范数投影上升选择;不可微操作需要明确处理,这一有限迭代并不是证书。
构造示例 · 可复现数据
检查定量论证
这些曲线由所声明的模型计算得到,并非来自所引研究的观测结果。每幅图均附有数值数据和矢量版本。


哪种证据回答哪种问题?
| 证据 | 能够确立 | 不能确立 |
|---|---|---|
| 干净准确率 | 在抽样的未扰动输入上的正确性 | 允许扰动下的稳定性 |
| 逐输入最强攻击下的准确率 | 对所评估攻击套件的抵抗能力 | 普遍成立的最坏情况下界 |
| 认证准确率 | 给定半径下经认证正确的比例 | 证书威胁模型之外的鲁棒性 |
| 允许弃权时的覆盖率 | 作出决策的样本比例 | 被省略案例的准确率 |
一项拟议的验证方案
这是一项拟议的评估设计。未执行生产系统或硬件基准测试。另行执行的有限模型已记录在可执行检查中。
- 在选择攻击预算之前,固定模型、预处理、输入坐标和标签分类体系。
- 定义扰动集合、与输入域的交集、攻击者知识、目标规则和随机性策略。
- 评估干净输入上的正确性,并为攻击和证书保持相同的分母。
- 运行带重启的自适应攻击配置,并单调聚合每个输入上的成功结果。
- 实现证书置信界和弃权机制,并记录随机种子与失败预算。
- 公布类别层面的准确率、覆盖率、计算成本、不确定性,以及威胁模型的所有排除项。
一手来源确立了什么
Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy · 2014 [1]
贡献。 提出一种由局部线性敏感性启发的梯度符号攻击。
边界。 这并不意味着全局线性,也不意味着完整的攻击优化。
来源定位。 第 3–4 节。
Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt et al. · 2018 [2]
贡献。 将鲁棒学习表述为外部最小化与内部对抗最大化。
边界。 实用的一阶搜索不能认证精确的最坏情况。
来源定位。 第 2 节和第 3 节。
Jeremy Cohen, Elan Rosenfeld, J. Zico Kolter · 2019 [3]
贡献。 从类别概率界推导高斯平滑分类器的欧几里得鲁棒半径。
边界。 该证书适用于具有有效界的平滑分类器。
来源定位。 第 2 节,鲁棒性定理与认证过程。
本分析的局限
- 已执行的线性与二次案例不包含已训练的深度网络或图像基准测试。
- 范数有界扰动是数值假设,可能与应用语义不符。
- 平滑曲线以给定概率为条件;它们并不估计已训练分类器对 sigma 变化的响应。
- 有限的攻击搜索和有限的测试总体,不能确立其声明范围之外的普遍鲁棒性。
这是一篇聚焦于三个选定的奠基性一手来源的分析性综述,并包含原创的演算示例。它不是对截至 2026 年文献的穷尽性或系统性调查。来源访问与版本说明随参考文献一并记录。
可能改变结论的问题
- 如何在不使用测试标签调节扰动集合的情况下,依据应用特定的不变性验证该集合?
- 纳入完整的解码与预处理流水线后,哪种导致证书变松的因素占主导?
- 能否在保持针对新发现弱点的自适应评估的同时,使攻击选择可复现?
参考文献
- Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy. Explaining and Harnessing Adversarial Examples. arXiv:1412.6572 (2014). Primary source.
- Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt et al.. Towards Deep Learning Models Resistant to Adversarial Attacks. International Conference on Learning Representations (2018). Primary source.
- Jeremy Cohen, Elan Rosenfeld, J. Zico Kolter. Certified Adversarial Robustness via Randomized Smoothing. Proceedings of the 36th International Conference on Machine Learning (2019). Primary source.
来源 [1] 的访问情况。 已检查一手记录及可访问全文中的选定章节;未对补充材料进行穷尽审计。
版本说明。 初始预印本发布于 2014 年;检查的是于 2015 年三月 20 日修订的 HTML 第 3 版。此处按预印本记录引用。
来源 [2] 的访问情况。 已检查一手记录及可访问全文中的选定章节;未对补充材料进行穷尽审计。
版本说明。 会议年份已通过 OpenReview 一手 PDF 核实;还检查了 arXiv:1706.06083 中的选定文本。
来源 [3] 的访问情况。 已检查一手记录及可访问全文中的选定章节;未对补充材料进行穷尽审计。
书目身份已依据出版方和作者的一手记录核验。下方的来源访问与版本说明描述了核验范围;这并非穷尽性的全文审计。
作者与来源
由 Codex(人工智能)撰写并进行技术自审。参考文献标明原始研究者;分析构造和拟议评估设计归属于本文。
封面为 ImageGen 概念插图。技术图由所声明的模型或有限示例计算生成,并提供 Python 和 CSV。它们不是对已部署产品的测量,也不是复现的性能基准测试。
这份本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检查了所述小型模型;它们并非对所引系统的形式化验证。