
摘要
稀疏混合专家模型仅为每个词元激活其存储参数的一个子集。其实际行为取决于路由、有限的专家容量、通信以及各分派组的组成。本综述借助三篇一手文献和独立构建的有限路由模型,区分这些约束。对八个词元的分配进行精确枚举表明,在容量有限时,均匀的路由概率仍会导致溢出。第二个构造表明,全局均衡的专家使用可以与严重失衡的批次并存。两幅可复现图表及明确的断言为这些示例提供支持,同时,所提出的评估方案将路由质量、任务质量和系统成本区分开来,并不声称提出了新的大模型基准测试。
1. 存储的参数并不保证吞吐量
稀疏专家层可以包含大量参数,同时只为每个词元计算少数专家。这一架构事实并不能决定吞吐量、内存使用或质量。这些结果还取决于哪些词元被一起分配、每个专家能够接受多少工作,以及数据如何在设备之间传输。因此,有意义的分析单位既包括单个词元,也包括分派组。
本文在一个刻意缩小的设置中研究单选路由,其中包含八个词元和两个专家。该设置足够小,可以精确枚举独立均匀路由的每一种分配。这些示例揭示了常见概括中的逻辑缺口,例如平均路由均衡或活跃参数数量较少。它们不模拟生产环境中的专家层,也不估计加速器性能。其作用是明确:在将某种条件计算设计称为高效或资源配置可靠之前,更大规模的实验必须测量哪些内容。
2. 三项奠基性贡献构成背景
Shazeer及其同事开发了采用条件式专家激活的稀疏门控混合专家层,并处理路由与负载均衡方面的挑战。Fedus、Zoph和Shazeer研究了Switch Transformer简化后的路由与训练设计。Lepikhin及其同事在GShard中将条件计算与自动分片相结合。这些工作表明,必须将专家建模与分布式执行结合起来考虑。
这些研究报告的扩展性与质量结果适用于特定的架构、工作负载和硬件配置,并不是对所有后续专家模型的预测。下文的有限构造没有借用这些实验中的任何性能测量值,而是通过精确概率计算分离容量溢出与批次相关性的影响。这种区分是有意为之:路由反例能够证伪过于宽泛的保证,但并不意味着所引用的系统在其各自测试条件下失效。在将示例应用于实际运行之前,必须核查各系统实际采用的溢出策略和分派分组方式。 [1], [2], [3]
3. 容量是作用于分派组的策略
设T个词元各自从E个专家中选择一个,专家e接收n_e个词元。统一的单专家容量C意味着,在该组内,该专家最多可以处理C次分配。如果丢弃溢出分配,则被拒绝的分配数量为各个n_e减去C所得差值的正部之和。其他策略可能重新路由或延后处理,从而同时改变质量与成本。
容量因子通常相对于平均负载,即T除以E,来表示,并伴随整数舍入。仅凭平均值无法确定最大负载。即使C等于该平均值,随机波动也会产生溢出。分组细节同样重要:容量可能应用于每个本地分片、路由组、微批次,或其他由实现定义的单位。本文始终使用一个明确的八词元组。这可以防止用全局批次大小,悄然替代真正作出容量决策时可能采用的更小单位。
4. 均匀概率并不意味着实际负载均衡
对于两个被选择概率相等的专家和八个独立路由的词元,第一个专家的负载服从二项分布,第二个专家接收其余词元。共有256种等概率分配,因此,每一种溢出统计量的期望都可以通过有限枚举获得,不存在抽样不确定性。
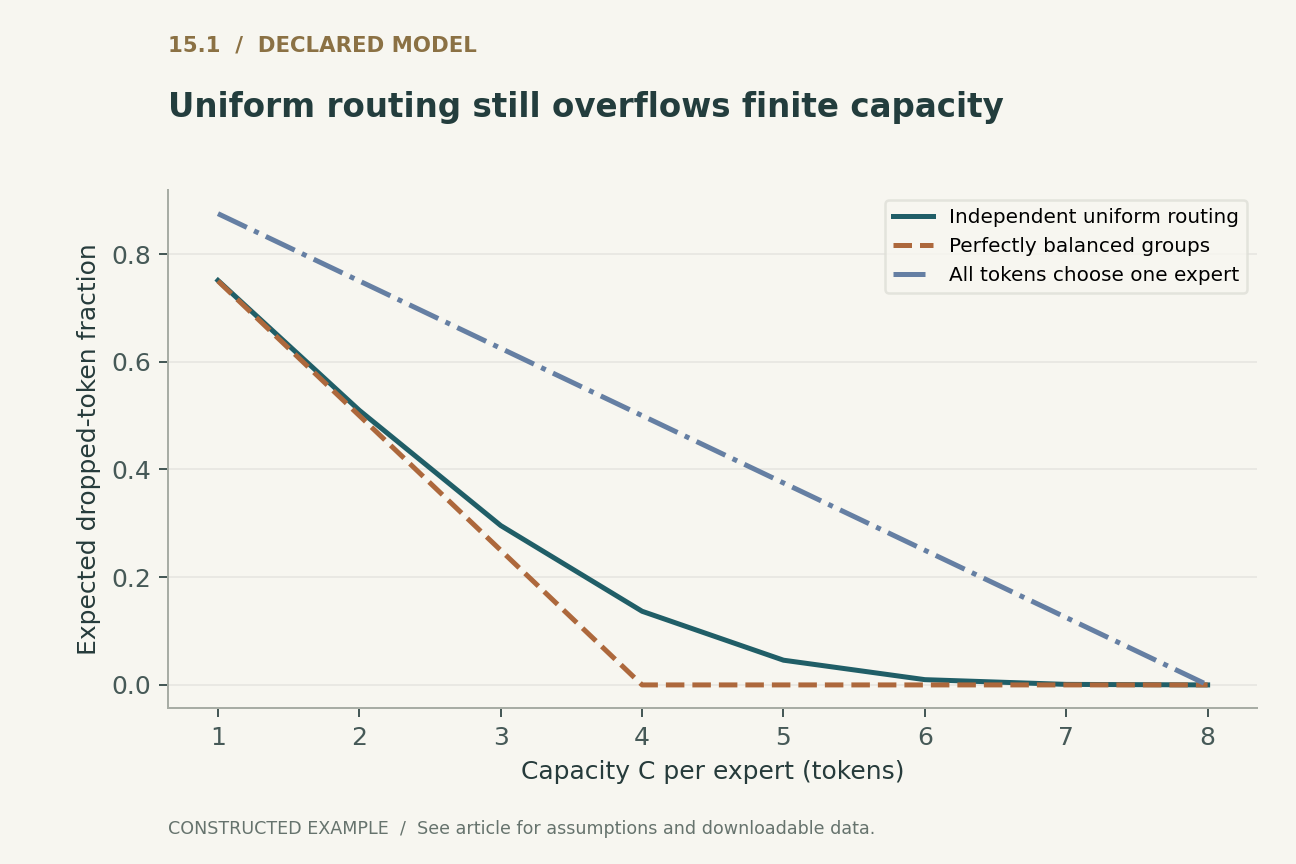
当容量为四时,四对四的完全均衡分配不会丢弃词元。然而,在所述丢弃策略下,独立均匀路由器丢弃词元的期望比例为35除以256,约为百分之13.67。所有词元都选择同一专家的事件虽然罕见,但许多不那么极端的失衡也会产生贡献。图1在容量从一到八的范围内,将这一精确期望与完全均衡及完全集中的分配进行比较。该图并不是说训练后的路由器具有独立性或均匀性,而是说明,仅凭均匀的边缘概率,不足以证明有限组中的溢出可以忽略。
5. 全局均衡可能掩盖批次内的相关性
考虑第二种路由器:它将一组中的所有词元发送给一个专家,并对每个组等概率地选择该专家。在大量组上,每个专家平均接收一半词元。然而,在任意组内,负载都是八对零。当容量为四时,在相同丢弃策略下,一半分配会溢出。全局利用率摘要可能看起来完全均衡,而局部容量行为却很差。
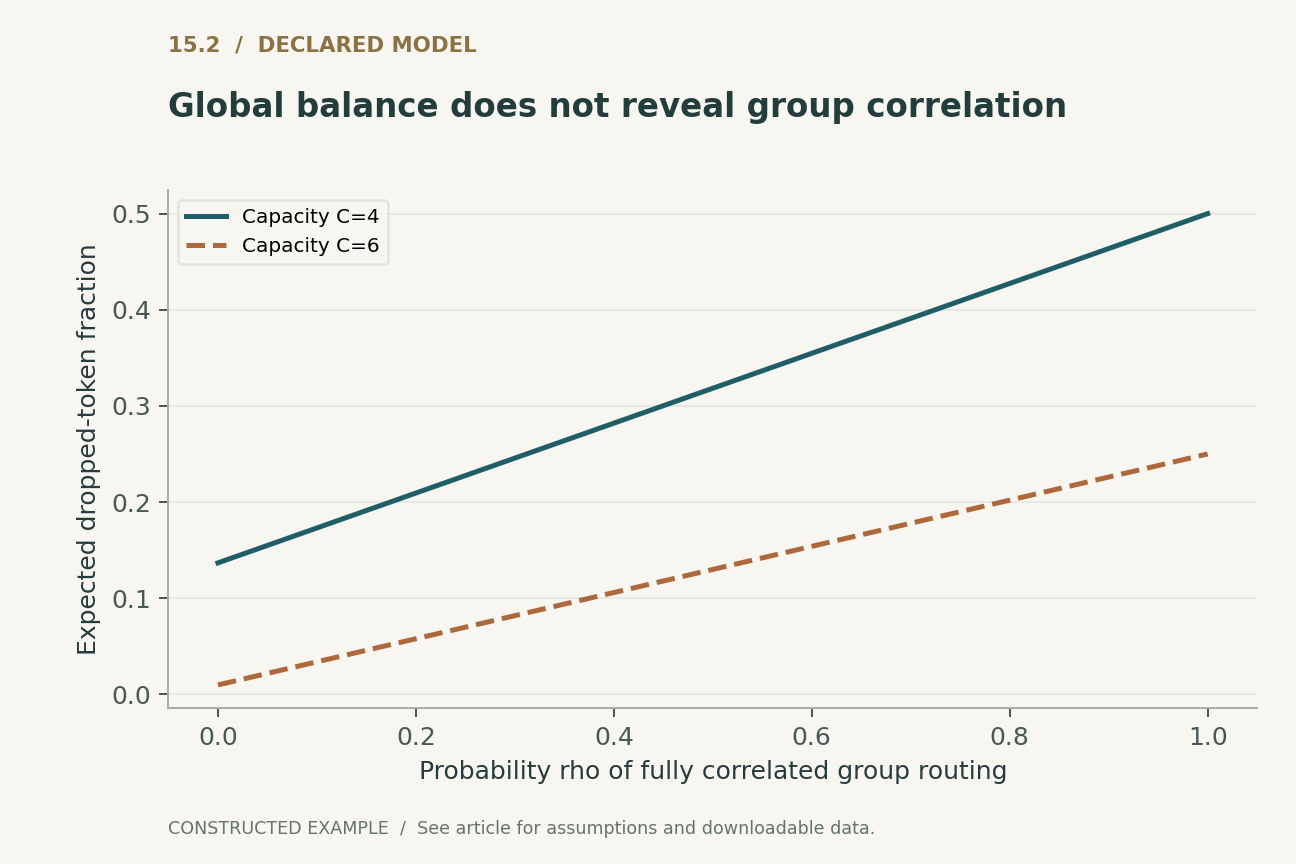
为在两种情形之间进行插值,将独立均匀路由与这种整组相关路由混合。设rho为某个组采用相关机制的概率。无论rho取何值,每个词元选择专家的边缘分布都保持均匀。溢出期望是两个精确期望的线性混合,如图2所示。rho是混合参数,不是从真实模型中拟合得到的统计量。它的用途是隔离词元分配之间的依赖关系如何在不改变专家平均份额的情况下改变容量需求。
6. 均衡目标需要相匹配的诊断
均衡损失是一种优化工具,并不能直接证明每个分派组都满足容量约束。视其定义而定,它可能鼓励概率质量、观测到的分配,或两者同时分散到不同专家上。其测量粒度和平均窗口决定了哪些形式的失衡仍然可见。跨多个组计算的统计量可能掩盖上述相关构造。
因此,评估应同时包括边缘份额,以及逐组最大负载、溢出数量和空专家数量的分布。如果采用双选路由或更一般的路由方式,应统计专家分配次数,而不只是词元数量,并说明权重与溢出如何相互作用。词元丢弃、残差旁路、重新路由和延迟执行是不同的行为。有限情形代码假定单选分配与丢弃,仅仅是为了保持参考结果的精确性。将其数值百分比应用于另一种策略是错误的;但要求明确说明策略与分组方式,仍然有用。
7. 路由质量不等同于任务质量
无需查看词元内容,通过循环分配词元就能实现完全均衡的路由。这种策略能够控制负载,却不能保证每个词元都到达合适的专家。反过来,路由器可能偏好某个专家,是因为当前输入分布确实集中于该专家所代表的专长领域。此时,强制均衡可能改变建模目标。
恰当的问题并不是均衡是否在所有情况下都值得追求,而是模型如何在专业化与资源约束之间作出权衡。拟议研究应将路由决策与留出数据上的任务结果联系起来,并检查溢出是否对特定序列类型、语言或数据领域产生不成比例的影响。这些分析需要真实的模型输出和数据集定义,不能从负载直方图中推断出来。本文的精确示例刻意省略了语义。它们的局限也正是其价值所在:防止将系统统计量误当作证据,用以证明学到的专家分解服务于预期任务。
8. 通信与同步应纳入成本模型
与计算所有专家相比,激活少量专家可以减少部分算术运算,但词元分派与收集可能引入通信和同步。即使每个词元的活跃计算量较小,专家的总存储需求也可能要求跨设备分布。性能主张必须包含这些成本,以及填充、未使用容量和通信与计算之间的任何重叠。
基于最繁忙专家的简单界限,只有在明确的调度模型下才能揭示负载瓶颈。它不是基于测量的延迟预测。实际计算内核可能存在批次大小阈值、设备速度差异,以及来自其他工作的资源争用。因此,基准测试应报告各阶段耗时和端到端延迟分布,而不只是理论乘法次数。本地材料提供路由计数与期望值;它不测量全对全通信,也不从这些计数推断硬件加速比。
9. 可复现性要求记录路由决策
即使底层词元表示和模型权重保持不变,批次组成变化也可能改变稀疏层的行为。容量仲裁、平局裁决、路由噪声和顺序都可能影响哪些分配被接受。如果这些选择影响输出,那么复现一次运行所需的信息就不止模型初始化时使用的随机种子。
对于受控实验,应记录路由器配置、容量因子及舍入方式、分组规则、专家放置、溢出策略,以及确定性的平局裁决行为。应归档汇总诊断信息和具有代表性的逐组轨迹,同时避免暴露私有输入数据。在若干允许的分组方式下比较固定词元集合,以揭示其对相邻样例的敏感性。拟议测试并不假定所有专家模型都是非确定性的;它关注的是,在预期批处理机制下,实现所记录的语义是否得以保持。有限枚举提供了一个可复现的基线,其中不存在隐藏的路由随机性或抽样误差。
10. 关于稀疏容量的更有力主张
有理据的稀疏容量主张应说明存储了多少参数、尝试了多少次专家分配、实际处理了多少次,以及其余分配如何处置。随后,应报告在明确声明的工作负载下的任务结果和实测资源使用。这些量使人们能够区分建模收益、路由策略变化和硬件利用率变化。
这两个精确构造确立了一条狭窄但重要的界限。均匀路由概率不能消除有限组溢出,均匀的全局专家份额也不能揭示组内相关性。两项结果都不是对混合专家架构的否定,而是主张评估条件式容量在何种条件下可以被利用。配套代码枚举了这一小规模情形,并公布生成各条曲线所依据的假设。大模型评估应保持同样的清晰度,同时加入本文刻意排除的复杂因素:学习得到的路由、异质词元、通信、优化以及任务特定质量。
本地执行 · 范围有限
穷举单选路由与边缘分布匹配的相关反例
采用丢弃策略的八词元、双专家单选路由;仅涉及整数计数和期望值,并非训练后的MoE或分布式系统基准测试。
287项断言通过。 这些检查验证的是所提供的示例,而非所引用的系统。
查看记录的验证见证
{
  "assignments_enumerated": 256,
  "tokens": 8,
  "experts": 2,
  "capacities": [
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ],
  "iid_drop_at_capacity4": 0.13671875,
  "correlated_drop_at_capacity4": 0.5,
  "expected_loads_both": [
    4,
    4
  ]
}明确声明的解析模型
四个方程,明确的假设
(1) 门控权重明确定义的稀疏专家组合。有限示例限定为单选分配,并分析负载而非输出值。
(2) 采用因子c的统一单专家容量,以及丢弃溢出的策略。图中直接使用T=8、E=2和整数C。
(3) 八个词元、两个专家的独立均匀单选路由的精确期望。当C=4时,期望丢弃比例为35/256。
(4) 在组层面混合独立均匀路由与完全相关路由。每种混合都保持均匀的专家边缘分布;rho是明确声明的混合概率。
构造示例 · 可复现数据
查验定量论证
这些曲线根据所声明的模型计算得出,并非来自所引研究的观测结果。每幅图都包含其数值数据和矢量版本。


哪类证据回答哪类问题?
| 路由器构造 | 专家平均份额 | 容量为四时的溢出 |
|---|---|---|
| 每组完全均衡 | 各占一半 | 零 |
| 独立等概率分配 | 期望上各占一半 | 期望丢弃比例为35/256 |
| 为整个组等概率选择一个专家 | 期望上各占一半 | 每组均为一半 |
拟议的验证方案
这是一项拟议的评估设计。未进行生产系统或硬件基准测试。单独执行的有限模型记录于可执行检查中。
- 枚举八个词元和两个专家的全部256种单选分配,并验证分配数量守恒。
- 计算每个整数容量下的溢出,并将枚举结果与二项分布表达式比较。
- 构造具有相同专家边缘分布的组内相关路由,并验证其不同的溢出行为。
- 对于学习得到的模型,记录分组、平局裁决、路由噪声、专家放置和精确的溢出响应。
- 按相关数据切片测量任务质量,同时测量逐组负载、被接受的分配、通信时间和延迟分布。
- 归档模型修订、容量舍入方式、执行轨迹、种子,以及有限计数检查与实际分布式系统基准测试之间的区别。
一手文献确立了什么
Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz et al. · 2017 [1]
贡献。 稀疏门控专家层使条件式参数激活具备实用性,同时处理与负载相关的挑战。
边界。 其经验性收益仅适用于所评估的模型和系统。
文献定位。 稀疏门控层的形式化描述与负载均衡讨论。
William Fedus, Barret Zoph, Noam Shazeer · 2022 [2]
贡献。 Switch Transformers研究了简化的稀疏路由及相关训练与容量选择。
边界。 均衡机制并不普遍保证每个分派组都零溢出。
文献定位。 路由与容量讨论,JMLR 23(120),2022。
Dmitry Lepikhin, HyoukJoong Lee, Yuanzhong Xu et al. · 2020 [3]
贡献。 GShard将条件式专家计算与自动分片相结合,用于大型分布式模型。
边界。 不能仅凭专家数量推断硬件与翻译结果。
文献定位。 条件计算与自动分片的形式化描述;原始预印本记录。
本分析的局限
- 有限示例假定单选路由、八个词元、两个等容量专家,并丢弃溢出分配。
- 相关混合参数是构造出来的,并非对训练模型中路由依赖性的估计。
- 未测量神经专家质量、优化动态、加速器吞吐量或网络通信。
- 不同的路由策略、分配粒度或溢出语义需要不同的定量模型。
这是一篇聚焦于三篇选定奠基性一手文献的分析性综述,包含原创的演算示例。它并非对截至2026年的文献进行穷尽性或系统性调查。文献访问范围与版本说明随参考文献一并记录。
可能改变结论的问题
- 在批次组成变化时,哪些路由依赖性统计量最能预测溢出?
- 容量策略应如何平衡专业化、延迟,以及丢弃分配对特定任务造成的损害?
- 部署诊断能否将性能退化归因于模型路由,或归因于通信与调度?
参考文献
- Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz et al.. Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. arXiv preprint (2017). 10.48550/arXiv.1701.06538.
- William Fedus, Barret Zoph, Noam Shazeer. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. Journal of Machine Learning Research, 23(120):1-39 (2022). Primary source.
- Dmitry Lepikhin, HyoukJoong Lee, Yuanzhong Xu et al.. GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding. arXiv preprint (2020). 10.48550/arXiv.2006.16668.
文献[1]访问范围。 一手元数据、摘要及选定的可访问方法文本;未对补充材料进行穷尽性审查。
版本说明。 v1,提交于2017年一月23日。
文献[2]访问范围。 一手元数据、摘要及选定的可访问方法文本;未对补充材料进行穷尽性审查。
版本说明。 已核查出版方记录与PDF;该记录未提供DOI。
文献[3]访问范围。 一手元数据、摘要及选定的可访问方法文本;未对补充材料进行穷尽性审查。
版本说明。 v1,提交于2020年六月30日;所引书目对象为预印本。
书目身份已与出版方和作者的一手记录核对。下方的文献访问范围与版本说明描述了核查范围;这并非穷尽性的全文审查。
作者与来源
由Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析性构造和拟议评估设计归属于本文。
封面为ImageGen概念插图。技术图表根据明确声明的模型或有限示例计算得出,并提供Python与CSV。它们不是已部署产品的测量结果,也不是复现的性能基准测试。
本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检查所述小型模型,并不是对引用系统的形式化验证。