
要旨
疎な混合エキスパートモデルは、各トークンに対して保存パラメータの一部のみを活性化する。その実際の挙動は、ルーティング、エキスパートの有限容量、通信、および各ディスパッチ群の構成に依存する。本レビューでは、三つの一次資料と独自に構築した有限ルーティングモデルを用いて、これらの制約を区別する。八つのトークンの割り当てを厳密に列挙することで、一様なルーティング確率でも有限容量ではオーバーフローが生じることを示す。第二の構成は、大域的に均衡したエキスパート利用と、著しく不均衡なバッチが共存しうることを示す。再現可能な二つの図と明示的なアサーションが例を裏付ける一方、提案する評価プロトコルは、新たな大規模モデルのベンチマークを主張することなく、ルーティング品質、タスク品質、システムコストを切り分ける。
1. 保存パラメータはスループットを保証しない
疎なエキスパート層は、多数のパラメータを保持しながら、各トークンについて少数のエキスパートだけを評価できる。このアーキテクチャ上の事実だけでは、スループット、メモリ使用量、品質は決まらない。これらの結果は、どのトークンが一緒に割り当てられるか、各エキスパートがどれだけの処理を受け入れられるか、デバイス間でデータがどのように移動するかにも依存する。したがって、有用な分析単位は個々のトークンだけでなく、ディスパッチ群でもある。
本稿は、八つのトークンと二つのエキスパートからなる、意図的に極小化した設定でtop-oneルーティングを検討する。この設定は、独立一様ルーティングのすべての割り当てを厳密に列挙できるほど小さい。これらの例は、平均的なルーティングの均衡や活性パラメータ数の少なさといった一般的な説明にある論理的な隔たりを明らかにする。本番環境のエキスパート層をシミュレートしたり、アクセラレータ性能を推定したりするものではない。その役割は、条件付き計算の設計を効率的、あるいは確実に資源が確保されていると呼ぶ前に、より大規模な実験で何を測定すべきかを明確にすることである。
2. 三つの基礎的貢献が背景を形作る
Shazeerらは、エキスパートを条件付きで活性化する疎なゲート付き混合エキスパート層を開発し、ルーティングと負荷分散の課題に取り組んでいる。Fedus、Zoph、Shazeerは、Switch Transformerの簡略化されたルーティングおよび学習設計を研究している。LepikhinらはGShardにおいて条件付き計算と自動シャーディングを組み合わせている。これらの研究は、エキスパートによるモデリングと分散実行を併せて検討する必要性を明らかにしている。
これらの研究で報告されたスケーリングと品質の結果は、特定のアーキテクチャ、ワークロード、ハードウェア構成に属する。その後のあらゆるエキスパートモデルに対する予測ではない。以下の有限構成は、それらの実験から性能測定値を借用していない。代わりに、厳密な確率計算によって容量オーバーフローとバッチ内の相関を切り分ける。この分離は意図的である。ルーティングの反例は、引用したシステムがそれぞれの試験条件下で失敗することを意味せずに、過度に広い保証を反証できる。例を運用に適用する前に、各システムの実際のオーバーフロー方針とディスパッチのグループ化を確認しなければならない。 [1], [2], [3]
3. 容量はディスパッチ群に適用される方針である
T個のトークンがそれぞれE個のエキスパートの一つを選択し、エキスパートeがn_e個のトークンを受け取るとする。各エキスパートに一律の容量Cを設定すると、そのエキスパートは群内で最大C件の割り当てを処理できる。オーバーフローを破棄する場合、拒否される割り当て数は、n_eからCを引いた値の正の部分の総和である。他の方針では処理を再ルーティングまたは延期することがあり、品質とコストの両方が変わる。
容量係数は、多くの場合、TをEで割った平均負荷に対して表され、整数への丸めを伴う。平均だけでは最大負荷を決定できない。Cがその平均に等しい場合でさえ、ランダムな変動によってオーバーフローが生じる。グループ化の詳細も重要である。容量は、ローカルシャード、ルーティング群、マイクロバッチ、または実装で定義される別の単位ごとに適用される可能性がある。本稿では、一貫して明示的な八トークンの群を一つ用いる。これにより、実際の容量判断が行われうる、より小さな単位を、大域的なバッチサイズで暗黙に置き換えることを防ぐ。
4. 一様な確率は実現負荷の均衡を意味しない
等確率の二つのエキスパートと、独立にルーティングされる八つのトークンを考えると、第一のエキスパートの負荷は二項分布に従う。第二のエキスパートは残りのトークンを受け取る。等確率の割り当ては256通りあるため、あらゆるオーバーフロー統計量の期待値を、標本抽出の不確実性なしに有限列挙で求められる。
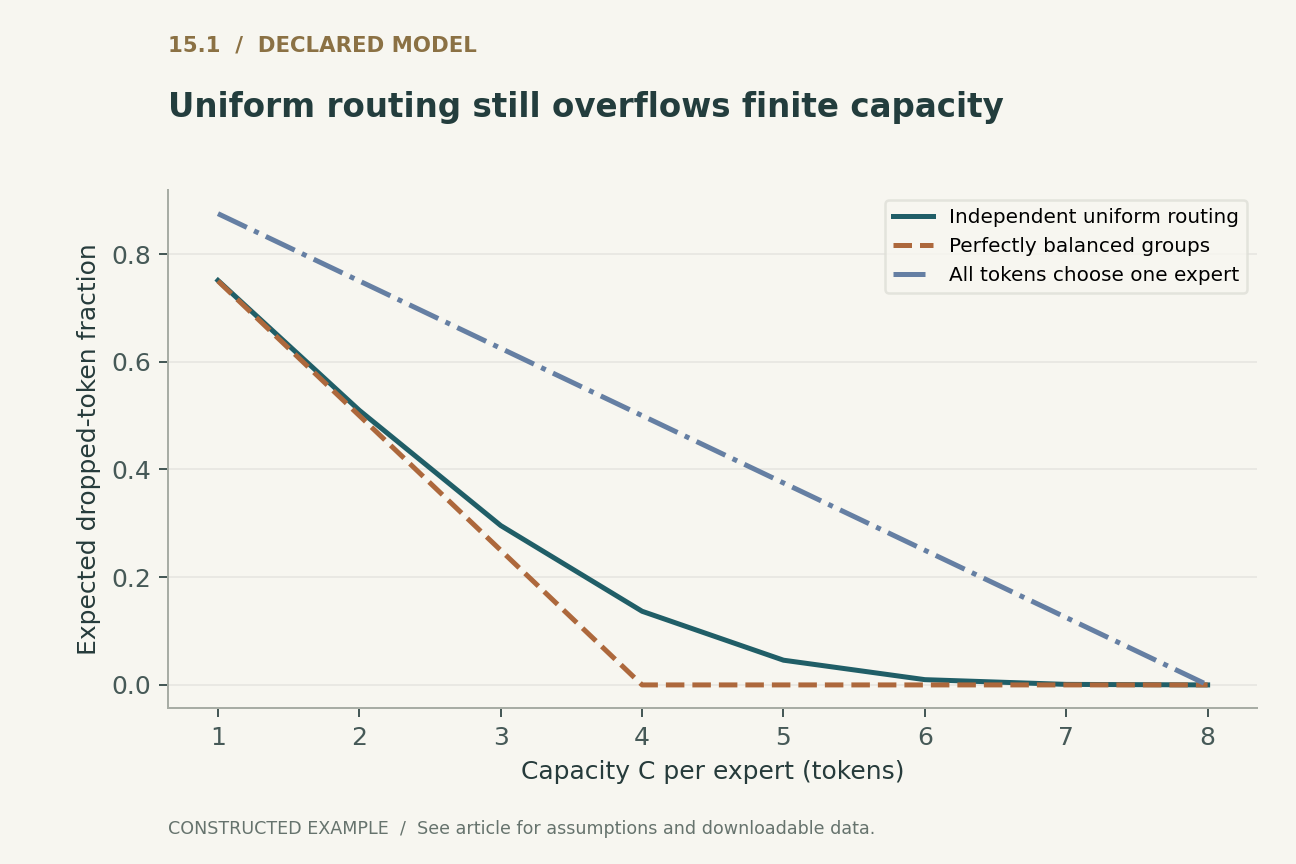
容量が四の場合、四対四の完全に均衡した割り当てではトークンの破棄はない。しかし、独立一様ルータは、明示した破棄方針の下で、期待割合として35を256で割った値、約13.67パーセントのトークンを破棄する。すべてのトークンが同じエキスパートを選ぶ事象はまれだが、それほど極端ではない多くの不均衡も寄与する。図1は、この厳密な期待値を、完全に均衡した割り当ておよび完全に集中した割り当てと、容量一から八にわたって比較する。この図は、学習済みルータが独立または一様であると述べているわけではない。一様な周辺確率だけでは、有限群のオーバーフローが無視できることを裏付ける十分な証拠にならないことを示している。
5. 大域的な均衡はバッチ内の相関を覆い隠しうる
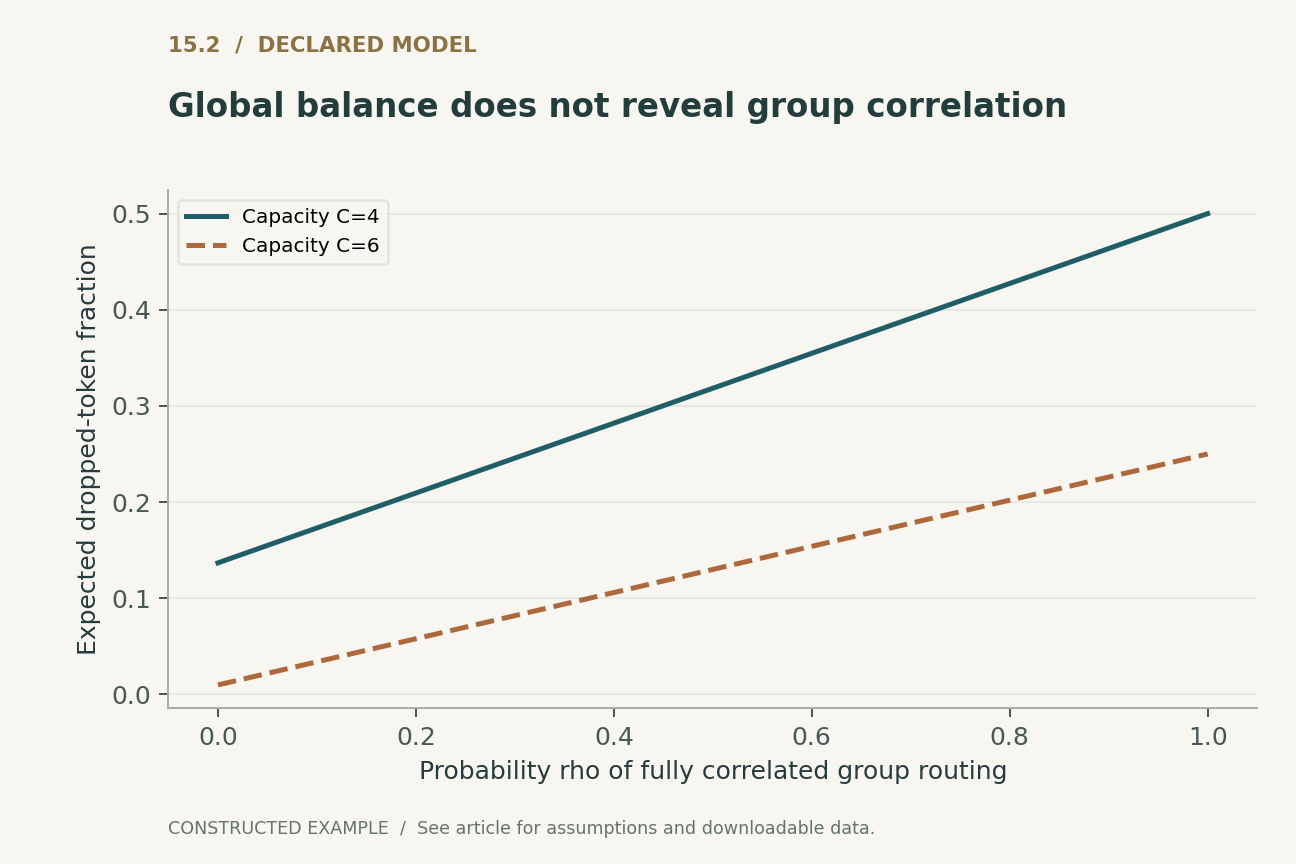
群内のすべてのトークンを一つのエキスパートへ送り、群ごとにそのエキスパートを等確率で選ぶ第二のルータを考える。多数の群にわたれば、各エキスパートは平均で半分のトークンを受け取る。しかし、どの群の内部でも負荷は八対ゼロである。容量が四の場合、同じ破棄方針の下で割り当ての半分がオーバーフローする。大域的な利用状況の要約は完全に均衡して見えても、局所的な容量の挙動は不良でありうる。
二つのケースの間を補間するため、独立一様ルーティングと、この群全体を相関させるルーティングを混合する。ある群に相関した機構を用いる確率をrhoとする。rhoのどの値でも、各トークンのエキスパート選択の周辺分布は一様に保たれる。期待オーバーフローは二つの厳密な期待値の線形混合となり、図2に示される。rhoは混合パラメータであり、実際のモデルに当てはめた統計量ではない。その目的は、平均的なエキスパート比率を変えずに、トークン割り当て間の依存性が容量要件をどう変えるかを切り分けることにある。
6. 負荷分散の目的には対応する診断が必要である
負荷分散損失は最適化の手段であり、各ディスパッチ群が容量制約を満たすことの直接的な証明ではない。定義によって、確率質量、観測された割り当て、または両方がエキスパート間に分散するよう促すことがある。測定粒度と平均化ウィンドウによって、どの形態の不均衡が可視化されたまま残るかが決まる。多数の群にわたって計算された統計量は、上記の相関した構成を覆い隠しうる。
したがって評価には、周辺比率とともに、群ごとの最大負荷、オーバーフロー件数、空のエキスパート数の分布を含めるべきである。ルーティングがtop-twoまたはより一般的な場合は、トークンだけでなくエキスパートへの割り当てを数え、重みとオーバーフローの相互作用を記述する必要がある。トークンの破棄、残差経路によるバイパス、再ルーティング、遅延実行は異なる挙動である。有限ケースのコードがtop-one割り当てと破棄を仮定するのは、参照例を厳密に保つためだけである。その数値的な割合を別の方針に適用するのは誤りだが、方針とグループ化を明示すべきだという要求を適用することは引き続き有用である。
7. ルーティング品質はタスク品質と同義ではない
完全に均衡したルーティングは、トークンの内容を見ずに巡回的に割り当てることで達成できる。この戦略は負荷を制御するが、各トークンが適切なエキスパートに届くことを保証しない。逆に、現在の入力分布が、あるエキスパートの表す専門性に実際に集中しているために、ルータがそのエキスパートを優先する場合もある。その場合、均衡を強制するとモデリングの目的が変わりうる。
適切な問いは、均衡が普遍的に望ましいかどうかではなく、モデルが専門化と資源制約の間でどのように折り合いをつけるかである。提案する研究では、ルーティング判断をホールドアウトデータにおけるタスク結果と関連付け、オーバーフローが特定の系列の種類、言語、データ領域に不均衡な影響を及ぼすかを調べるべきである。これらの分析には、実際のモデル出力とデータセットの定義が必要であり、負荷ヒストグラムから推論することはできない。ここでの厳密な例は、意図的に意味内容を除外している。この限界は同時に価値でもある。すなわち、学習されたエキスパートへの分解が意図したタスクに役立つ証拠と、システム統計量とを取り違えることを防ぐ。
8. 通信と同期をコストモデルに含める必要がある
少数のエキスパートを活性化すれば、すべてのエキスパートを評価する場合に比べて一部の算術演算は減るが、トークンのディスパッチと回収に通信や同期が伴うことがある。トークン当たりの実際の計算が少なくても、エキスパート全体の保存にはデバイス間への分散が必要な場合もある。性能に関する主張には、パディング、未使用容量、通信と計算の重なりに加え、これらのコストを含めなければならない。
最も負荷の高いエキスパートに基づく単純な限界値が負荷のボトルネックを明らかにできるのは、明示的なスケジューリングモデルの下に限られる。これは測定に基づくレイテンシ予測ではない。実際のカーネルには、バッチサイズの閾値、デバイス速度の差、他の処理との競合がありうる。したがってベンチマークでは、理論上の乗算回数だけでなく、段階ごとの時間とエンドツーエンドのレイテンシ分布を報告すべきである。ローカルの成果物が提供するのはルーティングの件数と期待値であり、全対全通信を測定したり、それらの件数からハードウェアの高速化率を推論したりはしない。
9. 再現性にはルーティング判断の記録が必要である
基礎となるトークン表現とモデル重みが固定されていても、バッチ構成が変われば疎な層の挙動は変化しうる。容量の割り当て調停、同順位の解消、ルーティングノイズ、順序によって、どの割り当てが受け入れられるかが変わる可能性がある。そのような選択が出力に影響する場合、実行の再現にはモデル初期化に用いた乱数シード以上の情報が必要である。
統制された実験では、ルータの設定、容量係数と丸め、グループ化規則、エキスパート配置、オーバーフロー方針、決定論的な同順位解消の挙動を記録する必要がある。集約診断と、非公開の入力データを露出しない群ごとの代表的なトレースを保存する。同じ固定トークン集合を複数の許容されるグループ化で比較し、隣接する事例への感度を明らかにする。提案する試験は、すべてのエキスパートモデルが非決定論的であるとは仮定しない。意図されたバッチ処理方式の下で、実装に文書化された意味論が保たれるかを問うものである。有限列挙は、隠れたルーティングのランダム性や標本誤差のない、再現可能なベースラインを一つ提供する。
10. 疎な容量についての、より強固な主張
妥当性を擁護できる疎な容量の主張では、保存されるパラメータ数、試みられるエキスパート割り当て数、実際に処理される数、残りの扱いを明示する。その上で、宣言したワークロードの下でのタスク結果と測定された資源使用量を報告する。これらの量により、モデリング上の改善を、ルーティング方針の変更やハードウェア利用状況の変化から区別できる。
二つの厳密な構成は、限定的だが重要な境界を示している。一様なルーティング確率は有限群のオーバーフローを解消せず、一様な大域的エキスパート比率は群内相関を明らかにしない。いずれの結果も混合エキスパートアーキテクチャに反対するものではない。両者とも、条件付きの容量が利用可能となる条件を評価すべきだと論じている。付属コードは小規模なケースを列挙し、各曲線を生成する仮定を公開している。大規模モデルの評価でも、同じ明確さを保ちつつ、ここで意図的に除外した複雑性、すなわち学習されたルーティング、不均質なトークン、通信、最適化、タスク固有の品質を追加すべきである。
ローカルで実行済み · 限定された範囲
top-oneルーティングの全数列挙と、周辺分布を一致させた相関のある反例
八トークン、二エキスパート、破棄方針を伴うtop-oneルーティング。整数による計数と期待値のみであり、学習済みMoEや分散システムのベンチマークではない。
287件のアサーションに合格。 これらの検証は、提示した例を検証するものであり、引用したシステムを検証するものではない。
記録された検証証跡を確認
{
  "assignments_enumerated": 256,
  "tokens": 8,
  "experts": 2,
  "capacities": [
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ],
  "iid_drop_at_capacity4": 0.13671875,
  "correlated_drop_at_capacity4": 0.5,
  "expected_loads_both": [
    4,
    4
  ]
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの式と明示的な仮定
(1) ゲーティング重みを明示的に定義した疎なエキスパートの組み合わせ。有限の例ではtop-one割り当てに限定し、出力値ではなく負荷を分析する。
(2) 係数cを用いるエキスパートごとの一律容量と、オーバーフローを破棄する方針。プロットではT=8、E=2、および整数Cを直接用いる。
(3) 八トークン、二エキスパートにおける、独立一様なtop-oneルーティングの厳密な期待値。C=4では、破棄割合の期待値は35/256である。
(4) 独立一様ルーティングと完全に相関したルーティングの群単位の混合。どの混合でもエキスパートの周辺分布は一様に保たれる。rhoは明示された混合確率である。
構成した例 · 再現可能なデータ
定量的な論証を確認
これらの曲線は明示されたモデルから計算したものである。引用研究の観測結果ではない。各図には数値データとベクター版を添付している。


どの証拠がどの問いに答えるか
| ルータの構成 | 平均エキスパート比率 | 容量四でのオーバーフロー |
|---|---|---|
| すべての群で完全に均衡 | それぞれ二分の一 | ゼロ |
| 独立な等確率割り当て | 期待値でそれぞれ二分の一 | 破棄割合の期待値は35/256 |
| 群全体について一つのエキスパートを等確率で選択 | 期待値でそれぞれ二分の一 | 各群で二分の一 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証に記録している。
- 八トークン、二エキスパートのtop-one割り当て全256通りを列挙し、割り当て数の保存を検証する。
- 各整数容量の下でオーバーフローを計算し、列挙結果を二項分布の式と比較する。
- 同一のエキスパート周辺分布を持つ群相関ルーティングを構成し、異なるオーバーフロー挙動を検証する。
- 学習されたモデルについては、グループ化、同順位解消、ルーティングノイズ、エキスパート配置、オーバーフローへの厳密な対応を記録する。
- 関連するデータ区分ごとにタスク品質を測定するとともに、群ごとの負荷、受理された割り当て、通信時間、レイテンシ分布を測定する。
- モデルの改訂、容量の丸め、実行トレース、シード、および有限計数による検証と実際の分散システムベンチマークの区別を保存する。
一次資料が確立していること
Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz et al. · 2017 [1]
貢献。 疎なゲート付きエキスパート層は、負荷に関連する課題に対処しつつ、条件付きのパラメータ活性化を実用的なものにする。
適用範囲の境界。 その実証的な改善は、評価されたモデルとシステムに固有である。
資料内の該当箇所。 疎なゲート付き層の定式化と負荷分散の議論。
William Fedus, Barret Zoph, Noam Shazeer · 2022 [2]
貢献。 Switch Transformersは、簡略化された疎なルーティングと、それに関連する学習および容量の選択を研究している。
適用範囲の境界。 負荷分散機構は、あらゆるディスパッチ群でオーバーフローがゼロになることを包括的に保証するものではない。
資料内の該当箇所。 ルーティングと容量の議論、JMLR 23(120)、2022。
Dmitry Lepikhin, HyoukJoong Lee, Yuanzhong Xu et al. · 2020 [3]
貢献。 GShardは、大規模分散モデルのために、条件付きエキスパート計算と自動シャーディングを組み合わせる。
適用範囲の境界。 ハードウェアと翻訳の結果は、エキスパート数だけから推論できない。
資料内の該当箇所。 条件付き計算と自動シャーディングの定式化。原プレプリントの記録。
本分析の限界
- 有限の例は、top-oneルーティング、八つのトークン、等容量の二つのエキスパート、オーバーフローの破棄を仮定している。
- 相関混合パラメータは構成したものであり、学習済みモデルのルーティング依存性を推定したものではない。
- ニューラルエキスパートの品質、最適化ダイナミクス、アクセラレータのスループット、ネットワーク通信は測定していない。
- ルーティング方針、割り当て粒度、オーバーフローの意味論が異なれば、別の定量モデルが必要となる。
選定した三つの基礎的一次資料を対象とする焦点を絞った分析的レビューであり、独自の計算例を含む。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセス範囲と版に関する注記を参考文献とともに記録している。
結論を変えうる問い
- バッチ構成が変化する状況で、どのルーティング依存性統計量がオーバーフローを最もよく予測するか。
- 容量方針は、専門化、レイテンシ、割り当ての破棄がもたらすタスク固有の悪影響の間で、どのように均衡を取るべきか。
- デプロイ時の診断によって、性能低下をモデルのルーティングと通信・スケジューリングのどちらに帰属させるべきか判断できるか。
参考文献
- Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz et al.. Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. arXiv preprint (2017). 10.48550/arXiv.1701.06538.
- William Fedus, Barret Zoph, Noam Shazeer. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. Journal of Machine Learning Research, 23(120):1-39 (2022). Primary source.
- Dmitry Lepikhin, HyoukJoong Lee, Yuanzhong Xu et al.. GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding. arXiv preprint (2020). 10.48550/arXiv.2006.16668.
資料[1]の参照範囲。 一次メタデータ、要旨、アクセス可能な方法記述の一部。補足資料の網羅的な監査は行っていない。
版に関する注記。 v1、2017年一月23日投稿。
資料[2]の参照範囲。 一次メタデータ、要旨、アクセス可能な方法記述の一部。補足資料の網羅的な監査は行っていない。
版に関する注記。 出版社の記録とPDFを確認済み。当該記録にはDOIが提示されていない。
資料[3]の参照範囲。 一次メタデータ、要旨、アクセス可能な方法記述の一部。補足資料の網羅的な監査は行っていない。
版に関する注記。 v1、2020年六月30日投稿。引用対象の書誌資料はプレプリントである。
書誌情報の同一性を、出版社と著者による一次記録と照合した。以下の資料アクセスと版に関する注記は、その範囲を記述するものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示しており、分析的構成と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は明示されたモデルまたは有限の例から計算され、PythonとCSVを提供している。稼働中の製品の測定や、性能ベンチマークの再現ではない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示された小規模モデルを検証するものであり、引用したシステムの形式検証ではない。