
要旨
低ランク適応は重み更新を因子分解することで学習可能なパラメータ数を削減するが、ランクだけで関数としての表現能力や下流タスクの品質が決まるわけではない。本レビューは、行列近似、入力で重み付けされた出力誤差、因子分解の幾何構造、最適化におけるスケーリング、デプロイ時のコスト算定を区別する。三つの一次資料を出発点として、LoRA、内在次元、ランク依存のスケーリングを論じる。独自に構成した例により、特異値の減衰が重み付けのない近似誤差をどのように支配するか、また重み空間で最適なランク一の更新が、入力共分散の変化の下ではいかに不適切になりうるかを示す。再現可能な図、厳密な行列検証、および提案する評価プロトコルによって、これらの演繹が確立する範囲を明確にするものであり、新たな言語モデルのベンチマーク結果を主張するものではない。
1. ランクが制約される対象を明確にする
ランク制約が適用されるのは特定の層の行列であり、ネットワーク全体が表現できる関数の集合に直接適用されるわけではない。一つの線形作用素に対する低ランク更新は、非線形性、残差経路、正規化、他の層での更新と相互作用しうる。したがって、結果として生じる関数の変化は、重要な方向ではなお制約されつつも、個々の行列のランクから示唆されるものより豊かになりうる。
厳密な分析では、学習可能なパラメータ数、実現された重み更新のランク、明示された入力分布上での出力の変化、下流タスクの評価基準という四つの量を区別する。これらは関連しているが、互いに置き換えられるものではない。本稿は、厳密な反例を構成できる単一の線形層から議論を始める。ここで用いる行列は構成したものであり、学習済み言語モデルから抽出したものではない。その目的は、表現能力に関する主張を複雑なネットワークの実測性能に結び付ける前に、その論理を検証することにある。
2. 三つの一次資料が提起する論点
Huらは、事前学習済み重みを凍結し、低ランク更新の因子を学習するLoRAを導入し、適応に関する実験結果と、統合可能な線形更新を示した。Aghajanyan、Zettlemoyer、Guptaは、言語モデルのファインチューニングにおける低次元の再パラメータ化を研究した。そこでの内在次元の概念は、層の更新行列のランクと同一ではない。Kalajdzievskiは、LoRAにおけるランク依存のスケーリングを研究し、同論文の分析の下でランクの平方根に基づくスケーリングを提案した。
これらの貢献は、制約されたパラメータ化でタスクを解けるか、その実効次元をどう測るか、そしてパラメータ化が変化しても最適化を比較可能に保てるか、という三つの独立した問いを提起する。いずれも、特定のランクがあらゆるドメインやモデルに十分であるという普遍的な規則を与えるものではない。以下の例は、引用した性能表を再現するものではない。小さな行列の厳密な性質を導き、その性質を用いて、将来のファインチューニング比較に必要な統制条件を明確にする。 [1], [2], [3]
3. パラメータの削減量は固定ランク多様体の次元とは等しくない
d行k列の重み行列に対し、d行r列の因子Bとr行k列の因子Aが含むスカラーパラメータ数は、rにdとkの和を掛けた数である。その積のランクは高々rである。ランクrの一般的な点では、行列多様体の次元はrに、dとkの和からrを引いた量を掛けた値となる。この差は因子分解の冗長性を反映している。Bに可逆なr行r列の行列を掛け、Aにその逆行列を掛けても、積は変わらない。
このゲージ自由度は、最適化器の軌跡を解釈したり、因子のノルムを比較したりする際に重要である。二組の因子は、個々のノルムや勾配が異なっていても、まったく同じ更新を実装できる。学習可能なスカラーの個数を数えることは、最適化器の状態を保存するための容量を考えるうえで有用だが、独立した関数的方向を数えることとは同じではない。実行可能な例では、固定した可逆変換に対する不変性を検証する。有限精度演算や特定の適応的最適化器の下で、得られる最適化問題が数値的に等価であるとは主張しない。
4. 特異値の裾は厳密な線形基準を与える
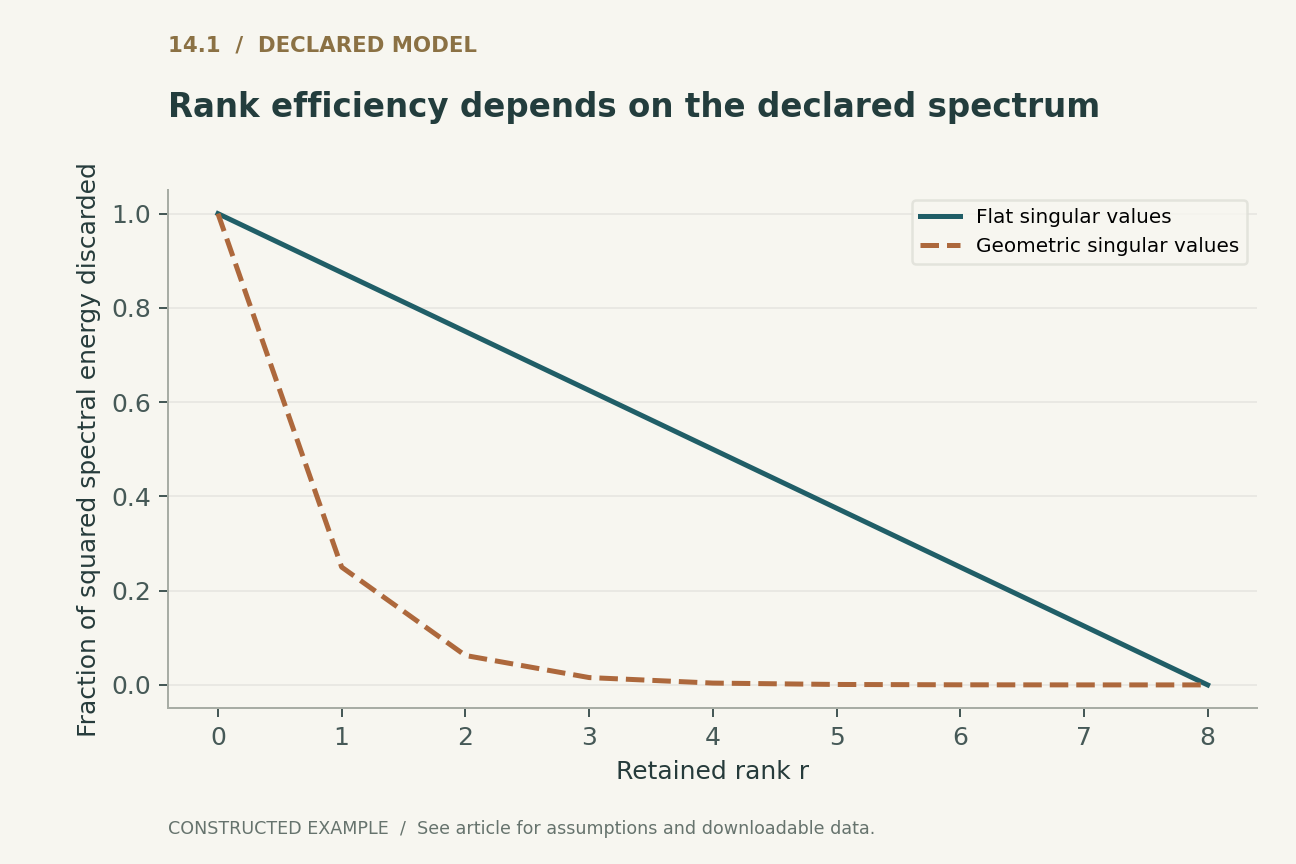
求める更新行列がすでに既知であり、評価基準が重み付けのないフロベニウス誤差の二乗であるとする。最良のランクr近似は、最大のr個の特異成分を保持する。残差の二乗誤差は、捨てた特異値の二乗の和である。これは、ニューラルネットワークのファインチューニングよりはるかに単純な設定において、厳密な基準を与える。そこには非凸なタスク損失も、変化する表現も、未知の目標更新も存在しない。
図1は、構成した二つの八次元スペクトルについて、捨てられるスペクトルエネルギーの割合を比較する。一方は平坦であり、もう一方は等比的に減衰する。後者では、小さなランクでより多くのエネルギーを捉えられる。この記述は、重み空間のノルムの下でのこれらのスペクトルに関するものである。実際の適応更新がいずれかのスペクトルを持つことや、スペクトルエネルギーを一致させればタスクの挙動を維持できることを確立するものではない。この図は、低ランク構造に関する経験的な主張を精密化するための基準を提供する。
5. 入力共分散は考慮すべき近似問題を変える
線形層と中心化された入力について、出力の二乗誤差の期待値は入力共分散に依存する。それは、残差更新、その共分散、残差の転置を順に掛けた行列のトレースである。入力が等方的で共分散が単位行列なら、これはフロベニウス誤差の二乗に帰着する。そうでなければ、入力の方向ごとに異なる重みが与えられる。
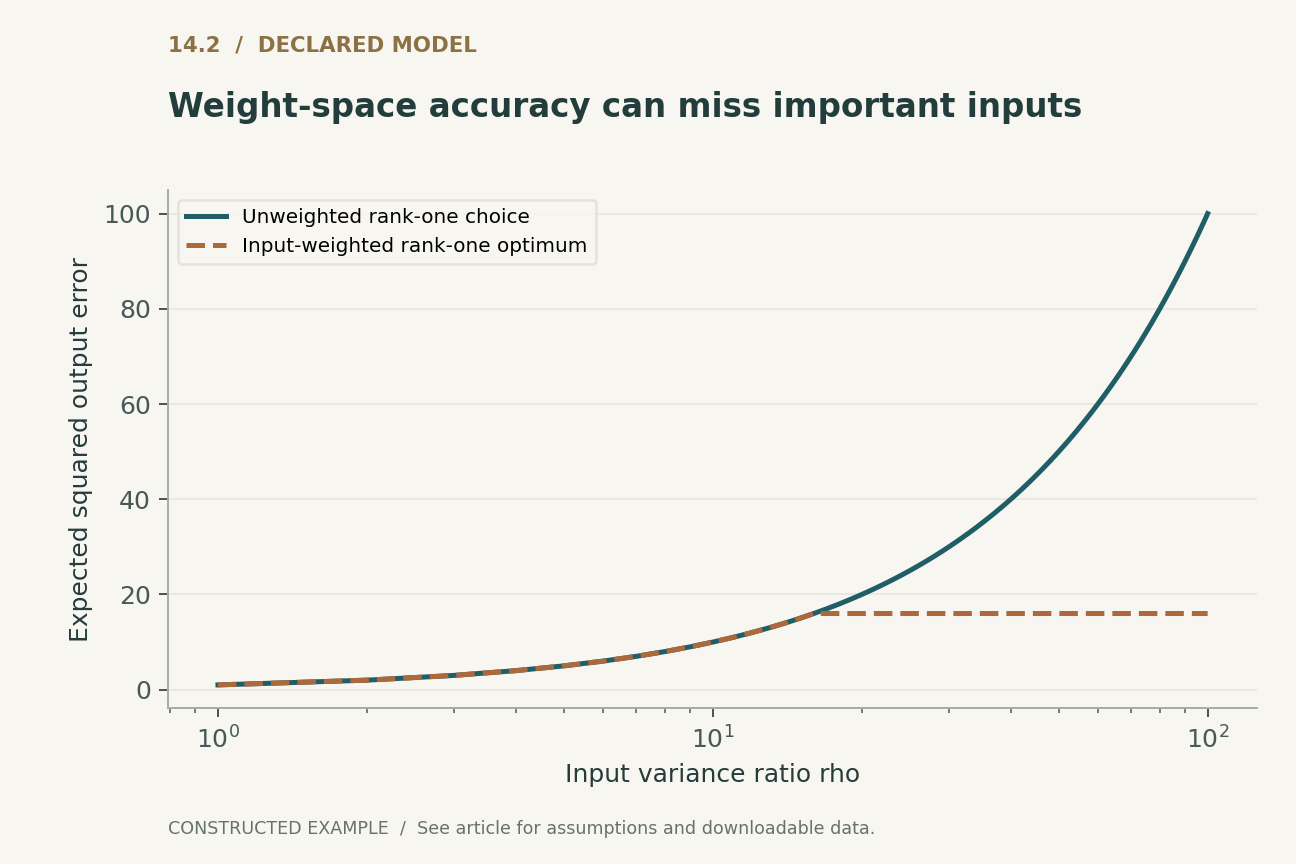
対角成分が四と一である目標更新を考える。重み付けのないランク一近似は第一の方向を保持し、行列の二乗誤差として一を残す。次に、入力共分散を対角成分が一とrhoの対角行列とする。同じ近似の出力誤差はrhoとなる。代わりに第二の方向を保持すると、出力誤差は十六となる。rho = 100では、重み空間に基づく選択は、指定された入力分布上ではるかに大きな損失を生む。図2はrhoを変化させ、重み付けのない選択と、ランク一で最適な出力基準を比較する。これは分布に依存する厳密な反例であり、LoRAの失敗率を測定したものではない。
6. 入力分布の変化は望ましい更新を逆転させうる
共分散の例は、ドメインシフトに対して実践的な含意を持つ。ある分布の下で選ばれた更新は、その限られたランクを、別の分布では重要性が低下する方向に割り当てている可能性がある。この問題は、更新行列の特異値だけを報告しても解決しない。その層に到達する入力と、その出力に対する下流の感度についても証拠が必要である。
入力共分散が正定値である単一の線形層では、目標更新に共分散の平方根を掛け、その空間で低ランク近似を求めてから逆変換することで、重み付き問題を変換できる。共分散が特異であれば、評価基準は観測された台に限定され、一部の方向は同定されない。深いネットワークでは、後続の非線形変換が別の感度重み付けを導入するため、この線形的構成は診断手段にすぎない。それでも、推奨ランクをアーキテクチャに依存しない定数として示すのではなく、タスクとドメインの情報を添えるべき理由を明確にしている。
7. 因子の初期化とスケールは学習に影響する
一般的な因子分解の初期化では、一方の因子をゼロ、もう一方を非ゼロにすることで、初期更新をゼロにする。このとき積はゼロだが、二つの因子に関する勾配の挙動は対称とは限らない。Bがゼロなら、積に依存する損失のAに関する初期勾配はゼロである一方、Bに関する勾配は非ゼロになりうる。したがって初期の学習には、完全な行列による直接的なパラメータ化には存在しない方向構造がある。
ランクを増やすと、積に含まれる項の数も変わる。因子の再スケーリングを許せば表現可能な非ゼロ更新の集合が同じであっても、乗法的なスケールは活性値と勾配の大きさを変えうる。そのため、ランクを走査する際には、スケール、初期化の分散、学習率、最適化器の設定を記録すべきである。本稿の有限規模の行列検証は、表現に関する恒等関係を確立するものであり、最適な最適化器のスケジュールを確立したり、深いネットワークに対する普遍的なスケーリング則を検証したりするものではない。
8. 層への配置は表現能力の予算の一部である
学習可能なパラメータ数が同じ二つの構成でも、それらのパラメータを異なる層や射影に配置できる。したがって、利用可能になる関数的方向は大きく異なりうる。多数の層に小さなランクを割り当てることは、一般に一つの層に大きなランクを割り当てることと等価ではない。線形ネットワークでさえ、変更した行列の積は交差項を生む。非線形ネットワークでは、その関係はさらに複雑になる。
意味のある比較では、可能な限り総資源予算を一定に保ち、配置規則を開示すべきである。また、検証前に選ばれた設計と、大規模な非公開の探索を通じて選ばれた設計を区別すべきである。そうしなければ、ランク配分の見かけ上の優位性は、追加の調整労力を反映している可能性がある。ここでの小規模な例は、数学的な基準を厳密に保つために一つの層を切り出している。将来のネットワーク研究では、層への介入と活性値の診断を追加し、単一層の結果をモデル全体の表現力に関する定理ではなく、妥当性の確認として扱うべきである。
9. デプロイ時の削減効果は選択する実行経路に依存する
凍結した基盤モデルに、多数のタスク固有の低ランク因子を組み合わせると、独立した完全なチェックポイントを多数保存する場合に比べて、保存容量を削減できる。更新を統合すれば、選択した単一タスクに対して因子分解された分岐を別途評価せずに済む。これらは異なるデプロイ構成であり、アダプターを動的に切り替えたりバッチ化したりする場合、どちらもそれだけで総サービングコストを決定するものではない。
学習メモリには、活性値、勾配、最適化器の状態、一時的な作業領域、凍結した基盤重みも含まれる。パラメータ数はその一項にすぎない。ベンチマークでは、これらの区分と、実際の数値精度、系列長、バッチサイズ、メモリアロケータの挙動を報告すべきである。アダプターの統合によって量子化や数値丸めが変わるかどうかも記録すべきである。本稿はGPUメモリ、レイテンシ、スループットを測定していない。主張は厳密なパラメータ数と行列恒等式に限定され、実装に依存する削減効果は、明示的な算定を伴う別途設計された実験に委ねる。
10. 根拠をもって主張できる表現能力には条件がある
中心的な問いは、低ランクが良いか悪いかではない。特定の制約された更新族が、指定された分布と最適化予算の下で、指定された目的を達成できるかどうかである。スペクトルの例は、目標更新が既知のとき、最良の場合の線形的な基準を与える。共分散の例は、評価基準を重みから出力へ移すと、この基準さえ変わることを示している。
したがって実験報告には、ランク、配置、スケーリング、探索労力、ドメイン構成、実行間の不確実性を含めるべきである。全パラメータをファインチューニングするベースラインが実行可能な場合は、学習された重み間の距離だけでなく、関数としての結果を比較すべきである。パラメータの対称性によって重みの距離が誤解を招くことがあるためである。実行不可能な場合は、制約されたベースラインを無制約の能力とみなすのではなく、その限界を明示すべきである。提供する実行可能な例は、こうした主張をより厳密にすることを意図している。すなわち、パラメータ数が少ないという事実から、適応が何を表現できるかについて意味のある主張へ進むために必要な仮定を明らかにする。
ローカルで実行済み · 限定された範囲
回転を加えたSVD残差、因子のゲージ不変性、重み付き線形出力誤差
構成した行列と、中心化された入力に対する線形の評価基準のみを対象とする。学習済みアダプター、最適化器の挙動、アクセラレータの資源削減については主張しない。
47件のアサーションが成功した。 これらの検証は、提供した例を検証するものであり、引用したシステムを検証するものではない。
記録された検証証跡を確認する
{
  "matrix_dimension": 8,
  "ranks": [
    0,
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ],
  "rho100_unweighted_error": 100,
  "rho100_weighted_error": 16,
  "factor_gauge_matrix": [
    [
      2,
      1
    ],
    [
      0,
      3
    ]
  ]
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全体を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) スケールcを明示したLoRA型の因子分解。ランクは高々rである。Pは保存される学習可能な因子成分の数であり、固定ランク多様体の独立した座標数ではない。
(2) Qは可逆であり、r <= min(d,k)である。次元に関する記述は、ランクが厳密にrである行列の滑らかな多様体についてのものである。
(3) 重み付けのないフロベニウス基準の下での最良低ランク近似。特異値は非増加順に並んでいる。
(4) 有限の共分散Sigma_xを持つ中心化された入力。図2ではDelta W = diag(4,1)、Sigma_x = diag(1,rho)を用い、重み付けのない選択の誤差はrho、最適なランク一の誤差はmin(16,rho)となる。
構成した例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示されたモデルから計算したものである。引用した研究の観測結果ではない。各図には数値データとベクトル版を添付している。


どの証拠がどの問いに答えるのか
| 主張 | 必要な明示事項 | 反例または限界 |
|---|---|---|
| 小さなランクで更新を捉えられる | 目標行列と近似のノルム | 平坦なスペクトルでは裾に相当量のエネルギーが残る |
| 重み誤差が小さければ出力が維持される | 入力共分散と下流の感度 | 重みの分散が小さい方向が、分布変化後の入力に対して支配的になりうる |
| パラメータが少なければデプロイのコストが低い | 統合、バッチ処理、精度、メモリの算定 | 活性値とルーティングのコストは依然として実装に依存する |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限規模モデルは、実行可能な検証の節に記録している。
- 平坦なスペクトルと減衰するスペクトルを持つ厳密に指定された目標行列を選び、打切りSVDの残差を独立に検証する。
- 固定した行列と明示した数値許容誤差を用いて、因子分解のゲージ不変性とランクの限界を確認する。
- ランク一の選択が逆転する例を含め、複数の共分散の下で入力重み付き誤差を評価する。
- ネットワーク実験では、アダプターの配置、ランク、スケール、初期化、最適化器、調整予算を事前に記録する。
- ホールドアウトデータでのタスク品質とドメイン変化時の挙動を、実際のメモリおよび時間の測定と併せて、乱数シード間で比較する。
- 基盤モデルのリビジョン、アダプター因子、統合設定、評価データのバージョン、および利用できない全パラメータ調整ベースラインに伴う限界を保存する。
一次資料が確立していること
Edward J. Hu, Yelong Shen, Phillip Wallis et al. · 2021 [1]
貢献。 LoRAは事前学習済み重みを凍結したまま学習可能な更新を因子分解し、統合した線形更新を可能にする。
適用範囲の限界。 報告された適応品質と資源削減は、その論文の構成に固有のものである。
資料内の該当箇所。 手法およびランクの実証的調査。arXiv v2。
Armen Aghajanyan, Luke Zettlemoyer, Sonal Gupta · 2020 [2]
貢献。 低次元の再パラメータ化は、言語モデルのファインチューニングを捉える視点を提供する。
適用範囲の限界。 この設定における内在次元は、層の更新行列のランクと同一ではない。
資料内の該当箇所。 内在次元の定式化とファインチューニング実験。元のプレプリント記録。
Damjan Kalajdzievski · 2023 [3]
貢献。 ランク依存のスケーリングはLoRAの最適化に大きく影響しうる。同論文は平方根に基づくスケーリングを分析している。
適用範囲の限界。 この分析によって、初期化と最適化器に関する仮定を調整し開示する必要がなくなるわけではない。
資料内の該当箇所。 スケーリング係数の分析。arXiv v1。
本分析の限界
- 実行可能な行列例が検証するのは代数的な表現能力と分布による重み付けであり、学習済みニューラルアダプターの品質ではない。
- 共分散の基準は、単一の線形層と出力の二乗誤差を仮定する。下流の非線形性は複雑さを加える。
- このローカル成果物では、GPUメモリ、学習スループット、デプロイ時のレイテンシを測定していない。
- パラメータの内在次元、行列ランク、タスクの意味的複雑さは異なるものであり、追加の証拠なしに相互に置き換えることはできない。
選定した三つの基礎的な一次資料に焦点を当て、独自の計算例を含む分析的レビューである。2026年までの文献を網羅的または系統的に調査したものではない。資料の閲覧範囲とバージョンに関する注記は、参考文献とともに記録している。
結論を変えうる問い
- 入力と下流の感度の測定は、更新スペクトルだけを用いる場合よりも確実にランク配分を導けるか。
- 有用な適応部分空間は、ドメインや系列長の変化に対してどの程度安定しているか。
- 表現上の限界と、最適化およびハイパーパラメータ探索の限界を切り分ける比較プロトコルは何か。
参考文献
- Edward J. Hu, Yelong Shen, Phillip Wallis et al.. LoRA: Low-Rank Adaptation of Large Language Models. arXiv preprint (2021). 10.48550/arXiv.2106.09685.
- Armen Aghajanyan, Luke Zettlemoyer, Sonal Gupta. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. arXiv preprint (2020). 10.48550/arXiv.2012.13255.
- Damjan Kalajdzievski. A Rank Stabilization Scaling Factor for Fine-Tuning with LoRA. arXiv preprint (2023). 10.48550/arXiv.2312.03732.
資料[1]の閲覧範囲。 一次メタデータ、要旨、および閲覧可能な手法本文の一部。補足資料の網羅的な監査は行っていない。
バージョン注記。 v2、2021年十月16日改訂。引用している書誌上の対象はプレプリントである。
資料[2]の閲覧範囲。 一次メタデータ、要旨、および閲覧可能な手法本文の一部。補足資料の網羅的な監査は行っていない。
バージョン注記。 v1、2020年十二月22日投稿。引用している書誌上の対象はプレプリントである。
資料[3]の閲覧範囲。 一次メタデータ、要旨、および閲覧可能な手法本文の一部。補足資料の網羅的な監査は行っていない。
バージョン注記。 v1、2023年十一月28日投稿。
書誌的な同一性は、出版社および著者の一次記録と照合した。以下の資料閲覧とバージョンに関する注記は、その範囲を示している。全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示している。分析上の構成と提案した評価設計は、本稿に帰属する。
表紙はImageGenによる概念イラストである。技術的な図は、明示したモデルまたは有限規模の例から計算しており、PythonとCSVを提供している。デプロイ済み製品の測定でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示された小規模モデルを検証するものであり、引用したシステムの形式的検証ではない。