
Resumen
La adaptación de bajo rango reduce el número de parámetros entrenables mediante la factorización de las actualizaciones de pesos, pero el rango por sí solo no determina la capacidad funcional ni la calidad en las tareas posteriores. Esta revisión distingue la aproximación matricial, el error de salida ponderado por las entradas, la geometría de la factorización, el escalado de la optimización y la contabilización del despliegue. Tres fuentes primarias motivan la discusión de LoRA, la dimensión intrínseca y el escalado dependiente del rango. Ejemplos construidos de forma independiente muestran cómo el decaimiento de los valores singulares controla un error de aproximación no ponderado y cómo una actualización de rango uno óptima en el espacio de pesos puede resultar deficiente al cambiar la covarianza de entrada. Figuras reproducibles, comprobaciones matriciales exactas y un protocolo de evaluación propuesto delimitan lo que establecen estas deducciones, sin reivindicar nuevos resultados de evaluación comparativa de modelos de lenguaje.
1. Especificar el objeto cuyo rango se restringe
Una restricción de rango se aplica a una matriz en una capa determinada, no directamente al conjunto de funciones que puede representar una red completa. Una actualización de bajo rango de un operador lineal puede interactuar con no linealidades, conexiones residuales, normalización y actualizaciones en otras capas. Por tanto, el cambio funcional resultante puede ser más rico de lo que sugiere el rango de una sola matriz, aunque siga estando restringido en direcciones importantes.
Un análisis riguroso distingue cuatro magnitudes: el número de parámetros entrenables, el rango de la actualización de pesos efectivamente obtenida, el cambio en las salidas sobre una distribución de entrada especificada y el criterio de la tarea posterior. Están relacionadas, pero no son intercambiables. Este artículo parte de una única capa lineal porque ese entorno permite contraejemplos exactos. Sus matrices se han construido, no se han extraído de un modelo de lenguaje entrenado. Su finalidad es poner a prueba la lógica de las afirmaciones sobre capacidad antes de vincularlas al rendimiento empírico de una red compleja.
2. Qué motivan las tres fuentes primarias
Hu y sus colaboradores introducen LoRA congelando los pesos preentrenados y aprendiendo factores de actualización de bajo rango, con resultados empíricos de adaptación y una actualización lineal que puede fusionarse. Aghajanyan, Zettlemoyer y Gupta estudian reparametrizaciones de baja dimensión del ajuste fino de modelos de lenguaje. Su noción de dimensión intrínseca no es idéntica al rango matricial de la actualización de una capa. Kalajdzievski estudia el escalado dependiente del rango en LoRA y propone un escalado con la raíz cuadrada del rango dentro del análisis del artículo.
Estas contribuciones motivan tres preguntas distintas: si una parametrización restringida puede resolver una tarea, cómo se mide su dimensión efectiva y si la optimización sigue siendo comparable cuando cambia esa parametrización. Ninguna ofrece una regla universal según la cual un rango específico baste para todos los dominios o modelos. Los ejemplos siguientes no reproducen las tablas de rendimiento citadas. Derivan propiedades exactas de matrices pequeñas y las utilizan para especificar los controles necesarios en una futura comparación de ajuste fino. [1], [2], [3]
3. El ahorro de parámetros no equivale a la dimensión de la variedad de rango fijo
Para una matriz de pesos de d por k, los factores B, de tamaño d por r, y A, de tamaño r por k, contienen r multiplicado por la suma de d y k parámetros escalares. Su producto tiene rango como máximo r. En un punto genérico de rango r, la variedad de matrices tiene dimensión r multiplicado por la cantidad d más k menos r. La diferencia refleja una redundancia de la factorización: multiplicar B por una matriz invertible de r por r y multiplicar A por su inversa deja el producto inalterado.
Esta libertad de gauge importa al interpretar las trayectorias del optimizador o comparar las normas de los factores. Dos pares de factores pueden implementar exactamente la misma actualización con normas y gradientes individuales diferentes. Contar los escalares entrenables sigue siendo útil para calcular el almacenamiento del estado del optimizador, pero no equivale a contar direcciones funcionales independientes. El ejemplo ejecutable verifica la invariancia para una transformación invertible fija. No afirma que los problemas de optimización resultantes sean numéricamente equivalentes con aritmética de precisión finita o un optimizador adaptativo concreto.
4. Las colas de valores singulares ofrecen una referencia lineal exacta
Supongamos que ya se conoce una matriz de actualización deseada y que el criterio es el error de Frobenius al cuadrado no ponderado. La mejor aproximación de rango r conserva sus r componentes singulares mayores. El error residual al cuadrado es la suma de los cuadrados de los valores singulares descartados. Esto ofrece una referencia exacta en un entorno mucho más sencillo que el ajuste fino de redes neuronales: no hay una pérdida de tarea no convexa, una representación cambiante ni una actualización objetivo desconocida.
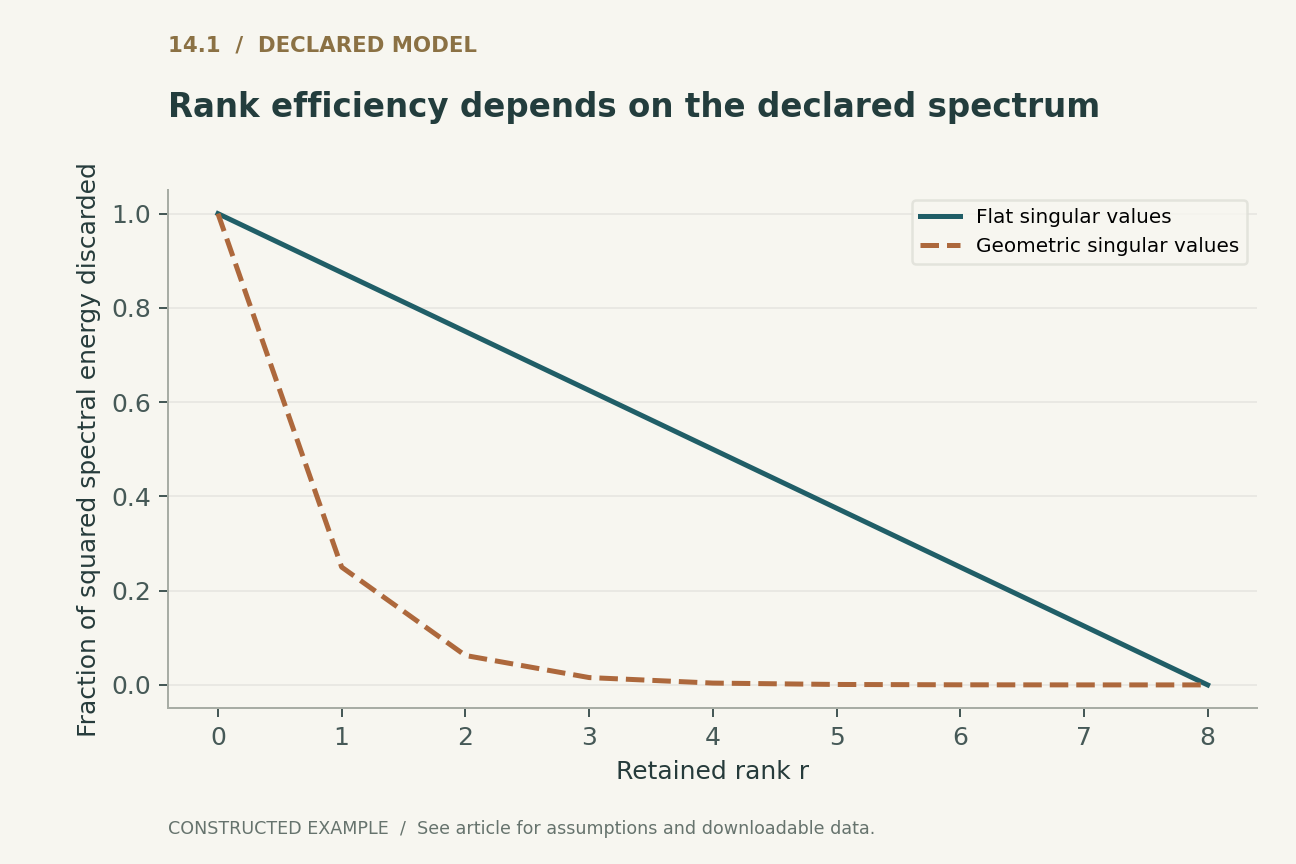
La figura 1 compara la fracción de energía espectral descartada para dos espectros construidos de ocho dimensiones. Uno es plano; el otro decrece geométricamente. Un rango pequeño captura mucha más energía en el segundo caso. La afirmación se refiere a esos espectros bajo una norma en el espacio de pesos. No establece que las actualizaciones de adaptación reales posean alguno de esos espectros, ni que igualar la energía espectral baste para preservar el comportamiento en la tarea. La figura proporciona una referencia frente a la cual puede precisarse una afirmación empírica sobre estructura de bajo rango.
5. La covarianza de entrada cambia el problema de aproximación pertinente
Para una capa lineal y entradas centradas, el error cuadrático esperado de salida depende de la covarianza de entrada. Es la traza del producto de la actualización residual, esa covarianza y la traspuesta del residuo. Si las entradas son isotrópicas y su covarianza es la identidad, se reduce al error de Frobenius al cuadrado. En caso contrario, las distintas direcciones de entrada reciben pesos diferentes.
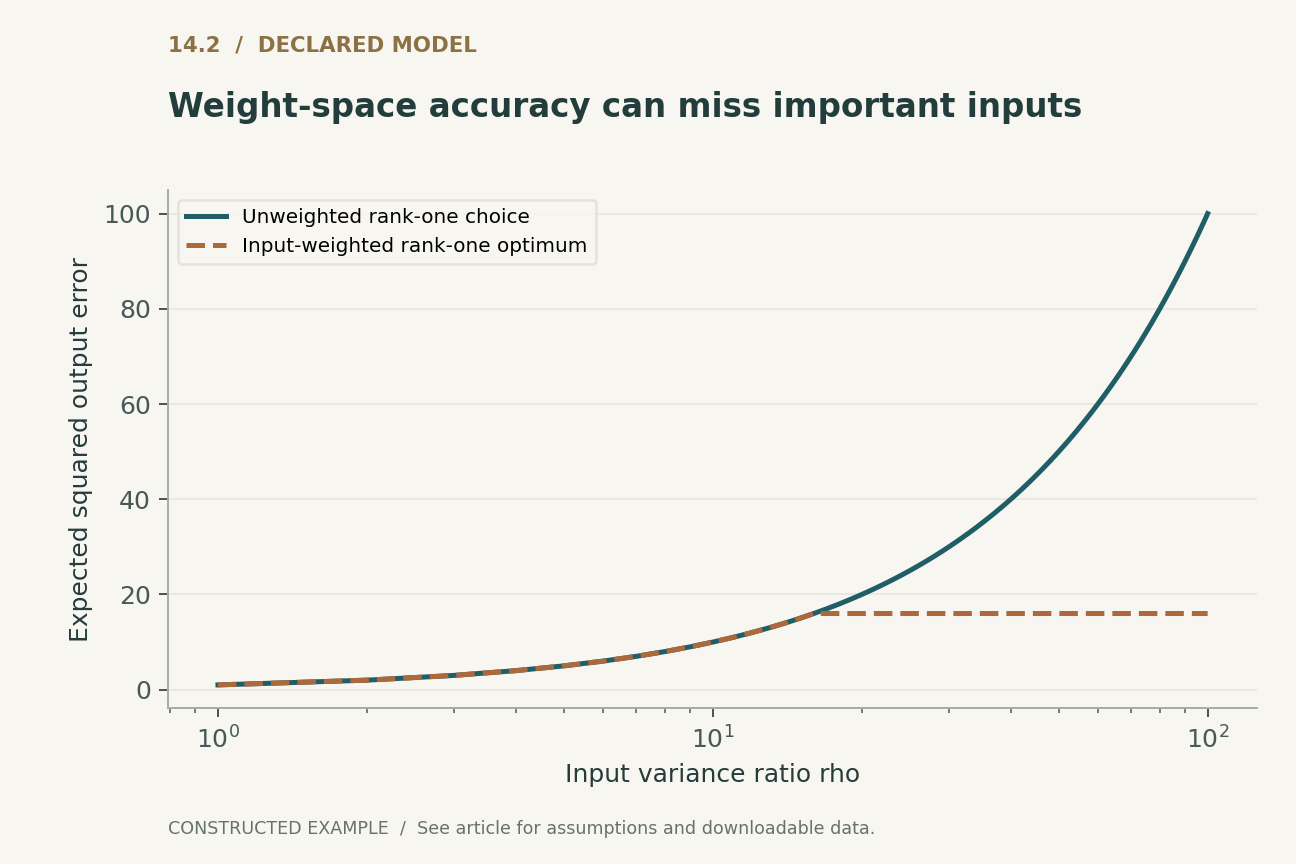
Considérese una actualización deseada con entradas diagonales cuatro y uno. Una aproximación no ponderada de rango uno conserva la primera dirección y deja un error matricial al cuadrado de uno. Supongamos ahora que la covarianza de entrada es diagonal, con entradas uno y rho. El error de salida de esa misma aproximación es rho. Conservar en cambio la segunda dirección deja un error de salida de dieciséis. Cuando rho = 100, la elección basada en el espacio de pesos sufre una pérdida mucho mayor sobre la distribución de entrada especificada. La figura 2 varía rho y compara la elección no ponderada con el criterio óptimo de salida de rango uno. Se trata de un contraejemplo exacto sensible a la distribución, no de una tasa de fallo medida de LoRA.
6. Un cambio en la distribución de entrada puede invertir la actualización preferida
El ejemplo de covarianza tiene una implicación práctica para el cambio de dominio. Una actualización seleccionada bajo una distribución puede asignar su rango limitado a direcciones que resulten menos pertinentes bajo otra. El problema no se resuelve informando únicamente de los valores singulares de la matriz de actualización. También se necesitan datos sobre las entradas que llegan a esa capa y sobre la sensibilidad posterior a su salida.
Para una única capa lineal con covarianza de entrada definida positiva, el problema ponderado puede transformarse multiplicando la actualización deseada por la raíz cuadrada de la covarianza, obteniendo allí una aproximación de bajo rango y aplicando la transformación inversa. Una covarianza singular restringe el criterio al soporte observado y deja algunas direcciones sin identificar. En una red profunda, las transformaciones no lineales posteriores introducen otra ponderación de sensibilidad, de modo que esta construcción lineal es solo un diagnóstico. Aun así, aclara por qué una recomendación de rango debe acompañarse de información sobre la tarea y el dominio, en lugar de presentarse como una constante independiente de la arquitectura.
7. La inicialización de los factores y la escala afectan al aprendizaje
Una inicialización factorizada habitual hace que la actualización inicial sea nula asignando cero a un factor mientras el otro es no nulo. El producto es entonces nulo, pero los gradientes respecto de ambos factores no tienen por qué comportarse de forma simétrica. Si B es nulo, el gradiente inicial respecto de A de la pérdida dependiente del producto es nulo, mientras que el gradiente respecto de B puede ser no nulo. Por ello, el entrenamiento inicial tiene una estructura direccional ausente en una parametrización directa mediante una matriz completa.
Aumentar el rango también cambia el número de términos del producto. Una escala multiplicativa puede alterar las magnitudes de las activaciones y los gradientes incluso cuando el conjunto de actualizaciones no nulas representables sigue siendo el mismo, salvo por un reescalado de los factores. Por ello, una exploración de rangos debe registrar la escala, la varianza de inicialización, la tasa de aprendizaje y la configuración del optimizador. Las comprobaciones matriciales finitas del manuscrito establecen identidades de representación; no establecen una programación óptima del optimizador ni validan ninguna ley universal de escalado para redes profundas.
8. La ubicación en las capas forma parte del presupuesto de capacidad
Dos configuraciones con el mismo número de parámetros entrenables pueden situarlos en capas o proyecciones diferentes. Por tanto, pueden habilitar direcciones funcionales muy distintas. Asignar un rango pequeño a muchas capas no equivale, en general, a asignar un rango mayor a una sola. Incluso en una red lineal, los productos de matrices modificadas introducen términos cruzados; las redes no lineales complican aún más la relación.
Una comparación significativa debe mantener constantes los presupuestos totales de recursos cuando sea posible y revelar la regla de ubicación. También debe distinguir un diseño elegido antes de la validación de otro seleccionado mediante una amplia búsqueda oculta. De lo contrario, una ventaja aparente de una asignación de rangos puede reflejar un esfuerzo adicional de ajuste. Los ejemplos pequeños de este artículo aíslan una capa para que la referencia matemática siga siendo exacta. Un futuro estudio de redes debería añadir intervenciones en las capas y diagnósticos de activación, tratando los resultados de una sola capa como comprobaciones de coherencia y no como un teorema sobre la expresividad del modelo completo.
9. El ahorro en el despliegue depende de la ruta de ejecución elegida
Un modelo base congelado junto con numerosos factores de bajo rango específicos de cada tarea puede reducir el almacenamiento frente a múltiples puntos de control completos independientes. Una actualización fusionada puede evitar evaluar por separado la rama factorizada para una única tarea seleccionada. Son disposiciones de despliegue diferentes, y ninguna determina por sí sola el coste total del servicio cuando los adaptadores se intercambian o se agrupan en lotes dinámicamente.
La memoria de entrenamiento también incluye activaciones, gradientes, estados del optimizador, espacios de trabajo temporales y los pesos base congelados. El número de parámetros es solo un componente. Una evaluación comparativa debe informar de estas categorías y de la precisión real, las longitudes de secuencia, los tamaños de lote y el comportamiento del asignador de memoria. Debe registrar si la fusión de adaptadores modifica la cuantización o el redondeo numérico. Este artículo no mide memoria de GPU, latencia ni rendimiento por unidad de tiempo. Sus afirmaciones se limitan a recuentos exactos de parámetros e identidades matriciales, dejando el ahorro dependiente de la implementación para un experimento diseñado por separado con una contabilización explícita.
10. Una afirmación defendible sobre la capacidad es condicional
La cuestión central no es si el bajo rango es bueno o malo. Es si una familia concreta y restringida de actualizaciones puede alcanzar un objetivo especificado bajo una distribución y un presupuesto de optimización determinados. El ejemplo espectral ofrece una referencia lineal del mejor caso cuando se conoce la actualización objetivo. El ejemplo de covarianza muestra que incluso esta referencia cambia cuando el criterio pasa de los pesos a las salidas.
Por tanto, un informe empírico debe incluir rango, ubicación, escalado, esfuerzo de búsqueda, composición de dominios e incertidumbre entre ejecuciones. Cuando sea viable una referencia de ajuste fino completo, deben compararse resultados funcionales y no solo distancias entre pesos aprendidos, ya que las simetrías de los parámetros pueden hacer engañosa la distancia entre pesos. Cuando no sea viable, debe declararse esa limitación en vez de tratar una referencia restringida como capacidad irrestricta. Los ejemplos ejecutables suministrados pretenden dar mayor rigor a tales afirmaciones: identifican los supuestos necesarios para pasar de un número reducido de parámetros a una afirmación significativa sobre lo que una adaptación puede representar.
Ejecutado localmente · Alcance acotado
Residuos de SVD con rotaciones, invariancia de gauge de los factores y error ponderado de salida lineal
Únicamente matrices construidas y un criterio lineal con entradas centradas. Ninguna afirmación sobre adaptadores entrenados, comportamiento del optimizador o ahorro en aceleradores.
Se superaron 47 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "matrix_dimension": 8,
  "ranks": [
    0,
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ],
  "rho100_unweighted_error": 100,
  "rho100_weighted_error": 16,
  "factor_gauge_matrix": [
    [
      2,
      1
    ],
    [
      0,
      3
    ]
  ]
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Factorización de tipo LoRA con una escala c especificada. El rango es como máximo r; P cuenta las entradas almacenadas de los factores entrenables, no las coordenadas independientes de la variedad de rango fijo.
(2) Q es invertible y r <= min(d,k). La afirmación sobre la dimensión se refiere a la variedad suave de matrices de rango exactamente r.
(3) Mejor aproximación de bajo rango bajo un criterio de Frobenius no ponderado; los valores singulares están ordenados de forma no creciente.
(4) Entradas centradas con covarianza finita Sigma_x. La figura 2 utiliza Delta W = diag(4,1), Sigma_x = diag(1,rho), lo que da un error de la elección no ponderada de rho y un error óptimo de rango uno de min(16,rho).
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Afirmación | Especificación necesaria | Contraejemplo o limitación |
|---|---|---|
| Un rango pequeño captura la actualización | Matriz objetivo y norma de aproximación | Un espectro plano conserva una energía considerable en la cola |
| Un error pequeño en los pesos preserva las salidas | Covarianza de entrada y sensibilidad posterior | Una dirección de pesos de baja varianza puede dominar las entradas cuya distribución ha cambiado |
| Pocos parámetros implican un despliegue económico | Fusión, procesamiento por lotes, precisión y contabilización de memoria | Los costes de activación y enrutamiento siguen dependiendo de la implementación |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna evaluación comparativa de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Elegir matrices objetivo exactas con espectros planos y decrecientes y verificar de forma independiente los residuos de la SVD truncada.
- Comprobar la invariancia de gauge de la factorización y las cotas de rango utilizando matrices fijas y tolerancias numéricas declaradas.
- Evaluar los errores ponderados por las entradas bajo varias covarianzas, incluido el ejemplo de inversión de la elección de rango uno.
- Para los experimentos de redes, registrar previamente la ubicación de los adaptadores, el rango, la escala, la inicialización, el optimizador y el presupuesto de ajuste.
- Comparar la calidad en la tarea sobre datos reservados y el comportamiento ante cambios de dominio entre semillas, junto con mediciones reales de memoria y tiempo.
- Archivar las revisiones del modelo base, los factores de los adaptadores, los ajustes de fusión, las versiones de los datos de evaluación y las limitaciones de cualquier referencia de ajuste completo no disponible.
Qué establecen las fuentes primarias
Edward J. Hu, Yelong Shen, Phillip Wallis et al. · 2021 [1]
Contribución. LoRA factoriza las actualizaciones entrenables mientras congela los pesos preentrenados y permite una actualización lineal fusionada.
Límite. La calidad de adaptación y el ahorro de recursos comunicados son específicos de las configuraciones del artículo.
Localización en la fuente. Método e investigación empírica del rango; arXiv v2.
Armen Aghajanyan, Luke Zettlemoyer, Sonal Gupta · 2020 [2]
Contribución. Las reparametrizaciones de baja dimensión ofrecen una perspectiva sobre el ajuste fino de modelos de lenguaje.
Límite. La dimensión intrínseca en este contexto no es idéntica al rango de la matriz de actualización de una capa.
Localización en la fuente. Formulación de la dimensión intrínseca y experimentos de ajuste fino; registro original de la prepublicación.
Damjan Kalajdzievski · 2023 [3]
Contribución. El escalado dependiente del rango puede afectar sustancialmente a la optimización de LoRA; el artículo analiza el escalado con la raíz cuadrada.
Límite. El análisis no elimina la necesidad de ajustar y revelar los supuestos sobre la inicialización y el optimizador.
Localización en la fuente. Análisis del factor de escala; arXiv v1.
Límites de este análisis
- Las matrices ejecutables ponen a prueba la capacidad algebraica y la ponderación por la distribución, no la calidad de un adaptador neuronal entrenado.
- El criterio de covarianza supone una única capa lineal y un error de salida al cuadrado; las no linealidades posteriores añaden complejidad.
- En este artefacto local no se miden la memoria de GPU, el rendimiento del entrenamiento por unidad de tiempo ni la latencia de despliegue.
- La dimensión intrínseca de los parámetros, el rango matricial y la complejidad semántica de la tarea son distintos y no pueden sustituirse entre sí sin evidencia adicional.
Una revisión analítica centrada en tres fuentes primarias fundacionales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la bibliografía hasta 2026. El acceso a las fuentes y las notas de versión se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Pueden las mediciones de las entradas y de la sensibilidad posterior orientar la asignación de rango con más fiabilidad que los espectros de actualización por sí solos?
- ¿Qué estabilidad tienen los subespacios útiles de adaptación ante cambios de dominio y longitud de secuencia?
- ¿Qué protocolo de comparación separa los límites de representación de los límites de optimización y búsqueda de hiperparámetros?
Referencias
- Edward J. Hu, Yelong Shen, Phillip Wallis et al.. LoRA: Low-Rank Adaptation of Large Language Models. arXiv preprint (2021). 10.48550/arXiv.2106.09685.
- Armen Aghajanyan, Luke Zettlemoyer, Sonal Gupta. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. arXiv preprint (2020). 10.48550/arXiv.2012.13255.
- Damjan Kalajdzievski. A Rank Stabilization Scaling Factor for Fine-Tuning with LoRA. arXiv preprint (2023). 10.48550/arXiv.2312.03732.
Acceso a la fuente [1]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin una auditoría exhaustiva del material complementario.
Nota de versión. v2, revisada el 16 de octubre de 2021; el objeto bibliográfico citado es la prepublicación.
Acceso a la fuente [2]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin una auditoría exhaustiva del material complementario.
Nota de versión. v1, presentada el 22 de diciembre de 2020; el objeto bibliográfico citado es la prepublicación.
Acceso a la fuente [3]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin una auditoría exhaustiva del material complementario.
Nota de versión. v1, presentada el 28 de noviembre de 2023.
Las identidades bibliográficas se comprobaron con los registros primarios de editoriales y autores. Las notas de acceso a las fuentes y de versión que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se suministran Python y CSV. No son mediciones de productos desplegados ni evaluaciones comparativas de rendimiento reproducidas.
Este borrador local no tiene registro de revisión por pares independiente ni de aceptación por una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos declarados; no constituyen una verificación formal de los sistemas citados.