
摘要
低秩适应通过将权重更新分解为因子来减少可训练参数数量,但秩本身并不决定函数表示能力或下游任务质量。本综述区分矩阵近似、输入加权的输出误差、因子分解的几何结构、优化中的缩放以及部署成本核算。三项一手研究为有关 LoRA、内在维数及秩相关缩放的讨论提供了出发点。独立构造的示例说明了奇异值衰减如何控制未加权近似误差,以及在权重空间中最优的秩一更新为何可能在输入协方差变化后表现不佳。可复现图表、精确矩阵检验和所提出的评估方案界定了这些推导能够确立的结论,而不声称提供新的语言模型基准测试结果。
1. 明确秩受到约束的对象
秩约束作用于特定层中的矩阵,并不直接作用于整个网络能够表示的函数集合。对一个线性算子的低秩更新可能与非线性、残差路径、归一化及其他层的更新相互作用。因此,最终产生的函数变化可能比任何单个矩阵的秩所暗示的更丰富,同时在一些重要方向上仍然受到限制。
严谨的分析需要区分四个量:可训练参数数量、实际实现的权重更新的秩、在明确指定的输入分布上产生的输出变化,以及下游任务评价标准。这些量彼此关联,但不能相互替代。本文从单个线性层出发,因为这一设定允许构造精确反例。文中的矩阵是人为构造的,并非从训练好的语言模型中提取。其目的是在将容量论断与复杂网络上的实证表现联系起来之前,先检验这些论断的逻辑。
2. 三项一手研究引出的议题
Hu 及其同事提出 LoRA,通过冻结预训练权重并学习低秩更新因子来实现适应,同时给出了适应的实证结果和可合并的线性更新。Aghajanyan、Zettlemoyer 和 Gupta 研究了语言模型微调的低维重参数化。他们所指的内在维数并不等同于某层更新矩阵的秩。Kalajdzievski 研究了 LoRA 中与秩相关的缩放,并依据该论文的分析提出了基于秩平方根的缩放。
这些贡献引出了三个独立问题:受限参数化能否解决某项任务,如何衡量其有效维数,以及当参数化改变时,优化是否仍具有可比性。它们都没有给出某个特定秩足以适用于所有领域或模型的普遍规则。下文示例并不复现所引文献中的性能表,而是推导小型矩阵的精确性质,并利用这些性质明确未来微调比较所需的控制条件。 [1], [2], [3]
3. 参数节省量不等于固定秩矩阵流形的维数
对于一个 d 行 k 列的权重矩阵,形状为 d 行 r 列的因子 B 和形状为 r 行 k 列的因子 A 共包含 r 乘以 d 与 k 之和个标量参数。它们乘积的秩至多为 r。在一般的秩 r 点处,矩阵流形的维数为 r × (d + k − r)。这一差异体现了因子分解的冗余性:将 B 右乘一个可逆的 r 行 r 列矩阵,并将 A 左乘其逆矩阵,乘积保持不变。
在解释优化器轨迹或比较因子范数时,这种规范自由度很重要。两组因子可以实现完全相同的更新,却具有不同的单个因子范数与梯度。统计可训练标量的数量对于核算优化器状态存储仍然有用,但这不等同于统计独立的函数方向。可执行示例验证了在一个固定可逆变换下的不变性。它并不声称,在有限精度算术或某个特定自适应优化器下,由此得到的优化问题在数值上等价。
4. 奇异值尾部给出精确的线性基准
假设所需的更新矩阵已经已知,且评价标准为未加权的弗罗贝尼乌斯平方误差。最优秩 r 近似保留其最大的 r 个奇异分量。残差平方误差等于被舍弃奇异值的平方和。这在一个远比神经网络微调简单的设定中给出了精确基准:其中没有非凸的任务损失、变化中的表示,也没有未知的目标更新。
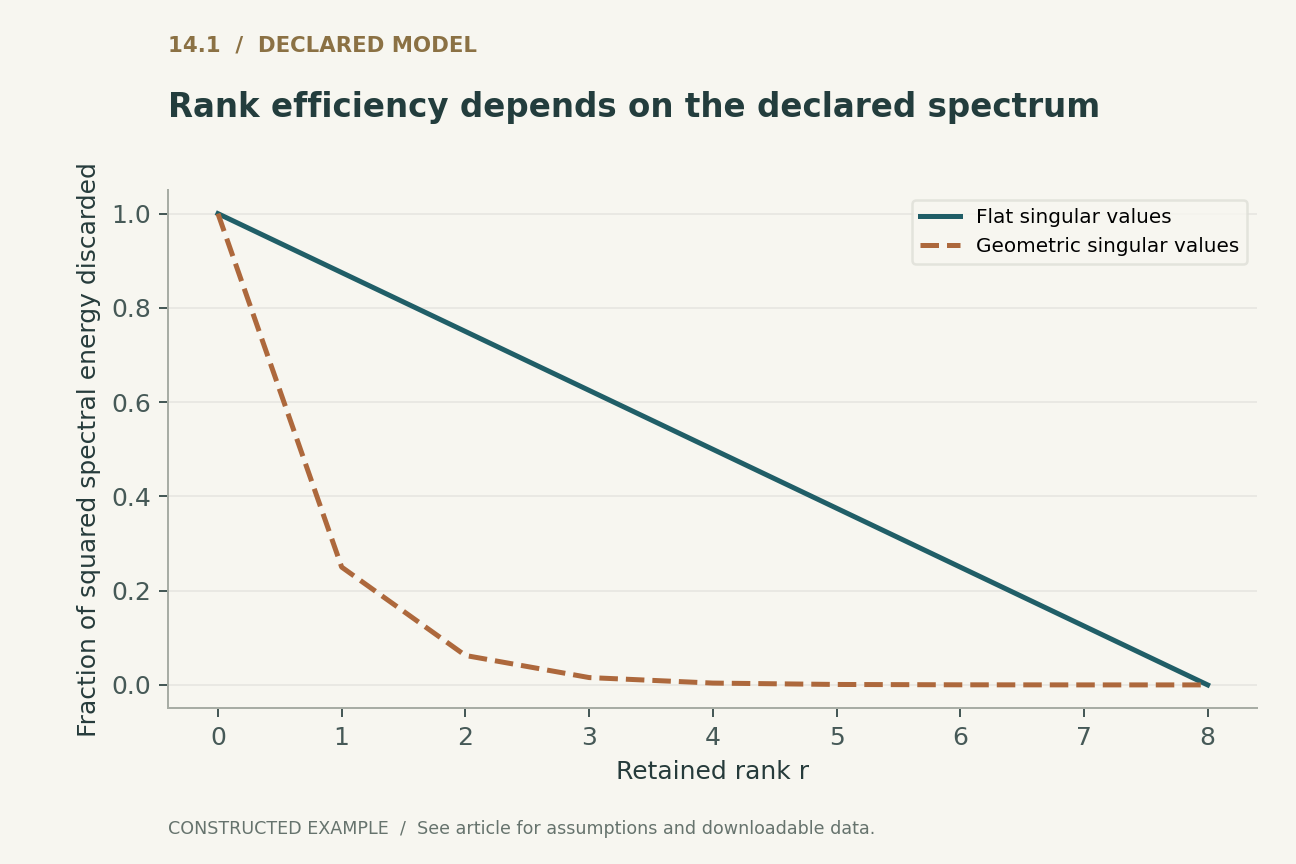
图 1 比较了两个构造的八维谱中被舍弃谱能量的比例。其中一个谱是平坦的,另一个按等比方式递减。在第二种情况下,较小的秩能够捕获多得多的能量。这一陈述针对的是权重空间范数下的这两个谱。它并未证明真实适应更新具有其中任何一种谱,也未证明匹配谱能量足以保持任务行为。该图提供了一个参照,使有关低秩结构的实证论断能够得到精确表述。
5. 输入协方差改变了相关的近似问题
对于线性层和中心化输入,期望输出平方误差取决于输入协方差。它等于残差更新、该协方差以及残差转置依次相乘所得矩阵的迹。如果输入各向同性且协方差为单位矩阵,则它退化为弗罗贝尼乌斯平方误差。否则,不同输入方向会获得不同权重。
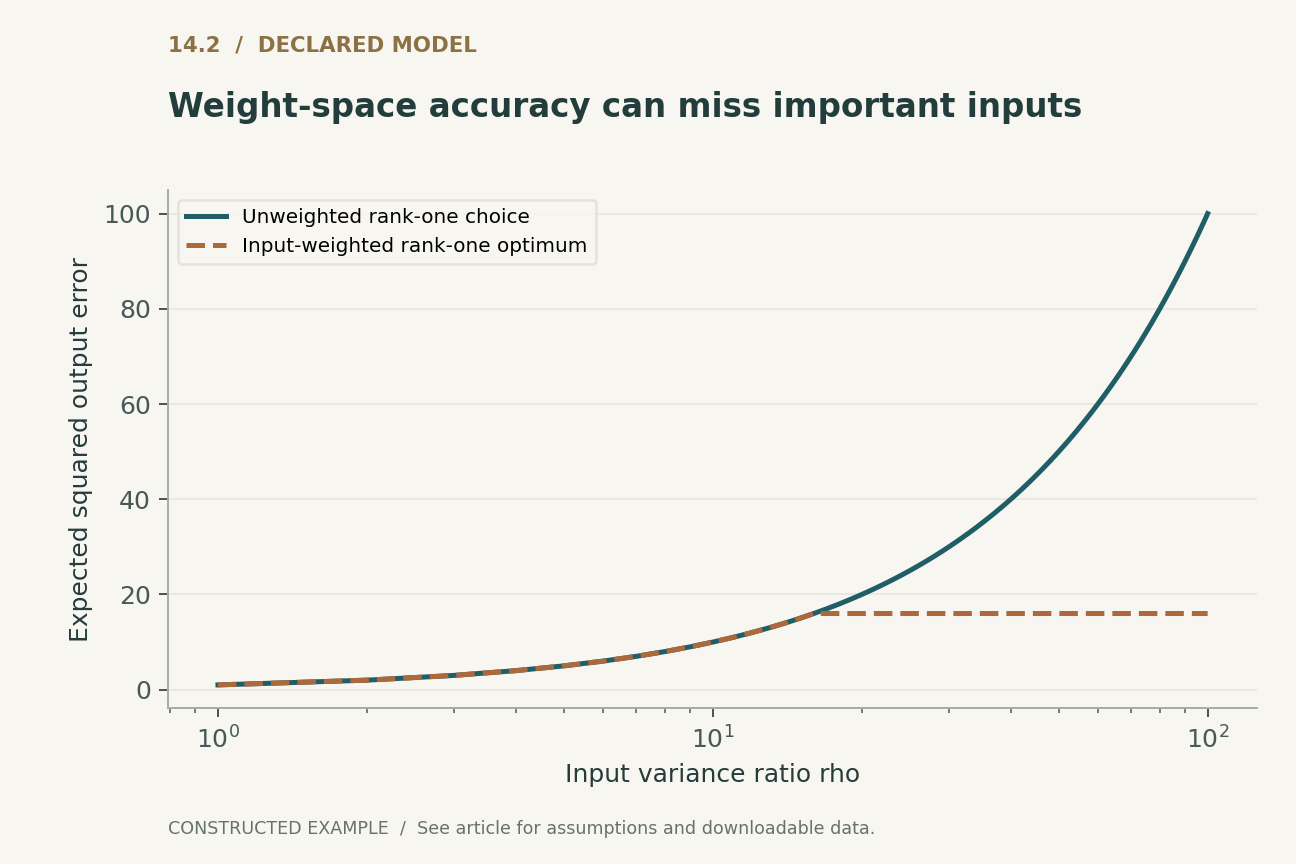
考虑一个对角元素为四和一的目标更新。未加权的秩一近似保留第一个方向,留下的矩阵平方误差为一。现在令输入协方差为对角矩阵,其对角元素为一和 rho。同一近似的输出误差就为 rho。如果改为保留第二个方向,则输出误差为十六。当 rho = 100 时,权重空间中的选择在指定输入分布上造成的损失大得多。图 2 改变 rho,并将未加权选择与最优秩一输出准则进行比较。这是一个对分布敏感的精确反例,并非测得的 LoRA 失败率。
6. 输入分布的变化可能逆转更新的优先选择
协方差示例对领域迁移具有实际启示。在一个分布下选出的更新,可能将有限的秩分配给在另一个分布下变得不那么重要的方向。仅报告更新矩阵的奇异值无法解决这一问题,还需要有关到达该层的输入以及下游对该层输出敏感性的证据。
对于输入协方差正定的单个线性层,可以将目标更新乘以协方差的平方根,在变换后的空间中求低秩近似,再变换回去,从而处理加权问题。奇异协方差将评价标准限制在已观测的支撑上,并使某些方向无法被识别。在深层网络中,后续非线性变换还会引入另一种敏感性加权,因此这一线性构造仅是一种诊断工具。尽管如此,它仍说明了为什么秩的建议应附带任务与领域信息,而不应被表述为与架构无关的常数。
7. 因子初始化与尺度影响学习
一种常见的因子化初始化方式是将一个因子置零、另一个保持非零,从而使初始更新为零。此时乘积为零,但损失对两个因子的梯度不一定具有对称行为。如果 B 为零,那么依赖乘积的损失对 A 的初始梯度为零,而对 B 的梯度可以非零。因此,初始训练具有直接全矩阵参数化所不具备的方向结构。
增大秩还会改变乘积中的项数。即使允许对因子重新缩放后,可表示的非零更新集合保持相同,乘法尺度也可能改变激活值和梯度的大小。因此,秩扫描应记录尺度、初始化方差、学习率和优化器配置。本文的有限规模矩阵检验确立的是表示恒等关系,而不是最优的优化器调度方案,也不是验证深层网络的任何普遍缩放定律。
8. 层级部署位置是容量预算的一部分
两个具有相同可训练参数数量的配置,可以将这些参数放在不同层或不同投影中。因此,它们可能开放非常不同的函数方向。在许多层中分配较小的秩,通常不等价于在某一层中分配较大的秩。即使在线性网络中,修改后矩阵的乘积也会引入交叉项;非线性网络则使这种关系更加复杂。
有意义的比较应尽可能保持总资源预算一致,并披露部署位置的选择规则。还应区分在验证前选定的设计与通过大规模隐蔽搜索选出的设计。否则,某种秩分配的表面优势可能反映的是额外调参投入。这里的小型示例将单个层隔离出来,以保持数学参照的精确性。未来的网络研究应加入层级干预和激活诊断,将单层结果视为合理性检查,而非关于整个模型表达能力的定理。
9. 部署节省取决于所选执行路径
一个冻结的基础模型加上许多任务专属的低秩因子,相较于多个独立的完整检查点,可以减少存储。对于选定的单一任务,合并后的更新可以避免单独计算因子化分支。这是两种不同的部署安排;当适配器被动态切换或批处理时,任何一种安排本身都不能决定总服务成本。
训练内存还包括激活值、梯度、优化器状态、临时工作区和冻结的基础权重。参数数量只是其中一项。基准测试应报告这些类别,以及实际精度、序列长度、批大小和内存分配器行为。还应记录适配器合并是否改变了量化或数值舍入。本文不测量 GPU 内存、延迟或吞吐量。其论断仅限于精确参数计数和矩阵恒等式,而将依赖实现的节省留待另行设计、明确核算的实验来评估。
10. 站得住脚的容量论断是有条件的
核心问题并不是低秩好还是不好,而是某个特定的受限更新族能否在指定分布和优化预算下实现指定目标。当目标更新已知时,谱示例给出了最佳情形下的线性参照。协方差示例表明,当评价标准从权重转向输出时,即使这一参照也会改变。
因此,实证报告应包含秩、部署位置、缩放、搜索投入、领域构成以及不同运行之间的不确定性。在全量微调基线可行时,应比较函数层面的结果,而不只是学习后权重之间的距离,因为参数对称性可能使权重距离产生误导。在其不可行时,应说明这一限制,而不是将受限基线当作不受限制的能力。所提供的可执行示例旨在使这类论断更加严谨:它们明确了从参数数量较少这一事实,过渡到关于适应能够表示什么的有意义陈述所必需的假设。
本地已执行 · 范围有限
旋转后的 SVD 残差、因子规范不变性与加权线性输出误差
仅涉及构造的矩阵和中心化线性输入准则。不对已训练适配器、优化器行为或加速器资源节省作出论断。
47 项断言通过。 这些检验验证的是所提供的示例,而不是所引述的系统。
检查记录的验证证据
{
  "matrix_dimension": 8,
  "ranks": [
    0,
    1,
    2,
    3,
    4,
    5,
    6,
    7,
    8
  ],
  "rho100_unweighted_error": 100,
  "rho100_weighted_error": 16,
  "factor_gauge_matrix": [
    [
      2,
      1
    ],
    [
      0,
      3
    ]
  ]
}明确声明的分析模型
四个方程,明确的假设
(1) 采用已声明尺度 c 的 LoRA 式因子分解。秩至多为 r;P 统计所存储的可训练因子元素,而不是固定秩矩阵流形的独立坐标。
(2) Q 可逆,且 r <= min(d,k)。维数陈述针对的是秩恰好为 r 的矩阵所构成的光滑流形。
(3) 未加权弗罗贝尼乌斯准则下的最优低秩近似;奇异值按非增顺序排列。
(4) 具有有限协方差 Sigma_x 的中心化输入。图 2 使用 Delta W = diag(4,1)、Sigma_x = diag(1,rho),得到未加权选择的误差 rho 和最优秩一误差 min(16,rho)。
构造示例 · 可复现数据
检查定量论证
这些曲线依据已声明的模型计算,并非所引研究中的观测结果。每幅图均附有数值数据和矢量版本。


哪种证据回答哪个问题?
| 论断 | 必须明确的条件 | 反例或局限 |
|---|---|---|
| 较小的秩即可捕获更新 | 目标矩阵与近似范数 | 平坦谱会保留大量尾部能量 |
| 较小的权重误差能够保持输出 | 输入协方差与下游敏感性 | 低方差的权重方向可能在分布迁移后的输入上起主导作用 |
| 参数少意味着部署成本低 | 合并、批处理、精度和内存核算 | 激活与路由成本仍取决于实现 |
拟议的验证方案
这是一个拟议的评估设计。未进行生产系统或硬件基准测试。单独执行的有限规模模型记录于可执行检验中。
- 选择具有平坦谱和衰减谱的精确定义目标矩阵,并独立验证截断 SVD 残差。
- 使用固定矩阵和已声明的数值容差,检查因子分解的规范不变性及秩界。
- 在多种协方差下评估输入加权误差,包括秩一选择发生逆转的示例。
- 对于网络实验,预先记录适配器部署位置、秩、尺度、初始化、优化器和调参预算。
- 比较不同随机种子下留出数据上的任务质量及领域迁移后的行为,同时给出实际内存和时间测量。
- 归档基础模型修订版本、适配器因子、合并设置、评估数据版本,以及任何无法获得的全量微调基线所带来的限制。
一手文献确立了什么
Edward J. Hu, Yelong Shen, Phillip Wallis et al. · 2021 [1]
贡献。 LoRA 在冻结预训练权重的同时,将可训练更新分解为因子,并支持合并后的线性更新。
边界。 所报告的适应质量和资源节省仅针对论文中的具体配置。
来源定位。 方法及秩的实证研究;arXiv v2。
Armen Aghajanyan, Luke Zettlemoyer, Sonal Gupta · 2020 [2]
贡献。 低维重参数化为理解语言模型微调提供了视角。
边界。 这一设定中的内在维数并不等同于某层更新矩阵的秩。
来源定位。 内在维数的形式化与微调实验;原始预印本记录。
Damjan Kalajdzievski · 2023 [3]
贡献。 与秩相关的缩放可能显著影响 LoRA 优化;该论文分析了平方根缩放。
边界。 该分析并未免除调优以及披露初始化与优化器假设的必要性。
来源定位。 缩放因子分析;arXiv v1。
本分析的局限
- 可执行矩阵示例检验的是代数表示能力和分布加权,而不是训练后神经适配器的质量。
- 协方差准则假设单个线性层和输出平方误差;下游非线性会增加复杂性。
- 该本地材料未测量 GPU 内存、训练吞吐量或部署延迟。
- 参数内在维数、矩阵秩和语义任务复杂度是不同概念,没有额外证据就不能相互替代。
这是一篇聚焦于三项选定的基础性一手研究、并包含原创推演示例的分析性综述。它并非对截至 2026 年文献的穷尽性或系统性调查。来源查阅范围和版本说明随参考文献一并记录。
可能改变结论的问题
- 与仅依靠更新谱相比,输入和下游敏感性的测量能否更可靠地指导秩分配?
- 在领域和序列长度变化时,有用的适应子空间有多稳定?
- 什么样的比较方案能够将表示能力的限制与优化及超参数搜索的限制区分开来?
参考文献
- Edward J. Hu, Yelong Shen, Phillip Wallis et al.. LoRA: Low-Rank Adaptation of Large Language Models. arXiv preprint (2021). 10.48550/arXiv.2106.09685.
- Armen Aghajanyan, Luke Zettlemoyer, Sonal Gupta. Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning. arXiv preprint (2020). 10.48550/arXiv.2012.13255.
- Damjan Kalajdzievski. A Rank Stabilization Scaling Factor for Fine-Tuning with LoRA. arXiv preprint (2023). 10.48550/arXiv.2312.03732.
来源 [1] 的查阅范围。 一手元数据、摘要及部分可获取的方法正文;未对补充材料进行全面审查。
版本说明。 v2,于 2021 年十月 16 日修订;所引用的书目对象为预印本。
来源 [2] 的查阅范围。 一手元数据、摘要及部分可获取的方法正文;未对补充材料进行全面审查。
版本说明。 v1,于 2020 年十二月 22 日提交;所引用的书目对象为预印本。
来源 [3] 的查阅范围。 一手元数据、摘要及部分可获取的方法正文;未对补充材料进行全面审查。
版本说明。 v1,于 2023 年十一月 28 日提交。
书目信息已与出版方和作者的一手记录核对。下文的来源查阅范围和版本说明描述了核查范围;这并非全面的全文审查。
作者与来源
由 Codex(AI)撰写并进行技术自审。参考文献注明原研究者;分析性构造与拟议评估设计归属于本文。
封面是 ImageGen 概念插图。技术图表依据已声明的模型或有限规模示例计算,并提供 Python 和 CSV。它们不是对已部署产品的测量,也不是对性能基准测试的复现。
这份本地草稿没有独立同行评审或期刊接收记录。范围有限的可执行示例检验了所声明的小型模型;它们并非对所引系统的形式化验证。