
摘要
变分自编码器在重构与潜变量编码之间取得平衡,但通常报告的诊断指标并不能识别单一的失效模式。本篇分析性综述区分了条件后验坍塌、聚合分布与先验匹配、潜变量互信息、解码器依赖性以及优化误差。三篇一手文献为这些区分提供了动机。一个有限二元信道给出了精确的信息分解,而一个标量高斯解码器揭示了一个依赖噪声的阈值,最优潜变量载荷在该阈值处消失。两幅可复现图和可执行检查表明,正KL为何未必意味着有用信息,以及在指定模型下,坍塌的潜变量为何可能是最优的。所提出的实证方案检验潜变量的因果使用,而不虚构图像或语言基准测试结果。
1. 明确哪个变量不再承载信息
潜变量模型可以在忽略潜变量输入的同时生成看似合理的观测。当预期用途需要压缩、可控变化或对单个样本的表示时,这一事实就构成问题。但它并不自动与似然目标矛盾。在诊断坍塌之前,必须说明观测、推断出的潜变量与解码器输出之间原本预期存在何种关系。
本文将坍塌视为一组可以区分的命题。编码器分布可能对每个输入都等于先验;其聚合分布可能等于先验,而单个编码仍然包含信息;解码器可能对某个坐标不敏感;或者某次优化运行可能未能达到更好的解。这些命题可以重叠,但没有任何单一标量能够识别它们全部。我们的目标是构建其解释能够经受简单反例检验的诊断方法,首先考察有限分布以及一个所有相关量都能精确获得的高斯模型。
2. 奠基性文献究竟贡献了什么
Kingma和Welling提出了采用摊销识别模型的重参数化变分学习构造。Bowman及其同事将连续潜变量模型应用于句子,并讨论了与潜在编码使用不足相关的实际训练困难。Lucas及其同事通过线性变分自编码器与概率主成分分析之间的关系来分析前者,区分似然景观的特征与被归因于变分下界的效应。
这些文献共同说明,有必要仔细区分目标、模型容量与优化。它们的结果并不意味着每个较小的潜变量KL都不可取,也不意味着某一种干预能够普遍修复坍塌。下文的分析示例是独立推导的小模型,而非对所引语言或图像实验的复现。具体而言,二元信道用于单独考察信息核算,而标量高斯模型用于单独考察假定观测方差的作用。二者均不声称复现深层解码器的优化动态。 [1], [2], [3]
3. 证据下界包含一个独立的近似差距
对于固定观测,对数边缘似然等于证据下界,加上近似后验到模型真实后验的KL散度。这一恒等式将模型拟合不佳与后验近似不准确区分开来。下界较低可能源于其中任一原因,而改进推断可以在不改变模型边缘分布的情况下收紧下界。
这里还存在摊销问题:共享编码器可能无法达到每个观测所能获得的最佳变分分布。将所有差距都归因于解码器行为的诊断会忽略这一额外约束。在可处理的模型中,应计算精确后验,并将其同时与摊销编码器及针对每个样本单独优化的近似进行比较。在深层模型中,精确比较可能不可行,因此更强的后验分布族提供的是证据,而非证明。这一区分很重要,因为改变正则化系数与增加推断容量干预的是问题的不同部分。
4. 聚合匹配可以与完整信息并存
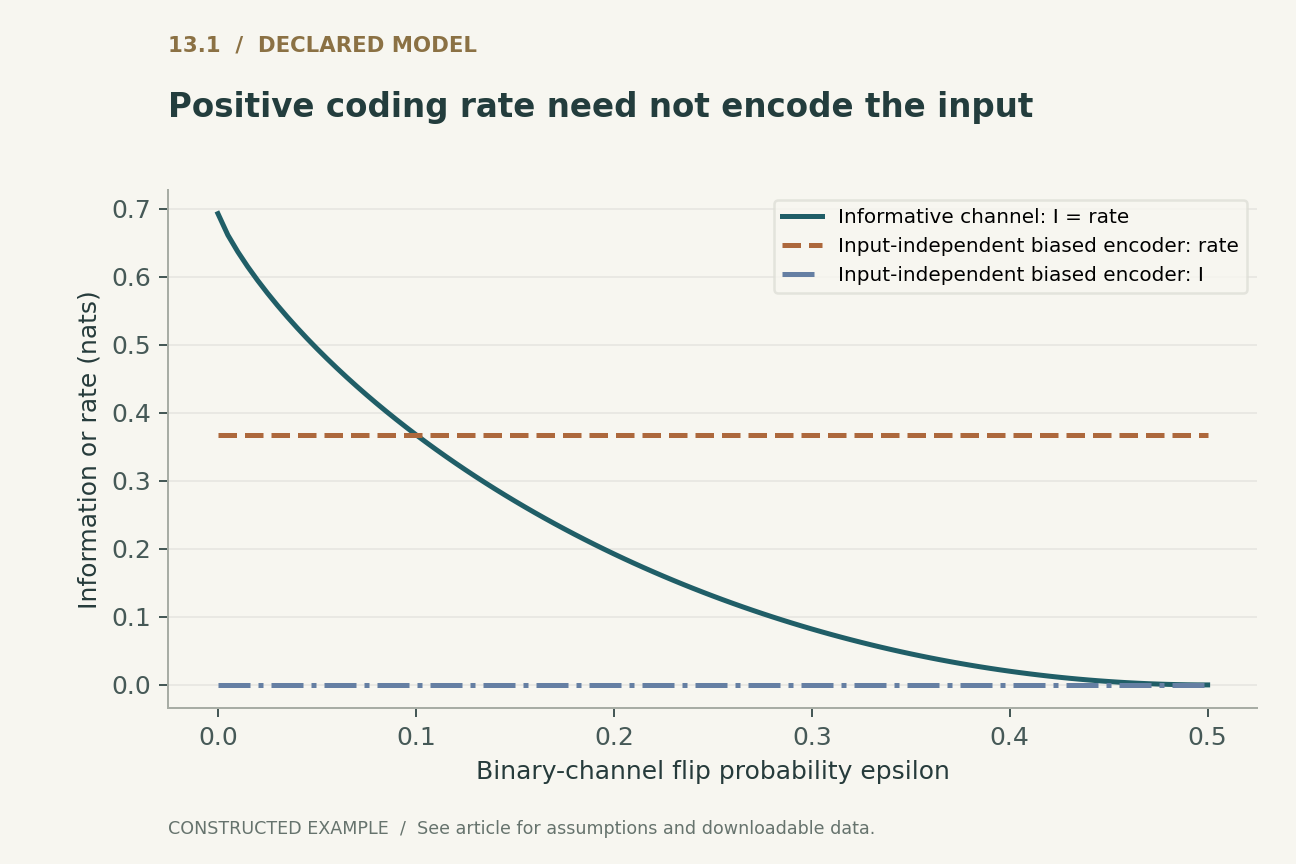
考虑一个均匀二元观测X,以及以概率epsilon翻转X所得到的二元潜变量Z。无论翻转概率如何,潜变量的聚合分布都是均匀的。如果先验也均匀,则聚合分布与先验之间的KL始终严格为零。然而,潜变量互信息从翻转概率为零时的二的对数,变化到翻转概率为二分之一时的零。
图1以自然单位,即纳特,绘出了这一信息量。对于这个特定信道,它也等于相对于先验的期望条件KL。这个例子说明,聚合直方图与先验匹配为何不能作为坍塌的证据。在零噪声下,即使聚合分布看起来与先验完全一致,每个单独的编码仍然包含完整信息。反过来,聚合一致也不能保证某个特定语义属性得到保留。互信息涉及的是依赖关系,而不是对某项任务的有用性。后一判断需要明确的下游目标或干预。
5. 正编码率未必承载输入信息
现在选择一个编码器,使其对每个输入都以概率0.9输出Z = 1,同时保留均匀先验。期望条件KL为正,约为0.368纳特,但与X的互信息为零。全部编码率都用于聚合失配。图1将这一恒定编码率的反例与有信息的二元信道并列呈现。
一般分解可以通过在期望条件KL内部加上并减去对数聚合密度得到。其中一项是在数据与编码器所定义的联合分布下的互信息,另一项是聚合分布与先验之间的KL。有限可执行示例通过显式求和验证该恒等式,而非仅依赖其闭式表达。这一计算也提醒我们,不应将干预后更高的KL等同于更好的表示。增加可能反映有用的依赖关系、不必要的先验失配,或二者兼有。报告应尽可能分别估计这些贡献,或给出其界限。
6. 标量高斯模型具有精确的坍塌阈值
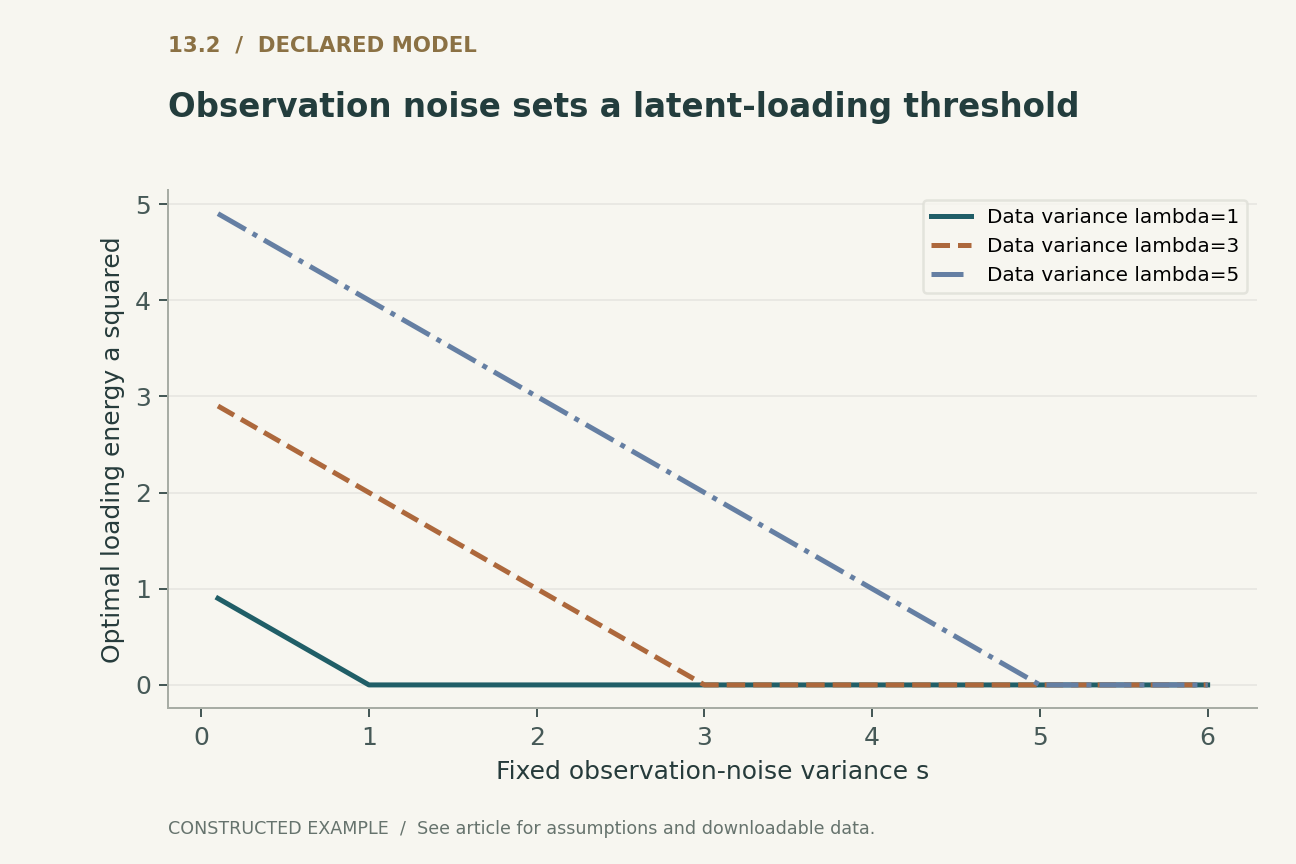
令潜变量先验为标准正态分布,并令观测等于潜变量乘以a再加上方差固定为s的独立高斯噪声。假设中心化数据的方差为lambda。模型的边缘方差为a的平方加s。忽略常数后,期望负对数似然等于模型方差的对数与lambda除以该方差之和的一半。
针对非负的载荷能量,即a的平方,优化这一表达式,得到lambda减s的正部。如果假定的观测噪声不小于数据方差,则最优解满足a = 0,潜变量不承载信息。如果噪声更小,则非零载荷最优。图2展示了三种数据方差下的这一阈值。这个例子并不声称深度网络遵循同样的标量相边界。它确立的是一个更有限的结论:在明确的模型约束下,坍塌可能是最优解,而非优化中的偶然失误。
7. 观测噪声改变了潜变量必须解释的内容
高斯阈值的来源可以解释。解码器的固定噪声项已经解释了s单位的方差。潜变量载荷可以增加方差,却不能减去方差。当s超过观测方差时,将载荷设为零会得到该模型族内能够达到的最接近的边缘方差。强制非零潜变量活动会恶化所声明的似然目标。
这一示例提示我们应报告观测模型,包括方差是固定的、学习得到的、对角的,还是受到其他约束。没有相应似然尺度的重构数值含义不明。平方误差与负对数似然只有在相应的噪声假设和常数条件下才可比较。将异构模态的重构项组合起来时也会出现同样的问题:它们的相对尺度会改变在潜变量中存储信息的激励。为获得有用表示而选择某个系数可能是合理的,但应将其效果描述为改变目标,而非修复某种普遍的数学缺陷。
8. 应通过干预检验解码器对潜变量的使用
潜变量可能与观测相关,但解码器几乎不使用它。反过来,解码器可能对编码器典型支撑集之外的潜变量变化作出强烈响应。因此,观测相关性与任意插值都不足以完整检验有用的信息流。干预应说明替换了哪些潜变量值,以及这些值在推断分布或先验分布下是否合理。
一种拟议的诊断方法是在保持解码器其他输入不变的情况下,将某个推断编码替换为从另一个样本独立推断出的编码。将重构或条件似然的变化与扰动无关坐标的对照进行比较。对于序列解码器,应保留所声明的条件上下文,使测试能够单独识别潜变量的贡献。此类测试衡量的是训练后模型内部某种特定的因果依赖,并不能确立人类可解释的语义。本文的有限示例并未运行这些深层模型干预,而是提供了未来诊断套件应当能够成功区分的反例。
9. 训练干预需要条件匹配的比较
改变KL权重、逐渐增加该权重、限制解码器上下文或改进编码器,都可能改变潜变量使用情况。它们的机制不同。较小的权重改变优化目标;受限的上下文改变模型族;额外的推断步骤改变优化过程。仅通过潜变量KL比较所得模型,可能会因为某项干预增加了先验失配而非有意义的信息,就对其作出更高评价。
拟议研究应使用匹配的数据划分、初始化预算和停止规则,并采用多个随机种子。应报告留出数据上的似然估计及估计器细节、在所声明观测模型下的重构、潜变量依赖诊断,以及任何预期下游任务的性能。如果目标是可控生成,应包含盲法或以其他方式预先声明的控制评估,而不是挑选有利的插值。这些是拟议实验,并非已完成的结果。范围有限的可执行材料仅确立了本文所述的二元分解与受约束高斯最优解。
10. 坍塌只有作为精确诊断才有用
从较小KL项能够得出的最强结论,受测量它时所用分布与估计器的限制。在固定先验下,条件KL严格为零意味着近似后验在数据分布下几乎处处等于该先验。有限样本中较小的估计KL是更弱的观察,而聚合KL关注的则是完全不同的对象。
因此,实用诊断应指出未满足的要求:输入信息不足、解码器敏感性弱、近似推断不佳,或目标偏好不使用潜变量。有限信道表明,两个看似令人放心的摘要指标可能如何造成误导。高斯阈值说明,为何不应仅凭零载荷就推断优化失败。这些区分使拟议补救措施可以被检验。与其询问模型是否具有“更多活跃的潜变量”,不如询问在对应用重要的条件下,预期信息是否得到表示、使用和保留。
已在本地执行 · 范围有限
有限二元KL分解与受约束高斯载荷最优解
精确的有限信息求和与标量高斯期望似然。不训练任何深层编码器、解码器或互信息估计器。
344项断言通过。 这些检查验证的是所提供的示例,而非所引用的系统。
查看已记录的验证证据
{
  "binary_channel_grid": 101,
  "independent_encoder_rate_nats": 0.3680642071684971,
  "independent_encoder_information_nats": 0.0,
  "lambda3_noise3_loading_energy": 0,
  "Gaussian_parameter_pairs": 20,
  "candidate_energies_per_pair": 161
}明确声明的分析模型
四个方程,明确的假设
(1) 适用于相容密度的标准ELBO恒等式。非负差距涉及后验近似,与模型拟合不同。
(2) 在相关量有限的假设下,通过在对数比中引入聚合分布q(z)导出。编码率与信息量以纳特计量。
(3) 均匀二元X与二元对称编码器,翻转概率epsilon位于[0,1/2];采用0 log 0 = 0。聚合分布与先验之间的KL为零。
(4) 标量模型z~N(0,1)、x|z~N(az,s),固定s>0,中心化数据方差为lambda。载荷最优解针对期望边缘似然;信息表达式则在模型联合分布下成立。
构造示例 · 可复现数据
查看定量论证
这些曲线根据所声明的模型计算而得,并非所引研究的观测结果。每幅图均附有数值数据和矢量版本。


哪种证据回答哪个问题?
| 诊断方法 | 能够确立什么 | 不能确立什么 |
|---|---|---|
| 聚合分布与先验之间的KL | 聚合编码分布的失配 | 输入信息或语义有用性 |
| 期望条件KL | 信息加上聚合失配 | 解码器如何使用编码 |
| 潜变量替换测试 | 对指定干预的敏感性 | 一般语义解释或似然最优性 |
拟议的验证方案
这是拟议的评估设计。未执行任何生产系统或硬件基准测试。单独执行的有限模型记录在可执行检查中。
- 构造精确的有限联合分布,通过求和计算边缘量、条件量与互信息量。
- 同时验证有信息且聚合匹配的反例,以及无信息且聚合失配的反例。
- 独立求解标量高斯似然最优解,并与有界载荷网格进行比较。
- 对于深层模型实验,记录观测噪声假设、解码器上下文、后验分布族与优化预算。
- 跨随机种子分别评估留出数据拟合、潜变量信息代理指标、解码器干预以及预先声明的任务效用。
- 公布对估计器偏差的担忧、失败运行、模型检查点,以及已执行的有限检查与拟议训练实验之间的界限。
一手文献确立了什么
Diederik P. Kingma, Max Welling · 2013 [1]
贡献。 重参数化变分推断使采用摊销识别模型的高效学习成为可能。
边界。 可处理的训练估计器并不能保证每种模型族都具有有信息的潜变量。
文献定位。 变分下界与重参数化章节;arXiv记录。
Samuel R. Bowman, Luke Vilnis, Oriol Vinyals et al. · 2016 [2]
贡献。 用于句子的连续潜变量模型揭示了训练解码器使用其潜在编码时的实际困难。
边界。 本文既未重复其语言实验与干预,也未将其推广为普遍适用的修复方法。
文献定位。 模型与训练讨论,CoNLL 2016论文。
James Lucas, George Tucker, Roger Grosse et al. · 2019 [3]
贡献。 线性VAE分析将似然景观的行为与ELBO带来的额外效应区分开来。
边界。 这些结论针对所声明的线性模型假设;本文的标量构造是独立推导。
文献定位。 第4.1–4.2节及关于观测噪声的讨论。
本分析的局限
- 二元与标量高斯示例是分析构造,并非对已训练语言或图像模型的测量。
- 互信息不能证明语义、解耦、公平性或任务有用性。
- 标量阈值假定观测方差固定且为正,并采用单因子线性高斯模型。
- 文献选择有意聚焦;并未比较所有针对后验坍塌提出的补救措施。
这是一篇聚焦于三篇选定的奠基性一手文献的分析综述,附有原创演算示例。它不是截至2026年的详尽或系统性文献调查。文献访问范围与版本说明随参考文献记录。
可能改变结论的问题
- 哪些潜变量使用估计器能够在现实的样本量下,将信息与聚合失配区分开来?
- 何时干预会改善有用的潜变量控制,却恶化预期的似然目标?
- 没有精确后验时,如何区分推断误差与解码器的漠视?
参考文献
- Diederik P. Kingma, Max Welling. Auto-Encoding Variational Bayes. arXiv preprint (2013). 10.48550/arXiv.1312.6114.
- Samuel R. Bowman, Luke Vilnis, Oriol Vinyals et al.. Generating Sentences from a Continuous Space. Proceedings of the 20th SIGNLL Conference on Computational Natural Language Learning (2016). 10.18653/v1/K16-1002.
- James Lucas, George Tucker, Roger Grosse et al.. Don't Blame the ELBO! A Linear VAE Perspective on Posterior Collapse. arXiv preprint (2019). 10.48550/arXiv.1911.02469.
文献[1]访问范围。 一手元数据、摘要及选取的可访问方法文本;未对补充材料进行全面审查。
版本说明。 初始预印本发表于2013年;v11日期为2022年十二月10日;日期字段表示初始预印本年份,而非会议年份。
文献[2]访问范围。 一手元数据、摘要及选取的可访问方法文本;未对补充材料进行全面审查。
版本说明。 作者全名已与出版方PDF核对;Andrew M. Dai包含论文中印出的姓名首字母。
文献[3]访问范围。 一手元数据、摘要及选取的可访问方法文本;未对补充材料进行全面审查。
版本说明。 v1,提交于2019年十一月6日;记录注明获NeurIPS 2019接收。
书目身份已与出版方和作者的一手记录核对。下方文献访问范围与版本说明描述了审查范围;这不是全面的全文审查。
作者身份与来源
由Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;分析构造与拟议评估设计归属于本文。
封面为ImageGen概念插图。技术图表由明确声明的模型或有限示例计算而得,并提供Python与CSV。它们不是对已部署产品的测量,也不是复现的性能基准测试。
这份本地草稿没有独立同行评审或期刊接收记录。范围有限的可执行示例检查了所声明的小模型;它们并非对所引系统的形式化验证。