
Resumen
Los autocodificadores variacionales equilibran la reconstrucción y la codificación latente, pero los indicadores diagnósticos que suelen comunicarse no identifican un único modo de fallo. Esta revisión analítica distingue el colapso posterior condicional, la coincidencia entre la distribución agregada y la previa, la información mutua latente, la dependencia del decodificador y el error de optimización. Tres fuentes primarias motivan estas distinciones. Un canal binario finito proporciona una descomposición exacta de la información, y un decodificador gaussiano escalar revela un umbral dependiente del ruido en el que desaparece la carga latente óptima. Dos figuras reproducibles y comprobaciones ejecutables muestran por qué una KL positiva no necesariamente implica información útil y por qué una variable latente colapsada puede ser óptima bajo un modelo especificado. El protocolo empírico propuesto evalúa el uso causal de las variables latentes sin inventar resultados de pruebas de referencia de imágenes o lenguaje.
1. Identificar la variable que dejó de transmitir información
Un modelo de variables latentes puede generar observaciones plausibles mientras ignora su entrada latente. Esto constituye un problema cuando el uso previsto requiere compresión, variación controlable o una representación de ejemplos individuales. No contradice automáticamente un objetivo de verosimilitud. Antes de diagnosticar el colapso, debe indicarse qué relación se esperaba entre las observaciones, las variables latentes inferidas y las salidas del decodificador.
Este artículo aborda el colapso como una familia de afirmaciones distinguibles. La distribución del codificador puede coincidir con la previa para cada entrada; su distribución agregada puede coincidir con la previa mientras las codificaciones individuales siguen siendo informativas; el decodificador puede ser insensible a una coordenada; o una ejecución de optimización puede no alcanzar una solución mejor. Estas afirmaciones pueden solaparse, pero ningún escalar aislado las identifica todas. El objetivo es construir diagnósticos cuya interpretación resista contraejemplos sencillos, comenzando por distribuciones finitas y un modelo gaussiano en el que todas las magnitudes pertinentes se conocen exactamente.
2. Qué aportan realmente las fuentes fundamentales
Kingma y Welling introducen una construcción de aprendizaje variacional reparametrizado con un modelo de reconocimiento amortizado. Bowman y sus colegas aplican a oraciones un modelo de variables latentes continuas y examinan dificultades prácticas de entrenamiento asociadas con un uso escaso del código latente. Lucas y sus colegas analizan los autocodificadores variacionales lineales mediante su relación con el análisis probabilístico de componentes principales, distinguiendo las características del paisaje de verosimilitud de los efectos atribuidos a la cota variacional.
En conjunto, estas fuentes motivan una separación cuidadosa entre objetivos, capacidad del modelo y optimización. Sus resultados no implican que toda KL latente pequeña sea indeseable ni que una intervención resuelva universalmente el colapso. Los ejemplos analíticos que siguen son modelos pequeños derivados de forma independiente, no reproducciones de los experimentos citados de lenguaje o imágenes. En particular, el canal binario se utiliza para aislar la contabilidad de la información, mientras que el modelo gaussiano escalar aísla el papel de una varianza de observación supuesta. Ninguno pretende reproducir la dinámica de optimización de un decodificador profundo. [1], [2], [3]
3. La cota inferior de la evidencia contiene una brecha de aproximación diferenciada
Para una observación fija, el logaritmo de la verosimilitud marginal es igual a la cota inferior de la evidencia más la divergencia KL de la distribución posterior aproximada respecto de la posterior verdadera del modelo. Esta identidad separa un ajuste deficiente del modelo de una aproximación posterior inexacta. Una cota inferior baja puede deberse a cualquiera de los dos, y mejorar la inferencia puede hacer más ajustada la cota sin cambiar la distribución marginal del modelo.
También existe un problema de amortización: un codificador compartido puede no alcanzar la mejor distribución variacional disponible para cada observación. Un diagnóstico que atribuya toda brecha al comportamiento del decodificador pasa por alto esta restricción adicional. En un modelo tratable, calcúlese la posterior exacta y compárese tanto con el codificador amortizado como con una aproximación optimizada por separado para cada ejemplo. En un modelo profundo, puede no ser posible una comparación exacta, por lo que una familia posterior más expresiva aporta evidencia, no una demostración. La distinción importa porque cambiar un coeficiente de regularización y aumentar la capacidad de inferencia intervienen en partes diferentes del problema.
4. La coincidencia agregada puede coexistir con información perfecta
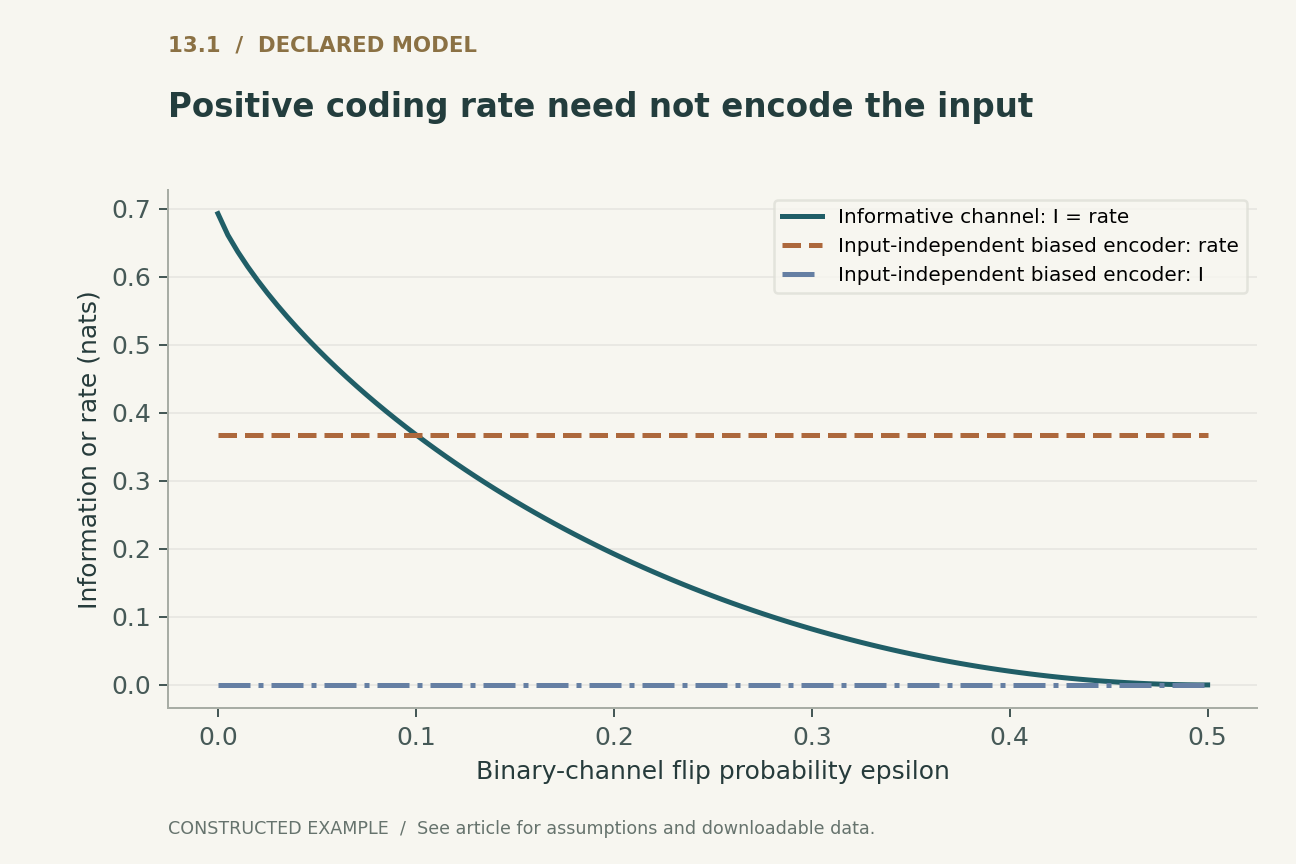
Considérese una observación binaria uniforme X y una variable latente binaria Z obtenida al invertir X con probabilidad epsilon. La distribución latente agregada es uniforme para cualquier probabilidad de inversión. Si la previa también es uniforme, la KL entre la distribución agregada y la previa es exactamente cero en todo el intervalo. Sin embargo, la información mutua latente varía desde el logaritmo de dos cuando la probabilidad de inversión es cero hasta cero cuando dicha probabilidad es un medio.
La figura 1 representa esta información en unidades naturales, o nats. También es la KL condicional esperada respecto de la previa para este canal particular. El ejemplo muestra por qué un histograma agregado que coincide con la previa no constituye evidencia de colapso. Con ruido nulo, cada codificación individual es perfectamente informativa, aunque la distribución agregada sea exactamente igual a la previa. A la inversa, la coincidencia agregada no garantiza que se conserve una propiedad semántica específica. La información mutua se refiere a la dependencia, no a la utilidad para una tarea. Ese juicio adicional requiere un objetivo posterior declarado o una intervención.
5. Una tasa de codificación positiva no necesariamente transmite información sobre la entrada
Elíjase ahora un codificador que produzca Z = 1 con probabilidad 0.9 para cualquier entrada, conservando la previa uniforme. La KL condicional esperada es positiva, de aproximadamente 0.368 nats, pero la información mutua con X es cero. Toda la tasa de codificación se dedica a la discrepancia agregada. La figura 1 incluye este contraejemplo de tasa constante junto al canal binario informativo.
La descomposición general se obtiene sumando y restando el logaritmo de la densidad agregada dentro de la KL condicional esperada. Un término es la información mutua bajo la distribución conjunta definida por los datos y el codificador; el otro es la KL entre la distribución agregada y la previa. El ejemplo finito ejecutable verifica la identidad mediante sumas explícitas, en lugar de basarse únicamente en su forma cerrada. Este cálculo también advierte contra equiparar una KL mayor tras una intervención con mejores representaciones. El aumento podría reflejar dependencia útil, discrepancia innecesaria respecto de la previa o ambas. Un informe debería estimar o acotar estas contribuciones por separado cuando sea posible.
6. Un modelo gaussiano escalar tiene un umbral de colapso exacto
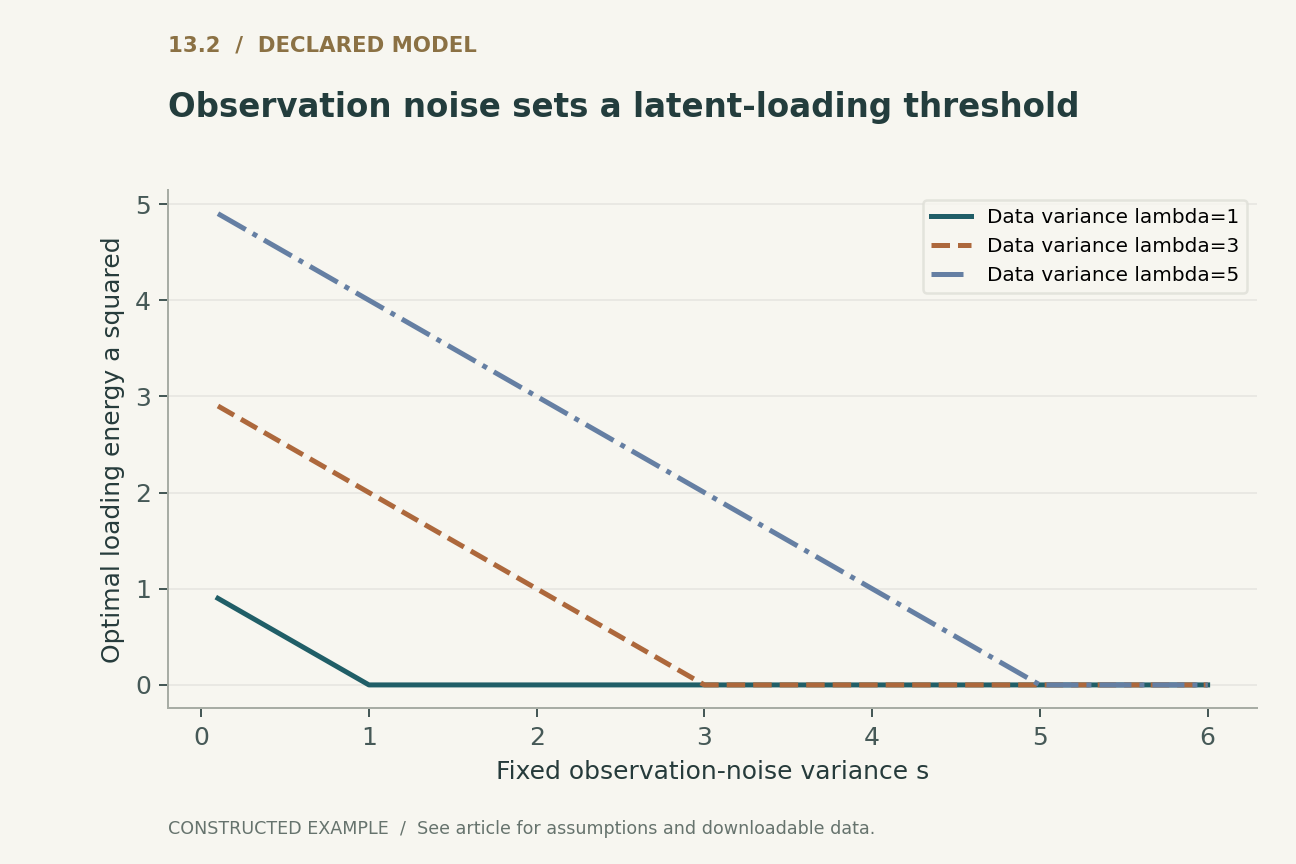
Supóngase que la variable latente previa es normal estándar y que la observación es igual a a multiplicado por la variable latente más ruido gaussiano independiente con varianza fija s. Supóngase que los datos centrados tienen varianza lambda. La varianza marginal del modelo es a al cuadrado más s. El valor esperado de la log-verosimilitud negativa, salvo una constante, es la mitad de la suma del logaritmo de la varianza del modelo y lambda dividida por esa varianza.
Al optimizar esta expresión sobre la energía de carga no negativa a al cuadrado se obtiene la parte positiva de lambda menos s. Si el ruido de observación supuesto es al menos igual a la varianza de los datos, el óptimo tiene a = 0 y la variable latente no transmite información. Si el ruido es menor, una carga no nula es óptima. La figura 2 muestra este umbral para tres varianzas de los datos. El ejemplo no afirma que una red profunda obedezca la misma frontera de fase escalar. Establece una afirmación más limitada: bajo una restricción explícita del modelo, el colapso puede ser un óptimo y no un accidente de la optimización.
7. El ruido de observación cambia lo que debe explicar la variable latente
El umbral gaussiano tiene un origen interpretable. El término de ruido fijo del decodificador ya explica s unidades de varianza. Una carga latente puede añadir varianza, pero no sustraerla. Cuando s supera la varianza observada, fijar la carga en cero proporciona la varianza marginal más cercana que puede alcanzarse dentro de esta familia. Forzar una actividad latente no nula empeoraría el objetivo de verosimilitud declarado.
Este ejemplo favorece la comunicación del modelo de observación, incluido si la varianza es fija, aprendida, diagonal o está restringida de otra manera. Una cifra de reconstrucción sin su escala de verosimilitud resulta ambigua. Un error cuadrático y una log-verosimilitud negativa solo son comparables bajo los supuestos de ruido y las constantes correspondientes. El mismo problema surge al combinar términos de reconstrucción de modalidades heterogéneas: su escala relativa cambia el incentivo para almacenar información en la variable latente. Elegir un coeficiente para obtener una representación útil puede ser razonable, pero su efecto debería describirse como un cambio del objetivo y no como la reparación de un defecto matemático universal.
8. El uso por parte del decodificador debe comprobarse mediante intervención
Una variable latente puede correlacionarse con las observaciones mientras el decodificador apenas la utiliza. A la inversa, un decodificador puede responder intensamente a cambios latentes que quedan fuera del soporte habitual del codificador. Por tanto, la correlación observacional y la interpolación arbitraria son pruebas incompletas del flujo de información útil. Una intervención debería especificar qué valores latentes se sustituyen y si esos valores son plausibles bajo la distribución de inferencia o la previa.
Un diagnóstico propuesto sustituye un código inferido por otro inferido independientemente a partir de otro ejemplo, manteniendo fijas las demás entradas del decodificador. Compárense los cambios en la reconstrucción o la verosimilitud condicional con un control que perturbe una coordenada irrelevante. Para los decodificadores de secuencias, consérvese el contexto de condicionamiento declarado, de modo que la prueba aísle la contribución latente. Estas pruebas miden una dependencia causal particular dentro del modelo entrenado; no establecen una semántica interpretable por humanos. Los ejemplos finitos actuales no ejecutan esas intervenciones sobre modelos profundos. Aportan contraejemplos que una futura batería de diagnósticos debería distinguir correctamente.
9. Las intervenciones de entrenamiento requieren comparaciones equiparadas
Cambiar el peso de KL, aumentarlo gradualmente, restringir el contexto del decodificador o mejorar el codificador pueden modificar el uso de la variable latente. Sus mecanismos difieren. Un peso menor cambia el objetivo de optimización; un contexto restringido cambia la familia del modelo; pasos adicionales de inferencia cambian el procedimiento de optimización. Comparar los modelos resultantes únicamente mediante la KL latente puede premiar una intervención por aumentar la discrepancia respecto de la previa, en vez de la información significativa.
Un estudio propuesto debería emplear particiones de datos, presupuestos de inicialización y reglas de parada equiparados, además de varias semillas aleatorias. Debería comunicar estimaciones de verosimilitud en datos reservados con detalles del estimador, la reconstrucción bajo el modelo de observación declarado, diagnósticos de dependencia latente y el rendimiento en cualquier tarea posterior prevista. Si el objetivo es la generación controlable, deben incluirse evaluaciones del control ciegas o predeclaradas de otro modo, en lugar de seleccionar interpolaciones favorables. Son experimentos propuestos, no resultados obtenidos. El artefacto ejecutable de alcance limitado solo establece la descomposición binaria y el óptimo gaussiano restringido descritos en este manuscrito.
10. El colapso solo es útil como diagnóstico preciso
La conclusión más fuerte que puede extraerse de un término KL pequeño está limitada por la distribución y el estimador utilizados para medirlo. Una KL condicional exactamente nula bajo una previa fija implica que la posterior aproximada es igual a esa previa casi en todas partes respecto de la distribución de los datos. Una KL estimada pequeña en una muestra finita es una observación más débil, y la KL agregada se refiere a un objeto completamente diferente.
Por tanto, un diagnóstico práctico debería identificar el requisito incumplido: información insuficiente sobre la entrada, sensibilidad débil del decodificador, inferencia aproximada deficiente o un objetivo que prefiere no usar la variable latente. El canal finito muestra cómo dos resúmenes aparentemente tranquilizadores pueden inducir a error. El umbral gaussiano muestra por qué no debería inferirse un fallo de optimización únicamente a partir de una carga nula. Estas distinciones permiten poner a prueba los remedios propuestos. En vez de preguntar si un modelo tiene «más variables latentes activas», pregúntese si la información prevista está representada, se utiliza y se conserva en las condiciones relevantes para la aplicación.
Ejecutado localmente · Alcance limitado
Descomposición KL binaria finita y óptimo restringido de la carga gaussiana
Sumas exactas de información finita y verosimilitud esperada gaussiana escalar. No se entrena ningún codificador profundo, decodificador profundo ni estimador de información mutua.
344 aserciones superadas. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar la evidencia de ejecución registrada
{
  "binary_channel_grid": 101,
  "independent_encoder_rate_nats": 0.3680642071684971,
  "independent_encoder_information_nats": 0.0,
  "lambda3_noise3_loading_energy": 0,
  "Gaussian_parameter_pairs": 20,
  "candidate_energies_per_pair": 161
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) La identidad ELBO estándar para densidades compatibles. La brecha no negativa concierne a la aproximación posterior, distinta del ajuste del modelo.
(2) Derivada al insertar la distribución agregada q(z) dentro del cociente logarítmico, suponiendo que las magnitudes pertinentes sean finitas. Las tasas y la información se miden en nats.
(3) X binaria uniforme y un codificador binario simétrico con probabilidad de inversión epsilon en [0,1/2]; se usa 0 log 0 = 0. La KL entre la distribución agregada y la previa es cero.
(4) Modelo escalar z~N(0,1), x|z~N(az,s), s>0 fijo y varianza lambda de los datos centrados. El óptimo de carga corresponde a la verosimilitud marginal esperada; la expresión de información se calcula bajo la distribución conjunta del modelo.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Diagnóstico | Qué establece | Qué no establece |
|---|---|---|
| KL entre la distribución agregada y la previa | Discrepancia de la distribución agregada de códigos | Información sobre la entrada o utilidad semántica |
| KL condicional esperada | Información más discrepancia agregada | Cómo utiliza el decodificador el código |
| Prueba de sustitución latente | Sensibilidad a la intervención especificada | Interpretación semántica general u optimalidad de la verosimilitud |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Construir distribuciones conjuntas finitas exactas y calcular mediante sumas las magnitudes marginales, condicionales y de información mutua.
- Verificar tanto el contraejemplo informativo con coincidencia agregada como el no informativo con discrepancia agregada.
- Resolver de forma independiente el óptimo de verosimilitud gaussiano escalar y compararlo con una cuadrícula acotada de cargas.
- Para los experimentos con modelos profundos, registrar los supuestos sobre el ruido de observación, el contexto del decodificador, la familia posterior y el presupuesto de optimización.
- Evaluar por separado, entre semillas, el ajuste en datos reservados, los indicadores indirectos de información latente, las intervenciones sobre el decodificador y la utilidad predeclarada para la tarea.
- Publicar las preocupaciones sobre el sesgo del estimador, las ejecuciones fallidas, los puntos de control del modelo y la frontera entre las comprobaciones finitas ejecutadas y los experimentos de entrenamiento propuestos.
Qué establecen las fuentes primarias
Diederik P. Kingma, Max Welling · 2013 [1]
Contribución. La inferencia variacional reparametrizada permite un aprendizaje eficiente con un modelo de reconocimiento amortizado.
Límite. Un estimador de entrenamiento tratable no garantiza variables latentes informativas para todas las familias de modelos.
Localización en la fuente. Secciones sobre la cota inferior variacional y la reparametrización; registro de arXiv.
Samuel R. Bowman, Luke Vilnis, Oriol Vinyals et al. · 2016 [2]
Contribución. Un modelo latente continuo para oraciones pone de manifiesto dificultades prácticas al entrenar un decodificador para que utilice su código latente.
Límite. Sus experimentos e intervenciones lingüísticos no se repiten aquí ni se generalizan como soluciones universales.
Localización en la fuente. Discusión del modelo y del entrenamiento, artículo de CoNLL 2016.
James Lucas, George Tucker, Roger Grosse et al. · 2019 [3]
Contribución. El análisis de VAE lineales distingue el comportamiento del paisaje de verosimilitud de los efectos adicionales de la ELBO.
Límite. Las conclusiones se refieren a los supuestos declarados del modelo lineal; la construcción escalar presentada aquí es una derivación independiente.
Localización en la fuente. Secciones 4.1–4.2 y discusión del ruido de observación.
Límites de este análisis
- Los ejemplos binario y gaussiano escalar son construcciones analíticas, no mediciones de modelos entrenados de lenguaje o imágenes.
- La información mutua no certifica semántica, disentanglement, equidad ni utilidad para una tarea.
- El umbral escalar supone una varianza de observación positiva fija y un modelo gaussiano lineal de un solo factor.
- La selección de fuentes es deliberadamente acotada; no compara todos los remedios propuestos para el colapso posterior.
Una revisión analítica focalizada de tres fuentes primarias fundamentales seleccionadas, con ejemplos desarrollados originales. No constituye una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso a las fuentes y de versión se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué estimadores del uso latente pueden separar la información de la discrepancia agregada con tamaños de muestra realistas?
- ¿Cuándo mejora una intervención el control latente útil mientras empeora el objetivo de verosimilitud previsto?
- ¿Cómo pueden distinguirse el error de inferencia y la indiferencia del decodificador sin una posterior exacta?
Referencias
- Diederik P. Kingma, Max Welling. Auto-Encoding Variational Bayes. arXiv preprint (2013). 10.48550/arXiv.1312.6114.
- Samuel R. Bowman, Luke Vilnis, Oriol Vinyals et al.. Generating Sentences from a Continuous Space. Proceedings of the 20th SIGNLL Conference on Computational Natural Language Learning (2016). 10.18653/v1/K16-1002.
- James Lucas, George Tucker, Roger Grosse et al.. Don't Blame the ELBO! A Linear VAE Perspective on Posterior Collapse. arXiv preprint (2019). 10.48550/arXiv.1911.02469.
Acceso a la fuente [1]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin una auditoría exhaustiva del material suplementario.
Nota de versión. Prepublicación inicial de 2013; v11 fechada el 10 de diciembre de 2022; el campo de fecha indica la prepublicación inicial, no el año de una conferencia.
Acceso a la fuente [2]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin una auditoría exhaustiva del material suplementario.
Nota de versión. Los nombres completos de los autores se cotejaron con el PDF del editor; Andrew M. Dai incluye la inicial impresa en el artículo.
Acceso a la fuente [3]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin una auditoría exhaustiva del material suplementario.
Nota de versión. v1, presentada el 6 de noviembre de 2019; el registro indica su aceptación en NeurIPS 2019.
Las identidades bibliográficas se cotejaron con los registros primarios de editores y autores. Las notas de acceso a las fuentes y de versión que siguen describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Escrito y revisado técnicamente por el propio Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni pruebas de rendimiento reproducidas.
Este borrador local no cuenta con un registro de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance limitado comprueban los pequeños modelos declarados; no constituyen una verificación formal de los sistemas citados.