
要旨
変分オートエンコーダは再構成と潜在符号化の均衡を図るが、一般に報告される診断指標は単一の失敗様式を特定するものではない。本分析的レビューは、条件付き事後分布崩壊、集約分布と事前分布の一致、潜在相互情報量、デコーダの依存性、および最適化誤差を区別する。これらの区別は三つの一次文献に動機づけられている。有限の二値通信路は厳密な情報分解を与え、スカラーガウスデコーダは、最適な潜在負荷が消失するノイズ依存の閾値を明らかにする。二つの再現可能な図と実行可能な検証により、正のKLが必ずしも有用な情報を意味しない理由と、指定されたモデルの下では崩壊した潜在変数が最適となりうる理由を示す。提案する実証プロトコルは、画像や言語のベンチマーク結果を創作することなく、潜在変数の因果的な利用を検証する。
1. 情報を担わなくなった変数を特定する
潜在変数モデルは、潜在入力を無視しながらもっともらしい観測を生成できる。この事実は、想定用途が圧縮、制御可能な変動、または個々の事例の表現を必要とする場合には問題となる。しかし、尤度目的と自動的に矛盾するわけではない。崩壊を診断する前に、観測、推論された潜在変数、デコーダ出力の間にどのような関係が期待されていたのかを明示しなければならない。
本稿では、崩壊を区別可能な複数の主張の集合として扱う。エンコーダ分布がすべての入力について事前分布と等しくなる場合もあれば、個々の符号化が情報を保ったまま集約分布が事前分布と等しくなる場合もある。デコーダがある座標に反応しない場合や、最適化の実行がより良い解に到達できない場合もある。これらの主張は重なりうるが、単一のスカラー量でそのすべてを特定することはできない。目的は、単純な反例に耐える解釈を持つ診断法を構築することであり、関連するすべての量を厳密に得られる有限分布とガウスモデルから始める。
2. 基礎となる文献が実際に果たす貢献
KingmaとWellingは、償却型認識モデルを用いた再パラメータ化による変分学習の枠組みを導入した。Bowmanらは、連続潜在変数モデルを文に適用し、潜在コードの利用が弱いことに伴う実際の学習上の困難を論じた。Lucasらは、線形変分オートエンコーダと確率的主成分分析との関係を通じて前者を分析し、尤度地形の特徴と変分下限に起因するとされる効果を区別した。
これらの文献は総じて、目的、モデル容量、最適化を慎重に区別する必要性を示している。その結果は、小さな潜在KLがすべて望ましくないことや、単一の介入があらゆる崩壊を解消することを意味しない。以下の分析例は独立に導出した小規模モデルであり、引用した言語実験や画像実験の再現ではない。特に、二値通信路は情報の収支を切り分けるために用い、スカラーガウスモデルは仮定した観測分散の役割を切り分ける。いずれも深層デコーダの最適化ダイナミクスを再現すると主張するものではない。 [1], [2], [3]
3. エビデンス下限には独立した近似ギャップが含まれる
固定された観測について、対数周辺尤度は、エビデンス下限と、近似事後分布からモデルの真の事後分布へのKLダイバージェンスの和に等しい。この恒等式は、モデルの適合不良と事後近似の不正確さを切り分ける。下限が低くなる原因はどちらにもあり、推論の改善によって、モデルの周辺分布を変えずに下限を厳密値に近づけられる。
償却に関する問題もある。共有エンコーダは、各観測について利用可能な最良の変分分布に到達できない場合がある。すべてのギャップをデコーダの挙動に帰する診断は、この追加的な制約を見落とす。計算可能なモデルでは、厳密な事後分布を求め、償却型エンコーダと、事例ごとに個別に最適化した近似の双方と比較すべきである。深層モデルでは厳密な比較ができない場合があるため、より表現力の高い事後分布族が与えるのは証拠であって証明ではない。この区別が重要なのは、正則化係数の変更と推論容量の増加が、問題の異なる部分に介入するためである。
4. 集約分布の一致は完全な情報と両立する
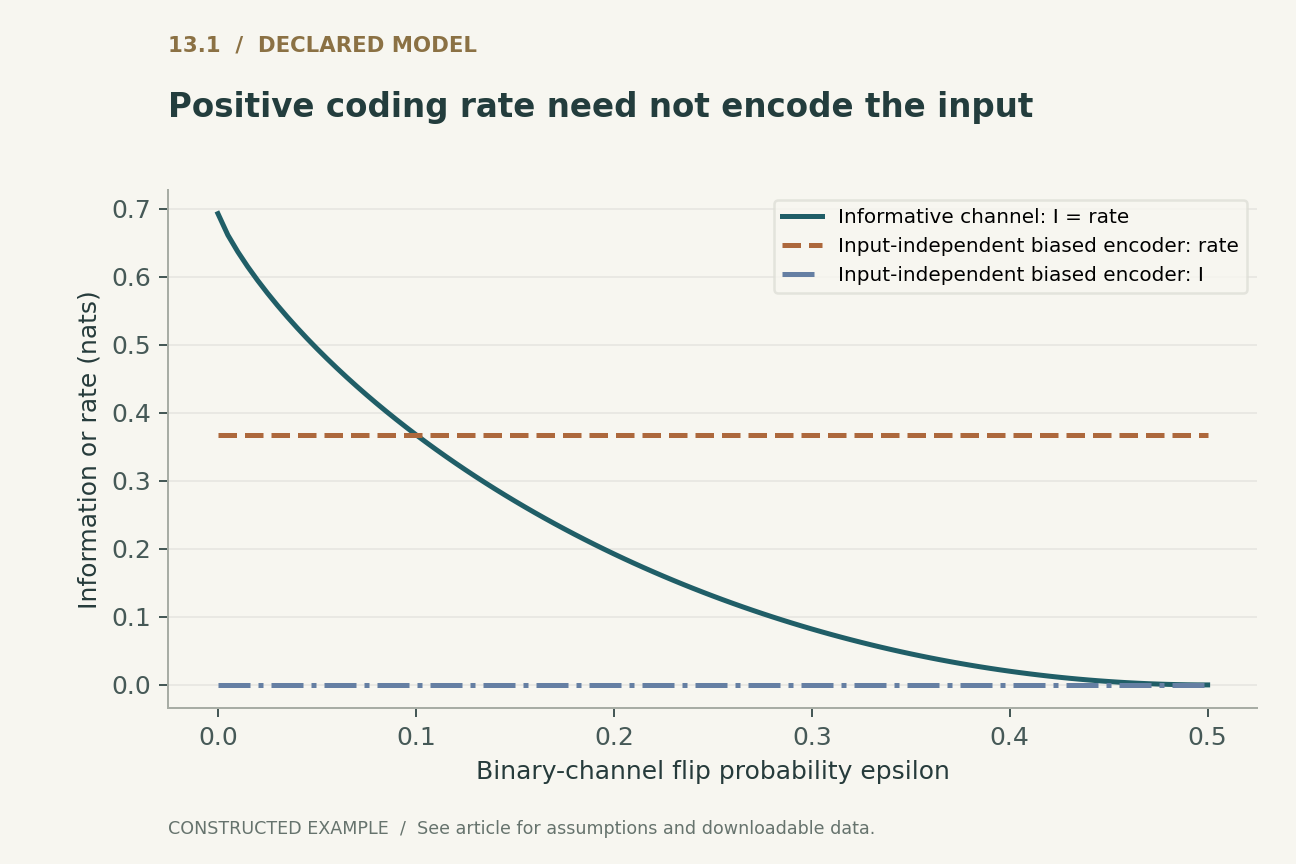
一様な二値観測Xと、確率epsilonでXを反転させて得られる二値潜在変数Zを考える。潜在変数の集約分布は、どの反転確率でも一様である。事前分布も一様なら、集約分布と事前分布のKLは全域で厳密にゼロとなる。それにもかかわらず、潜在相互情報量は、反転確率がゼロのときの二の対数から、反転確率が二分の一のときのゼロまで変化する。
図1は、この情報量を自然単位、すなわちナットで示す。この量は、この特定の通信路では事前分布に対する条件付きKLの期待値でもある。この例は、集約ヒストグラムが事前分布と一致しても崩壊の証拠にはならない理由を示す。ノイズがゼロなら、集約分布が事前分布と完全に同じに見えても、個々の符号化は完全な情報を持つ。逆に、集約分布の一致は特定の意味的性質の保持を保証しない。相互情報量が扱うのは依存性であり、タスクに対する有用性ではない。その追加的な判断には、明示された下流の目標または介入が必要である。
5. 正の符号化率は入力情報を担うとは限らない
次に、一様な事前分布を維持したまま、すべての入力に対して確率0.9でZ = 1を出力するエンコーダを選ぶ。条件付きKLの期待値は正で約0.368ナットとなるが、Xとの相互情報量はゼロである。符号化率のすべてが集約分布の不一致に費やされている。図1には、この一定符号化率の反例を、情報を持つ二値通信路と並べて示している。
一般的な分解は、条件付きKLの期待値の内部で集約密度の対数を加減することで得られる。一方の項はデータとエンコーダが定める同時分布の下での相互情報量であり、他方は集約分布と事前分布のKLである。有限の実行可能な例では、閉形式だけに依拠せず、明示的な総和によってこの恒等式を検証する。この計算はまた、介入後のKLの増加を表現の改善と同一視すべきでないことを示す。増加は、有用な依存性、不要な事前分布との不一致、またはその両方を反映している可能性がある。報告では、可能な限りこれらの寄与を個別に推定するか、上下界を与えるべきである。
6. スカラーガウスモデルには厳密な崩壊閾値がある
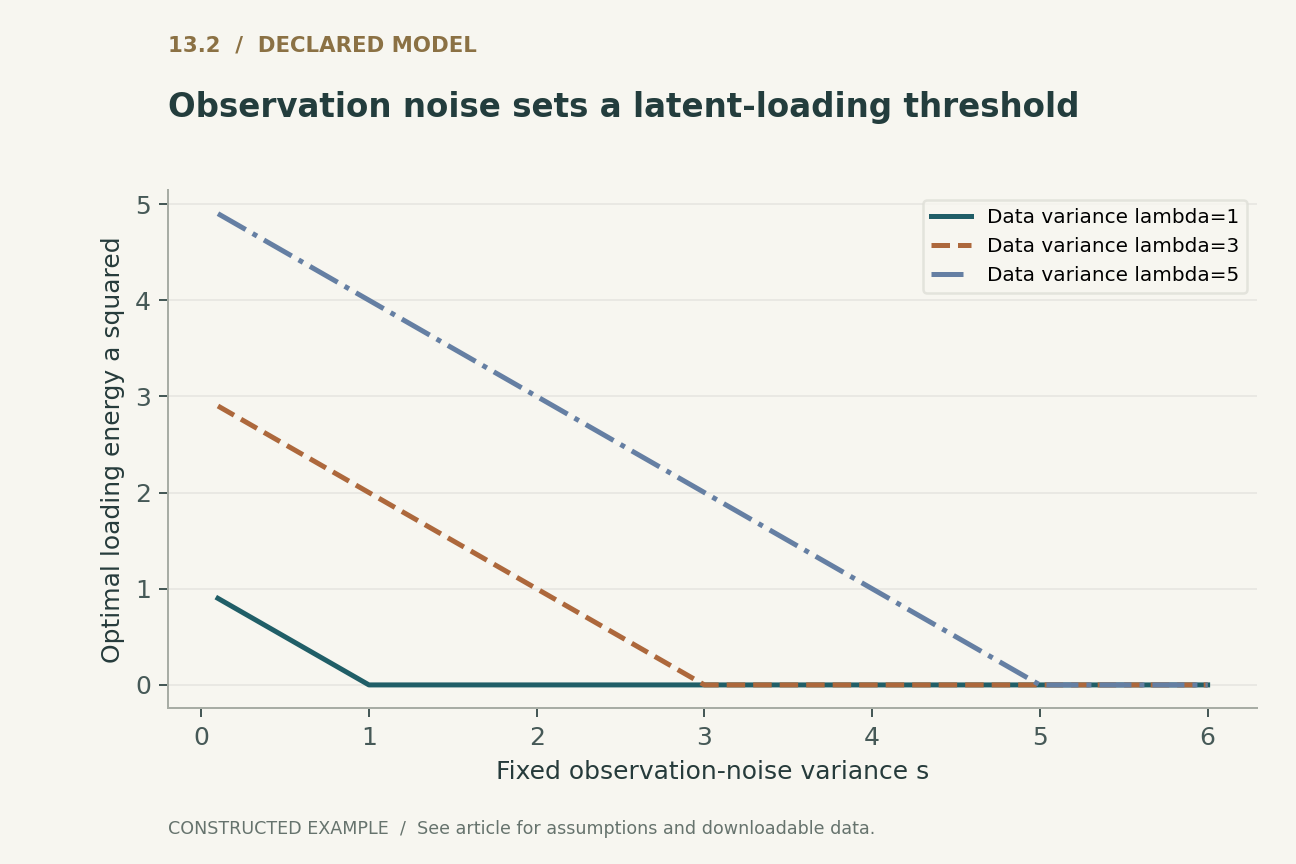
潜在変数の事前分布を標準正規分布とし、観測を潜在変数のa倍と、固定分散sを持つ独立なガウスノイズの和とする。中心化されたデータの分散をlambdaとする。モデルの周辺分散はaの二乗とsの和である。期待負の対数尤度は、定数を除けば、モデル分散の対数とlambdaをその分散で割った値の和の半分である。
非負の負荷エネルギーであるaの二乗についてこの式を最適化すると、lambdaからsを引いた値の正の部分が得られる。仮定した観測ノイズがデータ分散以上であれば、最適解はa = 0となり、潜在変数は情報を持たない。ノイズがそれより小さければ、非ゼロの負荷が最適となる。図2は、三つのデータ分散についてこの閾値を示す。この例は、深層ネットワークが同じスカラーの相境界に従うと主張するものではない。示すのはより限定された点、すなわち明示的なモデル制約の下では、崩壊が最適化の偶発的失敗ではなく最適解となりうるということである。
7. 観測ノイズは潜在変数が説明すべきものを変える
ガウスモデルの閾値には解釈可能な由来がある。デコーダの固定ノイズ項が、すでにs単位の分散を説明している。潜在負荷は分散を加えられるが、減らすことはできない。sが観測分散を上回る場合、負荷をゼロに設定することで、このモデル族内で達成可能な最も近い周辺分散が得られる。非ゼロの潜在活動を強制すると、明示された尤度目的は悪化する。
この例は、分散が固定か、学習されるか、対角か、あるいは別の制約を受けるかも含めて、観測モデルを報告することを促す。尤度の尺度を伴わない再構成の数値は曖昧である。二乗誤差と負の対数尤度を比較できるのは、対応するノイズ仮定と定数の下に限られる。異種モダリティの再構成項を組み合わせる場合にも同じ問題が生じる。項の相対的尺度が、潜在変数に情報を格納する誘因を変えるからである。有用な表現を得るために係数を選ぶことは合理的でありうるが、その効果は普遍的な数学的欠陥の修復ではなく、目的の変更として記述すべきである。
8. デコーダによる利用は介入によって検証すべきである
潜在変数が観測と相関していても、デコーダはそれをほとんど利用しない場合がある。逆に、デコーダはエンコーダの典型的な台の外側にある潜在変数の変化に強く反応する場合がある。したがって、観測上の相関と任意の補間は、有用な情報の流れを検証するには不十分である。介入では、どの潜在値を置換するのか、またその値が推論分布または事前分布の下で妥当なのかを明示すべきである。
提案する診断法の一つは、他のデコーダ入力を固定したまま、ある推論コードを別の事例から独立に推論したコードで置き換えるものである。再構成または条件付き尤度の変化を、無関係な座標を摂動する対照条件と比較する。系列デコーダでは、潜在変数の寄与を切り分けるため、明示された条件付け文脈を保つべきである。このような検証が測るのは、学習済みモデル内部の特定の因果依存性であり、人間が解釈できる意味を確立するものではない。本稿の有限例では、そのような深層モデルへの介入は実施しない。将来の診断スイートが適切に区別すべき反例を提供するものである。
9. 学習への介入には条件を揃えた比較が必要である
KLの重みを変えること、徐々に増やすこと、デコーダの文脈を制限すること、エンコーダを改善することは、いずれも潜在変数の利用を変えうる。ただし、その機構は異なる。重みの縮小は最適化の目標を変え、文脈の制限はモデル族を変え、追加の推論ステップは最適化手順を変える。得られたモデルを潜在KLだけで比較すると、有意味な情報ではなく事前分布との不一致を増やした介入を高く評価しかねない。
提案する研究では、データ分割、初期化の予算、停止規則を揃え、複数の乱数シードを用いるべきである。推定量の詳細を伴うホールドアウトデータの尤度推定、明示された観測モデルの下での再構成、潜在依存性の診断、および想定する下流タスクの性能を報告すべきである。目的が制御可能な生成であるなら、都合のよい補間を選ぶのではなく、盲検化された、または別の形で事前に規定された制御評価を含める。これらは提案された実験であり、実施済みの結果ではない。範囲を限定した実行可能成果物が確立するのは、本稿で述べた二値分解と制約付きガウス最適解のみである。
10. 崩壊という概念は精密な診断としてのみ有用である
小さなKL項から導ける最も強い結論は、その測定に用いた分布と推定量によって制限される。固定された事前分布の下で条件付きKLが厳密にゼロであるなら、近似事後分布はデータ分布に関してほとんど至る所でその事前分布に等しい。有限標本で推定KLが小さいことは、より弱い観察にすぎず、集約KLはそもそも異なる対象に関する量である。
したがって、実用的な診断では、満たされていない要件を明示すべきである。すなわち、入力情報の不足、デコーダ感度の弱さ、不十分な近似推論、あるいは潜在変数を利用しないことを選好する目的である。有限通信路は、一見安心を与える二つの要約指標がどのように誤解を招きうるかを示す。ガウス閾値は、ゼロ負荷だけから最適化の失敗を推測すべきでない理由を示す。これらの区別により、提案された対処法を検証できるようになる。モデルに「より多くの活動的な潜在変数」があるかを問う代わりに、用途にとって重要な条件の下で、意図した情報が表現され、利用され、保持されているかを問うべきである。
ローカルで実行済み · 限定された範囲
有限二値KL分解と制約付きガウス負荷の最適解
厳密な有限情報量の総和とスカラーガウス期待尤度。深層エンコーダ、深層デコーダ、相互情報量推定器の学習は行わない。
344件のアサーションに合格。 これらの検証が妥当性を確認するのは提供した例であり、引用したシステムではない。
記録された検証証跡を確認する
{
  "binary_channel_grid": 101,
  "independent_encoder_rate_nats": 0.3680642071684971,
  "independent_encoder_information_nats": 0.0,
  "lambda3_noise3_loading_energy": 0,
  "Gaussian_parameter_pairs": 20,
  "candidate_energies_per_pair": 161
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された分析モデル
四つの方程式と明示的な仮定
(1) 整合的な密度に対する標準的なELBO恒等式。非負のギャップは事後近似に関するものであり、モデル適合とは異なる。
(2) 関連する量が有限であると仮定し、対数比の内部に集約分布q(z)を挿入して導出する。符号化率と情報量はナットで測る。
(3) 一様な二値Xと、反転確率epsilonが[0,1/2]にある二元対称エンコーダ。0 log 0 = 0を用いる。集約分布と事前分布のKLはゼロである。
(4) スカラーモデルz~N(0,1)、x|z~N(az,s)、固定されたs>0、中心化データの分散lambda。負荷の最適解は期待周辺尤度に対するものであり、情報量の式はモデルの同時分布の下でのものである。
構成した例 · 再現可能なデータ
定量的な論拠を確認する
これらの曲線は明示されたモデルから計算したものであり、引用研究の観測結果ではない。各図には数値データとベクター版を付属する。


どの証拠がどの問いに答えるのか
| 診断法 | 確立できること | 確立できないこと |
|---|---|---|
| 集約分布と事前分布のKL | 集約コード分布の不一致 | 入力情報または意味的有用性 |
| 条件付きKLの期待値 | 情報量と集約分布の不一致の和 | デコーダがコードをどのように利用するか |
| 潜在変数の置換テスト | 指定された介入に対する感度 | 一般的な意味解釈または尤度最適性 |
提案する検証プロトコル
これは提案された評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証に記録している。
- 厳密な有限同時分布を構成し、周辺量、条件付き量、相互情報量を総和によって計算する。
- 情報を持ち集約分布が一致する反例と、情報を持たず集約分布が不一致となる反例の両方を検証する。
- スカラーガウス尤度の最適解を独立に求め、有界な負荷のグリッドと比較する。
- 深層モデルの実験では、観測ノイズの仮定、デコーダの文脈、事後分布族、最適化予算を記録する。
- ホールドアウト適合度、潜在情報の代理指標、デコーダへの介入、事前に規定したタスク有用性を、シード間でそれぞれ独立に評価する。
- 推定量のバイアスに関する懸念、失敗した実行、モデルのチェックポイント、および実行済みの有限例の検証と提案段階の学習実験との境界を公開する。
一次文献が確立していること
Diederik P. Kingma, Max Welling · 2013 [1]
貢献。 再パラメータ化による変分推論は、償却型認識モデルを用いた効率的な学習を可能にする。
適用範囲の限界。 計算可能な学習用推定量があっても、すべてのモデル族で情報を持つ潜在変数が得られるとは限らない。
文献内の該当箇所。 変分下限と再パラメータ化に関する節、およびarXivの記録。
Samuel R. Bowman, Luke Vilnis, Oriol Vinyals et al. · 2016 [2]
貢献。 文のための連続潜在モデルは、デコーダが潜在コードを利用するよう学習させる際の実際的な課題を明らかにする。
適用範囲の限界。 その言語実験と介入を本稿で再実施することも、普遍的な解決策として一般化することもしない。
文献内の該当箇所。 モデルと学習に関する議論、CoNLL 2016論文。
James Lucas, George Tucker, Roger Grosse et al. · 2019 [3]
貢献。 線形VAEの分析は、尤度地形の挙動とELBOによる追加的な効果を区別する。
適用範囲の限界。 結論は明示された線形モデルの仮定に関するものであり、本稿のスカラー構成は別個の導出である。
文献内の該当箇所。 第4.1–4.2節および観測ノイズに関する議論。
本分析の限界
- 二値例とスカラーガウス例は分析的な構成であり、学習済みの言語モデルや画像モデルの測定ではない。
- 相互情報量は、意味、表現因子の分離(ディスエンタングルメント)、公平性、またはタスク有用性の保証ではない。
- スカラー閾値は、固定された正の観測分散と単一因子の線形ガウスモデルを仮定している。
- 文献の選定は意図的に焦点を絞っており、事後分布崩壊に対する提案済みの対処法をすべて比較するものではない。
選定した三つの基礎的な一次文献に焦点を絞り、独自の具体的な計算例を含む分析的レビューである。2026年までの文献を網羅的または系統的に調査したものではない。文献へのアクセス範囲と版に関する注記は参考文献とともに記録している。
結論を変えうる問い
- 現実的な標本サイズで、情報と集約分布の不一致を切り分けられる潜在利用の推定量は何か。
- 介入が有用な潜在制御を改善する一方で、意図した尤度目的を悪化させるのはどのような場合か。
- 厳密な事後分布なしに、推論誤差とデコーダの無関心をどのように区別できるか。
参考文献
- Diederik P. Kingma, Max Welling. Auto-Encoding Variational Bayes. arXiv preprint (2013). 10.48550/arXiv.1312.6114.
- Samuel R. Bowman, Luke Vilnis, Oriol Vinyals et al.. Generating Sentences from a Continuous Space. Proceedings of the 20th SIGNLL Conference on Computational Natural Language Learning (2016). 10.18653/v1/K16-1002.
- James Lucas, George Tucker, Roger Grosse et al.. Don't Blame the ELBO! A Linear VAE Perspective on Posterior Collapse. arXiv preprint (2019). 10.48550/arXiv.1911.02469.
文献[1]の参照範囲。 一次メタデータ、要旨、およびアクセス可能な方法記述の一部。補足資料の網羅的な監査は行っていない。
版に関する注記。 初回プレプリントは2013年。v11は2022年十二月10日付。日付欄は学会開催年ではなく初回プレプリントを示す。
文献[2]の参照範囲。 一次メタデータ、要旨、およびアクセス可能な方法記述の一部。補足資料の網羅的な監査は行っていない。
版に関する注記。 著者の完全な氏名を出版社のPDFと照合した。Andrew M. Daiには論文に印刷されたイニシャルを含めている。
文献[3]の参照範囲。 一次メタデータ、要旨、およびアクセス可能な方法記述の一部。補足資料の網羅的な監査は行っていない。
版に関する注記。 v1、2019年十一月6日投稿。記録にはNeurIPS 2019への採択が記されている。
書誌上の同一性は、出版社および著者による一次記録と照合した。以下のアクセス範囲と版に関する注記が調査範囲を示すものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示しており、分析的構成と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は明示されたモデルまたは有限例から計算され、PythonとCSVを提供している。これらは運用中の製品の測定でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示された小規模モデルを検証するものであり、引用したシステムの形式検証ではない。