
Resumen
Flow matching aprende un campo de velocidad a partir de una trayectoria elegida de distribuciones de probabilidad. Esta revisión distingue el acoplamiento de los extremos, la interpolación condicional, el objetivo de regresión marginal y el flujo numérico producido durante la inferencia. Tres fuentes primarias establecen el contexto de flow matching, la rectificación y los modelos de profundidad continua. Una construcción gaussiana independiente demuestra que las líneas condicionales rectas pueden inducir un flujo marginal curvo, mientras que un acoplamiento anticorrelacionado crea una singularidad interior pese a tener distribuciones válidas en los extremos. Las figuras reproducibles de varianza y error de integración ponen de manifiesto estas distinciones. El artículo desarrolla una propuesta de diseño de evaluación centrada en el acoplamiento, el condicionamiento, la corrección de los extremos y el coste numérico, sin afirmar nuevos resultados de referencia para modelos generativos.
1. La especificación de una trayectoria contiene más que dos distribuciones
Para transformar ruido en datos, no basta con nombrar una distribución de origen y otra de destino. También hay que especificar cómo se emparejan los puntos, cómo se desplazan los puntos emparejados a través de los tiempos intermedios y cómo se asigna una única velocidad a cada ubicación visitada por muchas de esas trayectorias. Distintas elecciones pueden compartir extremos idénticos y aun así producir problemas de regresión muy diferentes.
Esta revisión utiliza ejemplos gaussianos unidimensionales para separar esas elecciones. Son deliberadamente lo bastante simples como para calcularlos sin entrenar una red. Las lecciones resultantes conciernen a la identificación y al condicionamiento numérico, no a la calidad relativa de las imágenes de modelos comerciales o de investigación. En particular, el adjetivo «recto» puede referirse a una línea condicional entre dos extremos muestreados o a una trayectoria de la ecuación diferencial ordinaria marginal aprendida. Son objetos diferentes. Una exposición rigurosa indica cuál se mide, bajo qué acoplamiento y respecto de qué parámetro temporal.
2. Contribuciones que deben mantenerse diferenciadas
Lipman y sus colaboradores formulan flow matching como una regresión sobre campos vectoriales asociados a trayectorias de probabilidad condicionales; el objetivo condicional proporciona la relación adecuada con el gradiente marginal. Liu, Gong y Liu estudian el flujo rectificado mediante la interpolación recta entre extremos y la regresión, incluidas las propiedades del coste de transporte bajo la construcción que especifican. Chen y sus colaboradores proporcionan el marco de profundidad continua y de flujos normalizantes continuos en el que una ecuación diferencial aprendida puede transformar estados y seguir densidades.
Estos trabajos conectan el diseño de trayectorias, el aprendizaje y la integración numérica, pero no reducen esas etapas a una única garantía. Un objetivo de entrenamiento sin simulación sigue requiriendo un procedimiento de muestreo. Una interpolación condicional de desplazamiento no establece, por esa expresión por sí sola, que el acoplamiento de los extremos sea globalmente óptimo para un coste de transporte elegido. Los ejemplos siguientes son deducciones y pruebas propias de este artículo. No recrean los experimentos citados ni afirman que todas las implementaciones prácticas de flow matching utilicen la misma familia de trayectorias. [1], [2], [3]
3. La regresión condicional promedia instrucciones que se intersectan
Sean X0 y X1 variables de extremos emparejadas, y defínase un estado intermedio mediante interpolación lineal. Cada par lleva la velocidad condicional constante X1 menos X0. Varios pares pueden atravesar un entorno con velocidades diferentes. La regresión por error cuadrático asigna la velocidad media condicional dados el estado intermedio y el tiempo. Es precisamente en este promedio donde un conjunto de instrucciones condicionales rectas se convierte en un único campo marginal.
La varianza condicional no resuelta de la velocidad es un término irreducible de la regresión. No desaparece simplemente porque las líneas de entrenamiento sean rectas. Un modelo entrenado con capacidad suficiente y optimización ideal se aproxima a la media condicional, no a un único par oculto de extremos para cada observación intermedia. Distinguir estos objetivos evita un error de diagnóstico habitual: considerar una pérdida de entrenamiento condicional distinta de cero como prueba de que el transporte marginal es incorrecto. La referencia adecuada es el riesgo de regresión de Bayes para el acoplamiento y la interpolación elegidos, cuando puede calcularse.
4. Los extremos gaussianos independientes producen un valle de varianza
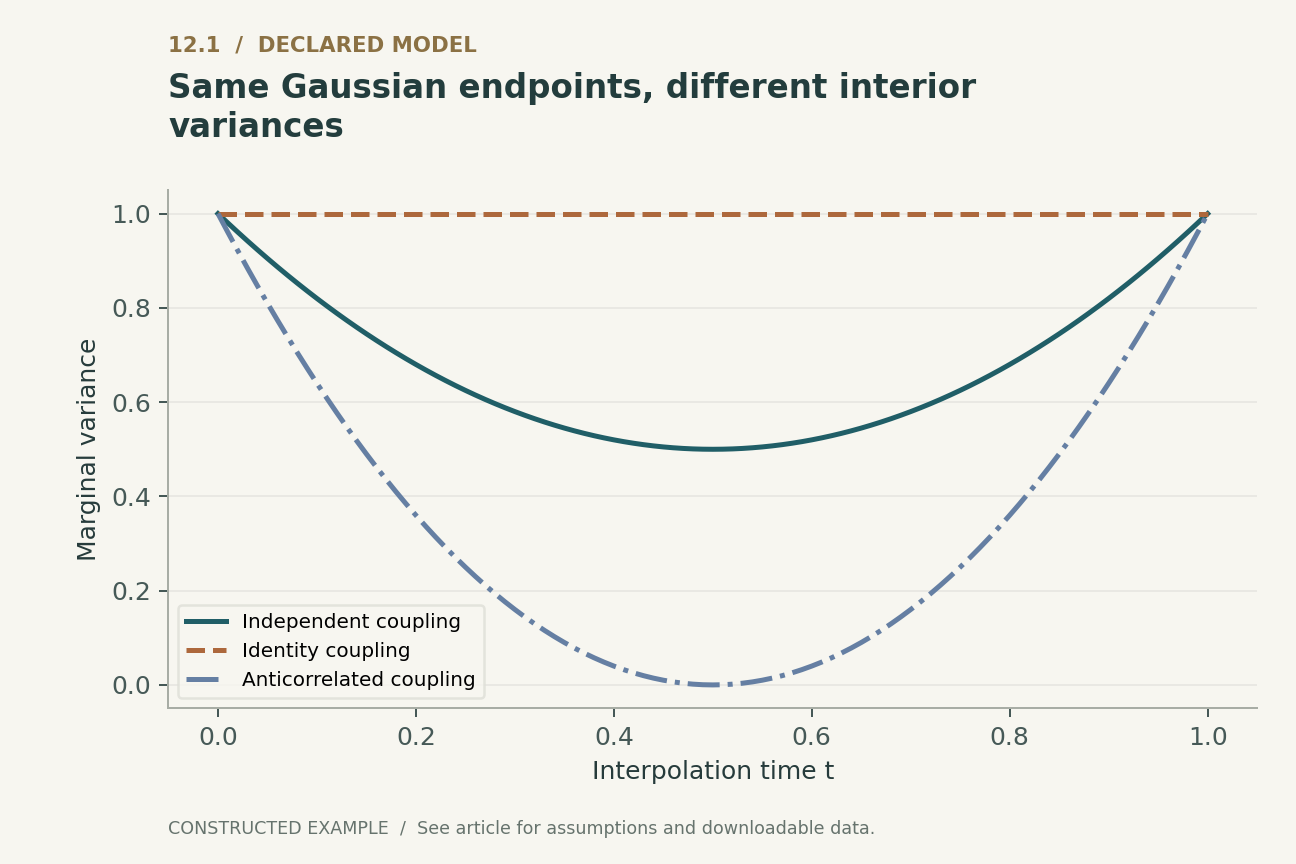
Elíjanse extremos independientes con distribución normal estándar. La varianza interpolada es la suma de los cuadrados de los pesos de interpolación, alcanza un medio en el punto medio y vuelve a uno al final. La velocidad marginal es un coeficiente dependiente del tiempo multiplicado por el estado actual, y ese coeficiente es el cociente de dos t menos uno entre dicha varianza. Contrae antes del punto medio y expande después.
La trayectoria marginal exacta que comienza en x0 es x0 multiplicado por la raíz cuadrada de la varianza interpolada. Vuelve a su posición inicial en el extremo final, aunque la mayoría de los pares condicionales muestreados tienen extremos diferentes. Así, el flujo determinista induce un acoplamiento distinto del emparejamiento independiente original, al tiempo que reproduce las marginales gaussianas prescritas. La figura 1 hace visible el valle de varianza. Este es un contraejemplo explícito de la afirmación de que las trayectorias condicionales rectas obligan a que toda trayectoria marginal sea recta, y no requiere ni error de aproximación ni capacidad limitada de la red.
5. El acoplamiento puede crear o evitar una singularidad interior
Compárese el acoplamiento independiente con otros dos emparejamientos que tienen las mismas marginales normales estándar en los extremos. Bajo el emparejamiento identidad, cada punto permanece fijo y la varianza sigue siendo uno. Bajo el emparejamiento anticorrelacionado X1 = menos X0, la varianza se convierte en el cuadrado de uno menos dos veces el tiempo y colapsa a cero en el punto medio. Todos los puntos se encuentran allí antes de separarse de nuevo.
El ejemplo anticorrelacionado no es una demostración válida de un flujo invertible globalmente regular que atraviese ese punto medio. Su propósito es precisamente revelar el supuesto de regularidad que falta. Una EDO determinista localmente Lipschitz con trayectorias únicas no puede llevar todos los puntos iniciales distintos a un mismo estado y recuperar después sus diferencias. Por tanto, una familia elegida de medidas de probabilidad puede estar bien definida algebraicamente sin admitir el tipo de campo de velocidad suave e invertible que pretende un modelo de flujo normalizante. La plausibilidad de los extremos no elimina la necesidad de examinar el condicionamiento intermedio.
6. Una etiqueta de coste de transporte requiere un acoplamiento especificado
Para extremos independientes normales estándar, el desplazamiento cuadrático esperado es dos. Para el acoplamiento identidad es cero, y cero es el coste cuadrático mínimo posible entre dos distribuciones idénticas. El acoplamiento anticorrelacionado tiene un desplazamiento cuadrático esperado de cuatro. Estos números son propiedades exactas de tres acoplamientos que comparten las mismas marginales.
La comparación muestra por qué «transporte óptimo» debe identificar el problema de optimización y qué es realmente óptimo. Una línea recta punto a punto es la más corta entre sus propios extremos según la longitud euclídea, pero el emparejamiento de esos extremos puede ser costoso. Además, minimizar un objetivo de transporte poblacional, aproximar un emparejamiento en un minilote y elegir una trayectoria gaussiana condicional son operaciones distintas. Ninguna debe heredar tácitamente la garantía de otra. Para evaluar modelos generativos, deben comunicarse el mecanismo de emparejamiento y su presupuesto de aproximación. Si no se realizó una optimización global de los extremos, la descripción debe indicarlo en lugar de permitir que la terminología geométrica lo sugiera.
7. Los métodos numéricos discretos no heredan la preservación exacta de las marginales
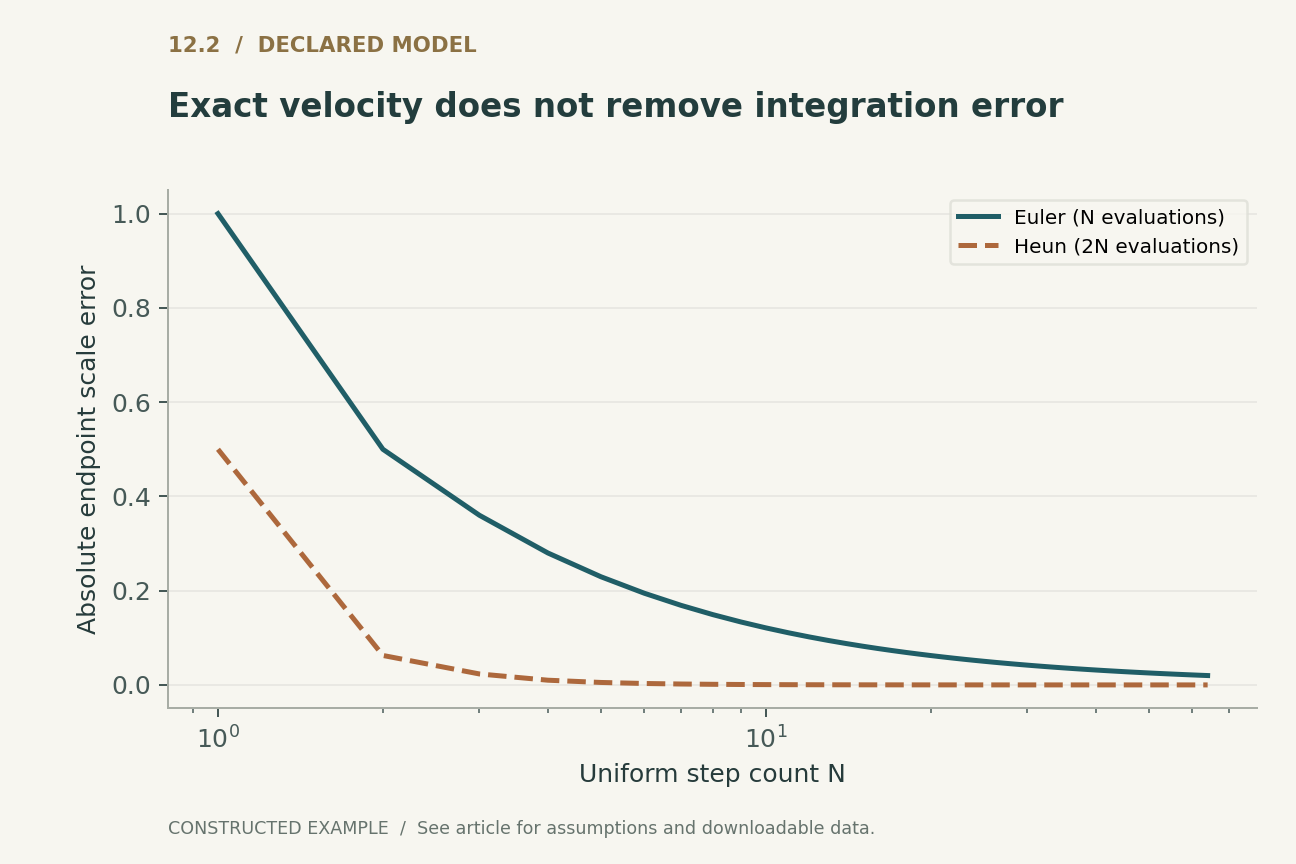
El flujo marginal gaussiano independiente vuelve a la distribución original en el tiempo uno. Un método de Euler explícito de un solo paso no lo hace: su coeficiente de velocidad inicial es menos uno, por lo que cada valor inicial se lleva a cero. Una actualización de Heun de un solo paso lleva cada valor inicial a la mitad de su valor original. Ambos se apartan de la escala final exacta de uno, pese a usar el campo exacto.
La figura 2 aumenta el número de pasos uniformes y mide el error absoluto de la escala final para ambos métodos. La solución de referencia se calcula de forma independiente a partir de la trayectoria de varianza conocida. Esta construcción separa el error del método numérico del error de aprendizaje porque no hay ninguna red. También evita interpretar el número de evaluaciones de la función como coste en tiempo real: aquí Heun utiliza dos evaluaciones del campo por paso, mientras que Euler utiliza una. Un estudio justo de implementación comunicaría tanto las evaluaciones como el uso medido de recursos. La convergencia en este ejemplo suave no establece estabilidad cerca del acoplamiento singular considerado anteriormente.
8. La reparametrización temporal cambia la dificultad sin cambiar los extremos
Un cambio monótono de la coordenada temporal puede preservar una trayectoria geométrica mientras redistribuye su velocidad. La velocidad transformada incluye la derivada del nuevo reloj, por lo que las regiones comprimidas en intervalos temporales cortos pueden requerir velocidades locales mayores y un control más estricto del método numérico. El entrenamiento con muestras uniformes en la nueva variable temporal también cambia la ponderación efectiva de la trayectoria original.
En consecuencia, un objetivo de regresión aparentemente más fácil puede reflejar una medida temporal alterada en lugar de un transporte intrínsecamente más simple. Un análisis debe distinguir la curvatura geométrica, la variación de velocidad y las derivadas que controlan el error de truncamiento numérico. Están relacionadas, pero no son idénticas. Las figuras suministradas mantienen el intervalo unitario original y pasos temporales iguales para que sus comparaciones sean inequívocas. En un estudio empírico de la programación temporal, deberían compararse varios relojes con presupuestos de evaluación fijos y tolerancias de integración controladas, manteniendo métricas de los extremos que detecten una concentración incorrecta o pérdida de soporte.
9. El cálculo de la verosimilitud requiere su propia evidencia numérica
Un transporte determinista puede utilizarse para generar muestras sin evaluar nunca una densidad. Calcular la verosimilitud mediante un flujo normalizante continuo requiere además seguir la divergencia de la velocidad a lo largo de las trayectorias y tratar de forma coherente la densidad base y la transformación de los datos. El error numérico en la evolución del estado y en el cálculo de la densidad puede interactuar.
Una muestra de aspecto razonable no valida esta estimación de densidad. A la inversa, una verosimilitud plausible en una distribución de prueba estrecha no demuestra una cobertura adecuada de los modos relevantes para la aplicación. En el diagnóstico gaussiano, la densidad y la varianza están disponibles analíticamente, lo que proporciona una referencia independiente para cualquier futura implementación de seguimiento de densidad. El código complementario actual verifica únicamente varianzas y escalas finales; no implementa un estimador de verosimilitud. Explicitar ese límite importa porque, de lo contrario, el vocabulario de los flujos normalizantes puede hacer que una capacidad no implementada parezca haber sido probada. Deben comunicarse la generación, la estimación de densidad y la inversión como operaciones separadas.
10. Un contrato experimental más sólido para los modelos de flujo
Un contrato de evaluación útil registra cuatro capas: distribuciones de los extremos y acoplamiento; trayectoria condicional y medida temporal; campo marginal entrenado; y procedimiento numérico de inferencia. El contrato debe incluir el comportamiento cerca de los extremos y en cualquier región interior de baja densidad o alta concentración. También debe registrar si un estadístico de rectitud se calcula sobre las líneas condicionales de entrenamiento o sobre trayectorias muestreadas de la EDO aprendida.
El protocolo propuesto comienza con los controles gaussianos de este artículo y luego se amplía a distribuciones multimodales con densidad conocida. Solo después debería introducirse una prueba de referencia con datos reales en la que no se disponga de referencias exactas de transporte. Esa secuencia no puede demostrar que un modelo grande sea correcto, pero puede revelar si una mejora aparente procede del diseño de la trayectoria, la capacidad de regresión o el presupuesto del método numérico. El criterio central no es que toda trayectoria deba ser recta. Es que la propiedad geométrica afirmada y el objeto numérico sometido a prueba se refieran a la misma construcción.
Ejecutado localmente · Alcance acotado
Covarianza condicional y extremos del flujo gaussiano conocidos de forma independiente
Identidades del acoplamiento gaussiano y dos métodos numéricos escalares programados explícitamente; la trayectoria anticorrelacionada singular es solo un contraejemplo, no un flujo regular válido.
Se superaron 106 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testimonio de verificación registrado
{
  "independent_midpoint_variance": 0.5,
  "anticorrelated_midpoint_variance": 0,
  "Euler_N1_scale": 0.0,
  "Heun_N1_scale": 0.5,
  "Euler_N64_error": 0.019885668352616848,
  "Heun_N64_error": 2.5536292165284635e-06
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Interpolación lineal bajo un acoplamiento especificado de los extremos; la regresión por error cuadrático produce la media condicional marginal donde está definida.
(2) Extremos independientes normales estándar. Esta trayectoria marginal exacta es generalmente curva en el tiempo pese a las trayectorias condicionales rectas.
(3) Acoplamientos gaussianos identidad y anticorrelacionado. Este último colapsa en t=1/2 y allí vulnera la interpretación como flujo regular invertible.
(4) Euler explícito para la EDO marginal gaussiana independiente, h=1/N. Heun, en el código, promedia las pendientes inicial y del extremo predicho; la escala final exacta es uno.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Construcción | Marginales de los extremos | Propiedad intermedia o del acoplamiento |
|---|---|---|
| Emparejamiento identidad | Ambas normales estándar | Varianza uno; coste de desplazamiento cuadrático cero |
| Emparejamiento independiente | Ambas normales estándar | Varianza en el punto medio de un medio; coste dos |
| Emparejamiento anticorrelacionado | Ambas normales estándar | Colapso en el punto medio; coste cuatro |
Una propuesta de protocolo de validación
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Declarar las marginales de los extremos, la generación del acoplamiento, la ecuación de la trayectoria y la medida de muestreo temporal.
- Verificar las medias condicionales y las varianzas marginales en casos gaussianos con respuestas analíticas independientes.
- Incluir el caso anticorrelacionado singular como un supuesto de flujo regular rechazado, no como una prueba de referencia válida de flujo suave.
- Medir los errores finales de Euler y Heun frente a trayectorias exactas y contar las evaluaciones del campo.
- En los experimentos con aprendizaje, separar el error de regresión, la varianza condicional irreducible, el error de densidad y el error de muestreo.
- Archivar las semillas de emparejamiento, las tolerancias numéricas, el recorte de los extremos, la precisión, las comprobaciones de inversión y las distribuciones de evaluación especificadas de forma independiente.
Qué establecen las fuentes primarias
Yaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu et al. · 2022 [1]
Contribución. La regresión de trayectorias condicionales proporciona una construcción escalable para entrenar flow matching.
Límite. La terminología de trayectorias condicionales por sí sola no certifica un acoplamiento de extremos globalmente óptimo.
Localización en la fuente. Secciones 3.1–3.2 y 4; arXiv v2.
Xingchao Liu, Chengyue Gong, Qiang Liu · 2022 [2]
Contribución. El flujo rectificado estudia la interpolación recta, la regresión condicional y las propiedades de transporte inducidas.
Límite. Los resultados enunciados sobre coste y rectitud dependen de la construcción y de los supuestos; no se reproduce ninguna prueba de referencia citada.
Localización en la fuente. Resumen y formulación de la rectificación; arXiv v1.
Ricky T. Q. Chen, Yulia Rubanova, Jesse Bettencourt et al. · 2018 [3]
Contribución. Los modelos neuronales de profundidad continua y los flujos normalizantes continuos hacen explícitas las transformaciones de estado y densidad basadas en EDO.
Límite. Los métodos numéricos y el seguimiento de densidad introducen errores de implementación separados.
Localización en la fuente. Sección de flujos normalizantes continuos; marco original, con indicación de la versión actual del registro de arXiv.
Límites de este análisis
- Los ejemplos ejecutables utilizan distribuciones gaussianas escalares y no predicen el rendimiento de la síntesis de imágenes.
- La trayectoria anticorrelacionada singular es un contraejemplo de los supuestos de regularidad, no una construcción generativa recomendada.
- Aquí no se entrena ni se somete a pruebas de referencia ninguna red aprendida, estimador de verosimilitud ni método de resolución global de transporte óptimo.
- Tres fuentes fundacionales seleccionadas no constituyen una revisión sistemática de las variantes de flow matching.
Una revisión analítica focalizada de tres fuentes primarias fundacionales seleccionadas, con ejemplos resueltos originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso y versión de las fuentes se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué estadísticos del acoplamiento predicen la rigidez del campo marginal antes de entrenar un modelo grande?
- ¿Cómo debería el muestreo temporal equilibrar la varianza de la regresión y la dificultad de la integración numérica?
- ¿Puede evaluarse la calidad del acoplamiento sin confundir la rectitud condicional con la optimalidad global del transporte?
Referencias
- Yaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu et al.. Flow Matching for Generative Modeling. arXiv preprint (2022). 10.48550/arXiv.2210.02747.
- Xingchao Liu, Chengyue Gong, Qiang Liu. Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow. arXiv preprint (2022). 10.48550/arXiv.2209.03003.
- Ricky T. Q. Chen, Yulia Rubanova, Jesse Bettencourt et al.. Neural Ordinary Differential Equations. arXiv preprint (2018). 10.48550/arXiv.1806.07366.
Acceso a la fuente [1]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin auditoría exhaustiva del material suplementario.
Nota de versión. Prepublicación inicial en 2022; v2 revisada el 8 de febrero de 2023.
Acceso a la fuente [2]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin auditoría exhaustiva del material suplementario.
Nota de versión. v1, enviada el 7 de septiembre de 2022.
Acceso a la fuente [3]. Metadatos primarios, resumen y texto metodológico accesible seleccionado; sin auditoría exhaustiva del material suplementario.
Nota de versión. Prepublicación inicial en 2018; la v6 actual, fechada el 9 de octubre de 2026, incluye correcciones en el recuento de figuras según el registro. Esta revisión utiliza el marco, no esos recuentos.
Las identidades bibliográficas se cotejaron con registros primarios de editoriales y autores. Las notas de acceso y versión de las fuentes que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva del texto completo.
Autoría y procedencia
Escrito y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se suministran Python y CSV. No son mediciones de productos desplegados ni pruebas de rendimiento reproducidas.
Este borrador local no tiene constancia de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos enunciados; no constituyen una verificación formal de los sistemas citados.