
Resumen
La generación por difusión combina un campo estadístico aprendido con un procedimiento de transporte numérico. Esta revisión analítica separa los errores de predicción de ruido, scores, estimaciones sin ruido, inicialización e integración temporal. Tres fuentes primarias fundacionales establecen el contexto de modelización; una construcción gaussiana derivada de manera independiente muestra después por qué un error de predicción aparentemente pequeño puede tener consecuencias distintas a diferentes escalas de ruido. Un ejemplo estacionario de Ornstein-Uhlenbeck revela un sesgo persistente en el punto final incluso cuando el integrador converge. Dos figuras reproducibles y comprobaciones numéricas de alcance acotado respaldan la construcción, mientras que un protocolo de evaluación propuesto separa el error del modelo del error del integrador sin presentar curvas sintéticas como mediciones de generación de imágenes.
1. Definir el objeto que se supone preciso
Una imagen generada puede resultar visualmente convincente aunque su distribución difiera de la distribución de entrenamiento. A la inversa, una mejora de la verosimilitud no tiene por qué corregir la característica que un espectador considera importante. Por tanto, un análisis técnico útil comienza por declarar qué objeto se aproxima: una densidad indexada por el tiempo, su score, una esperanza condicional del ruido o una secuencia finita de transiciones. Estos objetos están relacionados mediante ecuaciones, pero sus errores tienen unidades y ponderaciones diferentes. Tratarlos como intercambiables dificulta la interpretación de una curva de validación.
El análisis se ocupa aquí de variables euclídeas continuas con densidades ruidosas suaves y positivas. No infiere fidelidad semántica a partir de un error escalar. Su pregunta principal es más acotada: ¿cómo entra un error especificado del predictor en un muestreador explícitamente especificado? Esa pregunta puede responderse exactamente en un modelo gaussiano y utilizarse después para organizar, en lugar de sustituir, experimentos con imágenes. Un objetivo de entrenamiento, una configuración del muestreador y una evaluación del punto final constituyen tres piezas de evidencia distintas.
2. Qué establecen las tres construcciones fundacionales
Ho, Jain y Abbeel conectan un proceso gaussiano de corrupción directa con transiciones inversas aprendidas y un objetivo simplificado de predicción de ruido. Esto proporciona una construcción de entrenamiento tratable; no hace que todos los pasos temporales tengan la misma importancia bajo cualquier muestreador. Song y sus colaboradores formulan la generación basada en scores mediante ecuaciones diferenciales estocásticas y una ecuación diferencial ordinaria de flujo de probabilidad correspondiente. Su equivalencia concierne a las distribuciones marginales con el score exacto apropiado y los supuestos de regularidad pertinentes. No afirma que implementaciones aproximadas arbitrarias coincidan.
Song, Meng y Ermon construyen procesos de muestreo implícitos que comparten un objetivo de entrenamiento por difusión. Su trabajo hace visible una separación crucial: cambiar la trayectoria de muestreo no requiere necesariamente cambiar el objetivo de entrenamiento. Para esta revisión, la consecuencia es metodológica. Una comparación debe indicar tanto qué se aprendió como cómo se produjeron las muestras. El rendimiento comunicado en estos artículos no se incorpora a las figuras siguientes, que son nuevas construcciones algebraicas y no reproducciones de sus experimentos con imágenes. [1], [2], [3]
3. Un factor de conversión ya es un amplificador del error
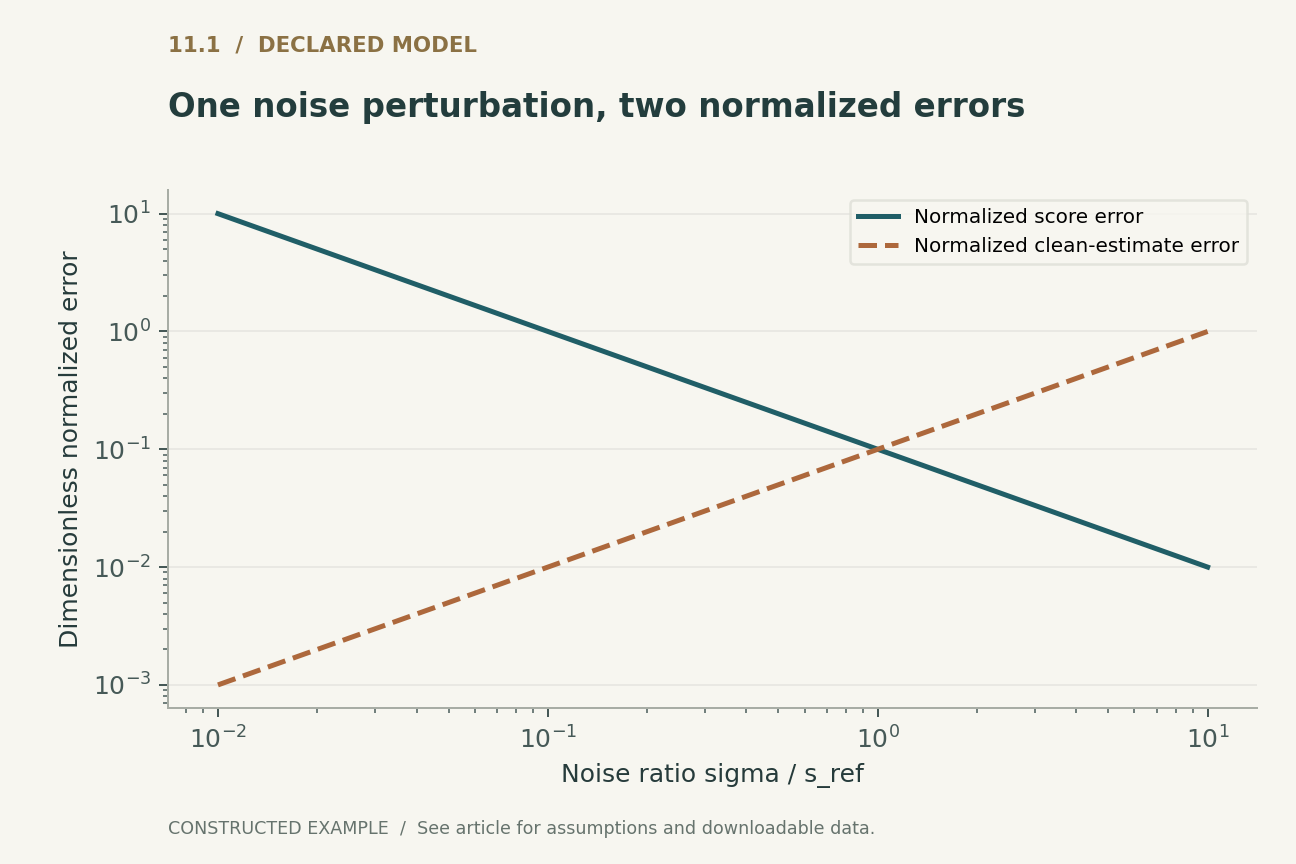
Considérese la corrupción gaussiana aditiva Y = X + sigma por epsilon, con epsilon normal estándar y sigma estrictamente positiva. La media condicional del ruido y el score marginal satisfacen una relación sencilla: el ruido predicho es menos sigma por el score. Si un predictor tiene un error aditivo de ruido delta, el error correspondiente del score es menos delta dividido por sigma. Su magnitud aumenta a medida que sigma disminuye. Esa misma conversión no significa que la estimación de la muestra limpia se vuelva arbitrariamente inexacta: la estimación sin ruido utiliza sigma al cuadrado por el score, por lo que el error inducido en la estimación limpia es menos sigma por delta.
La figura 1 mantiene el error adimensional de predicción de ruido delta en 0.1 y varía la razón de ruido sigma/s_ref. Para comparar con rigor cantidades con unidades físicas distintas, se elige una escala de referencia fija s_ref igual a una unidad de datos: se representa s_ref por el valor absoluto del error del score y el valor absoluto del error de la estimación limpia dividido por s_ref. Ambas cantidades representadas son adimensionales. Una aumenta mientras la otra disminuye, aunque ambas describen la misma perturbación artificial. Estos valores normalizados no son métricas de calidad intercambiables; su convención de escala se declara explícitamente. Esta construcción supone un error absoluto fijo de predicción de ruido, no una propiedad empírica de las redes entrenadas.
4. Los scores marginales difieren de los objetivos de corrupción realizados
Un ejemplo de entrenamiento incluye una realización de un vector de ruido gaussiano. El mejor predictor bajo error cuadrático, condicionado únicamente a la observación ruidosa y al tiempo, es la esperanza condicional de ese vector, no su valor realizado desconocido. Por consiguiente, la pérdida residual de entrenamiento contiene tanto varianza condicional irreducible como error de aproximación. Comparar pérdidas brutas a distintas relaciones señal-ruido puede ocultar esa descomposición.
La distinción puede comprobarse en una dimensión sin una red neuronal. Si los datos limpios siguen una distribución normal estándar y la varianza de corrupción es sigma al cuadrado, la observación ruidosa tiene varianza uno más sigma al cuadrado. La esperanza condicional da un predictor de ruido proporcional a la observación, con coeficiente sigma dividido por uno más sigma al cuadrado. Al sustituir este coeficiente en la conversión al score, se recupera menos la observación dividida por su varianza marginal. Este cálculo explica por qué el objetivo de eliminación de ruido es útil pese a las etiquetas ruidosas. También identifica qué debe restar una comparación con un oráculo: el riesgo condicional de predicción, no una pérdida de entrenamiento nula.
5. Un muestreador inverso con un sesgo conocido y persistente
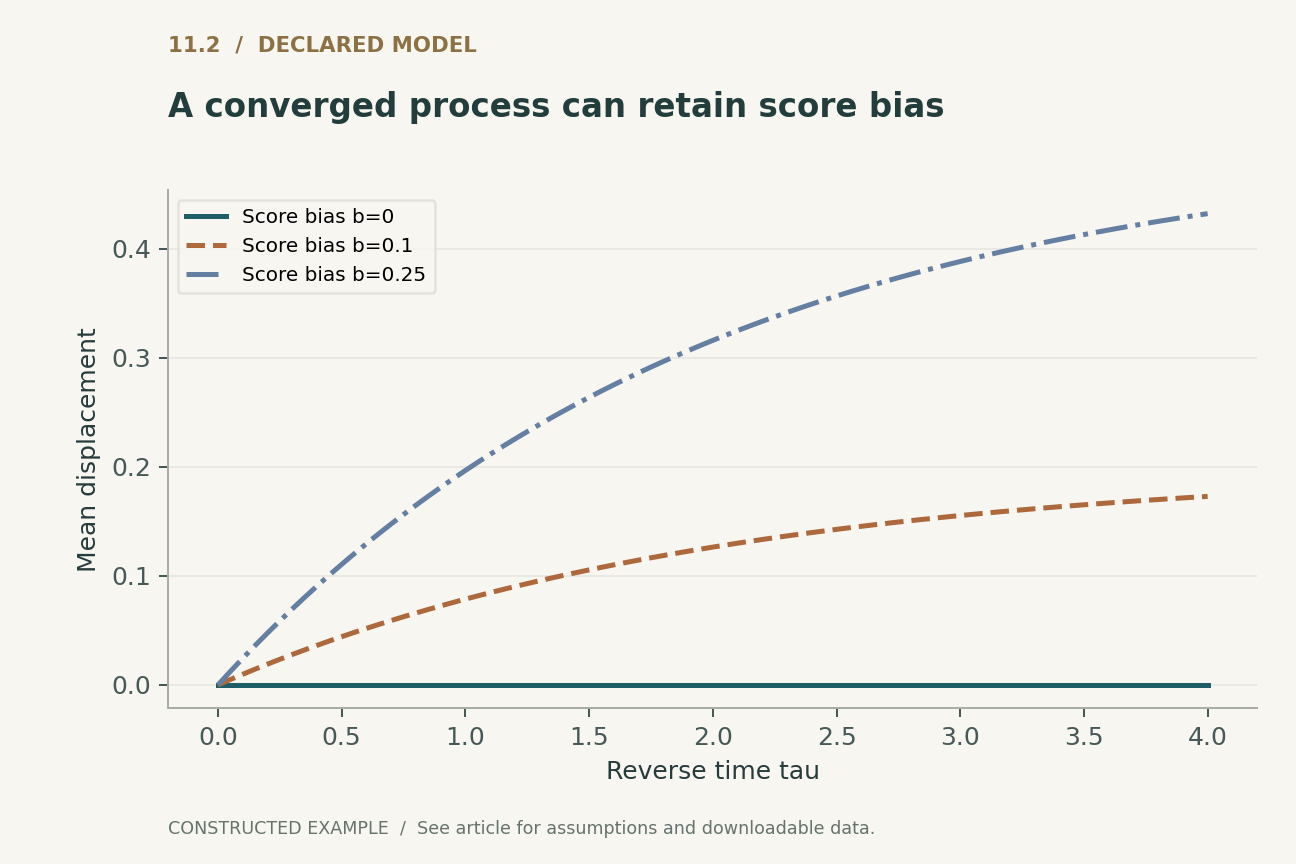
Considérese el proceso directo estacionario de Ornstein-Uhlenbeck con deriva igual a menos la mitad del estado y coeficiente de difusión unitario. Su densidad marginal sigue siendo normal estándar. Se parametriza el muestreo inverso mediante un reloj inverso creciente tau. Con el score exacto, la deriva inversa vuelve a ser menos la mitad del estado. Se sustituye el score por el score exacto más una constante b. La deriva inversa pasa a ser menos la mitad del estado más b.
Partiendo de una muestra normal estándar, el proceso inverso conserva varianza unitaria en tiempo continuo, mientras que su media pasa a ser dos veces b por uno menos la exponencial de menos tau dividido por dos. La figura 2 representa esta media para tres sesgos declarados del score. El error es una propiedad del campo aprendido, no un artefacto de integración. Un integrador puede converger perfectamente a la media equivocada. Este es un contraejemplo a la inferencia de que la convergencia numérica por sí sola establece la corrección estadística; no es un modelo de realismo para imágenes naturales.
6. Hay que aislar el error de discretización del error del campo aprendido
La discretización de Euler del proceso inverso anterior multiplica la media por uno menos la mitad del tamaño de paso y añade el tamaño de paso por b en cada paso. Esta recurrencia tiene una solución cerrada, lo que permite comparar una implementación numérica con el proceso sesgado exacto. Refinar el tamaño de paso reduce el error de discretización y mantiene el sesgo no nulo en tiempo continuo. Por tanto, una prueba que compare solo dos mallas finas puede superarse aunque la distribución generada no alcance su objetivo.
Las comprobaciones ejecutables adjuntas calculan ambos límites por separado. También examinan la recurrencia de la varianza, porque la inyección de ruido y la contracción de la deriva de Euler no conservan exactamente la varianza unitaria con un paso finito. Estas comprobaciones se limitan deliberadamente a determinados números de pasos y sesgos. Establecen que el código proporcionado sigue las ecuaciones declaradas; no certifican un muestreador de imágenes aprendido. La enseñanza experimental más general es incluir un control con score de oráculo cuando se dispone de una distribución objetivo tratable.
7. La ponderación temporal cambia la pregunta científica
Una única integral escalar del error del score depende de la distribución de muestreo temporal y de cualquier ponderación explícita. Concentrar el peso del entrenamiento o de la evaluación cerca de un extremo de la trayectoria puede mejorar ese escalar y dejar otra región débilmente restringida. El muestreador también puede visitar estados cuya distribución difiera de la distribución de corrupción directa utilizada durante el entrenamiento. Por tanto, hay dos cambios que deben seguirse: la ponderación temporal y el desajuste de la distribución de estados.
Un informe interpretable debe ofrecer perfiles de error por intervalos temporales declarados, especificando el sistema de coordenadas. El tiempo uniforme, la desviación estándar del ruido uniforme y el logaritmo de la relación señal-ruido uniforme son medidas distintas. Ninguna es automáticamente la única elección correcta. Una ponderación se justifica por el objetivo que representa o por una relación comprobada empíricamente con el comportamiento deseado en el punto final. Las construcciones gaussianas no proporcionan esa relación para datos complejos; simplemente impiden que las unidades y los pesos desaparezcan dentro de un único promedio atractivo.
8. El control condicional añade otro campo
El condicionamiento y la guía modifican el campo de muestreo. Incluso cuando una modificación de este tipo mejora un atributo deseado, cambia el objeto matemático analizado. Una medición del error del score incondicional no puede validar por sí sola la trayectoria guiada. El campo añadido puede amplificar las derivadas locales, concentrar trayectorias en regiones escasamente representadas durante el entrenamiento o alterar el equilibrio entre cobertura y concentración.
Para un estudio controlado, se debe mantener fijo el predictor base y variar la intensidad del condicionamiento y el presupuesto del integrador. Deben registrarse la ecuación exacta de guía y si los gradientes se recortan o reescalan. Deben evaluarse estadísticas del punto final que permitan detectar tanto modos omitidos como variación no deseada, en vez de seleccionar solo ejemplos que satisfagan visiblemente la instrucción. En un diagnóstico gaussiano, un término de guía constante es simplemente otro sesgo de deriva, de modo que su efecto puede calcularse exactamente. En un modelo de imágenes, el mismo álgebra constituye una advertencia local, no una predicción de que toda guía se comporte como un desplazamiento de la media.
9. Qué constituiría un resultado empírico convincente
Un estudio convincente separaría tres afirmaciones. Primero, que el predictor aproxima su objetivo declarado bajo una distribución declarada de entradas ruidosas. Segundo, que el integrador aproxima el proceso continuo o discreto elegido con un presupuesto computacional especificado. Tercero, que las muestras satisfacen criterios específicos de la aplicación bajo un diseño de evaluación que tiene en cuenta la variabilidad. La evidencia de una afirmación no debe sustituir a la de otra.
En los experimentos con imágenes, el plan de evaluación debe especificar los datos reservados, los números de muestras, el preprocesamiento, las semillas aleatorias, los puntos de control del modelo y los cálculos de incertidumbre antes de comparar variantes. El coste computacional debe incluir cada evaluación del score, paso de corrección y llamada de condicionamiento. Una ablación útil fija el modelo entrenado y cambia únicamente el muestreador; una ablación complementaria fija el muestreador y cambia únicamente el objetivo de entrenamiento. Este artículo propone ese diseño, pero no lo ejecuta. Las comprobaciones finitas proporcionadas operan sobre momentos gaussianos y no pueden sustentar una nueva clasificación de calidad de imagen.
10. El valor práctico de un modelo resoluble
Un pequeño ejemplo analítico es valioso cuando hace observable una ambigüedad que de otro modo permanecería oculta. Aquí muestra que errores de ruido idénticos pueden implicar tendencias opuestas en los errores del score y de la estimación limpia, y que un método numérico convergente puede conservar el sesgo del modelo. Ninguna observación requiere afirmar que los datos gaussianos aproximan la semántica de una fotografía.
El uso adecuado del código complementario es como plantilla de diagnóstico. Se sustituye una afirmación de éxito integral de caja negra por cantidades intermedias cuyas respuestas pueden calcularse de manera independiente. Después se añade complejidad manteniendo un registro de los supuestos eliminados. Si un muestreador aprendido falla en una distribución tratable, ese fallo permite actuar; si supera la prueba, el resultado es una comprobación de coherencia limitada. Una evaluación fiable de la difusión requiere, en última instancia, ambos tipos de evidencia: control matemático sobre mecanismos simplificados y examen empírico de la distribución objetivo real. Ambos resultan más útiles cuando sus límites permanecen explícitos.
Ejecutado localmente · Alcance acotado
Identidad de ruido a score y recurrencias exactas de media y varianza de OU con sesgo
Solo campos gaussianos escalares y las discretizaciones de Euler enumeradas; no se prueba ningún predictor aprendido ni muestreador de imágenes.
Se superaron 117 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testimonio registrado
{
  "T": 2,
  "step_counts": [
    4,
    8,
    16,
    32,
    64,
    128
  ],
  "biases": [
    0,
    0.1,
    0.25,
    -0.2
  ],
  "limiting_mean_b025": 0.31606027941427883,
  "refinement": [
    {
      "b": 0.0,
      "mean_error_at_N128": 0.0
    },
    {
      "b": 0.1,
      "mean_error_at_N128": 0.00028834504988073384
    },
    {
      "b": 0.25,
      "mean_error_at_N128": 0.0007208626247024452
    },
    {
      "b": -0.2,
      "mean_error_at_N128": 0.0005766900997614677
    }
  ]
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Corrupción gaussiana aditiva e isótropa, sigma > 0, con densidad marginal diferenciable. La igualdad implica la media condicional del ruido, no el ruido realizado de una muestra.
(2) Se mantiene fija una perturbación aditiva adimensional delta de la predicción de ruido. La estimación limpia es y + sigma al cuadrado por el score estimado. El error bruto del score tiene unidades inversas a las de los datos y el error bruto de la estimación limpia tiene unidades de datos. La figura 1 utiliza las cantidades adimensionales s_ref*abs(error del score) y abs(error de la estimación limpia)/s_ref, con s_ref fijo = una unidad de datos y delta = 0.1.
(3) Diagnóstico gaussiano estacionario con reloj inverso, un sesgo aditivo b del score y media inicial nula. El coeficiente de difusión es uno; la varianza en tiempo continuo permanece en uno.
(4) Media de Euler tras N pasos iguales en [0,T]. Estas fórmulas aíslan el error de discretización del sesgo no nulo del proceso límite; no son cotas de calidad de imagen.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Cantidad | Referencia necesaria | Fallo oculto por una única puntuación del punto final |
|---|---|---|
| Predictor de ruido | Esperanza condicional del ruido | Varianza irreducible del objetivo |
| Campo de score | Gradiente del logaritmo de la densidad ruidosa | Conversión de unidades dependiente del ruido |
| Muestreador | Proceso sesgado o exacto especificado | Convergencia a una distribución equivocada |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de rendimiento de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Especificar un objetivo tratable y calcular de manera independiente sus densidades ruidosas y sus scores de oráculo.
- Evaluar los errores de ruido, score y estimación sin ruido sobre la misma malla temporal y distribución de estados declaradas.
- Introducir errores conocidos del predictor, aditivos y dependientes de la escala, registrando sus unidades y parametrización.
- Comparar los momentos numéricos con los momentos exactos del proceso sesgado mientras se incrementa el número de pasos.
- Para un estudio independiente con datos reales, fijar los puntos de control e informar de los números de muestras, semillas, incertidumbre y todas las evaluaciones del modelo.
- Archivar las ecuaciones, el planificador, la precisión, la regla de condicionamiento, el código y los fallos; informar de las comprobaciones gaussianas por separado de la calidad empírica de las muestras.
Qué establecen las fuentes primarias
Jonathan Ho, Ajay Jain, Pieter Abbeel · 2020 [1]
Contribución. Una construcción de corrupción gaussiana y transiciones inversas sustenta el entrenamiento generativo basado en la eliminación de ruido.
Límite. Sus experimentos con imágenes publicados no se reproducen aquí; este artículo utiliza diagnósticos gaussianos independientes.
Localización en la fuente. Secciones 2 y 3, en especial las marginales directas y el objetivo simplificado.
Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma et al. · 2020 [2]
Contribución. Un marco de SDE basado en scores incluye muestreo inverso y una ODE de flujo de probabilidad.
Límite. La igualdad de las marginales exactas no es la igualdad de integradores aproximados arbitrarios.
Localización en la fuente. Secciones 3.2 y 4.3; derivación del flujo de probabilidad en el apéndice D.
Jiaming Song, Chenlin Meng, Stefano Ermon · 2020 [3]
Contribución. Los muestreadores implícitos pueden compartir un objetivo de entrenamiento por difusión y cambiar a la vez la dinámica de muestreo.
Límite. La velocidad y la calidad del muestreo siguen siendo empíricas y dependientes de la configuración.
Localización en la fuente. Resumen y secciones 3–4; registro de arXiv v4.
Límites de este análisis
- Los ejemplos son construcciones gaussianas unidimensionales; su geometría no modeliza la calidad semántica de las imágenes.
- La perturbación aditiva del score es deliberadamente simple y no tiene por qué parecerse a los errores aprendidos dependientes del estado.
- Las aserciones numéricas finitas validan los ejemplos declarados, no teoremas generales de convergencia ni implementaciones de redes neuronales.
- Solo se revisan tres fuentes fundacionales; los muestreadores y objetivos de entrenamiento más recientes quedan fuera de este análisis focalizado.
Una revisión analítica focalizada de tres fuentes primarias fundacionales seleccionadas, con ejemplos originales desarrollados. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso a las fuentes y de versión se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué errores del predictor desglosados por tiempo predicen mejor los fallos bajo la distribución real de muestreo?
- ¿Cómo deben responder las tolerancias del integrador a la incertidumbre local del campo aprendido, en lugar de únicamente al error numérico?
- ¿Puede una batería de evaluación revelar la pérdida de modos y los fallos de condicionamiento manteniendo controles de oráculo tratables?
Referencias
- Jonathan Ho, Ajay Jain, Pieter Abbeel. Denoising Diffusion Probabilistic Models. arXiv preprint (2020). 10.48550/arXiv.2006.11239.
- Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma et al.. Score-Based Generative Modeling through Stochastic Differential Equations. arXiv preprint (2020). 10.48550/arXiv.2011.13456.
- Jiaming Song, Chenlin Meng, Stefano Ermon. Denoising Diffusion Implicit Models. arXiv preprint (2020). 10.48550/arXiv.2010.02502.
Acceso a la fuente [1]. Metadatos primarios, resumen y textos metodológicos accesibles seleccionados; sin auditoría exhaustiva del material suplementario.
Nota de versión. v2, revisada el 16 de diciembre de 2020.
Acceso a la fuente [2]. Metadatos primarios, resumen y textos metodológicos accesibles seleccionados; sin auditoría exhaustiva del material suplementario.
Nota de versión. Prepublicación inicial 2020; v2 revisada el 10 de febrero de 2021; el registro indica ICLR 2021.
Acceso a la fuente [3]. Metadatos primarios, resumen y textos metodológicos accesibles seleccionados; sin auditoría exhaustiva del material suplementario.
Nota de versión. Prepublicación inicial 2020; v4 revisada el 5 de octubre de 2022; el registro indica ICLR 2021.
Las identidades bibliográficas se contrastaron con los registros primarios de editoriales y autores. Las notas siguientes de acceso a las fuentes y de versión describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni pruebas de rendimiento reproducidas.
Este borrador local no tiene registro de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos expuestos; no constituyen una verificación formal de los sistemas citados.