
Resumen
Las redes neuronales de grafos deben intercambiar información sin borrar las distinciones que requiere una tarea. Esta revisión analítica separa el sobresuavizado, los campos receptivos limitados y la sobrecompresión mediante tres referencias primarias: las redes convolucionales de grafos, un análisis asintótico condicional de las GCN profundas y la perspectiva de los cuellos de botella en el paso de mensajes de largo alcance. Dos construcciones exactas concretan esta distinción. Un proceso de promediado entre dos nodos presenta un decaimiento del contraste en forma cerrada, controlado por su valor propio no trivial. Un árbol regular de agregación atenúa la contribución de cada hoja mediante promedios repetidos y hace indistinguibles en su raíz distintas configuraciones de hojas. El artículo analiza la mezcla residual, la reinyección de características, la reconexión del grafo y la normalización como intervenciones con consecuencias diferentes. Propone evaluaciones en las que el radio de la tarea y la estructura del grafo se varían de forma controlada. Las gráficas y las comprobaciones ejecutables se refieren a modelos lineales finitos; no son nuevos resultados de referencia ni teoremas universales de imposibilidad para redes de grafos no lineales.
1. Tres razones por las que una red de grafos más profunda puede fallar
Un nodo puede no utilizar evidencia distante porque un número insuficiente de capas hace que esa evidencia sea inalcanzable. Puede fallar porque la mezcla repetida vuelve demasiado similares las representaciones de los nodos relevantes. También puede fallar porque muchas fuentes distintas deben atravesar un canal estrecho de agregación. Estos mecanismos pueden coexistir, pero sus remedios difieren.
Añadir capas amplía el campo receptivo del paso de mensajes local ordinario, aunque puede intensificar la mezcla o la compresión. Añadir aristas puede acortar las rutas e introducir, a la vez, nuevas relaciones de mezcla. Aumentar la anchura oculta puede ayudar a representar múltiples mensajes, pero no modifica automáticamente la regla de agregación. Por tanto, un diagnóstico riguroso comienza por la tarea: ¿qué nodos contienen la evidencia necesaria, qué relación entre ellos determina la etiqueta y dónde debe producirse la respuesta? Sin esa especificación, observar una menor exactitud a mayor profundidad no identifica una causa. Los ejemplos siguientes aíslan mecanismos en lugar de tratar todos los fallos relacionados con la profundidad como un mismo fenómeno.
2. La propagación de las GCN como referencia
Kipf y Welling introducen un enfoque convolucional sobre grafos para la clasificación semisupervisada de nodos, utilizando una matriz de adyacencia normalizada con bucles propios, transformaciones de características aprendidas y no linealidades. Su arquitectura proporciona un operador concreto de propagación cuya aplicación repetida puede analizarse.
El proceso de dos nodos utilizado en este artículo elimina deliberadamente los pesos aprendidos y las no linealidades para que la mezcla pueda resolverse exactamente. No es la GCN completa, y sus tasas de decaimiento no deben presentarse como predicciones para cualquier arquitectura entrenada. La fuente establece una familia útil de modelos y la evalúa en conjuntos de datos específicos; el cálculo finito presentado aquí aborda una pregunta más acotada sobre el efecto informativo del promediado repetido. Mantener visible esta distinción evita convertir una intuición lineal en un teorema incondicional sobre redes neuronales. [1]
3. Un resultado asintótico condicional
Oono y Suzuki analizan las redes de grafos profundas desde la perspectiva de los sistemas dinámicos. Su resultado describe la convergencia hacia un conjunto restringido de señales bajo condiciones que involucran los espectros de los grafos y las normas de los pesos. En el contexto de las GCN, la información límite puede vincularse con las componentes conexas y los grados de los nodos.
Las condiciones son fundamentales. La fuente no establece que toda arquitectura de grafos no lineal pierda información útil al mismo ritmo, ni que todos los fallos a profundidad finita se deriven de su resultado asintótico. Esta revisión utiliza el artículo para motivar diagnósticos espectrales, al tiempo que deriva su propio ejemplo elemental de dos nodos. Una evaluación práctica debe medir los operadores entrenados y el régimen de profundidad antes de aplicar una explicación asintótica al rendimiento observado. [2]
4. Los cuellos de botella no son lo mismo que el suavizado
Alon y Yahav investigan la dificultad de propagar información de largo alcance a través de cuellos de botella en redes de grafos y plantean el problema como sobrecompresión. Su fuente destaca que los mensajes procedentes de vecindarios crecientes pueden comprimirse en representaciones de tamaño fijo, perjudicando las tareas que requieren interacciones distantes.
El ejemplo del árbol de agregación que sigue aísla la atenuación y las colisiones bajo un operador de promedio especificado. No demuestra que toda representación de dimensión fija y valores reales tenga un límite absoluto de información: la aritmética real sin restricciones puede codificar distinciones de maneras numéricamente poco realistas. Las afirmaciones sobre la capacidad general requieren supuestos de precisión, robustez o clase de funciones. La fuente motiva el examen del cuello de botella de comunicación; este artículo mantiene sus comprobaciones finitas ligadas al agregador implementado explícitamente, en lugar de afirmar una imposibilidad independiente de la arquitectura. [3]
5. Dos nodos bastan para revelar la contracción espectral
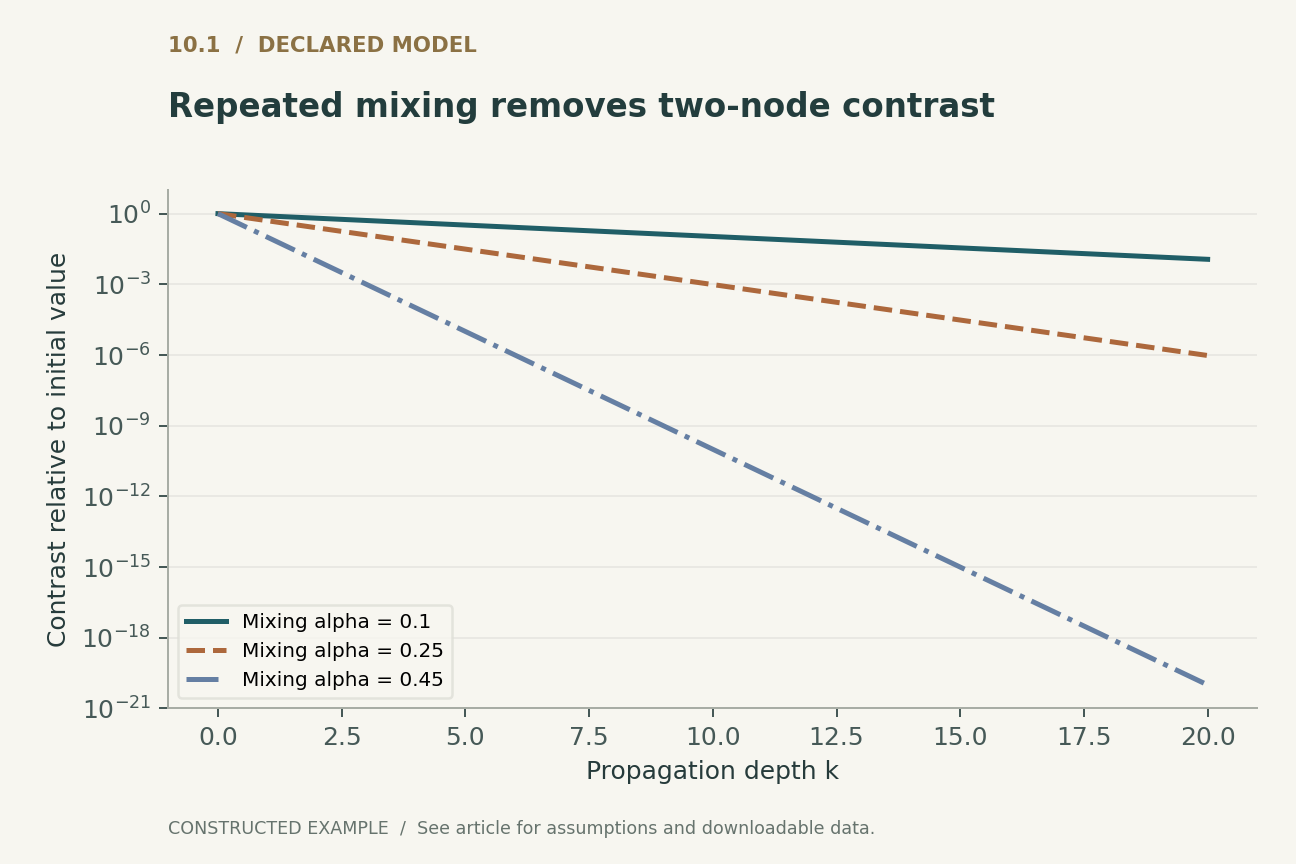
Considérense dos nodos cuyos valores escalares se mezclan mediante una matriz estocástica simétrica cuya entrada fuera de la diagonal es alfa. Cada valor nuevo conserva una fracción uno menos alfa de sí mismo y recibe una fracción alfa del otro nodo. El promedio permanece constante. La diferencia entre los nodos se multiplica por uno menos dos veces alfa en cada capa.
Para alfa entre cero y un medio, el contraste decae, por tanto, de forma monótona y sin cambios de signo. El panel 1 compara tres intensidades de mezcla a lo largo de veinte pasos. Cuando alfa es igual a un cuarto, un contraste de uno pasa a ser un medio después de un paso y un cuarto después de dos. Cuando alfa es igual a un medio, los dos valores se vuelven idénticos inmediatamente. Estas afirmaciones exactas se derivan de los dos vectores propios: el vector constante tiene valor propio uno, y el vector de contraste tiene valor propio uno menos dos veces alfa. El material complementario comprueba tanto la forma cerrada como la conservación de la media mediante multiplicación matricial directa.
6. La similitud no es automáticamente un defecto
Si la salida deseada es un promedio global, la contracción hacia una representación constante resulta útil. Si la salida deseada distingue los valores iniciales de los nodos, esa misma contracción elimina la señal. El comportamiento del operador no puede evaluarse independientemente del objetivo.
Además, la matriz de adyacencia con normalización simétrica de un grafo irregular no tiene por qué converger hacia coordenadas brutas idénticas. Su vector dominante puede depender del grado, por lo que la igualdad ingenua por pares no es la única medida relevante. Un análisis espectral debe especificar el subespacio invariante y la normalización utilizada antes de interpretar la similitud de características. Las no linealidades, los mapas de características aprendidos y las componentes desconectadas añaden otras distinciones. El ejemplo de dos nodos es regular y lineal precisamente para hacer transparentes sus afirmaciones. Un diagnóstico empírico de sobresuavizado debe comparar la información de la tarea que se conserva con la distancia al subespacio de baja dimensión apropiado, en lugar de basarse únicamente en un promedio genérico de similitud coseno cuyo significado puede variar con la escala de las características y la normalización.
7. La mezcla residual ralentiza un proceso sin detenerlo necesariamente
Sustitúyase una matriz de propagación P por una mezcla de P y la identidad. En el ejemplo de dos nodos, esto reemplaza alfa por una intensidad efectiva de mezcla menor. El valor propio no trivial se acerca a uno, de modo que el contraste decae más lentamente. A menos que la mezcla efectiva sea exactamente cero o que otro mecanismo preserve la señal, la aplicación repetida sigue llevando ese contraste hacia cero en el límite de profundidad infinita.
Este cálculo sencillo distingue entre ralentizar la contracción y eliminar su causa. Una ruta residual puede ser valiosa a las profundidades finitas que realmente se utilizan, por lo que un límite asintótico por sí solo no constituye un veredicto sobre la utilidad práctica. La evaluación pertinente debe comunicar conjuntamente la profundidad, la intensidad efectiva de mezcla y una métrica de la tarea. También debe distinguir una conexión residual con la capa anterior de una conexión explícita con las características originales. Estas intervenciones tienen puntos fijos diferentes. Tratarlas como conexiones de salto intercambiables puede ocultar por qué un modelo conserva las distinciones iniciales mientras que otro solo pospone su atenuación.
8. La reinyección cambia el punto fijo
Considérese una recurrencia que combina las características actuales propagadas con una fracción fija beta de las características originales en cada capa. En la dirección de contraste de los dos nodos, la ganancia estacionaria respecto al contraste inicial es beta dividida por uno menos el producto de uno menos beta y el valor propio original del contraste. Para beta positiva y un valor propio de propagación contractivo, esta ganancia es distinta de cero.
El material complementario verifica numéricamente el punto fijo en un caso declarado y lo compara con la forma cerrada. Esto no establece que una reinyección arbitraria de características mejore la clasificación. Las características originales pueden contener ruido o identificadores irrelevantes, y conservarlas puede oponerse a la agregación deseada. Sí establece un mecanismo: la recurrencia aporta repetidamente una señal externa, por lo que su comportamiento límite difiere del suavizado autónomo. Una comparación experimental debe variar tanto la calidad de la señal como la intensidad de reinyección. De lo contrario, un beneficio obtenido con características iniciales informativas podría generalizarse a contextos en los que la representación inicial es precisamente la parte que necesita una corrección sustancial.
9. Un árbol revela un cuello de botella de agregación
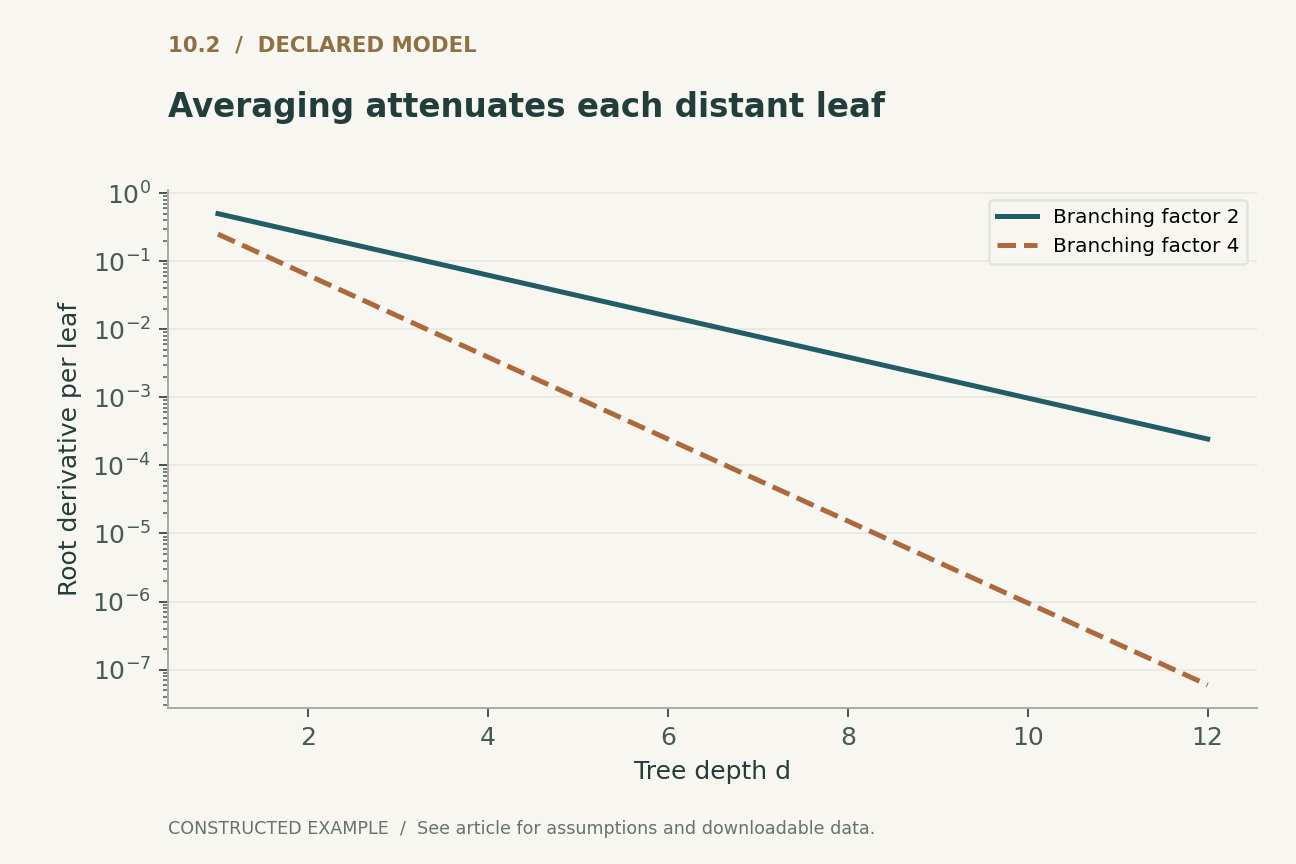
Considérese ahora un árbol regular con raíz, factor de ramificación b y profundidad d. Cada nodo interno produce la media aritmética de sus hijos. La raíz es el promedio de los b elevados a d valores de las hojas, y su derivada respecto a cualquier hoja individual es b elevado a menos d. El panel 2 representa esa derivada para árboles binarios y de ramificación cuádruple.
Esta atenuación es exacta para el operador declarado. Distintas asignaciones a las hojas con la misma media también producen el mismo estado en la raíz: mover un único uno entre dos hojas cambia un objetivo que pregunta por una hoja concreta, pero no la media de la raíz. El material complementario enumera todas las asignaciones binarias a ocho hojas y registra estas colisiones. El ejemplo no requiere que las representaciones de los nodos se vuelvan similares a lo largo de una capa. Muestra que la agregación puede perder una distinción relevante para la tarea incluso cuando no es aplicable la imagen habitual de todos los nodos convergiendo a una misma representación. Por ello, los diagnósticos de suavizado y de cuellos de botella deben comunicarse por separado.
10. La reconexión modifica tanto las rutas como la evidencia
Añadir una arista puede reducir el número de pasos de agregación necesarios para que dos nodos se comuniquen. También puede modificar el tamaño del vecindario, la normalización, el coste computacional y el significado del grafo. Una explicación causal del beneficio de la reconexión debe examinar estos cambios en lugar de atribuir toda la mejora a la longitud de las rutas.
Si el grafo registra una relación física o semántica, una arista nueva constituye una intervención explícita de modelado. Deben documentarse sus atributos e interpretación. Si el grafo es solo una estructura auxiliar de cálculo, la reconexión puede ser más flexible, pero sigue modificando la clase de funciones. Un diagnóstico útil compara presupuestos de aristas equiparados e incluye controles que acorten las rutas sin acceder a las etiquetas de prueba. Evaluar únicamente la exactitud final puede ocultar si el método aprovechó información no disponible durante la inferencia. La atención o los tokens globales también proporcionan rutas alternativas de comunicación, pero deben contabilizarse sus costes de tiempo de ejecución y capacidad. Ninguna intervención es gratuita por el mero hecho de describirse como la eliminación de un cuello de botella.
11. Una evaluación condicionada por la tarea
La evaluación propuesta varía independientemente el radio de la tarea, la expansión del grafo y la ubicación de la evidencia relevante. Una familia sintética puede solicitar un valor local, otra un promedio global y otra una relación entre hojas distantes. La misma regla de propagación debería tener éxito o fallar por razones diferentes en estas tareas, lo que haría interpretables los diagnósticos.
Para cada modelo, deben comunicarse la alcanzabilidad dentro del campo receptivo, la distancia al subespacio de suavizado apropiado, la sensibilidad a características distantes y el riesgo de la tarea. La sensibilidad por sí sola no basta: un modelo puede amplificar entradas irrelevantes e ignorar la relación requerida. Los grafos de entrenamiento y prueba deben separarse según la pregunta de generalización prevista, como nuevos nodos, nuevos grafos o nuevos tamaños de grafo. La selección de hiperparámetros no debe utilizar las etiquetas del grafo de prueba. Las comprobaciones suministradas solo establecen identidades de operadores finitos y ejemplos de atenuación y colisión. No miden el rendimiento real de redes entrenadas, y la evaluación más amplia propuesta sigue siendo trabajo futuro, no un experimento que se afirme haber realizado.
12. Diagnosticar el obstáculo antes de elegir la profundidad
La profundidad es útil cuando el cálculo y la comunicación adicionales preservan la información requerida por la tarea. Se vuelve perjudicial cuando las operaciones repetidas borran, ocultan o comprimen esa información más rápidamente de lo que la tarea se beneficia de un campo receptivo mayor. Estas posibilidades dependen del grafo, la regla de propagación, la calidad de las características y la decisión.
Las dos construcciones proporcionan un vocabulario diagnóstico compacto. La contracción espectral explica cómo decae un contraste concreto. La agregación por media en un árbol explica cómo se atenúan las contribuciones distantes y cómo configuraciones distintas se vuelven indistinguibles en la raíz. La mezcla residual y la reinyección muestran después que cambios arquitectónicos aparentemente similares pueden tener comportamientos límite diferentes. Una afirmación de investigación defendible identifica qué obstáculo se midió y qué intervención lo modificó. Esto es más informativo que declarar que las redes de grafos son intrínsecamente poco profundas o que una conexión de salto resuelve el problema de la profundidad. También orienta hacia mejores experimentos: variar conjuntamente la ruta de información y el objetivo, y verificar que el supuesto remedio preserve las distinciones que necesita la respuesta.
Ejecutado localmente · Alcance acotado
Decaimiento espectral de dos nodos, reinyección de características y enumeración exhaustiva de colisiones en árboles de promediado
Recurrencia lineal de dos nodos y las 256 asignaciones binarias a ocho hojas; sin teorema universal sobre GNN no lineales ni evaluación comparativa de entrenamiento.
Se superaron 394 aserciones. Estas comprobaciones validan el ejemplo suministrado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "reinjection_beta": 0.2,
  "contrast_eigenvalue": 0.8,
  "stationary_gain": 0.5555555555555556,
  "leaf_assignments": 256,
  "distinct_root_values": 9,
  "collision_a": [
    1,
    0,
    0,
    0,
    0,
    0,
    0,
    0
  ],
  "collision_b": [
    0,
    1,
    0,
    0,
    0,
    0,
    0,
    0
  ],
  "shared_root_value": 0.125
}
Ejecutor del ejemplo · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Propagación de tipo GCN; el modelo desarrollado de dos nodos elimina W aprendida y sigma no lineal, y utiliza una matriz estocástica declarada.
(2) El contraste c es la diferencia entre dos valores escalares de nodos; el panel 1 utiliza 0 < alpha < 1/2.
(3) Reinyección de características originales con beta fija > 0 y |(1-beta)lambda| < 1; c0 es distinta de cero para el cociente mostrado.
(4) Un árbol regular de profundidad d con ramificación b y agregación por media escalar en cada nodo interno; sin pesos aprendidos ni rutas alternativas.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Mecanismo | Diagnóstico | Intervención con un alcance diferenciado |
|---|---|---|
| Alcanzabilidad insuficiente | Fuente necesaria fuera del campo receptivo | Rutas o capas adicionales |
| Suavizado espectral | Decaimiento de componentes no estacionarias relevantes para la tarea | Modificar la propagación o preservar las características originales |
| Cuello de botella de la agregación por media | Sensibilidad atenuada y colisiones exactas | Cambiar el agregador, la capacidad o las rutas de comunicación |
| Fallo de optimización | El entrenamiento no ajusta un objetivo accesible | Investigar la dinámica del aprendizaje sin presuponer una causa ligada al grafo |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas en producción ni de hardware. Los modelos finitos ejecutados por separado están documentados en las comprobaciones ejecutables.
- Definir los nodos fuente relevantes, el radio de la tarea y la ubicación deseada de la salida.
- Verificar el decaimiento regido por el valor propio de dos nodos y la conservación de la media antes de extrapolar la intuición.
- Comparar la mezcla residual con la reinyección de características originales a partir de sus diferentes puntos fijos.
- Enumerar las colisiones del árbol de agregación y variar la ramificación por separado de la profundidad.
- Evaluar conjuntamente la alcanzabilidad, la distancia al subespacio de suavizado, la sensibilidad a características distantes y el riesgo de la tarea.
- Utilizar particiones de grafos y controles de reconexión que eviten la filtración de etiquetas de prueba, e informar de la incertidumbre entre ejecuciones.
Qué establecen las fuentes primarias
Thomas N. Kipf, Max Welling · 2017 [1]
Contribución. Las GCN utilizan propagación normalizada sobre grafos con mapas de características aprendidos para la clasificación semisupervisada.
Límite de alcance. El ejemplo lineal de dos nodos omite deliberadamente los pesos aprendidos y las no linealidades.
Ubicación en la fuente. Regla de propagación de la arquitectura.
Kenta Oono, Taiji Suzuki · 2020 [2]
Contribución. La convergencia de las GCN profundas se analiza bajo condiciones espectrales y de normas de los pesos.
Límite de alcance. No pueden omitirse las condiciones ni el régimen asintótico al interpretar el resultado.
Ubicación en la fuente. Resumen y análisis principal de convergencia.
Uri Alon, Eran Yahav · 2021 [3]
Contribución. El paso de mensajes de largo alcance puede sufrir cuellos de botella de agregación denominados sobrecompresión.
Límite de alcance. El ejemplo finito del árbol de promediado solo demuestra propiedades de su agregador declarado.
Ubicación en la fuente. Resumen y discusión del radio del problema y los cuellos de botella.
Límites de este análisis
- Los ejemplos finitos son modelos lineales o de media escalar, no descripciones universales de GNN entrenadas.
- Las afirmaciones de convergencia espectral requieren los supuestos indicados sobre el operador y los pesos.
- La dimensión fija por sí sola no implica una imposibilidad de teoría de la información sin restricciones numéricas o sobre la clase de funciones.
- No se presenta ninguna evaluación de referencia de grafos, entrenamiento neuronal ni replicación independiente de los sistemas citados.
Una revisión analítica centrada en tres fuentes primarias fundamentales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas de acceso y versión de las fuentes se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué mediciones condicionadas por la tarea separan de manera fiable el suavizado de la compresión en redes no lineales entrenadas?
- ¿Cómo debe la reconexión preservar el significado científico cuando las aristas del grafo codifican relaciones físicas?
- ¿Puede ajustarse la reinyección de características utilizando la calidad de la señal en lugar de una heurística independiente de la profundidad?
Referencias
- Thomas N. Kipf, Max Welling. Semi-Supervised Classification with Graph Convolutional Networks. International Conference on Learning Representations (2017). Primary source.
- Kenta Oono, Taiji Suzuki. Graph Neural Networks Exponentially Lose Expressive Power for Node Classification. International Conference on Learning Representations (2020). Primary source.
- Uri Alon, Eran Yahav. On the Bottleneck of Graph Neural Networks and its Practical Implications. International Conference on Learning Representations (2021). Primary source.
Acceso a la fuente [1]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Nota de versión. Artículo de ICLR 2017 consultado como arXiv v4, fechado el 22 de febrero de 2017; la primera prepublicación apareció en 2016.
Acceso a la fuente [2]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Nota de versión. Artículo de ICLR 2020 consultado como arXiv v5, fechado el 6 de enero de 2021; la primera prepublicación apareció en 2019.
Acceso a la fuente [3]. Se inspeccionaron el texto PDF del artículo primario y su página bibliográfica primaria.
Nota de versión. Artículo de ICLR 2021 consultado como arXiv v4, fechado el 9 de marzo de 2021; la primera prepublicación apareció en 2020.
Las identidades bibliográficas se contrastaron con los registros primarios de las editoriales y los autores. Las notas de acceso y versión que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Redactado y sometido a autorrevisión técnica por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, con Python y CSV suministrados. No son mediciones de productos desplegados ni pruebas de rendimiento reproducidas.
Este borrador local no cuenta con un registro de revisión independiente por pares ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos indicados; no constituyen una verificación formal de los sistemas citados.