
要旨
グラフニューラルネットワークは、タスクに必要な区別を消去することなく情報を交換しなければならない。本分析的レビューは、グラフ畳み込みネットワーク、深いGCNの条件付き漸近解析、および長距離メッセージパッシングをめぐるボトルネックの観点という三つの一次資料上の基盤を用いて、過平滑化、受容野の制限、過圧縮を区別する。二つの厳密な構成によって、この区別を具体化する。二ノードの平均化過程では、非自明な固有値に支配されるコントラスト減衰を閉形式で表せる。正則な集約木では、平均の反復によって各葉の寄与が減衰し、異なる葉の配置が根で同一視される。本稿は、残差混合、特徴の再注入、グラフの再配線、正規化を、それぞれ異なる帰結をもつ介入として分析する。また、タスク半径とグラフ構造を制御して変化させる評価を提案する。プロットと実行可能な検証が扱うのは有限規模の線形モデルであり、新たなベンチマーク結果でも、非線形グラフネットワークに関する普遍的な不可能性定理でもない。
1. より深いグラフネットワークが失敗しうる三つの理由
ノードが遠方の証拠を利用できない理由として、層が少なすぎるためにその証拠に到達できないことがある。混合の反復によって、関連するノード表現が過度に似通ってしまうこともある。また、多数の異なる情報源が狭い集約チャネルを通過しなければならないこともある。これらの機構は併存しうるが、その対処法は異なる。
層の追加は通常の局所メッセージパッシングの受容野を広げる一方、混合や圧縮を強める可能性がある。辺の追加は経路を短くする一方で、新たな混合関係を導入しうる。隠れ層の幅を広げることは複数のメッセージの表現に役立つ可能性があるが、集約規則を自動的に変えるわけではない。したがって、厳密な診断はタスクから始まる。必要な証拠はどのノードに存在し、それらのどの関係がラベルを決め、答えはどこで出力されなければならないのか。この指定がなければ、深さの増大とともに正解率が低下したという観測だけでは原因を特定できない。以下の例では、深さに関連するすべての失敗を同じ現象とみなすのではなく、機構を切り分ける。
2. 基準となるGCNの伝播
KipfとWellingは、自己ループを含む正規化隣接行列、学習される特徴変換、および非線形性を用いた、半教師ありノード分類のためのグラフ畳み込み手法を導入した。そのアーキテクチャは、反復適用を解析できる具体的な伝播作用素を与える。
本稿で用いる二ノード過程では、混合を厳密に解けるよう、学習される重みと非線形性を意図的に取り除いている。これは完全なGCNではなく、その減衰率をあらゆる学習済みアーキテクチャに対する予測として提示すべきではない。原資料は有用なモデル族を確立し、指定されたデータセットで評価している。一方、ここでの有限規模の計算は、平均化の反復が情報に及ぼす効果という、より限定された問いを扱う。この区別を明確に保つことで、線形な直観を無条件のニューラルネットワーク定理へと格上げすることを避けられる。 [1]
3. 条件付きの漸近的結果
OonoとSuzukiは、力学系の観点から深いグラフネットワークを解析している。その結果は、グラフのスペクトルと重みのノルムに関する条件の下で、制限された信号集合へ収束することを記述する。GCNの設定では、極限に残る情報を連結成分およびノードの次数と関連づけることができる。
条件は本質的である。この資料は、すべての非線形グラフアーキテクチャが同じ速度で有用な情報を失うことも、有限の深さでのすべての失敗がその漸近的結果から導かれることも示していない。本レビューは、この論文をスペクトル診断の動機づけとして用いつつ、独自の初等的な二ノード例を導出する。実践的な評価では、観測された性能に漸近的説明を適用する前に、学習済み作用素と深さの範囲を測定しなければならない。 [2]
4. ボトルネックと平滑化は同じではない
AlonとYahavは、グラフネットワークのボトルネックを通して長距離情報を伝播させる難しさを調べ、この問題を過圧縮として捉えている。その資料は、拡大する近傍からのメッセージが固定サイズの表現へ圧縮され、遠距離の相互作用を必要とするタスクに悪影響を及ぼしうることを強調する。
以下の集約木の例は、指定された平均作用素の下での減衰と衝突を切り分ける。これは、固定次元の実数値表現のすべてに絶対的な情報限界があることを証明するものではない。制約のない実数演算は、数値的には非現実的な方法で区別を符号化できるからである。一般的な容量に関する主張には、精度、頑健性、または関数クラスについての仮定が必要となる。原資料は通信ボトルネックを調べる動機を与える。本稿は、アーキテクチャに依存しない不可能性を主張するのではなく、有限規模の検証を明示的に実装した集約器に結びつけている。 [3]
5. 二つのノードだけでもスペクトル収縮は現れる
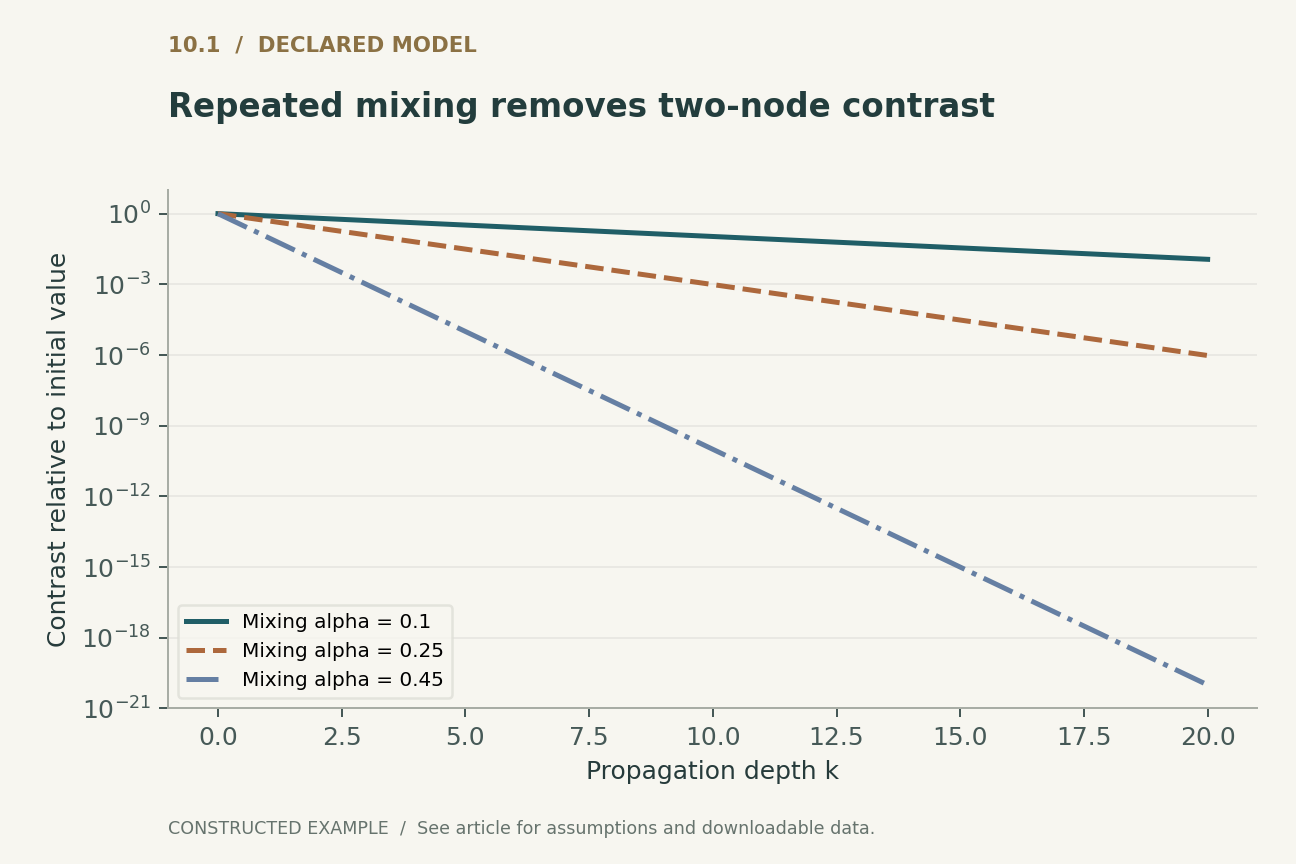
非対角成分がアルファである対称な確率行列によって、スカラー値を混合される二つのノードを考える。各々の新しい値は、自身の値を一からアルファを引いた割合だけ保持し、他方のノードの値をアルファの割合だけ受け取る。平均は一定に保たれる。ノード間の差には、各層で一からアルファの二倍を引いた値が掛けられる。
したがって、アルファが零と二分の一の間にあるとき、コントラストは符号を変えずに単調に減衰する。パネル1は、三つの混合強度を二十ステップにわたって比較する。アルファが四分の一のとき、一のコントラストは一ステップ後に二分の一、二ステップ後に四分の一となる。アルファが二分の一のとき、二つの値は直ちに等しくなる。これらの厳密な記述は、二つの固有ベクトルから導かれる。定数ベクトルの固有値は一であり、コントラストベクトルの固有値は一からアルファの二倍を引いた値である。付属資料では、直接の行列乗算によって、閉形式と平均の保存の双方を検証する。
6. 類似性が直ちに欠陥となるわけではない
望ましい出力が全体の平均であるならば、一定の表現への収縮は有用である。望ましい出力がノードの初期値を区別するものであれば、同じ収縮が信号を除去する。作用素の挙動は、目標から独立して評価することはできない。
さらに、不正則グラフ上の対称正規化隣接行列は、生の座標が同一となる状態へ収束するとは限らない。その支配的なベクトルは次数に依存しうるため、単純なペアごとの等しさだけが関連する尺度ではない。スペクトル解析では、特徴の類似性を解釈する前に、不変部分空間と用いる正規化を明示すべきである。非線形性、学習される特徴写像、非連結な成分によって、さらに区別すべき点が加わる。二ノード例が正則かつ線形であるのは、まさにその主張を明瞭にするためである。過平滑化の実証的診断では、特徴の尺度や正規化によって意味が変わりうる汎用的な平均コサイン類似度のみに依拠するのではなく、保持されたタスク情報と、適切な低次元部分空間からの距離とを比較すべきである。
7. 残差混合は過程を遅らせるが、必ずしも止めない
伝播行列Pを、Pと単位行列の混合に置き換える。二ノード例では、これによりアルファがより小さな実効混合強度に置き換わる。非自明な固有値は一に近づくため、コントラストはより緩やかに減衰する。実効的な混合が厳密に零であるか、別の機構が信号を保持するのでない限り、反復適用は無限深さの極限で依然としてそのコントラストを零へと向かわせる。
この単純な計算は、収縮を遅らせることと、その原因を取り除くこととを区別する。残差経路は、実際に用いられる有限の深さでは有用となりうるため、漸近極限だけで実用性を判定することはできない。適切な評価では、深さ、実効混合強度、タスク指標を併せて報告すべきである。また、前の層への残差接続と、元の特徴への明示的な接続を区別すべきである。これらの介入は異なる不動点をもつ。交換可能なスキップ接続として扱うと、あるモデルは初期の区別を保持し、別のモデルはその減衰を先送りするだけである理由が見えにくくなる。
8. 再注入は不動点を変える
各層で、伝播後の現在の特徴と、元の特徴の一定割合ベータとを組み合わせる漸化式を考える。二ノードのコントラスト方向では、初期コントラストに対する定常ゲインは、ベータを、一から「一からベータを引いた値」と元のコントラスト固有値との積を引いた値で割ったものとなる。ベータが正で、伝播の固有値が収縮的である場合、このゲインは非零である。
付属資料では、明示した場合について不動点を数値的に検証し、閉形式と比較する。これは、任意の特徴再注入が分類を改善することを示すものではない。元の特徴にはノイズや無関係な識別子が含まれうるため、それらを保持することが望ましい集約と相反する場合もある。ここで示されるのは機構である。漸化式は外部信号を繰り返し供給するため、その極限挙動は自律的な平滑化とは異なる。実験的な比較では、再注入強度だけでなく信号品質も変化させるべきである。そうしなければ、情報豊富な初期特徴で得られた利点を、初期表現こそ大幅な修正を必要とする設定へ一般化してしまう可能性がある。
9. 木が明らかにする集約のボトルネック
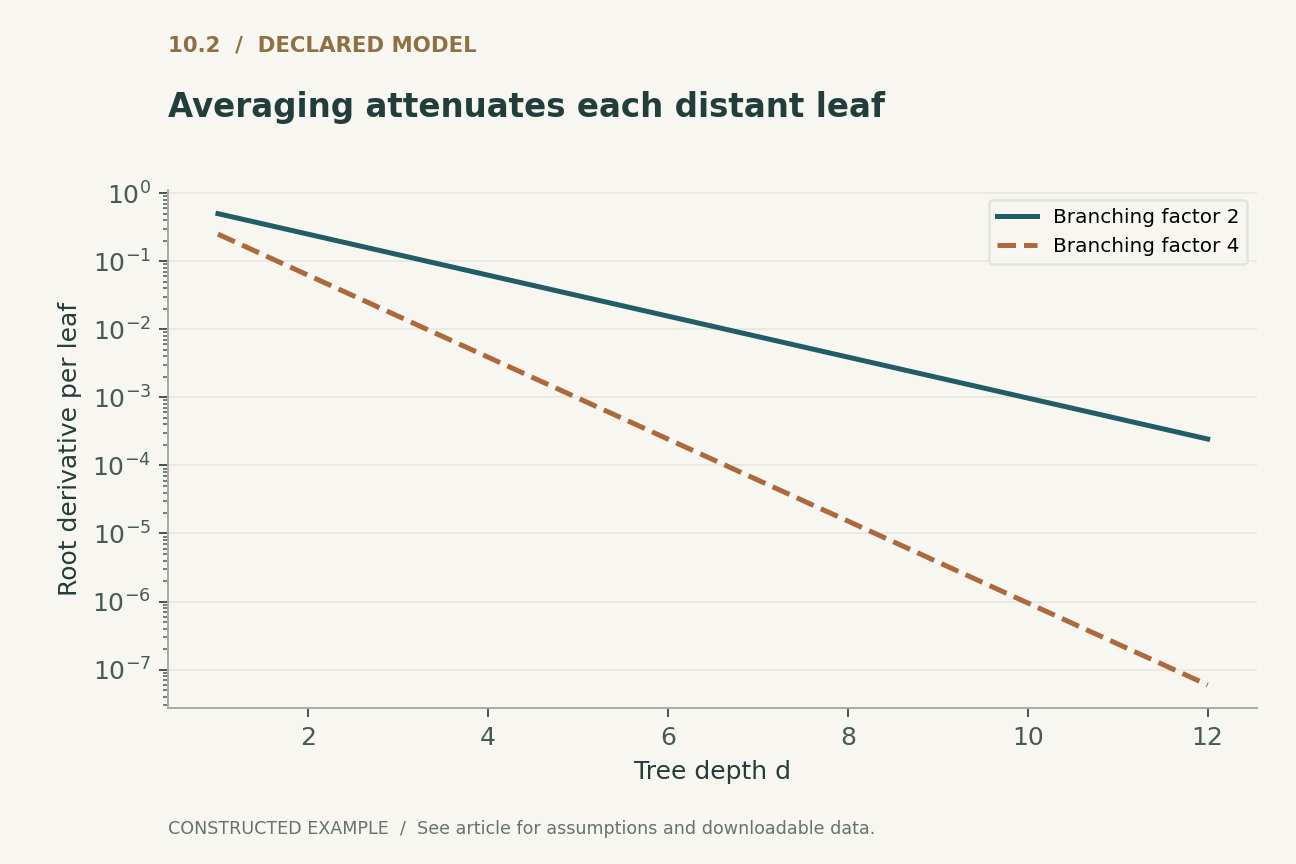
次に、分岐数b、深さdの正則な根付き木を考える。各内部ノードは、その子の算術平均を出力する。根はbのd乗個すべての葉の値の平均であり、任意の一つの葉に関するその微分はbの負のd乗となる。パネル2は、二分木と四分木についてこの微分を示す。
この減衰は、明示した作用素について厳密である。平均が同じである異なる葉の値の割当ても、同じ根の状態を生む。二つの葉の間で一つの一を移すと、特定の葉を問う目標は変わるが、根の平均は変わらない。付属資料では、八つの葉へのすべての二値割当てを列挙し、このような衝突を記録する。この例は、層内のノード表現が互いに似通うことを必要としない。すべてのノードが同じ表現へ収束するという通常の描像が当てはまらなくても、集約によってタスクに関連する区別が失われうることを示す。平滑化とボトルネックの診断を別々に報告すべきなのは、このためである。
10. 辺の再配線は経路と証拠の双方を変える
辺を追加すると、二つのノードが通信するために必要な集約ステップ数を減らせる場合がある。また、近傍の大きさ、正規化、計算コスト、グラフの意味も変わりうる。再配線の利点に関する因果的説明では、改善のすべてを経路長に帰するのではなく、これらの変化を調べなければならない。
グラフが物理的または意味的な関係を記録するものである場合、新たな辺は明示的なモデリング上の介入となる。その属性と解釈を記録すべきである。グラフが計算上の足場にすぎない場合、再配線の自由度は高くなりうるが、それでも関数クラスは変化する。有用な診断では、辺の予算をそろえて比較し、テストラベルにアクセスせずに経路を短縮する対照条件を含める。最終的な正解率だけを評価すると、推論時には利用できない情報を手法が利用していたかどうかが隠れてしまう可能性がある。アテンションやグローバルトークンも同様に代替的な通信経路を与えるが、実行時間と容量のコストを計上しなければならない。ボトルネックを除去すると説明されているだけで、介入のコストがなくなるわけではない。
11. タスクに条件づけた評価
提案する評価では、タスク半径、グラフの拡大性、関連する証拠の位置を独立に変化させる。ある合成タスク群では局所的な値を、別の群では全体の平均を、さらに別の群では遠く離れた葉の間の関係を問うことができる。同じ伝播規則がこれらのタスクで異なる理由によって成功または失敗するようにすれば、診断を解釈しやすくなる。
各モデルについて、受容野内での到達可能性、適切な平滑化部分空間からの距離、遠方の特徴への感度、タスクリスクを報告する。感度だけでは十分ではない。モデルは、必要な関係を無視しながら無関係な入力を増幅することがある。訓練グラフとテストグラフは、新たなノード、新たなグラフ、新たなグラフサイズなど、意図する汎化の問いに応じて分離すべきである。ハイパーパラメータの選択にテストグラフのラベルを用いてはならない。提供する検証が確立するのは、有限規模の作用素に関する恒等関係、減衰、および衝突の例だけである。学習済みネットワークの実際の性能を測定するものではなく、提案したより大規模な評価は、実施済みと主張する実験ではなく今後の課題である。
12. 深さを選ぶ前に障害を診断する
追加の計算と通信がタスクに必要な情報を保持する場合、深さは有用である。受容野の拡大からタスクが得る利益を上回る速さで、反復操作がその情報を消去し、見えにくくし、または圧縮すると、深さは有害となる。これらの可能性は、グラフ、伝播規則、特徴品質、判断に依存する。
二つの構成は、簡潔な診断の語彙を与える。スペクトル収縮は、特定のコントラストがどのように減衰するかを説明する。木上の平均集約は、遠方の寄与がどのように減衰し、異なる配置が根で区別できなくなるかを説明する。さらに、残差混合と再注入は、一見似たアーキテクチャ上の変更が異なる極限挙動をもちうることを示す。正当化可能な研究上の主張は、どの障害を測定し、どの介入がそれを変えたかを特定する。これは、グラフネットワークは本質的に浅い、あるいは一つのスキップ接続が深さの問題を解決すると宣言するよりも有益である。また、よりよい実験への道筋も示す。情報経路と目標をともに変化させ、対処法とされるものが、答えに必要な区別を保持することを検証すべきである。
ローカルで実行済み · 限定された範囲
二ノードのスペクトル減衰、特徴の再注入、および平均集約木の衝突の網羅的列挙
線形の二ノード漸化式と、八つの葉への全256通りの二値割当て。非線形GNNの普遍的定理や訓練ベンチマークではない。
394件のアサーションに合格。 これらの検証が妥当性を確認するのは、提供した例であり、引用されたシステムではない。
記録された検証用の具体例を確認
{
  "reinjection_beta": 0.2,
  "contrast_eigenvalue": 0.8,
  "stationary_gain": 0.5555555555555556,
  "leaf_assignments": 256,
  "distinct_root_values": 9,
  "collision_a": [
    1,
    0,
    0,
    0,
    0,
    0,
    0,
    0
  ],
  "collision_b": [
    0,
    1,
    0,
    0,
    0,
    0,
    0,
    0
  ],
  "shared_root_value": 0.125
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) GCN型の伝播。具体的に扱う二ノードモデルでは、学習されるWと非線形のsigmaを除き、明示された確率行列を用いる。
(2) コントラストcは二つのノードのスカラー値の差である。パネル1では0 < alpha < 1/2を用いる。
(3) 一定のbeta > 0および|(1-beta)lambda| < 1の下での元の特徴の再注入。表示した比ではc0は非零である。
(4) 深さd、分岐数bの正則木で、各内部ノードがスカラー平均集約を行う。学習される重みや代替経路はない。
構成した例 · 再現可能なデータ
定量的な論証を確認する
これらの曲線は、明示されたモデルから計算したものである。引用した研究の観測結果ではない。各図には数値データとベクトル版を付属する。


どの証拠がどの問いに答えるのか
| 機構 | 診断 | 固有の適用範囲をもつ介入 |
|---|---|---|
| 到達可能性の不足 | 必要な情報源が受容野の外にある | 経路または層の追加 |
| スペクトル平滑化 | タスクに関連する非定常成分の減衰 | 伝播を変更する、または元の特徴を保持する |
| 平均集約のボトルネック | 感度の減衰と厳密な衝突 | 集約器、容量、または通信経路を変更する |
| 最適化の失敗 | 訓練によって達成可能な目標に適合できない | グラフに原因があると仮定せず、学習ダイナミクスを調べる |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムやハードウェアのベンチマークは実施していない。別途実行した有限規模のモデルは、実行可能な検証に記録している。
- 関連する情報源ノード、タスク半径、望ましい出力位置を定義する。
- 直観を外挿する前に、二ノードの固有値による減衰と平均の保存を検証する。
- 異なる不動点を用いて、残差混合と元の特徴の再注入を比較する。
- 集約木の衝突を列挙し、分岐数を深さとは独立に変化させる。
- 到達可能性、平滑化部分空間からの距離、遠方の特徴への感度、タスクリスクを併せて評価する。
- テストラベルの漏洩を防ぐグラフ分割と再配線の対照条件を用い、実行間の不確実性を報告する。
一次資料が確立していること
Thomas N. Kipf, Max Welling · 2017 [1]
貢献。 GCNは、学習される特徴写像と正規化されたグラフ伝播を用いて半教師あり分類を行う。
適用範囲の限界。 線形の二ノード例では、学習される重みと非線形性を意図的に省いている。
出典内の該当箇所。 アーキテクチャの伝播規則。
Kenta Oono, Taiji Suzuki · 2020 [2]
貢献。 深いGCNの収束は、スペクトルと重みのノルムに関する条件の下で解析される。
適用範囲の限界。 結果を解釈する際、条件と漸近的な設定を省くことはできない。
出典内の該当箇所。 要旨と主要な収束解析。
Uri Alon, Eran Yahav · 2021 [3]
貢献。 長距離メッセージパッシングでは、過圧縮と呼ばれる集約のボトルネックが生じうる。
適用範囲の限界。 有限規模の平均集約木の例が証明するのは、明示された集約器の性質だけである。
出典内の該当箇所。 要旨、および問題半径とボトルネックに関する議論。
本分析の限界
- 有限規模の例は線形モデルまたはスカラー平均モデルであり、学習済みGNNの普遍的な記述ではない。
- スペクトル収束に関する主張には、明示した作用素と重みの仮定が必要である。
- 数値的制約や関数クラスの制約がなければ、次元が固定されているというだけでは情報理論的な不可能性は導かれない。
- グラフベンチマーク、ニューラルネットワークの訓練、引用したシステムの独立した追試は報告していない。
選定した三つの基礎的一次資料に焦点を絞った分析的レビューであり、独自の具体例を含む。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセスと版に関する注記は、参考文献とともに記録している。
結論を変えうる問い
- 学習済みの非線形ネットワークにおいて、どのようなタスク条件付きの測定が平滑化と圧縮を確実に切り分けるのか。
- グラフの辺が物理的関係を符号化するとき、再配線は科学的意味をどのように保持すべきか。
- 特徴の再注入を、深さに依存しないヒューリスティックではなく、信号品質に基づいて調整できるか。
参考文献
- Thomas N. Kipf, Max Welling. Semi-Supervised Classification with Graph Convolutional Networks. International Conference on Learning Representations (2017). Primary source.
- Kenta Oono, Taiji Suzuki. Graph Neural Networks Exponentially Lose Expressive Power for Node Classification. International Conference on Learning Representations (2020). Primary source.
- Uri Alon, Eran Yahav. On the Bottleneck of Graph Neural Networks and its Practical Implications. International Conference on Learning Representations (2021). Primary source.
資料[1]へのアクセス。 一次論文のPDF本文と一次書誌ランディングページを確認した。
版に関する注記。 ICLR 2017の論文を、2017年二月22日付のarXiv v4として参照した。最初のプレプリントは2016年に公開された。
資料[2]へのアクセス。 一次論文のPDF本文と一次書誌ランディングページを確認した。
版に関する注記。 ICLR 2020の論文を、2021年一月6日付のarXiv v5として参照した。最初のプレプリントは2019年に公開された。
資料[3]へのアクセス。 一次論文のPDF本文と一次書誌ランディングページを確認した。
版に関する注記。 ICLR 2021の論文を、2021年三月9日付のarXiv v4として参照した。最初のプレプリントは2020年に公開された。
書誌情報の同一性は、出版社および著者の一次記録と照合した。以下のアクセスと版に関する注記が確認範囲を示す。これは全文の網羅的な監査ではない。
著者情報と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は原研究者を示し、解析的な構成と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術的な図は、明示したモデルまたは有限規模の例から計算し、PythonとCSVを提供する。稼働中の製品の測定値や、再現した性能ベンチマークではない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、記述した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。