
要旨
拡散生成は、学習された統計的な場と数値的な輸送手続きを組み合わせる。本分析的レビューでは、ノイズ予測、スコア、ノイズ除去推定値、初期化、時間積分における誤差を分離する。基礎となる三つの一次資料によってモデル化の文脈を示した後、独立に導出したガウス分布の構成を用いて、一見小さな予測誤差がノイズスケールによって異なる結果をもたらし得る理由を示す。定常Ornstein–Uhlenbeck過程の例は、ソルバーが収束しても終点のバイアスが持続することを明らかにする。再現可能な二つの図と範囲を限定した数値検査がこの構成を裏付ける。また、提案する評価プロトコルは、合成的な曲線を画像生成の測定結果として提示することなく、モデル誤差とソルバー誤差を分離する。
1. 何の精度を求めるのかを定義する
生成画像は、その分布が訓練分布と異なっていても、視覚的には説得力を持ち得る。逆に、尤度が改善しても、見る人が重要と考える特徴が修正されるとは限らない。したがって、有用な技術的分析は、何を近似しているのかを明示することから始まる。すなわち、時間で添字付けされた密度、そのスコア、ノイズの条件付き期待値、あるいは有限個の遷移列のいずれかである。これらは方程式で関係付けられるが、その誤差の単位と重み付けは異なる。相互に交換可能なものとして扱うと、検証曲線の解釈が困難になる。
ここでの分析は、ノイズ付加後の密度が滑らかで正となる、連続的なユークリッド変数を対象とする。単一のスカラー誤差から意味的忠実度を推論するものではない。主な問いはより限定的であり、指定された予測器の誤差が、明示的に指定されたサンプラーにどのように入り込むか、というものである。この問いにはガウスモデルで厳密に答えることができ、その答えを画像実験の代替ではなく、その整理に用いることができる。訓練目的、サンプラーの設定、終点での評価は、別個の三つの証拠を構成する。
2. 基礎となる三つの構成が示すこと
Ho、Jain、Abbeelは、ガウス的な順方向汚染過程を、学習された逆向き遷移および簡略化されたノイズ予測目的に結び付けている。これは扱いやすい訓練の構成を与えるが、あらゆるサンプラーの下で各時間ステップの影響が等しくなることを意味しない。Songらは、確率微分方程式と、それに対応する確率流の常微分方程式を用いて、スコアに基づく生成を定式化している。その等価性は、適切な厳密スコアと正則性の仮定の下での周辺分布に関するものである。任意の近似実装が一致するという主張ではない。
Song、Meng、Ermonは、拡散の訓練目的を共有する陰的サンプリング過程を構成している。この研究は、サンプリング軌道を変更しても、訓練目的を変更する必要は必ずしもないという重要な分離を明らかにする。本レビューにとって、その帰結は方法論的なものである。比較では、何を学習したかと、どのようにサンプルを生成したかの両方を示すべきである。これらの論文で報告された性能を、以下の図に取り込んではいない。以下の図は新たな代数的構成であり、各論文の画像実験を再現したものではない。 [1], [2], [3]
3. 換算係数はそれ自体が誤差の増幅要因である
加法的ガウス汚染Y = X + sigma × epsilonを考える。epsilonは標準正規分布に従い、sigmaは厳密に正とする。ノイズの条件付き平均と周辺スコアは、予測ノイズがスコアにマイナスsigmaを掛けたものになる、という単純な関係を満たす。予測器に加法的なノイズ誤差deltaがある場合、対応するスコア誤差はマイナスdeltaをsigmaで割ったものになる。その大きさはsigmaが減少するにつれて増大する。この換算は、クリーンなサンプルの推定値が際限なく不正確になることを意味しない。ノイズ除去推定値にはスコアにsigmaの二乗を掛けたものを用いるため、誘起されるクリーン推定誤差はマイナスsigma × deltaとなる。
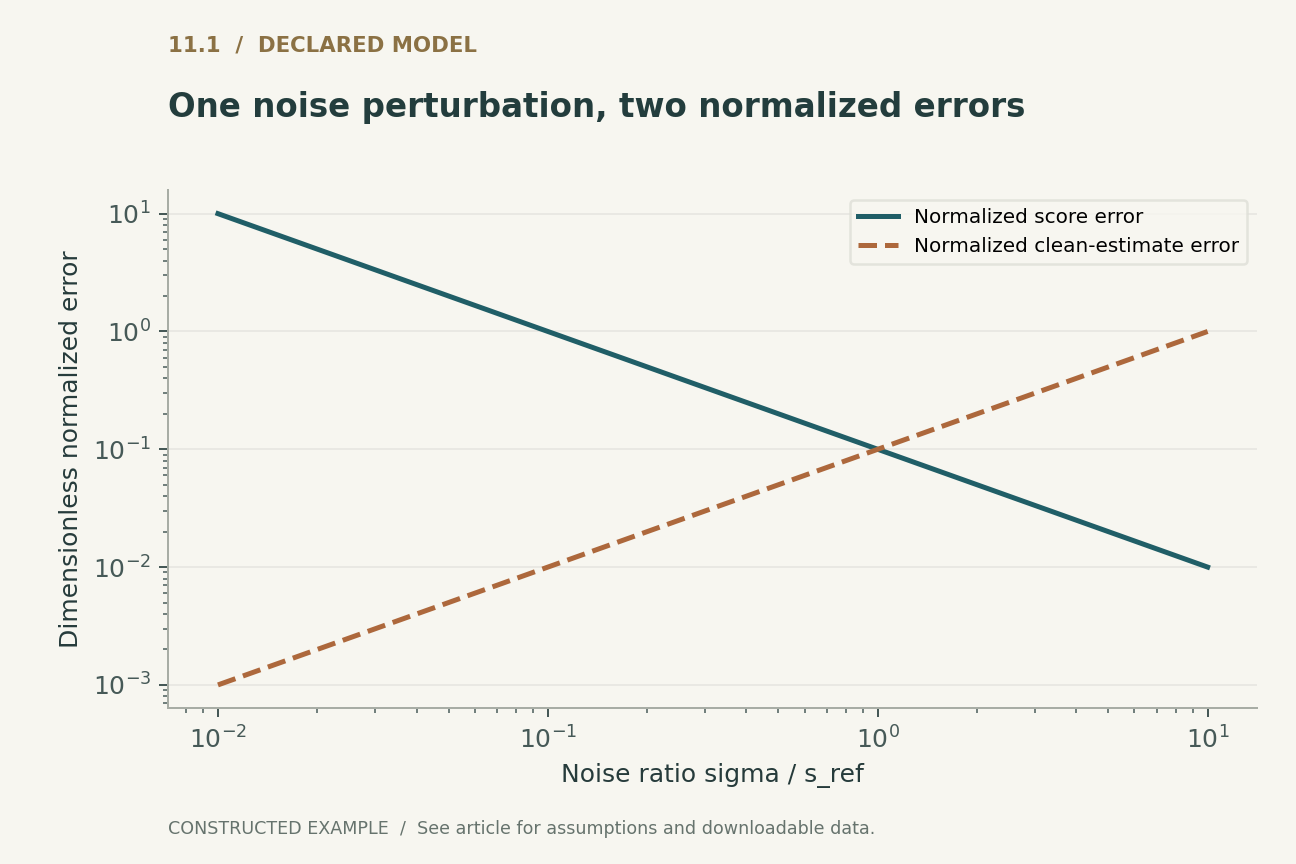
図1では、無次元のノイズ予測誤差deltaを0.1に固定し、ノイズ比sigma/s_refを変化させる。物理単位の異なる量を適切に比較するため、固定基準スケールs_refをデータの一単位に等しく設定し、s_refとスコア誤差の絶対値の積、およびクリーン推定誤差の絶対値をs_refで割った値を描く。描かれる二つの量はいずれも無次元である。同じ人工的摂動を表しているにもかかわらず、一方は増加し、他方は減少する。これらの正規化値は相互に交換可能な品質指標ではなく、スケーリングの規約を明示している。この構成は、ノイズ予測の絶対誤差が一定であると仮定したものであり、訓練済みネットワークの実証的性質を示すものではない。
4. 周辺スコアと実現した汚染の教師信号は異なる
訓練例には、ガウスノイズベクトルの一つの実現値が含まれる。ノイズを含む観測と時刻だけを条件とする二乗誤差最小の予測器は、そのベクトルの条件付き期待値であり、未知の実現値ではない。したがって、残存する訓練損失には、近似誤差だけでなく、除去不能な条件付き分散も含まれる。信号対雑音比が異なる条件間で生の損失を比較すると、この分解が見えにくくなり得る。
この区別は、ニューラルネットワークを使わず、一次元で確認できる。クリーンデータが標準正規分布に従い、汚染の分散がsigmaの二乗である場合、ノイズを含む観測の分散は一にsigmaの二乗を足したものとなる。条件付き期待値から、観測に比例するノイズ予測器が得られ、その係数はsigmaを一とsigmaの二乗の和で割ったものになる。この係数をスコアへの換算に代入すると、観測をその周辺分散で割って符号を反転した値が得られる。この計算は、教師ラベルにノイズがあってもノイズ除去の教師信号が有用である理由を説明する。また、オラクルとの比較で何を差し引くべきかも示している。それはゼロの訓練損失ではなく、条件付き予測リスクである。
5. 既知の持続的バイアスを持つ逆向きサンプラー
ドリフトが状態のマイナス二分の一倍、拡散係数が一である、順方向の定常Ornstein–Uhlenbeck過程を考える。その周辺密度は標準正規分布のまま保たれる。逆向きサンプリングを、増加する逆時間tauでパラメータ化する。厳密スコアを用いると、逆向きドリフトも状態のマイナス二分の一倍となる。スコアを、厳密スコアに定数bを加えたものに置き換える。すると逆向きドリフトは、状態のマイナス二分の一倍にbを加えたものとなる。
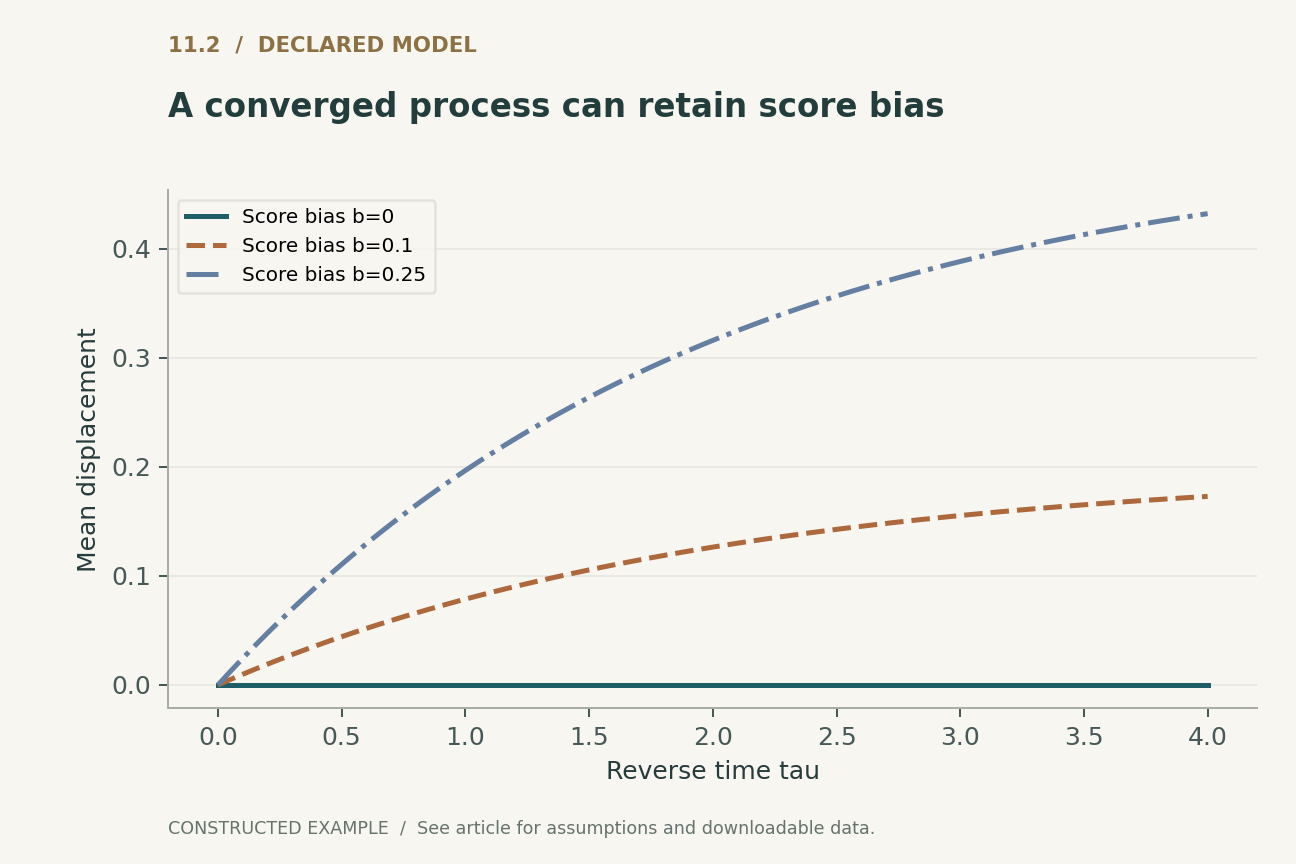
標準正規分布からのサンプルを初期値とすると、逆過程は連続時間で単位分散を保ち、その平均は、bの二倍に、一からマイナスtauを二で割った値の指数関数を引いたものを掛けた値となる。図2は、明示した三つのスコアバイアスについてこの平均を描いている。この誤差は学習された場の性質であり、積分によるアーティファクトではない。ソルバーは誤った平均に完全に収束し得る。これは、数値的収束だけで統計的正しさが成立するという推論に対する反例であり、自然画像のリアリズムを表すモデルではない。
6. 離散化誤差と学習された場の誤差を分離する必要がある
上述の逆過程をEuler法で離散化すると、各ステップで平均に一から刻み幅の半分を引いた値を掛け、刻み幅とbの積を加える。この漸化式には閉形式解があり、数値実装を厳密なバイアス付き過程と比較できる。刻み幅を小さくすると離散化誤差は減少するが、連続時間の非ゼロのバイアスは残る。したがって、細かい二つの格子だけを比較するテストは、生成分布が目標から外れていても合格し得る。
付属の実行可能な検査では、両方の極限を別々に計算する。また、Euler法のノイズ注入とドリフトによる収縮は有限の刻み幅で単位分散を厳密には保存しないため、分散の漸化式も調べる。これらの検査は、選択したステップ数とバイアスに意図的に範囲を限定している。提供コードが明示された方程式に従うことを確かめるものであり、学習された画像サンプラーを認証するものではない。より一般的な実験上の教訓は、扱いやすい目標分布を利用できる場合には、オラクルスコアによる対照を含めることである。
7. 時間重み付けは科学的な問いを変える
スコア誤差の単一のスカラー積分は、時間のサンプリング分布と明示的な重み付けに依存する。訓練や評価の重みを軌道の一方の端付近に集中させると、別の領域への制約が弱いまま、そのスカラー値を改善できる可能性がある。また、サンプラーが訪れる状態の分布は、訓練中に用いた順方向汚染の分布と異なる場合がある。したがって、追跡すべき変化は、時間重み付けと状態分布の不一致の二つである。
解釈可能な報告では、座標系を指定したうえで、明示した時間ビンごとの誤差プロファイルを示すべきである。時間に一様、ノイズ標準偏差に一様、対数信号対雑音比に一様という選択は、それぞれ異なる測度である。どれか一つが自動的に唯一正しい選択になるわけではない。重み付けは、それが表す目的、または望ましい終点挙動との実証的に検証された関係によって正当化される。ガウス分布の構成は、複雑なデータに対してその関係を与えるものではない。単に、単位や重みが一つの見栄えのよい平均の中に埋没するのを防ぐものである。
8. 条件付き制御は新たな場を加える
条件付けとガイダンスは、サンプリングの場を変更する。その変更が望ましい属性を改善する場合でも、分析対象の数学的な対象そのものが変わる。無条件スコアの誤差測定だけでは、ガイダンス付き軌道を検証できない。追加された場は、局所的な導関数を増幅し、訓練時の表現が乏しい領域に経路を集中させ、あるいは網羅性と集中性の均衡を変える可能性がある。
統制された研究では、基本となる予測器を固定し、条件付けの強さとソルバーの計算予算を変化させる。厳密なガイダンス方程式と、勾配をクリッピングまたは再スケーリングしているかどうかを記録する。プロンプトを視覚的に満たす例だけを選ぶのではなく、モードの欠落と望ましくない変動の両方を検出できる終点統計量を評価する。ガウス分布による診断では、定数のガイダンス項は単に別のドリフトバイアスであるため、その効果を厳密に計算できる。画像モデルでは、同じ代数は局所的な注意を与えるものであり、あらゆるガイダンスが平均の移動として振る舞うという予測ではない。
9. 説得力のある実証結果とは何か
説得力のある研究では、三つの主張を分離する。第一に、明示されたノイズ付き入力分布の下で、予測器が宣言した目標を近似すること。第二に、所定の計算予算で、ソルバーが選択された連続過程または離散過程を近似すること。第三に、変動性を考慮した評価設計の下で、サンプルが用途固有の基準を満たすことである。一つの主張に対する証拠を、別の主張の証拠として代用してはならない。
画像実験では、変種を比較する前に、評価計画でホールドアウトデータ、サンプル数、前処理、乱数シード、モデルのチェックポイント、不確実性の計算方法を指定すべきである。計算コストには、すべてのスコア評価、補正ステップ、条件付けの呼び出しを含めるべきである。有用なアブレーションは、訓練済みモデルを固定してサンプラーだけを変更するものであり、相補的なアブレーションは、サンプラーを固定して訓練目的だけを変更するものである。本稿はこの設計を提案するが、実行はしていない。提供する有限な検査はガウス分布のモーメントを対象とし、新たな画質順位を裏付けることはできない。
10. 可解モデルの実用的価値
小さな解析例は、そうでなければ隠れたままとなる曖昧さを観測可能にするときに価値を持つ。ここでは、同一のノイズ誤差がスコア誤差とクリーン推定誤差に逆方向の傾向をもたらし得ること、また収束した数値手法がモデルバイアスを保持し得ることを示している。いずれの観察にも、ガウスデータが写真の意味内容を近似するという主張は必要ない。
付属コードの適切な使い方は、診断のひな型とすることである。ブラックボックス的な端から端までの成功という主張を、答えを独立に計算できる中間量に置き換える。その後、取り除いた仮定を記録しながら複雑さを加える。学習されたサンプラーが扱いやすい分布で失敗するなら、その失敗は対処の手掛かりとなる。合格するなら、その結果は限定的な整合性検査となる。信頼できる拡散評価には、究極的には、単純化した機構に対する数学的制御と、実際の目標分布に対する実証的な精査という、両方の証拠が必要である。両者の境界を明示しておくことで、それぞれの有用性が増す。
ローカルで実行済み · 範囲限定
ノイズからスコアへの恒等式と、バイアス付きOU過程の平均・分散の厳密な漸化式
スカラーのガウス場と列挙したEuler離散化のみを対象とし、学習された予測器や画像サンプラーはテストしていない。
117件のアサーションに合格。 これらの検査は、引用したシステムではなく、提供した例を検証する。
記録された検証証跡を確認する
{
  "T": 2,
  "step_counts": [
    4,
    8,
    16,
    32,
    64,
    128
  ],
  "biases": [
    0,
    0.1,
    0.25,
    -0.2
  ],
  "limiting_mean_b025": 0.31606027941427883,
  "refinement": [
    {
      "b": 0.0,
      "mean_error_at_N128": 0.0
    },
    {
      "b": 0.1,
      "mean_error_at_N128": 0.00028834504988073384
    },
    {
      "b": 0.25,
      "mean_error_at_N128": 0.0007208626247024452
    },
    {
      "b": -0.2,
      "mean_error_at_N128": 0.0005766900997614677
    }
  ]
}
例の実行プログラム · モデルローダー · 訓練モデル · 表現モデル · 生成モデル · 信頼性モデル検査結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 加法的かつ等方的なガウス汚染、sigma > 0、微分可能な周辺密度を仮定する。この等式が扱うのはノイズの条件付き平均であり、単一サンプルにおけるノイズの実現値ではない。
(2) ノイズ予測に対する無次元の加法的摂動deltaを固定する。クリーン推定値は、yに、推定スコアとsigmaの二乗の積を加えたものである。生のスコア誤差の単位はデータ単位の逆数であり、生のクリーン推定誤差はデータ単位を持つ。図1では、s_refをデータの一単位に固定し、delta = 0.1として、無次元のs_ref*abs(スコア誤差)とabs(クリーン推定誤差)/s_refを用いる。
(3) 加法的スコアバイアスbと初期平均ゼロを持つ、逆時間での定常ガウス診断。拡散係数は一であり、連続時間での分散は一を保つ。
(4) 区間[0,T]上で等しい幅のステップをN回進めた後のEuler法の平均。これらの式は、離散化誤差を極限過程の非ゼロのバイアスから分離するものであり、画質の数学的な上界や下界を与えるものではない。
構成した例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示したモデルから計算したものである。引用研究から得た観測値ではない。各図には、数値データとベクトル形式の版を付属させている。


どの証拠がどの問いに答えるのか
| 量 | 必要な参照対象 | 単一の終点評価値が隠す失敗 |
|---|---|---|
| ノイズ予測器 | ノイズの条件付き期待値 | 教師信号の除去不能な分散 |
| スコア場 | ノイズ付加後の対数密度の勾配 | ノイズに依存する単位換算 |
| サンプラー | 指定されたバイアス付き過程または厳密過程 | 誤った分布への収束 |
提案する検証プロトコル
これは提案段階の評価設計である。実運用システムやハードウェアのベンチマークは実施していない。別途実行した有限モデルについては、実行可能な検査に記載している。
- 扱いやすい目標分布を指定し、そのノイズ付加後の密度とオラクルスコアを独立に計算する。
- 明示した同一の時間格子と状態分布にわたって、ノイズ誤差、スコア誤差、ノイズ除去推定誤差を評価する。
- 既知の加法的誤差およびスケール依存の予測器誤差を注入し、その単位とパラメータ化を記録する。
- ステップ数を増やしながら、数値的なモーメントをバイアス付き過程の厳密なモーメントと比較する。
- 別途行う実データ研究では、チェックポイントを固定し、サンプル数、シード、不確実性、すべてのモデル評価を報告する。
- 方程式、スケジューラー、精度、条件付け規則、コード、失敗を保存し、ガウス分布による検査は実証的なサンプル品質とは分けて報告する。
一次資料が示すこと
Jonathan Ho, Ajay Jain, Pieter Abbeel · 2020 [1]
貢献。 ガウス汚染と逆向き遷移の構成が、ノイズ除去に基づく生成学習を支える。
適用範囲。 そこで報告された画像実験は本稿では再現していない。本稿では別個のガウス診断を用いる。
出典の該当箇所。 第2節および第3節。特に順方向の周辺分布と簡略化された目的。
Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma et al. · 2020 [2]
貢献。 スコアに基づくSDEの枠組みには、逆向きサンプリングと確率流ODEが含まれる。
適用範囲。 厳密な周辺分布が等しいことは、任意の近似ソルバーが等しいことを意味しない。
出典の該当箇所。 第3.2節および第4.3節。確率流の導出は付録D。
Jiaming Song, Chenlin Meng, Stefano Ermon · 2020 [3]
貢献。 陰的サンプラーは、サンプリングのダイナミクスを変更しながら、拡散の訓練目的を共有できる。
適用範囲。 サンプリングの速度と品質は、依然として実証的な問題であり、設定に依存する。
出典の該当箇所。 要旨および第3–4節。arXiv v4の記録。
本分析の限界
- 例はいずれも一次元ガウス分布の構成であり、その幾何は画像の意味的品質をモデル化していない。
- 加法的スコア摂動は意図的に単純化されており、学習された状態依存の誤差に似ているとは限らない。
- 有限個の数値アサーションは、明示した例を検証するものであり、一般的な収束定理やニューラルネットワークの実装を検証するものではない。
- レビューするのは基礎的な三つの資料のみであり、より新しいサンプラーや訓練目的は、この焦点を絞った分析の対象外である。
選定した基礎的な三つの一次資料を対象に、独自の計算例を添えた、焦点を絞った分析的レビューである。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセス範囲と版に関する注記は、参考文献とともに記録している。
結論を変え得る問い
- 時間別に分解した予測器誤差のうち、実際のサンプリング分布の下での失敗を最もよく予測するものは何か。
- ソルバーの許容誤差は、数値誤差だけでなく、学習された場の局所的不確実性にどのように応答すべきか。
- 評価スイートは、扱いやすいオラクル対照を維持しつつ、モードの喪失と条件付けの失敗を明らかにできるか。
参考文献
- Jonathan Ho, Ajay Jain, Pieter Abbeel. Denoising Diffusion Probabilistic Models. arXiv preprint (2020). 10.48550/arXiv.2006.11239.
- Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma et al.. Score-Based Generative Modeling through Stochastic Differential Equations. arXiv preprint (2020). 10.48550/arXiv.2011.13456.
- Jiaming Song, Chenlin Meng, Stefano Ermon. Denoising Diffusion Implicit Models. arXiv preprint (2020). 10.48550/arXiv.2010.02502.
資料[1]へのアクセス。 一次メタデータ、要旨、およびアクセス可能な方法記述の一部を確認。補足資料の網羅的な監査は行っていない。
版に関する注記。 v2、2020年十二月16日改訂。
資料[2]へのアクセス。 一次メタデータ、要旨、およびアクセス可能な方法記述の一部を確認。補足資料の網羅的な監査は行っていない。
版に関する注記。 初版プレプリントは2020年。v2は2021年二月10日改訂。記録にはICLR 2021と記載。
資料[3]へのアクセス。 一次メタデータ、要旨、およびアクセス可能な方法記述の一部を確認。補足資料の網羅的な監査は行っていない。
版に関する注記。 初版プレプリントは2020年。v4は2022年十月5日改訂。記録にはICLR 2021と記載。
書誌上の同定情報は、出版社および著者による一次記録と照合した。以下の資料アクセスと版に関する注記は確認範囲を示すものであり、全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示するものであり、解析的構成と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的イラストである。技術的な図は、明示したモデルまたは有限の例から計算しており、PythonとCSVを提供している。実運用製品の測定値でも、性能ベンチマークの再現でもない。
このローカル草稿には、独立した査読や学術誌による受理の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検査するものであり、引用したシステムの形式的検証ではない。