
摘要
扩散生成将学习得到的统计场与数值输运过程结合起来。本分析性综述区分了噪声预测、得分、去噪估计、初始化和时间积分中的误差。三篇基础性一手文献确立了建模背景;随后,一个独立推导的高斯构造说明,看似很小的预测误差为何会在不同噪声尺度下产生不同后果。一个平稳奥恩斯坦–乌伦贝克过程的例子揭示,即使求解器收敛,终点偏差仍会持续存在。两幅可复现图和范围有限的数值检查为这一构造提供支持,同时,所提出的评估方案将模型误差与求解器误差分离,并未将合成曲线呈现为图像生成的测量结果。
1. 定义需要准确的对象
即使生成图像的分布与训练分布不同,它在视觉上仍可能令人信服。反过来,似然的改善也未必能修复观看者认为重要的特征。因此,有用的技术分析首先要声明所近似的对象:随时间索引的密度、其得分、条件噪声期望,还是有限的转移序列。这些对象通过方程相互关联,但其误差具有不同的单位和权重。将它们视为可互换的对象,会使验证曲线难以解释。
本文分析的是具有光滑正值含噪密度的连续欧几里得变量,并不从一个标量误差推断语义保真度。其主要问题更为具体:指定的预测器误差如何进入一个明确指定的采样器?这个问题可以在高斯模型中得到精确回答,再用来组织图像实验,而不是替代图像实验。训练目标、采样器配置和终点评估构成三项彼此独立的证据。
2. 三项基础构造确立了什么
Ho、Jain 和 Abbeel 将高斯前向扰动过程与学习得到的反向转移及简化的噪声预测目标联系起来。这提供了一种易于处理的训练构造,但并不意味着在每一种采样器下,各时间步都具有同等影响。Song 及其同事利用随机微分方程和相应的概率流常微分方程来表述基于得分的生成。两者的等价性涉及在适当的精确得分和正则性假设下的边缘分布,并不是说任意近似实现都会一致。
Song、Meng 和 Ermon 构造了共享扩散训练目标的隐式采样过程。他们的工作揭示了一项关键区分:改变采样轨迹未必需要改变训练目标。对本综述而言,其意义在于方法论。比较应同时说明学到了什么以及如何生成样本。这些论文报告的性能并未被引入下文图表;下文图表是新的代数构造,而不是对其图像实验的复现。 [1], [2], [3]
3. 换算因子本身就是误差放大器
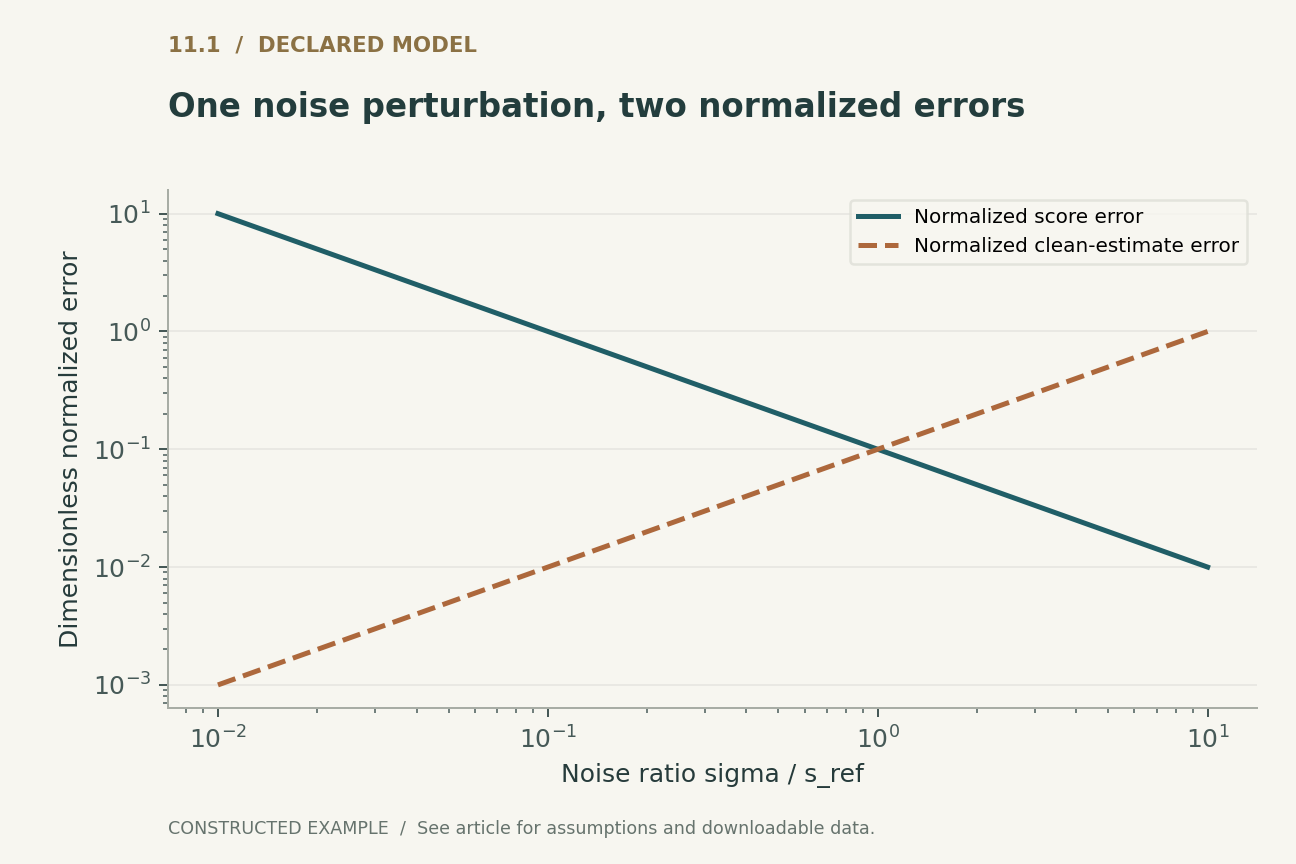
考虑加性高斯扰动 Y = X + sigma 乘以 epsilon,其中 epsilon 服从标准正态分布,sigma 严格为正。条件噪声均值与边缘得分满足一个简单关系:预测噪声等于负 sigma 乘以得分。如果预测器具有加性噪声误差 delta,对应的得分误差就是负 delta 除以 sigma。其大小随 sigma 减小而增大。这一换算并不意味着干净样本估计会变得任意不准确:去噪估计使用 sigma 的平方乘以得分,因此所引起的干净估计误差为负 sigma 乘以 delta。
图 1 将无量纲噪声预测误差 delta 固定为 0.1,并改变噪声比 sigma/s_ref。为了如实比较物理单位不同的量,选择一个等于一个数据单位的固定参考尺度 s_ref:绘制 s_ref 乘以得分误差绝对值,以及干净估计误差绝对值除以 s_ref。这两个绘制量均为无量纲量。尽管它们描述的是同一个人为扰动,一个上升,另一个却下降。这些归一化值并不是可互换的质量指标;其尺度约定已明确声明。该构造假设绝对噪声预测误差固定,并非训练后网络的一项实证性质。
4. 边缘得分不同于实际实现的扰动目标
一个训练样本包含一个实际实现的高斯噪声向量。仅以含噪观测和时间为条件时,平方误差最优预测器预测的是该向量的条件期望,而不是其未知的实现值。因此,残余训练损失既包含不可约的条件方差,也包含近似误差。在不同信噪比下比较原始损失,可能会掩盖这种分解。
无需神经网络,就可以在一维情形中检验这种区别。如果干净数据服从标准正态分布,扰动方差为 sigma 的平方,那么含噪观测的方差为一加 sigma 的平方。条件期望给出的噪声预测器与观测成正比,其系数为 sigma 除以一加 sigma 的平方。将这一系数代入得分换算式,就得到负的观测值除以其边缘方差。这一计算解释了为何即使标签带噪,去噪目标仍然有用。它也指出,与理想参照进行比较时应该减去什么:应减去条件预测风险,而不是零训练损失。
5. 具有已知持续偏差的反向采样器
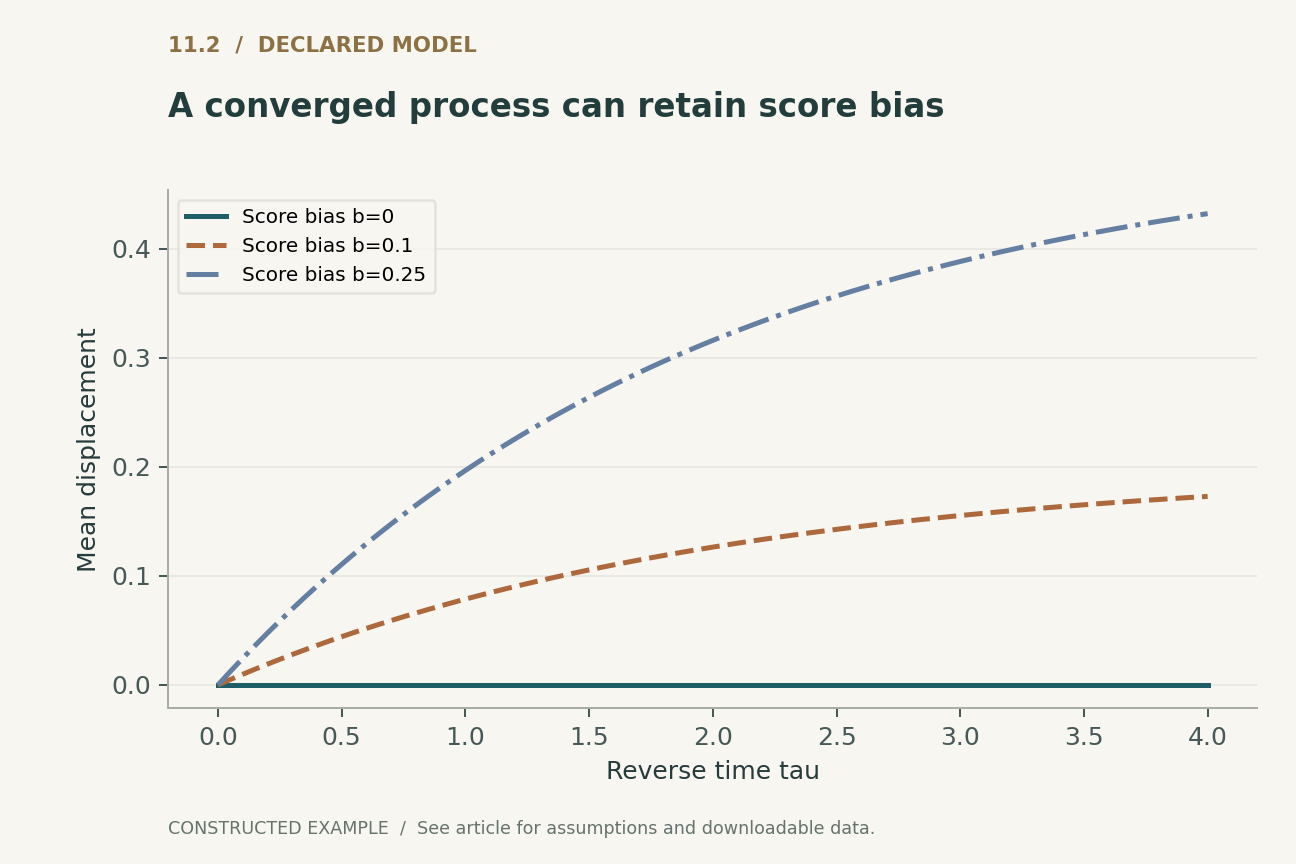
考虑前向平稳奥恩斯坦–乌伦贝克过程,其漂移为状态的负二分之一倍,扩散系数为一。它的边缘密度保持为标准正态密度。用递增的反向时钟 tau 对反向采样进行参数化。在使用精确得分时,反向漂移仍为状态的负二分之一倍。将得分替换为精确得分加上常数 b 后,反向漂移变为状态的负二分之一倍再加 b。
从标准正态分布抽取初始样本后,反向过程在连续时间中保持单位方差,而其均值变为 b 的两倍乘以(一减去 exp(−tau/二))。图 2 绘制了三种已声明得分偏差下的这一均值。该误差是学习场的性质,而不是积分伪影。求解器可以完美地收敛到错误的均值。这反驳了仅凭数值收敛就能确立统计正确性的推断,但它并不是自然图像逼真性的模型。
6. 必须分离离散化误差与学习场误差
对上述反向过程进行欧拉离散化时,每一步都将均值乘以一减半个步长,再加上步长乘以 b。这一递推具有闭式解,因此能够将数值实现与精确的有偏过程进行比较。缩小步长会减小离散化误差,却保留连续时间中非零的偏差。因此,即使生成分布偏离目标,只比较两个精细网格的测试仍可能通过。
随附的可执行检查分别计算这两个极限。它们还检验方差递推,因为在有限步长下,欧拉法的噪声注入与漂移收缩并不能精确保留单位方差。这些检查有意限定于所选步数和偏差。它们确立的是所提供代码遵循了声明的方程,而不是认证一个学习得到的图像采样器。更普遍的实验启示是:在存在易于处理的目标分布时,应加入使用理想得分的对照。
7. 时间加权改变了科学问题
得分误差的单一标量积分依赖于时间采样分布和任何显式权重。将训练或评估权重集中在轨迹某一端附近,可以改善该标量,同时让另一区域仍然受到较弱约束。采样器访问的状态分布也可能不同于训练期间使用的前向扰动分布。因此,需要跟踪两种变化:时间加权和状态分布不匹配。
一份可解释的报告应给出所声明时间分箱上的误差剖面,并指明坐标系。均匀时间、均匀噪声标准差和均匀对数信噪比是不同的测度,没有哪一种会自动成为唯一正确的选择。某种加权方式应通过其所代表的目标,或通过其与期望终点行为之间经实证检验的关系来获得依据。高斯构造并不为复杂数据提供这种关系;它们只是防止单位和权重消失在一个看起来很有吸引力的平均值之中。
8. 条件控制增加了另一个场
条件化和引导会修改采样场。即使这样的修改改善了某个期望属性,也会改变正在分析的数学对象。仅凭无条件得分误差的测量,无法验证引导后的轨迹。增加的场可能放大局部导数,使路径集中在训练期间表征不足的区域,或改变覆盖性与集中性之间的平衡。
在受控研究中,应固定基础预测器,同时改变条件化强度和求解器预算。记录精确的引导方程,以及是否对梯度进行裁剪或重新缩放。应评估能够同时检测遗漏模态和不期望变异的终点统计量,而不是只挑选视觉上满足提示的例子。在高斯诊断中,常数引导项只是另一个漂移偏差,因此其影响可以精确计算。在图像模型中,同样的代数只是一种局部提醒,并不预测所有引导都像均值平移那样起作用。
9. 什么才算有说服力的实证结果
一项有说服力的研究应区分三个主张。第一,在声明的含噪输入分布下,预测器近似了其声明的目标。第二,在给定计算预算下,求解器近似了所选择的连续或离散过程。第三,在考虑变异性的评估设计下,样本满足特定应用的标准。支持某一主张的证据不应被用来替代对另一主张的证据。
对于图像实验,评估计划应在比较变体之前规定留出数据、样本数量、预处理、随机种子、模型检查点和不确定性计算。计算成本应包括每一次得分求值、校正步骤和条件化调用。一项有用的消融实验固定训练好的模型,只改变采样器;互补的消融实验则固定采样器,只改变训练目标。本文提出了这一设计,但并未执行。所提供的有限检查针对高斯矩,无法支持新的图像质量排名。
10. 可解模型的实用价值
当一个小型解析例子能让原本隐藏的歧义变得可观察时,它就具有价值。这里的例子表明,相同的噪声误差可能意味着得分误差与干净估计误差呈相反趋势,而一个已收敛的数值方法仍可能保留模型偏差。这两项观察都不需要声称高斯数据能够近似照片的语义。
配套代码的恰当用途是充当诊断模板。应以具有可独立计算答案的中间量,替换黑箱式的端到端成功主张。然后在增加复杂性的同时,保留已移除哪些假设的记录。如果学习得到的采样器在易于处理的分布上失败,这种失败就能为采取行动提供依据;如果通过,结果也只是有限的相容性检查。可靠的扩散评估最终需要两类证据:对简化机制的数学控制,以及对实际目标分布的实证审查。明确保留两者的边界,会使它们更加有用。
已在本地执行 · 范围有限
噪声到得分的恒等式及有偏 OU 过程均值与方差的精确递推
仅涉及标量高斯场和列出的欧拉离散化;未测试任何学习得到的预测器或图像采样器。
117 项断言通过。 这些检查验证的是所提供的例子,而非所引用的系统。
检查记录的验证见证
{
  "T": 2,
  "step_counts": [
    4,
    8,
    16,
    32,
    64,
    128
  ],
  "biases": [
    0,
    0.1,
    0.25,
    -0.2
  ],
  "limiting_mean_b025": 0.31606027941427883,
  "refinement": [
    {
      "b": 0.0,
      "mean_error_at_N128": 0.0
    },
    {
      "b": 0.1,
      "mean_error_at_N128": 0.00028834504988073384
    },
    {
      "b": 0.25,
      "mean_error_at_N128": 0.0007208626247024452
    },
    {
      "b": -0.2,
      "mean_error_at_N128": 0.0005766900997614677
    }
  ]
}已声明的解析模型
四个方程,明确的假设
(1) 加性各向同性高斯扰动,sigma > 0,边缘密度可微。该等式涉及条件平均噪声,而非某个样本中实际实现的噪声。
(2) 固定无量纲加性噪声预测扰动 delta。干净估计为 y 加上 sigma 的平方乘以估计得分。原始得分误差的单位是数据单位的倒数,原始干净估计误差则具有数据单位。图 1 使用无量纲的 s_ref*abs(得分误差) 和 abs(干净估计误差)/s_ref,其中固定 s_ref = 一个数据单位,delta = 0.1。
(3) 反向时钟下的平稳高斯诊断,具有加性得分偏差 b,初始均值为零。扩散系数为一;连续时间方差保持为一。
(4) 在区间 [0,T] 上经过 N 个等长步骤后的欧拉均值。这些公式将离散化误差与极限过程的非零偏差分离;它们并不是图像质量界。
构造示例 · 可复现数据
检查定量论证
这些曲线根据声明的模型计算而来,并非所引用研究中的观测结果。每幅图均附带数值数据和矢量版本。


哪种证据回答哪种问题?
| 量 | 所需参照 | 单一终点评分掩盖的失败 |
|---|---|---|
| 噪声预测器 | 条件噪声期望 | 不可约的目标方差 |
| 得分场 | 含噪对数密度的梯度 | 依赖噪声的单位换算 |
| 采样器 | 指定的有偏过程或精确过程 | 收敛到错误分布 |
拟议的验证方案
这是一个拟议的评估设计。未进行生产系统或硬件基准测试。单独执行的有限模型记录于可执行检查中。
- 指定一个易于处理的目标,并独立计算其含噪密度和理想得分。
- 在同一组已声明的时间网格与状态分布上,评估噪声、得分和去噪估计误差。
- 注入已知的加性预测器误差和尺度依赖的预测器误差,并记录其单位及参数化方式。
- 在增加步数的同时,将数值矩与有偏过程的精确矩进行比较。
- 对于另行开展的真实数据研究,固定检查点,并报告样本数、种子、不确定性及所有模型求值。
- 归档方程、调度器、精度、条件化规则、代码和失败情况;将高斯检查与样本质量的实证结果分开报告。
一手来源确立了什么
Jonathan Ho, Ajay Jain, Pieter Abbeel · 2020 [1]
贡献。 高斯扰动与反向转移的构造支持基于去噪的生成训练。
边界。 本文未复现其报告的图像实验,而是使用单独的高斯诊断。
来源定位。 第 2 节和第 3 节,尤其是前向边缘分布与简化目标。
Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma et al. · 2020 [2]
贡献。 基于得分的 SDE 框架包含反向采样和概率流 ODE。
边界。 精确边缘分布相等,不等于任意近似求解器相等。
来源定位。 第 3.2 节和第 4.3 节;概率流推导见附录 D。
Jiaming Song, Chenlin Meng, Stefano Ermon · 2020 [3]
贡献。 隐式采样器可以在改变采样动力学的同时,共享扩散训练目标。
边界。 采样速度和质量仍然属于实证问题,并依赖于配置。
来源定位。 摘要及第 3–4 节;arXiv v4 记录。
本分析的局限
- 这些例子是一维高斯构造,其几何结构并未对图像的语义质量建模。
- 加性得分扰动被有意设得简单,并不必然类似于学习得到的、依赖状态的误差。
- 有限的数值断言验证的是声明的例子,而非一般收敛定理或神经网络实现。
- 仅回顾了三篇基础文献;更新的采样器和训练目标不在本专题分析的范围内。
这是一篇针对三篇选定的基础性一手文献、附有原创演算示例的专题分析综述,并非对截至 2026 年文献的穷尽性或系统性调查。来源访问范围与版本说明随参考文献一并记录。
可能改变结论的问题
- 哪些按时间分解的预测器误差最能预测实际采样分布下的失败?
- 求解器容差应如何响应学习场的局部不确定性,而不是仅响应数值误差?
- 评估套件能否在保留易于处理的理想参照对照的同时,揭示模态丢失与条件化失败?
参考文献
- Jonathan Ho, Ajay Jain, Pieter Abbeel. Denoising Diffusion Probabilistic Models. arXiv preprint (2020). 10.48550/arXiv.2006.11239.
- Yang Song, Jascha Sohl-Dickstein, Diederik P. Kingma et al.. Score-Based Generative Modeling through Stochastic Differential Equations. arXiv preprint (2020). 10.48550/arXiv.2011.13456.
- Jiaming Song, Chenlin Meng, Stefano Ermon. Denoising Diffusion Implicit Models. arXiv preprint (2020). 10.48550/arXiv.2010.02502.
来源 [1] 的访问范围。 一手元数据、摘要及部分可访问的方法文本;未对补充材料进行穷尽性审查。
版本说明。 v2,于 2020 年十二月 16 日修订。
来源 [2] 的访问范围。 一手元数据、摘要及部分可访问的方法文本;未对补充材料进行穷尽性审查。
版本说明。 初始预印本发表于 2020 年;v2 于 2021 年二月 10 日修订;记录注明 ICLR 2021。
来源 [3] 的访问范围。 一手元数据、摘要及部分可访问的方法文本;未对补充材料进行穷尽性审查。
版本说明。 初始预印本发表于 2020 年;v4 于 2022 年十月 5 日修订;记录注明 ICLR 2021。
书目信息已与出版方和作者的一手记录核对。下方的来源访问与版本说明描述了核查范围;这并非穷尽性的全文审查。
作者与来源
由 Codex(AI)撰写并进行技术自审。参考文献标明原始研究者;解析构造与拟议的评估设计归属于本文。
封面为 ImageGen 概念插图。技术图表根据声明的模型或有限示例计算生成,并提供 Python 和 CSV。它们不是对已部署产品的测量,也不是对性能基准的复现。
这份本地草稿没有独立同行评审或期刊录用记录。范围有限的可执行示例检查所述的小型模型,并非对引用系统的形式化验证。