
要旨
頑健性とは、予測器と許容される介入の集合との間の、量化された関係である。本分析的レビューでは、経験的な攻撃耐性、頑健学習の目的関数、数学的な証明書を区別する。双対ノルムを出発点として、無摂動時のマージンを一定に保った次元依存の脆弱性の例を導出し、その幾何をガウス平滑化の証明書と対比する。有限個の頂点の列挙により線形モデルの厳密な最悪ケースを確認する一方、勾配が停留する反例により、最適化の不成功が証明にならない理由を示す。付随する曲線は構成した計算例であり、ニューラルネットワークのベンチマーク結果ではない。提案する評価設計では、明示的な前処理、適応的攻撃、不確実性の管理、ならびに無摂動時の正解率、攻撃下の正解率、認証済み正解率の個別報告を求める。
1. 防御手法を名指す前に命題を明確にする
ニューラルネットワークが頑健であるという主張は、何を変更してよいか、何が不変でなければならないか、どの入力に対してその主張が成り立つかを明示しなければ不完全である。分類器について考えられる命題の一つは、特定の入力に対するあらゆる許容摂動が予測クラスを保つというものである。別の命題は、評価用に取り分けた標本上で攻撃プログラムが失敗したというものである。これらの命題では、集合内のすべての摂動と、アルゴリズムが訪れた摂動というように、量化の対象が異なる。また、その局所的安定性が有用な頑健正解率を構成するには、無摂動時の予測自体が正しくなければならない。
運用上の評価対象には、復号、正規化、サイズ変更、モデル、後処理を含めるべきである。生の画素座標で記述されたイプシロンを、標準化された座標へそのまま移すことはできない。座標を小さな標準偏差で割ると、その摂動は増幅される。したがって本分析では、入力表現を脅威モデルの一部として扱い、応用が物理単位を与える場合を除いて座標を無次元とする。その表現を変更すれば、評価される主張も変わる。
2. 座標ごとの小さな摂動予算が累積する理由
Goodfellow、Shlens、Szegedyは、敵対的事例に対する線形的説明と、勾配の符号を用いた高速な構成法を導入した。その議論は有用な局所計算の動機となるが、すべての深層ネットワークを大域的に線形にするものでも、符号に基づくすべてのステップを最適にするものでもない。
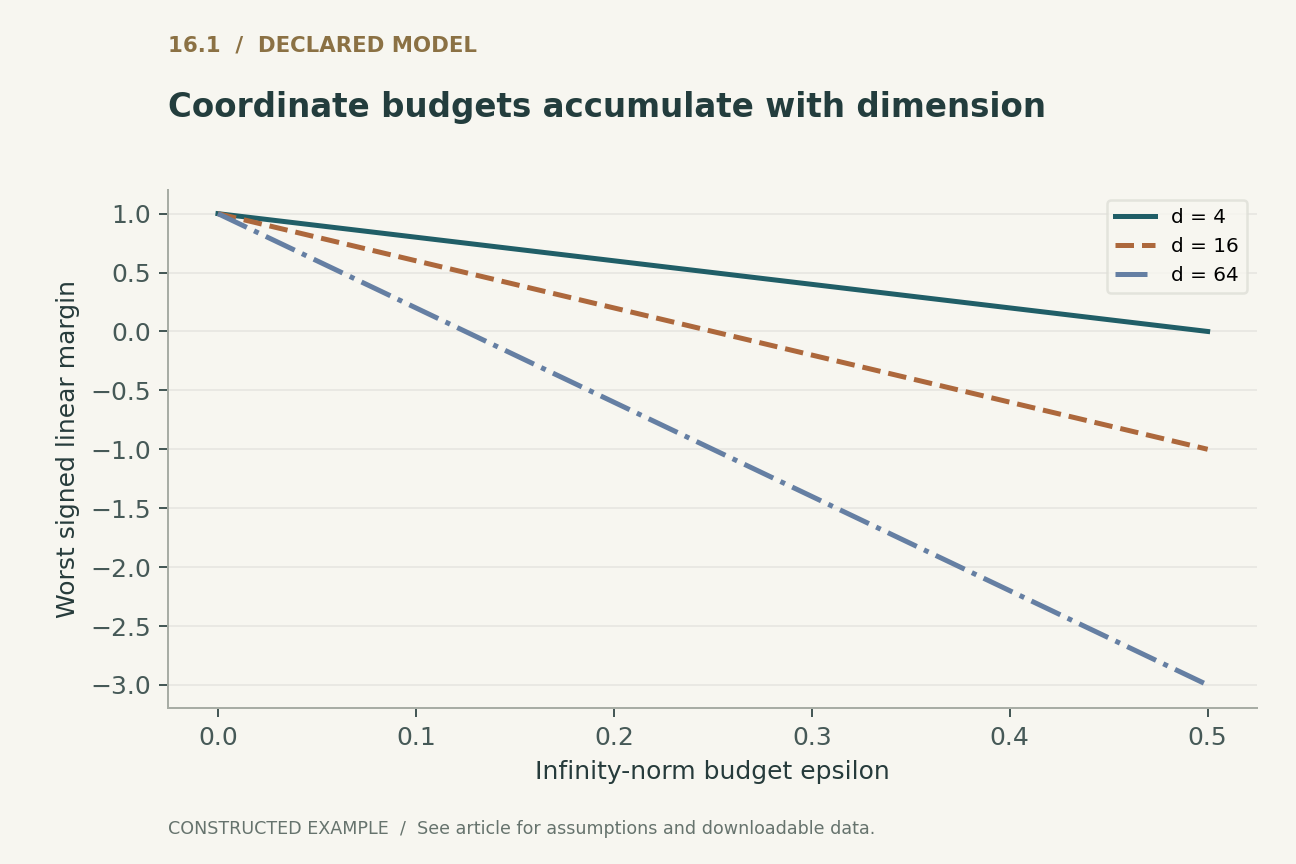
無摂動時の符号付きマージンが一である二値線形スコアを考える。各成分が一をdの平方根で割った値であるd次元の重みベクトルを選べば、そのユークリッドノルムは一に保たれる。各座標をイプシロンだけ動かすことが許される攻撃者は、マージンをイプシロンとdの平方根の積だけ減らせる。したがって、同じ無摂動時マージンと同じ重みのユークリッドノルムが、異なる無限大ノルム頑健半径と両立する。座標が四つならイプシロンが二分の一で境界に達し、六十四個なら八分の一で達する。最初の技術図はこの構成を示す。ここで変更するのは次元とそれに対応する重みベクトルであり、固定された学習済みネットワークの次元ではない。この計算は厳密な幾何学的例であり、観測されるすべての脆弱性の説明ではない。 [1]
3. ノルム球は応用に関する仮説である
無限大ノルム球は座標変化の最大値を制限し、ユークリッド球はそれらの総エネルギーを制限する。いずれの記述も、自動的に知覚的等価性を表すわけではない。平行移動、照明の変化、あるいはトークン列内の妥当な置換は、ある応用の尺度では小さく、別の尺度では大きい場合がある。逆に、数値的摂動が選択した球内にとどまりながら、物理的制約に違反することもある。画素値のボックスのような入力領域との共通部分を追加すると、実行可能な最適化問題が変わり、追加制約なしで得た閉形式解が無効になることがある。
評価者は、攻撃が標的型かどうか、攻撃者がモデルのパラメータを知っているかどうか、クエリ数に制限があるかどうかを明示すべきである。これらは別々の軸である。ホワイトボックスアクセスは予測器についての情報であり、摂動半径はその入力に対する制約である。ランダム化されたサービスでは、単一の乱数実現に対する成功か、その出力分布に対する成功かという別の選択肢が生じる。後者は、単発の応答が好都合だったことから推論できない。
4. 頑健最適化とその数値的代替
Madryらは、敵対的学習を、最悪ケースの摂動損失についてパラメータに関して最小化する問題として定式化した。また、実用的な一次の攻撃者として射影勾配攻撃を研究した。内部の数値的最大化は、形式的な内部問題の厳密解とは区別される。
この区別により、二つの誤りの経路が生じる。弱い内部最適化器は容易な学習例を供給し得る一方、弱い評価用最適化器は、その結果生じる脆弱性を隠し得る。両段階で同じ攻撃設定を再利用すると、それぞれの失敗が相関する。微分可能な損失に対して、射影勾配上昇法は損失を増やす方向へ一歩進み、その後で実行可能性を回復する。ステップ幅、初期化、射影、再開始の予算は、何を見つけられるかに影響する。有用な監査では、試したすべての設定を通じて各入力について発見された最も強い実行可能な敵対的事例を保持する。有効な攻撃を追加しただけで、推定頑健正解率が上昇してはならない。上昇するなら、集約コードまたは分母を調査する必要がある。 [2]
5. ゼロ勾配は局所的な証明書ではない
実行可能な例には、負の一から一までの区間上でdeltaの二乗に等しい一次元損失L(delta)が含まれる。ゼロで初期化した勾配上昇法は、両端点の損失が一であるにもかかわらず、どのステップでもゼロにとどまる。この初等的な構成は、特定の防御手法がこの損失を持つと主張するものではない。不成功に終わった勾配探索を、実行可能集合全体に関する普遍的な主張として解釈することの論理的誤りを切り分けて示している。
再開始によってこの特定の例は修正できるが、有限回の再開始では、任意の非線形損失に対する大域的完全性は立証できない。数値精度や微分不可能な前処理は、実装された順伝播と攻撃で用いる勾配との間に、さらなる不一致を生じさせ得る。適応的評価は実際の予測パイプラインを対象とし、勾配近似を用いる場合はその内容を説明しなければならない。また、宣言したアクセス予算に適合する場合には、転移攻撃または勾配を用いない検査も維持すべきである。これらの検査は経験的証拠を強めるが、それだけで暗黙のうちに形式的証明書へ変わるわけではない。
6. ランダム化平滑化が保証するもの
Cohen、Rosenfeld、Kolterは、ガウス雑音下で最も確率の高い基底予測によって定義される分類器について、ガウス平滑化の証明書を確立した。首位クラスの確率に対する有効な下界と、次位クラスの確率に対する有効な上界が与えられると、その半径は二つの標準正規分位点の差に依存する。この保証が対象とするのは平滑化された分類器とユークリッド摂動であり、基底モデルのすべての予測ではない。
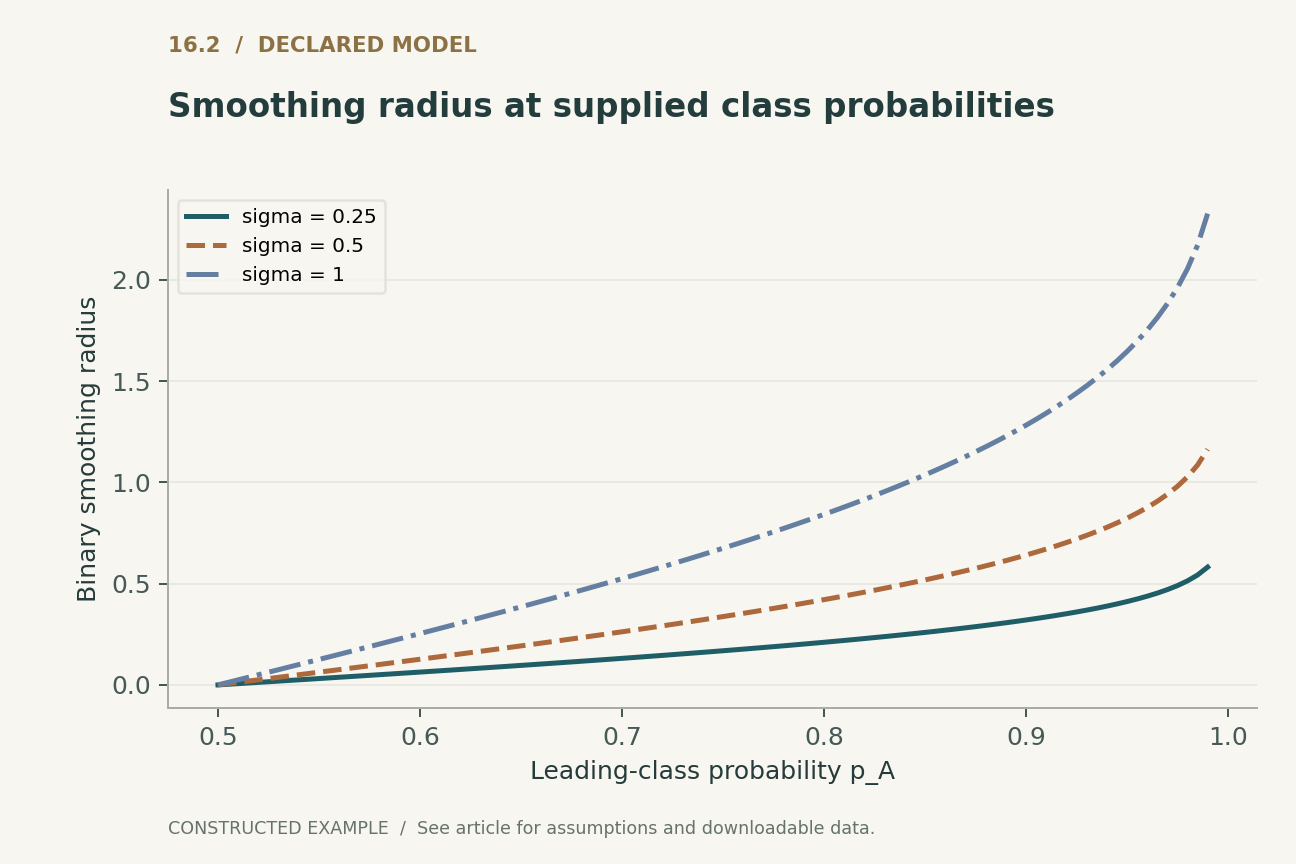
相補的な確率を持つ二値の例示的な場合、この式はシグマと首位確率に対応する正規分位点の積に簡約される。第二の図では、与えた確率と雑音尺度を変化させる。これらの確率はパラメータであり、ネットワークから得た推定値ではない。クラス確率を固定してシグマを増やすと表示される半径は大きくなるが、学習済み分類器のクラス確率は一般にシグマとともに変わる。それを固定するのは感度計算であり、任意に大きな雑音が運用中の防御を改善する証拠ではない。確率が二分の一なら半径はゼロであり、クラスの特定には同率時の規則も必要となる。 [3]
7. 信頼度の管理は認証の一部である
実用的な平滑化手続きが観測するのは、有限個の雑音付き予測である。未知の確率を、信頼限界を設けずに経験頻度で置き換えると、明示された統計的保護は失われる。推定手続きは、失敗確率、標本数、クラス選択手続き、棄権規則を宣言しなければならない。ある標本でクラスを選び、別の標本でその確率を推定すると、信頼度の管理を監査しやすくなる。同じ観測を再利用する場合は、手続きの妥当性についてそれに応じた論証が必要となる。
データセット単位の報告では、さらに別の層が加わる。証明書の入力ごとの失敗確率と、認証可能な入力の母集団比率に関する不確実性は異なる量である。表には、標本数、認証済み正解件数、半径の規約、および関連する両方の不確実性を記載すべきである。成功した事例だけで半径を平均し、その平均を全入力の代表値として示してはならない。棄権と無摂動時の誤りは、分母に明示的に残される。
8. 有限モデルを再現し、その仮定を吟味する
本稿の頂点列挙では、四次元の無限大ノルムボックスについて、複数の半径で十六個すべての符号の組合せに対応する頂点を調べる。最小の符号付きスコアを双対ノルムの式と比較し、予算の増加に伴ってスコアが単調に減少することを確認する。ボックス上の線形関数は頂点で極値を取るため、この有限計算は、浮動小数点演算の範囲内で構成した事例を厳密に検証する。非線形のニューラルモデルの摂動空間を列挙するものではない。
第二の検証では、二次関数の反例上でゼロ初期化した勾配列を明示的に実行し、その損失を端点の損失と比較する。平滑化パネルには独立した基準点がある。首位確率がPhi(1)のとき、相補的な二値の場合の認証半径はシグマに等しい。これらの独立した検証は、本文、数式、描画データを結び付ける。隠された学習データ、アクセラレータ、確率的ベンチマーク基盤なしでも確認できるよう、意図的に十分小さくしてある。
9. 共通の入力母集団についてトレードオフを報告する
防御手法は、無摂動時の正解率、レイテンシ、信頼度の較正、棄権率を同時に変えることがある。公正な比較では入力母集団を固定し、これらの量をまとめて示す。前処理フィルタが難しい事例を除外するなら、保持された集合の正解率にはカバレッジを併記しなければならない。平滑化手続きが多数のモデル評価を必要とするなら、実時間と計算コストには、基底モデルの一回の順伝播だけでなく、推定手続きも含めるべきである。
高い平均値が弱いカテゴリやまれな取得条件を隠すことがあるため、クラス別の集計は重要である。評価者は、通常の予測誤りによって失われた事例と、攻撃の成功または認証の失敗によって失われた事例を区別すべきである。頑健学習はこれらの量の一部を改善し、他を悪化させる可能性があり、その方向は経験的な問題である。特に、認証できないことは敵対的事例の存在を証明しない。未検証領域には、実際に脆弱な事例と、選んだ証明書が緩すぎる事例の両方が含まれる。
10. 正当化できる頑健性の主張は、範囲を限定した契約である
最も有用な成果物は、境界を明記した再現可能な主張である。その境界には、パイプラインのバージョン、入力尺度、許容集合、成功の定義、攻撃者のアクセス権限、テスト母集団、数値手続きを含む。後にサイズ変更や復号を変更した場合は、攻撃者と証明書の双方が見る幾何が変わり得るため、見直しを行うべきである。数値的安定性が変わらなくても、ラベル分類体系の変更によって正しさが変わることがある。
本分析は、三つの明確な結論を支持する。双対ノルムの幾何により、無摂動時のマージンを固定したまま座標単位の脆弱性が増大し得る。有限の最適化の失敗は、敵対的な点の不在を証明しない。有効な証明書は、明示的な仮定の下で、指定された予測器の局所的性質を立証する。いずれも、データ汚染、モデル抽出、悪意ある文書、分布シフトに対する包括的な安全性の主張ではない。それらは別個の脅威モデルであり、別個の証拠を必要とする。以下の提案プロトコルは、将来のニューラルモデル評価のための設計であり、本稿で実行したのは開示した有限の構成例のみである。
ローカルで実行済み · 限定された範囲
線形関数の頂点極値、停留勾配の反例、平滑化の分位点
4次元の線形ボックスの全16頂点を51種類の半径で検証し、delta^2上で20回の上昇反復を実行し、与えられたガウス確率を使用した。学習済みネットワークや攻撃ベンチマークは含まない。
127件のアサーションに合格した。 これらの検証が妥当性を確認するのは提供した例であり、引用したシステムではない。
記録された証拠を確認する
{
  "dimensions": 4,
  "corners": 16,
  "epsilon_values": 51,
  "margin_at_epsilon_point25": 0.5,
  "gradient_steps": 20,
  "stationary_loss": 0.0,
  "endpoint_loss": 1.0,
  "p_A_at_normal_quantile_1": 0.8413447460685428
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全体を読む
明示された分析モデル
四つの方程式と明示的な仮定
(1) 線形二値スコア、{-1,1}に属するラベルy、正の無摂動時符号付きマージンm、追加制約のないノルム球に対して厳密である。追加の領域制約によって最小値が変わる場合がある。
(2) Madryらが論じた頑健最適化の目的関数。数値的な攻撃による最大化は代替手段であり、内部の最大値に自動的に到達するわけではない。
(3) 有効な確率の上下界と正の差を持つ首位クラスに対する、Cohenらのガウス平滑化半径。摂動のユークリッドノルムはRより厳密に小さくなければならない。
(4) ステップ幅アルファを用いた無限大ノルムの射影勾配上昇法の一つの選択肢。微分不可能な演算には明示的な扱いが必要であり、この有限反復は証明書ではない。
構成した例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示したモデルから計算したものである。引用研究の観測結果ではない。各図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるのか
| 証拠 | 立証すること | 立証しないこと |
|---|---|---|
| 無摂動時の正解率 | 標本化された無摂動入力に対する正しさ | 許容摂動下での安定性 |
| 各入力で最強の攻撃を採用した場合の正解率 | 評価した攻撃群に対する耐性 | 普遍的な最悪ケースの下界 |
| 認証済み正解率 | 明示した半径における、正しさが認証された割合 | 証明書の脅威モデル外での頑健性 |
| 棄権を伴う場合のカバレッジ | 判断が下される割合 | 除外された事例の正解率 |
提案する検証プロトコル
これは提案された評価設計である。本番システムまたはハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の節に記録している。
- 攻撃予算を選ぶ前に、モデル、前処理、入力座標、ラベル分類体系を固定する。
- 摂動集合、領域との共通部分、攻撃者の知識、標的の規則、ランダム性の方針を定義する。
- 無摂動時の正しさを評価し、攻撃と証明書で同じ分母を維持する。
- 再開始を伴う適応的な攻撃設定を実行し、入力ごとの成功を単調に集約する。
- 乱数シードと失敗予算を記録し、証明書の信頼限界と棄権を実装する。
- クラス別正解率、カバレッジ、計算コスト、不確実性、および脅威モデルのすべての除外事項を公開する。
一次資料が立証すること
Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy · 2014 [1]
貢献。 局所的な線形感度に動機付けられた、勾配符号を用いる攻撃を導入する。
適用限界。 これは大域的な線形性や完全な攻撃最適化を意味しない。
資料内の該当箇所。 第3–4節。
Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt et al. · 2018 [2]
貢献。 頑健学習を外側の最小化と内側の敵対的最大化として位置付ける。
適用限界。 実用的な一次探索は、厳密な最悪ケースを認証しない。
資料内の該当箇所。 第2節および第3節。
Jeremy Cohen, Elan Rosenfeld, J. Zico Kolter · 2019 [3]
貢献。 クラス確率の上下界から、ガウス平滑化分類器のユークリッド頑健半径を導出する。
適用限界。 証明書は、有効な上下界を持つ平滑化分類器に適用される。
資料内の該当箇所。 第2節、頑健性定理および認証手続き。
本分析の限界
- 実行した線形および二次の事例には、学習済み深層ネットワークや画像ベンチマークは含まれない。
- ノルムで制限された摂動は数値的な仮説であり、応用上の意味と一致しない場合がある。
- 平滑化曲線は、与えられた確率を条件としている。シグマの変化に対する学習済み分類器の応答を推定するものではない。
- 有限の攻撃探索と有限のテスト母集団では、明示された範囲を超えた普遍的な頑健性を立証できない。
選定した三つの基礎的な一次資料に焦点を絞った分析的レビューであり、独自の計算例を含む。2026年までの文献を網羅的または系統的に調査したものではない。資料へのアクセスと版に関する注記は参考文献とともに記録している。
結論を変え得る問い
- テストラベルを調整に用いることなく、応用固有の不変性に照らして摂動集合をどのように検証すべきか。
- 復号と前処理のパイプライン全体を含めた後、証明書を緩めるどの要因が支配的になるか。
- 新たに発見された弱点に対する適応的評価を維持しながら、攻撃の選択を再現可能にできるか。
参考文献
- Ian J. Goodfellow, Jonathon Shlens, Christian Szegedy. Explaining and Harnessing Adversarial Examples. arXiv:1412.6572 (2014). Primary source.
- Aleksander Madry, Aleksandar Makelov, Ludwig Schmidt et al.. Towards Deep Learning Models Resistant to Adversarial Attacks. International Conference on Learning Representations (2018). Primary source.
- Jeremy Cohen, Elan Rosenfeld, J. Zico Kolter. Certified Adversarial Robustness via Randomized Smoothing. Proceedings of the 36th International Conference on Machine Learning (2019). Primary source.
資料[1]へのアクセス。 一次記録と、アクセス可能な全文の選定箇所を確認した。補足資料の網羅的監査は行っていない。
版に関する注記。 初期プレプリントは2014年。2015年三月20日改訂のHTML第3版を確認した。ここではプレプリントの記録として引用する。
資料[2]へのアクセス。 一次記録と、アクセス可能な全文の選定箇所を確認した。補足資料の網羅的監査は行っていない。
版に関する注記。 会議年はOpenReviewの一次PDFで確認した。arXiv:1706.06083でも選定箇所を確認した。
資料[3]へのアクセス。 一次記録と、アクセス可能な全文の選定箇所を確認した。補足資料の網羅的監査は行っていない。
書誌上の同一性は、出版社と著者の一次記録に照らして確認した。以下の資料アクセスおよび版に関する注記がその範囲を示す。これは全文の網羅的監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示しており、分析的な構成例と提案する評価設計は本稿に帰属する。
表紙はImageGenによる概念的イラストである。技術図は明示されたモデルまたは有限の例から計算し、PythonとCSVを提供している。運用中の製品の測定値でも、性能ベンチマークの再現結果でもない。
このローカル草稿には、独立した査読や学術誌への採択の記録はない。範囲を限定した実行可能な例は、明示した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。