
要旨
深層分類器は、正確でありながら過信していることも、較正されていながら情報をもたないことも、集約レベルでは十分に較正されていながら部分集団を誤導することもある。本稿は、明示的な母集団の構成を通じて、これらの区別を展開する。二群のベルヌーイモデルによって、不可約な不確実性と回避可能な確率誤差を分離し、較正された定数予測が意思決定上の価値を失う仕組みを示す。温度スケーリングと多クラス較正を、この意思決定理論的な分析の中に位置づけ、ビン分割、有限標本の不確実性、運用時の分布シフトに注意を払う。小規模母集団の厳密な列挙により、較正、Brier損失、ベイズ行動のコストを検証する。提案するニューラルモデルのプロトコルは、これらの実行済みの例とは区別され、新たな較正ベンチマークを主張するものではない。
1. 確率は反復される結果についての主張である
確率予測が有用なのは、結果によってコストが異なる意思決定を支援するからである。その解釈には、したがって順位付けスコアよりも厳しい要件が課される。確率五分の一を割り当てられた事例で、系統的に五分の二の頻度で事象が生じるなら、分類器が多くの事例を正しく順位付けしていても、その予測に基づく下流の閾値は誤りうる。較正が問うのは、予測値と条件付きの結果頻度とのこの対応である。
条件付けに用いうる事象は複数ある。特定クラスの確率、選択されたクラスの確信度、予測ベクトル全体、あるいはそれらのいずれかにおける部分集団を調べることができる。これらの評価は互換的ではない。本稿の構成では、すべての量を厳密に計算できるよう、二値事象の確率を用いる。同じ論理的区別は深層多クラス予測器にも重要であるが、スカラー曲線によって完全な確率ベクトルを保証することはできない。指標を選ぶ前に、条件付け情報と意思決定での用途を明記すべきである。
2. スカラー補正には固有の表現上の限界がある
Guoらは現代のニューラルネットワークの較正を研究し、softmaxの適用前にすべてのロジットを単一の正のパラメータで再スケーリングする温度スケーリングを評価している。報告された有効性は、簡便な後処理のベースラインを採用する動機となる。しかし、単一の温度があらゆるネットワークや分布を修正するという定理ではない。
共通の正の温度は、同順位を含めてロジットの順序を保持する。したがって、決定論的な最上位クラスの選択規則を変えずに確信度を変える。順位付けを信頼でき、確信度の歪みがおおむね共通のスケールで表される場合、これは有用である。一方で、系統的なクラスの入れ替わりを修復したり、欠落した特徴を追加したり、同一のロジットをもつ二つの入力に異なる補正を割り当てたりすることはできない。ある部分集団には大きな補正が必要で、別の部分集団には小さな補正が必要なら、単一の温度の当てはめは両者の妥協となる。ホールドアウトデータ上の較正目的関数はその妥協を選好しても、特定の運用上の意思決定は依然として不良でありうる。したがって温度は誤差パターンのモデルであり、信頼性を普遍的に切り替えるスイッチではない。 [1]
3. 集約レベルでの完全な較正は有用な構造を隠しうる
出現頻度が等しい二群を構成する。群Aでは事象確率を十分の一、群Bでは十分の九とする。常に二分の一を報告する予測器は、統合された母集団では完全に較正されている。二分の一を付与された全事例のうち、半数で事象が生じるからである。しかし、この予測器は群の情報を無視する。真の二つの条件付き確率を報告する予測器も較正されており、誤りのコストが等しい場合には、はるかに優れた分類を支援する。
定数予測は、較正だけでは分解能が評価されない理由を示す。また、母集団レベルの主張が厳密であっても、部分集団では較正が不適切でありうる理由も示す。群A内では、二分の一という確率予測は十分の四だけ過大評価し、群B内では同じ量だけ過小評価する。誤差が相殺されるのは集約後だけである。この構成は意図的に明快にしている。現実の人口統計学的集団がこれらの事象率をもつと述べるものでも、特定の保護属性を利用することが自動的に適切であると述べるものでもない。
4. 適正スコアリングは情報を較正の標語から切り分ける
真の条件付き確率がqであるベルヌーイ結果について、予測pにおける期待二乗確率損失は、qと一からqを引いた値との積に、pとqの差の二乗を加えたものに等しい。二乗を展開すれば、この恒等式が直接得られる。第一項は結果の不可約な条件付き変動であり、第二項は不正確な確率による回避可能なコストである。この局所的な恒等式は、ニューラルアーキテクチャに関する仮定を必要としない。
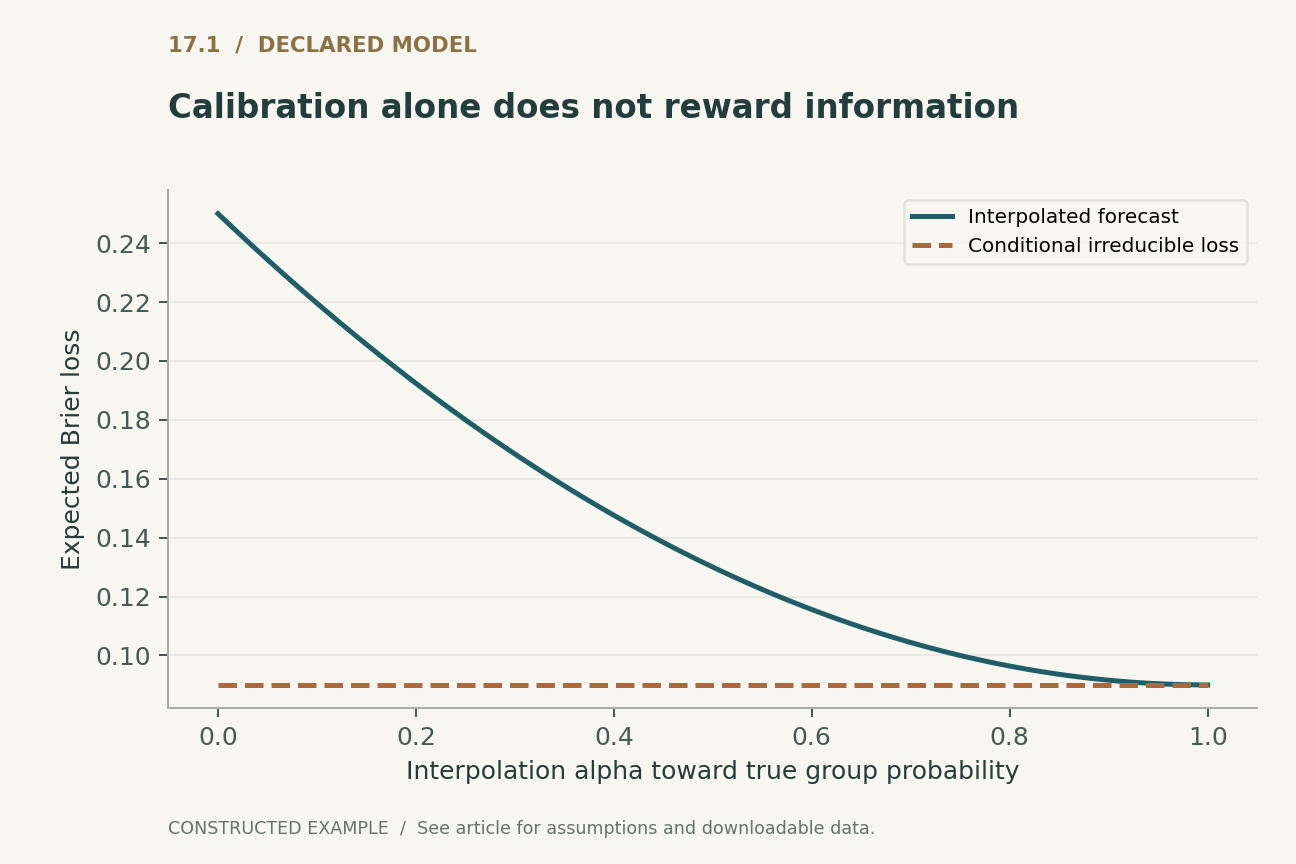
本稿の二群の例では、不可約項は両群とも百分の九である。二分の一という定数予測は百分の十六を上乗せし、Brier損失は四分の一となる。情報をもつ真の確率予測は百分の九を達成する。これらの予測間を補間すると第一の図が得られる。定数側の端点はすでに集約レベルで較正されているにもかかわらず、曲線は滑らかに低下する。したがって、報告には較正と適正スコアの両方を含めることができ、どちらかを冗長とみなす必要はない。対数スコアリングは、自信をもって誤る端点付近でより強いペナルティを加えるが、厳密なゼロの扱いには注意が必要である。
5. ビン分割は測定対象の誤差を消し去りうる
Vaicenaviciusらは較正評価のための確率論的枠組みを展開し、スカラー要約が混同しうる条件付けの概念を区別している。その分析は、評価統計量を特定の対象をもつ測定手続きとして扱うことを支持する。
本稿の例はこの問題を具体化する。母集団の半分に予測事象確率四分の一と結果頻度二分の一を与え、残り半分には確率四分の三と、同じく二分の一の結果頻度を与える。予測ビンを分けると、各群で四分の一の絶対確率誤差が明らかになる。これらを一つのビンに統合すると、平均予測も平均結果も二分の一となり、不一致が完全に隠れる。これは確率較正の例示であり、通常の最高確信度に対するECEは異なる変数に適用される。有限標本は別の複雑さを加える。真に較正されていても、観測されたビン誤差は変動する。ビンを増やせば分解能は高まるが、各ビンの観測数は減る。ビン分割と標本サイズを明示しない単一の低いECEだけでは、母集団の性質を確立できない。 [2]
6. 意思決定の閾値はコストから導かれる
行動一は事象が存在しないときにコストC_FPを、行動ゼロは事象が存在するときにコストC_FNを生じるとする。pが、利用する情報を条件とした真の事象確率であるなら、期待コストはそれぞれC_FPと一からpを引いた値との積、およびC_FNとpとの積である。pがC_FPを両コストの和で割った値を超えるとき、行動一を選ぶ。同値の場合はいずれの行動を選んでも期待コストは変わらない。
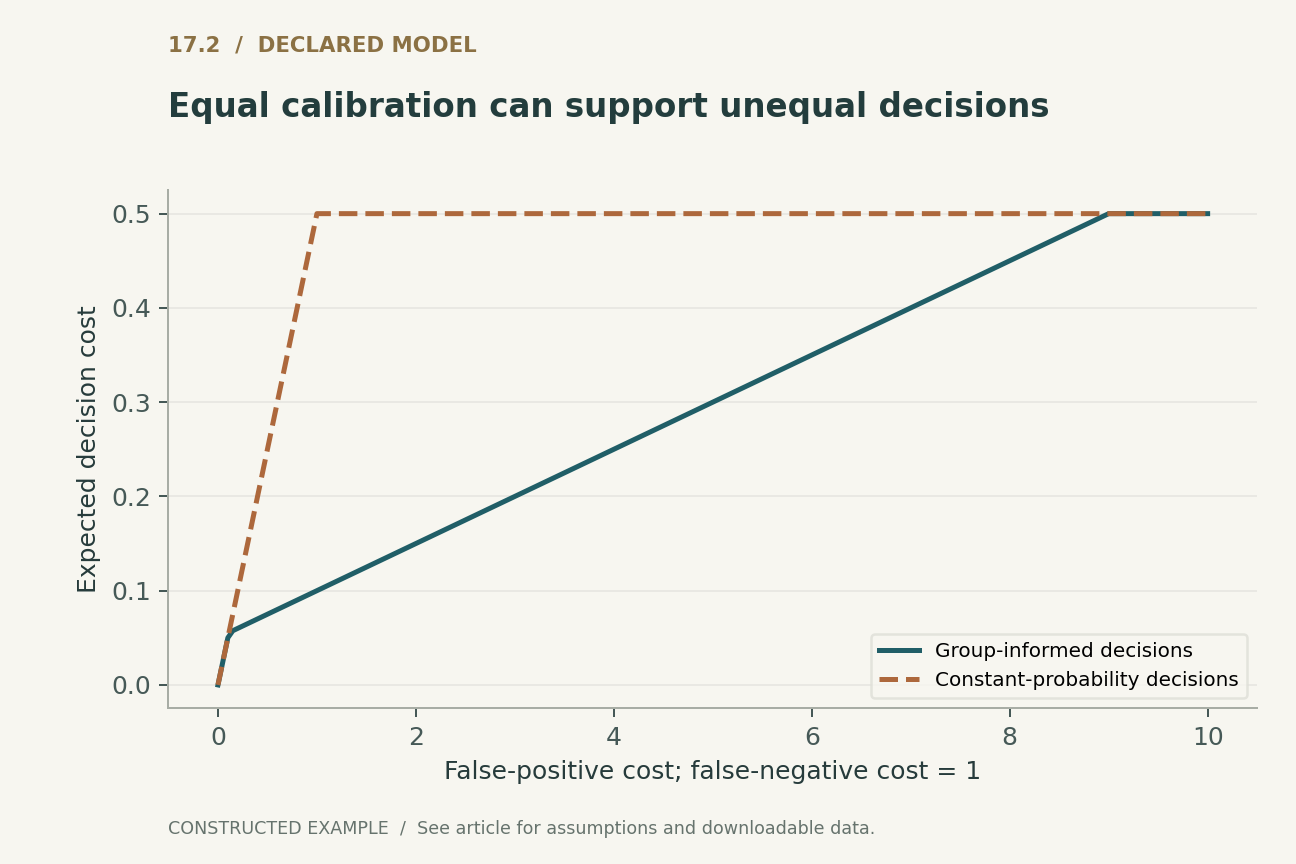
コストが等しい場合、定数予測は本稿の二群を区別できず、二分の一の誤り率を生じる。条件付き確率を用いると、誤り率は十分の一となる。第二の図では、偽陰性コストを一に固定し、偽陽性コストを変化させる。定数の情報集合に基づく意思決定と、群の情報に基づく意思決定を比較する。どちらの予測も、それぞれが明らかにする情報に対して較正されているが、達成可能なコストは異なる。これは情報の比較であり、特定のニューラル較正器がそのような改善を達成する証拠ではない。
7. 多クラスの柔軟性には推定コストが伴う
Kullらは、対数確率を学習された線形写像とsoftmaxによって変換するDirichlet較正を導入している。単一の温度と比べ、これはクラス固有の補正と確率の各成分間の相互作用を可能にする。この研究は多クラス較正法を提示するものであり、柔軟性の追加がホールドアウトデータ上の信頼性を常に改善するという保証ではない。
追加のパラメータは通常の推定問題を生む。小さな較正集合では希少クラスに対する有用な補正を同定できないことがあり、制約のない柔軟性は標本ノイズに適合しうる。そのため、正則化、クラスごとの標本数、独立した評価データは手法の記述に含めるべきである。最大確率のクラスを変更すると、分類は改善することも悪化することもある。共通の正の温度とは異なり、一般の写像は順位を保持するとは限らない。意思決定が変わらないと仮定していた下流のワークフローは、すべて再検証しなければならない。較正の学習もテスト集合上での反復的な調整から切り離すべきである。最終的な信頼性図に用いるのと同じ事例で写像を選択すると、見かけの結果にバイアスが生じるからである。 [3]
8. 選択と分布シフトは対象となる母集団を変える
確率の主張は母集団に依存する。サービスが低確信度の事例を人間に回す場合、残された事例の分布は元のテスト集合とは異なる。報告スコアだけを条件とする較正は、そのスコアだけで決まる選択のもとでも維持される。ただし、選択機構が結果に関する追加情報を導入しないことが条件である。モデル化されていない部分集団、取得経路、隠れた難易度の信号も使う選択のもとでは、較正が維持されるとは限らない。選択規則を明示すれば、この区別を検証可能にできる。
クラスの出現割合の変化も、固定されたスコアの解釈を変えうる。入力シフトが検出されるたびに再較正することが自動的に正当化されるわけではない。入力の変化が結果の条件付き生成機構を変えるとは限らず、入力の変化がないこともラベルの変化を排除しない。運用記録では、分布の相違に関する警報と、確率誤差の証拠を区別すべきである。遅れて得られるラベル、欠測した結果、選択的なフィードバックは、その証拠を複雑にするため、信頼性ダッシュボード上で可視化し続けるべきである。
9. 実行済みの有限例による検証が示すこと
付属コードは、等しい重みをもつ二十事例を表現する。構成した各群に十事例があり、陽性結果はそれぞれ一例と九例である。定数予測の集約レベルでの較正、部分集団での不一致、および定数予測と情報をもつ予測の厳密なBrier損失を検証する。別のビン統合例では、より粗いグループ化が誤差統計量を抑制しうることを検証する。すべての頻度は意図的に設定されており、外部データセットからの推定値ではない。
コストを走査する際には、厳密な条件付き期待値により、各情報群で独立に低コストの行動を選択する。検証では、選択したコストにおいて、これらの意思決定を有限の結果の直接列挙と比較する。温度の検証では、同順位のない代表的なロジットと正の温度について、順序の保持を確認する。これらのテストは、代数、実装、図の不整合を検出する。しかし、実際の利用者に対する較正を検証したり、後処理手法が有限の検証集合から汎化することを実証したりはできない。後者の主張には、提案したホールドアウト研究が必要である。
10. 意思決定と不確実性を中心に評価を構築する
実用的な較正報告は、解釈対象の出力確率と、それが情報を提供する意思決定から始めるべきである。そのうえで、適正スコアリング規則、信頼性に関する明示的な条件付け、不確実性区間、意思決定コストまたは根拠のあるコスト範囲を提示すべきである。棄権後のカバレッジとクラス別の標本数は、主要指標と並べて示す必要がある。較正写像の適用前後について、性能が悪化する事例も含め、同一のホールドアウト母集団を示せば、比較はより強固になる。
こうして得られる基準は厳しいが具体的である。集約レベルの較正は有用な制約であり、完全な目的ではない。柔軟な補正は誤指定された確率写像を改善しうるが、推定と評価は分離しなければならない。競合する二つの予測がいずれも較正に関する主張を満たす場合でも、より良い確率情報は意思決定コストを低減しうる。これらは、開示した構成によって支えられた解析的結論である。本稿は、取得ドメイン、クラスの出現割合、運用閾値をまたぐニューラル較正試験を提案するが、実施してはいない。
ローカルで実行済み · 限定された範囲
較正されているが情報をもたない母集団、ビン統合、コスト最適な行動
設定された有限の結果と母集団期待値。二値事象確率のビンを用い、多クラス確信度のECEではない。検証集合への当てはめも、実利用者の結果も含まない。
516件のアサーションに合格した。 これらの検証が妥当性を確認するのは提示した例であり、引用したシステムではない。
記録された検証証跡を確認する
{
  "cases": 20,
  "group_positive_counts": [
    1,
    9
  ],
  "constant_Brier": 0.25,
  "informed_Brier": 0.09,
  "coarse_probability_ECE": 0.0,
  "fine_probability_ECE": 0.25,
  "cost_at_equal_error_costs": {
    "pooled": 0.5,
    "informed": 0.1
  }
}
例の実行プログラム · モデルローダー · 学習モデル · 表現モデル · 生成モデル · 信頼性モデル検証結果の全文を読む
明示された解析モデル
四つの方程式と明示的な仮定
(1) 正の温度スケーリングはロジットの順序を保持する。温度は独立した較正データで当てはめ、未使用の事例で評価する。
(2) 二値のYに対する、母集団のビンベースの事象確率較正誤差。これは通常の選択クラス確信度のECEと自動的に同一になるわけではない。ビンは定義の一部である。
(3) pを固定し、Yを確率qのベルヌーイ変数とする。構成した群ではqは0.1または0.9であり、示した補間のもとでBrier損失は0.09+0.16(1-alpha)^2となる。
(4) 誤りのコストが非負で、その和が正である二値行動。pは意思決定に利用可能な情報に対する条件付き事象確率を表さなければならない。
構成された例 · 再現可能なデータ
定量的な議論を確認する
これらの曲線は、明示したモデルから計算したものである。引用研究の観測結果ではない。各図には数値データとベクトル版が付属する。


どの証拠がどの問いに答えるのか
| 評価 | 有用な問い | 盲点 |
|---|---|---|
| 最上位クラスの確信度 | この確信度において、選択されたクラスはどの程度の頻度で正しいか。 | 確率ベクトルの他の成分 |
| クラス別の信頼性 | 各クラスの確率は、その事象頻度に一致するか。 | 考えられるすべての同時条件または部分集団条件 |
| Brierスコアまたは対数スコア | 情報をもち正確な確率が評価されるか。 | どの部分集団が集約誤差を生んでいるか |
| 行動の期待コスト | その確率はこの意思決定を支えるか。 | 異なるコストを伴う他の意思決定 |
提案する検証プロトコル
これは提案段階の評価設計である。本番システムまたはハードウェアのベンチマークは実施していない。別途実行した有限モデルは、実行可能な検証の項に記録している。
- 確率の対象、行動空間、コスト範囲、運用対象母集団を固定する。
- モデル学習、較正の当てはめ、手法選択、最終評価に用いる事例を分離する。
- 未較正予測、正の温度によるベースライン、正則化した柔軟な写像を比較する。
- 適正スコアと信頼性曲線を、明示的なビン規則、標本数、不確実性とともに報告する。
- 棄権や希少クラスを隠さずに、部分集団と選択後母集団の信頼性を評価する。
- 事前指定した閾値のもとでコストとカバレッジを測定し、その後、実際にホールドアウトした分布シフトで繰り返す。
一次資料が明らかにすること
Chuan Guo, Geoff Pleiss, Yu Sun et al. · 2017 [1]
貢献。 ニューラルネットワークの較正不良と、後処理手法としての温度スケーリングを研究している。
適用上の限界。 経験的な有効性はデータセットに依存する。温度はクラスの順序を保持する。
資料内の参照箇所。 第2節および第4節、温度スケーリング。
Juozas Vaicenavicius, David Widmann, Carl Andersson et al. · 2019 [2]
貢献。 確率較正の異なる概念とその評価を形式化している。
適用上の限界。 スカラー要約は、すべての条件付け事象を特徴づけるものではない。
資料内の参照箇所。 較正の定義と評価に関する節。
Meelis Kull, Miquel Perello-Nieto, Markus Kängsepp et al. · 2019 [3]
貢献。 対数確率と線形変換・softmaxに基づく多クラス較正写像を導入している。
適用上の限界。 表現力の追加には、適切な当てはめと独立した評価が必要である。
資料内の参照箇所。 Dirichlet較正の定義とパラメータ化。
本分析の限界
- 二十事例の母集団は構成されたものであり、現実のいかなる部分集団についての証拠でもない。
- 厳密な母集団計算は、実際の較正研究が定量化しなければならない標本ノイズを回避している。
- 三つの基礎的資料は、現代の較正手法の網羅的な比較を構成しない。
- コストモデルは二値行動と既知のコストを仮定する。複雑な意思決定には、それ自体の効用モデルが必要である。
選定した三つの基礎的な一次資料に焦点を絞った解析的レビューであり、独自の計算例を含む。2026までの文献を網羅的または系統的に調査したものではない。資料へのアクセス状況と版に関する注記は、参考文献とともに記録している。
結論を変えうる問い
- 特定の下流意思決定には、どの較正の条件付け事象が必要か。
- 統計的不確実性を隠さずに、希少な群の信頼性をどのように推定できるか。
- 柔軟な多クラス写像は、どのような場合に、十分に当てはめたスカラー温度を上回って期待意思決定コストを改善するか。
参考文献
- Chuan Guo, Geoff Pleiss, Yu Sun et al.. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning (2017). Primary source.
- Juozas Vaicenavicius, David Widmann, Carl Andersson et al.. Evaluating model calibration in classification. Proceedings of the Twenty-Second International Conference on Artificial Intelligence and Statistics (2019). Primary source.
- Meelis Kull, Miquel Perello-Nieto, Markus Kängsepp et al.. Beyond temperature scaling: Obtaining well-calibrated multiclass probabilities with Dirichlet calibration. Advances in Neural Information Processing Systems 32 (2019). Primary source.
資料[1]へのアクセス。 一次記録と、アクセス可能な全文の一部の節を確認した。補足資料の網羅的な監査は行っていない。
資料[2]へのアクセス。 一次記録と、アクセス可能な全文の一部の節を確認した。補足資料の網羅的な監査は行っていない。
資料[3]へのアクセス。 一次記録と、アクセス可能な全文の一部の節を確認した。補足資料の網羅的な監査は行っていない。
書誌上の同一性は、出版社と著者の一次記録に照らして確認した。以下の資料へのアクセス状況と版に関する注記は、その範囲を示す。これは全文の網羅的な監査ではない。
著者と来歴
Codex(AI)が執筆し、技術的な自己レビューを行った。参考文献は元の研究者を明示する。解析的な構成と提案された評価設計は、本稿に帰属する。
表紙はImageGenによる概念的なイラストである。技術図は、明示したモデルまたは有限例から計算し、PythonとCSVを提供している。運用中の製品の測定値でも、再現された性能ベンチマークでもない。
このローカル草稿には、独立した査読や学術誌採択の記録はない。範囲を限定した実行可能な例は、記載した小規模モデルを検証するものであり、引用したシステムの形式検証ではない。