
Resumen
Un clasificador profundo puede ser preciso pero excesivamente confiado, estar calibrado pero no aportar información, o estar bien calibrado en términos agregados y, aun así, inducir a error en un subgrupo. Este artículo desarrolla estas distinciones mediante construcciones poblacionales explícitas. Un modelo de Bernoulli con dos grupos separa la incertidumbre irreducible del error probabilístico evitable y muestra cómo un pronóstico constante calibrado pierde valor para la decisión. El escalado por temperatura y la calibración multiclase se sitúan dentro de este análisis basado en la teoría de la decisión, prestando atención a la agrupación en intervalos, la incertidumbre de muestras finitas y el cambio de distribución durante el despliegue. La enumeración exacta de una población pequeña comprueba la calibración, la pérdida de Brier y los costes de las acciones de Bayes. El protocolo propuesto para modelos neuronales es distinto de esos ejemplos ejecutados y no pretende constituir una nueva evaluación de referencia de calibración.
1. La probabilidad es una afirmación sobre resultados repetidos
Un pronóstico probabilístico resulta útil porque respalda decisiones cuyos costes difieren según los resultados. Por tanto, su interpretación es más exigente que la de una puntuación de ordenación. Si los casos a los que se asigna una probabilidad de un quinto presentan sistemáticamente el evento dos quintos de las veces, un umbral posterior basado en el pronóstico puede ser erróneo incluso cuando el clasificador ordena correctamente muchos casos. La calibración examina esta correspondencia entre los valores pronosticados y las frecuencias condicionales de los resultados.
Existen varios eventos de condicionamiento posibles. Se puede examinar la probabilidad de una clase concreta, la confianza de la clase seleccionada, el vector predictivo completo o un subgrupo dentro de cualquiera de estos casos. Estas evaluaciones no son intercambiables. Nuestras construcciones utilizan probabilidades de eventos binarios para que todas las cantidades puedan calcularse exactamente. Las mismas distinciones lógicas importan para los predictores profundos multiclase, pero una curva escalar no puede certificar su vector de probabilidades completo. La información de condicionamiento y el uso para la decisión deben especificarse antes de elegir una métrica.
2. Una corrección escalar tiene un límite expresivo específico
Guo y sus colaboradores estudian la calibración en redes neuronales modernas y evalúan el escalado por temperatura, que reescala todos los logits mediante un único parámetro positivo antes de aplicar softmax. La eficacia que comunican motiva un método de referencia económico de posprocesamiento; no es un teorema según el cual una sola temperatura corrija cualquier red o distribución.
Una temperatura común positiva conserva el orden de los logits, incluidos los empates. En consecuencia, modifica la confianza sin cambiar una regla determinista de selección de la clase superior. Esto es valioso cuando se confía en la ordenación y la confianza está distorsionada aproximadamente por una escala común. No puede corregir un intercambio sistemático de clases, añadir una característica ausente ni asignar correcciones diferentes a dos entradas con logits idénticos. Si un subgrupo necesita una corrección mayor y otro una menor, ajustar una sola temperatura supone un compromiso entre ambos. Un objetivo de calibración sobre datos reservados puede favorecer ese compromiso mientras una decisión concreta durante el despliegue sigue siendo deficiente. La temperatura es, por tanto, un modelo del patrón de error, no un interruptor universal de fiabilidad. [1]
3. Una calibración agregada perfecta puede ocultar una estructura útil
Construyamos dos grupos de igual frecuencia. En el grupo A, la probabilidad del evento es de un décimo; en el grupo B, es de nueve décimos. Un predictor que siempre comunica un medio está perfectamente calibrado en la población combinada: de todos los casos que reciben un medio, la mitad experimenta el evento. Sin embargo, ignora la información de grupo. El predictor que comunica las dos probabilidades condicionales verdaderas también está calibrado y permite una clasificación mucho mejor cuando los costes de error son iguales.
El pronóstico constante ilustra por qué la calibración por sí sola no recompensa la resolución. También ilustra por qué un subgrupo puede estar mal calibrado incluso cuando una afirmación a escala poblacional es exacta. Dentro del grupo A, el pronóstico de probabilidad de un medio sobreestima en cuatro décimos; dentro del grupo B, subestima en la misma cantidad. Los errores solo se cancelan después de la agregación. Esta construcción es deliberadamente transparente: no afirma que los grupos demográficos reales tengan estas tasas de eventos, ni que el uso de cualquier atributo protegido concreto sea automáticamente apropiado.
4. La puntuación propia separa la información de un eslogan sobre calibración
Para un resultado de Bernoulli con probabilidad condicional verdadera q, la pérdida cuadrática esperada de probabilidad para una predicción p es igual a q por uno menos q, más el cuadrado de la diferencia entre p y q. La expansión del cuadrado proporciona directamente la identidad. El primer término es la variación condicional irreducible del resultado; el segundo es el coste evitable de una probabilidad inexacta. Esta identidad local no requiere ninguna suposición sobre la arquitectura neuronal.
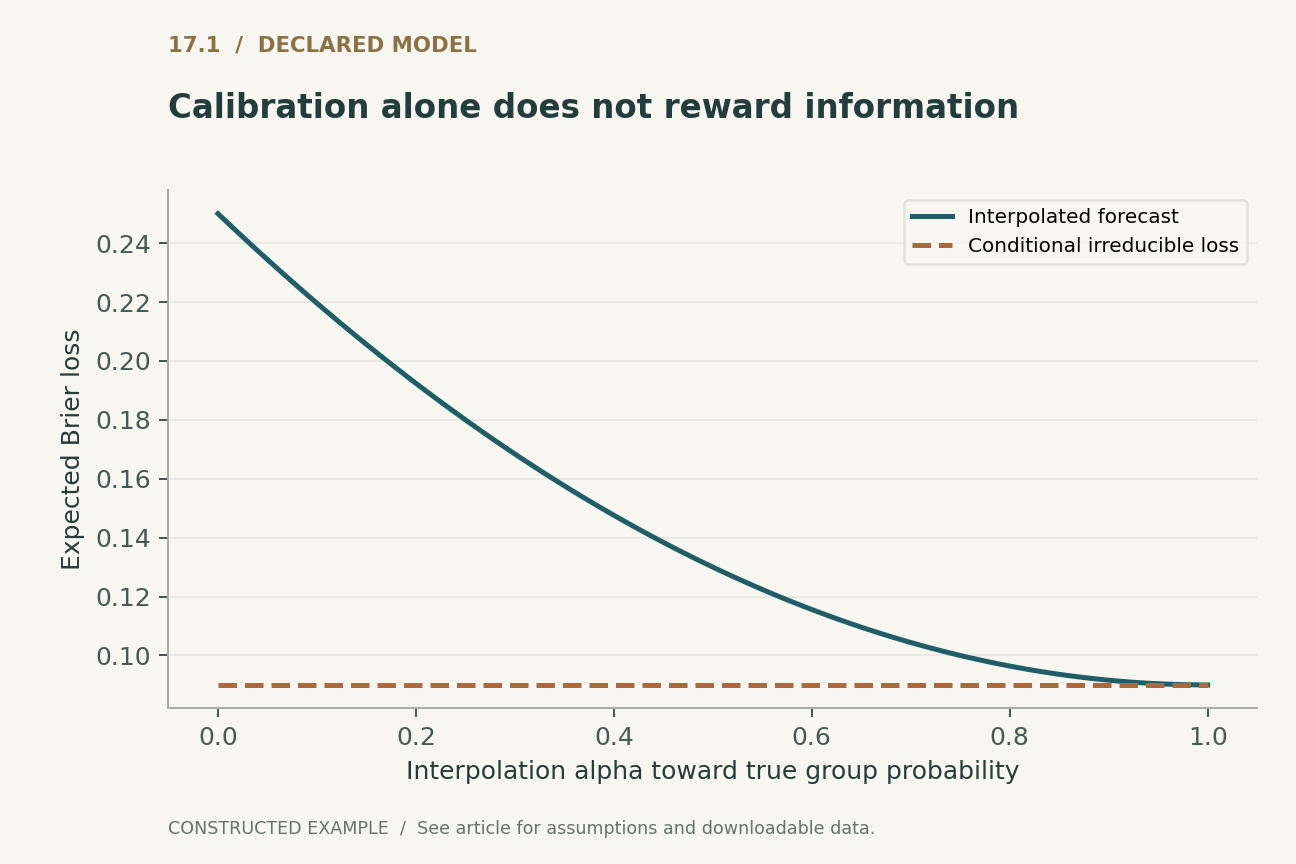
En nuestro ejemplo de dos grupos, el término irreducible es de nueve centésimos en ambos grupos. El pronóstico constante de un medio añade dieciséis centésimos, lo que produce una pérdida de Brier de un cuarto. El pronóstico informativo de la probabilidad verdadera alcanza nueve centésimos. La interpolación entre estos pronósticos produce la primera figura. Su curva desciende suavemente aunque el extremo constante ya está calibrado en términos agregados. Por tanto, un informe puede incluir tanto calibración como una puntuación propia sin considerar redundante ninguna de las dos. La puntuación logarítmica añade penalizaciones más fuertes cerca de los extremos en los que las predicciones son erróneas con gran confianza, pero exige tratar con cuidado los ceros exactos.
5. La agrupación en intervalos puede borrar el error que se mide
Vaicenavicius y sus colaboradores desarrollan un marco probabilístico para evaluar la calibración y distinguen nociones de condicionamiento que los resúmenes escalares pueden confundir. Su análisis respalda tratar un estadístico de evaluación como un procedimiento de medición con un objetivo particular.
Nuestro ejemplo concreta el problema. Asignemos a la mitad de la población una probabilidad pronosticada del evento de un cuarto y una frecuencia del resultado de un medio; asignemos a la otra mitad una probabilidad de tres cuartos y la misma frecuencia del resultado de un medio. Los intervalos de pronóstico separados revelan errores absolutos de probabilidad de un cuarto en cada grupo. Al fusionarlos en un solo intervalo se obtiene una predicción media de un medio y un resultado medio de un medio, lo que oculta por completo la discrepancia. Se trata de una ilustración de calibración de probabilidades; el ECE convencional de la confianza máxima se aplica a una variable distinta. Las muestras finitas añaden otra complicación: los errores observados por intervalo fluctúan incluso bajo una calibración verdadera. Un mayor número de intervalos mejora la resolución, pero deja menos observaciones en cada intervalo. Un único ECE bajo sin especificar la agrupación ni el tamaño muestral no puede establecer una propiedad poblacional. [2]
6. El umbral de decisión se deriva de los costes
Supongamos que la acción uno incurre en un coste C_FP cuando el evento está ausente, mientras que la acción cero incurre en un coste C_FN cuando está presente. Si p es la probabilidad verdadera del evento condicionada a la información utilizada, los costes esperados son C_FP por uno menos p y C_FN por p. Debe elegirse la acción uno cuando p supera C_FP dividido entre la suma de ambos costes; los empates pueden resolverse mediante cualquiera de las dos acciones sin modificar el coste esperado.
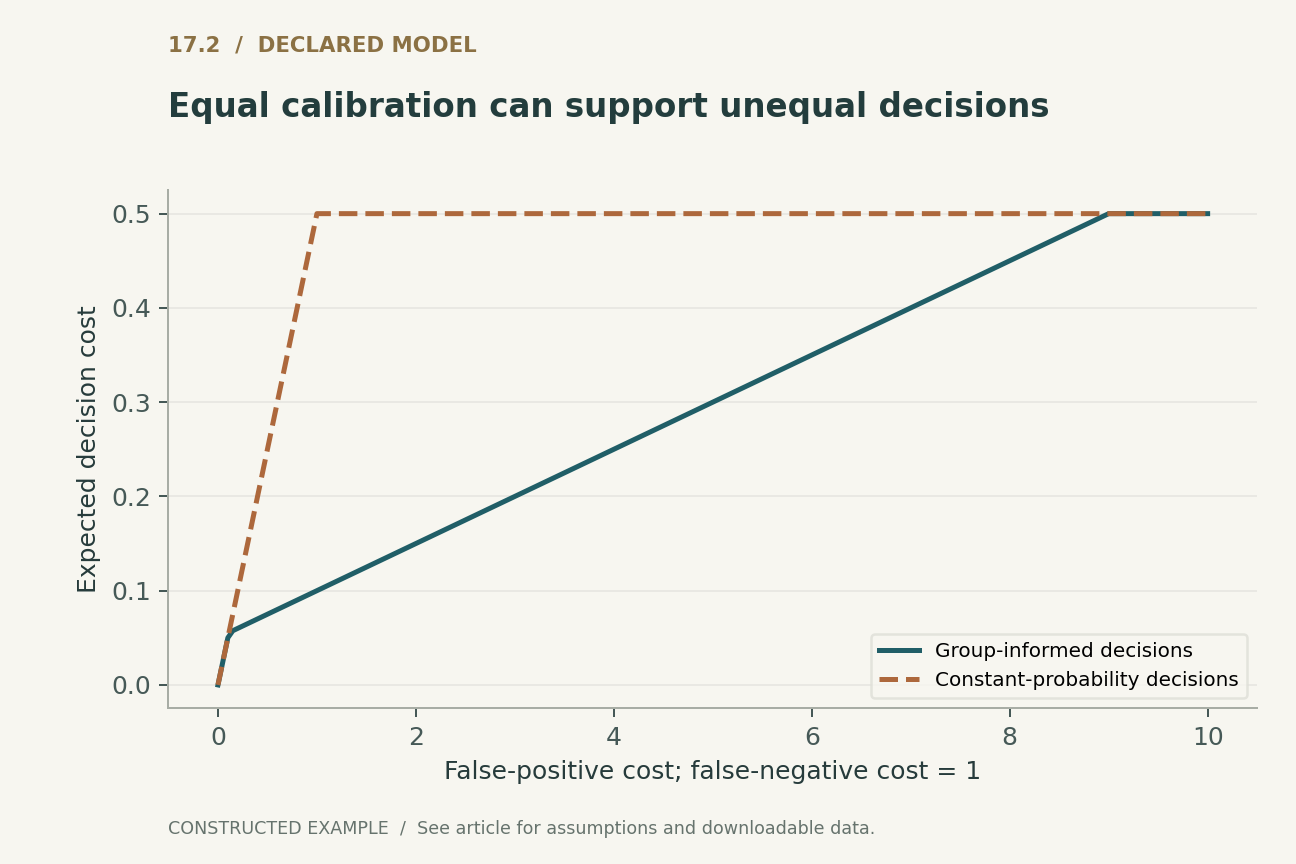
Con costes iguales, el pronóstico constante no puede distinguir nuestros dos grupos e incurre en un error de un medio. Utilizar sus probabilidades condicionales produce un error de un décimo. La segunda figura varía el coste del falso positivo y mantiene el coste del falso negativo en uno. Compara decisiones basadas en el conjunto de información constante con decisiones basadas en la información de grupo. Ambos pronósticos están calibrados respecto a lo que revelan, pero sus costes alcanzables difieren. Esta es una comparación de información, no evidencia de que un calibrador neuronal específico logre tales mejoras.
7. La flexibilidad multiclase debe asumir su coste de estimación
Kull y sus colaboradores introducen la calibración de Dirichlet, que transforma los logaritmos de las probabilidades mediante una aplicación lineal aprendida y softmax. Frente a una única temperatura, esto permite correcciones específicas por clase e interacciones entre las coordenadas de probabilidad. Su trabajo es un método de calibración multiclase, no una garantía de que una mayor flexibilidad mejore siempre la fiabilidad sobre datos reservados.
Los parámetros adicionales generan un problema ordinario de estimación. Un conjunto de calibración pequeño puede no permitir identificar una corrección útil para las clases poco frecuentes, y una flexibilidad sin restricciones puede ajustar el ruido muestral. Por ello, la regularización, el número de ejemplos por clase y los datos de evaluación separados deben figurar en la descripción del método. Cambiar la clase de mayor probabilidad puede mejorar o empeorar la clasificación; a diferencia de una temperatura común positiva, una transformación general no tiene por qué conservar la ordenación. Cualquier flujo de trabajo posterior que presupusiera decisiones inalteradas debe volver a probarse. El entrenamiento de calibración también debe aislarse del ajuste repetido sobre el conjunto de prueba, ya que seleccionar una transformación con los mismos ejemplos utilizados para su diagrama final de fiabilidad sesga el resultado aparente. [3]
8. La selección y el cambio de distribución modifican la población pertinente
Una afirmación probabilística está vinculada a una población. Si un servicio deriva los casos de baja confianza a una persona, la distribución retenida difiere de la del conjunto de prueba original. La calibración condicionada únicamente a la puntuación comunicada se conserva bajo una selección determinada exclusivamente por esa puntuación, siempre que el mecanismo de selección no introduzca información adicional sobre el resultado. No tiene por qué conservarse bajo una selección que también utilice un subgrupo no modelado, un canal de adquisición o una señal oculta de dificultad. Explicitar la regla de selección permite poner a prueba esta distinción.
Un cambio en la prevalencia de las clases también puede alterar la interpretación de una puntuación fija. Recalibrar después de cada cambio detectado en las entradas no está automáticamente justificado: un cambio en las entradas no tiene por qué modificar el mecanismo condicional del resultado, y la ausencia de cambios en las entradas no excluye un cambio en las etiquetas. El registro de despliegue debe distinguir una alarma sobre diferencias de distribución de la evidencia de un error probabilístico. Las etiquetas tardías, los resultados ausentes y la retroalimentación selectiva complican esa evidencia y deben permanecer visibles en los paneles de fiabilidad.
9. Qué establecen las comprobaciones finitas ejecutadas
El código adjunto representa veinte casos con igual peso: diez en cada grupo construido, con uno y nueve resultados positivos, respectivamente. Verifica la calibración agregada del pronóstico constante, sus discrepancias por subgrupo y las pérdidas de Brier exactas de los pronósticos constante e informativo. Un ejemplo separado de fusión de intervalos verifica que una agrupación más gruesa puede suprimir un estadístico de error. Todas las frecuencias se asignan deliberadamente; no son estimaciones obtenidas de un conjunto de datos externo.
Para el barrido de costes, las esperanzas condicionales exactas seleccionan de forma independiente la acción de menor coste en cada grupo de información. Las comprobaciones comparan estas decisiones con la enumeración directa de los resultados finitos para costes seleccionados. La comprobación de temperatura confirma la conservación del orden para logits representativos sin empates y temperaturas positivas. Estas pruebas detectan discrepancias algebraicas, de implementación y de las figuras. No pueden validar la calibración en usuarios reales ni demostrar que un método de posprocesamiento generalice a partir de un conjunto de validación finito. Esta última afirmación requiere el estudio propuesto con datos reservados.
10. Construir una evaluación en torno a las decisiones y la incertidumbre
Un informe práctico de calibración debe comenzar por la probabilidad de salida que se está interpretando y la decisión a la que servirá de apoyo. Después debe proporcionar una regla de puntuación propia, un condicionamiento explícito de la fiabilidad, intervalos de incertidumbre y costes de decisión o un rango justificado de costes. La cobertura tras la abstención y el número de ejemplos por clase deben acompañar a la métrica principal. Una comparación es más sólida cuando muestra la misma población reservada antes y después de aplicar una transformación de calibración, incluidos los casos en que el rendimiento empeora.
El criterio resultante es exigente, pero concreto. La calibración agregada es una restricción útil, no un objetivo completo. Una corrección flexible puede mejorar una transformación probabilística mal especificada, pero debe estimarse y evaluarse por separado. Una mejor información probabilística puede reducir el coste de decisión incluso cuando ambos pronósticos competidores satisfacen una afirmación de calibración. Estas son conclusiones analíticas respaldadas por las construcciones expuestas. El artículo propone, pero no ha realizado, un ensayo de calibración neuronal que abarque distintos dominios de adquisición, prevalencias de clase y umbrales operativos.
Ejecutado localmente · Alcance acotado
Población calibrada pero no informativa, fusión de intervalos y acciones óptimas en coste
Resultados finitos asignados y esperanzas poblacionales; intervalos de probabilidad de eventos binarios, no ECE de confianza multiclase. Sin ajuste sobre un conjunto de validación ni resultados de usuarios reales.
Se superaron 516 aserciones. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testimonio registrado
{
  "cases": 20,
  "group_positive_counts": [
    1,
    9
  ],
  "constant_Brier": 0.25,
  "informed_Brier": 0.09,
  "coarse_probability_ECE": 0.0,
  "fine_probability_ECE": 0.25,
  "cost_at_equal_error_costs": {
    "pooled": 0.5,
    "informed": 0.1
  }
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) El escalado por temperatura positiva conserva el orden de los logits; la temperatura se ajusta con datos de calibración separados y se evalúa con ejemplos no utilizados previamente.
(2) Error poblacional de calibración de probabilidades de eventos basado en intervalos para una Y binaria. No equivale automáticamente al ECE convencional de la confianza de la clase seleccionada; los intervalos forman parte de la definición.
(3) Para p fijo e Y de Bernoulli con probabilidad q. En los grupos construidos, q es 0.1 o 0.9; la pérdida de Brier es 0.09+0.16(1-alpha)^2 bajo la interpolación indicada.
(4) Acción binaria con costes de error no negativos y suma positiva; p debe representar la probabilidad condicional del evento para la información disponible en la decisión.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a cada pregunta?
| Evaluación | Pregunta útil | Punto ciego |
|---|---|---|
| Confianza de la clase superior | ¿Con qué frecuencia es correcta la clase seleccionada para este nivel de confianza? | Otras coordenadas del vector de probabilidades |
| Fiabilidad por clase | ¿Coincide la probabilidad de cada clase con la frecuencia de su evento? | Todas las condiciones conjuntas o de subgrupo posibles |
| Puntuación de Brier o logarítmica | ¿Se recompensan las probabilidades precisas e informativas? | Qué subgrupo explica un error agregado |
| Coste esperado de la acción | ¿Respalda la probabilidad esta decisión? | Otras decisiones con costes diferentes |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna evaluación de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado están documentados en las comprobaciones ejecutables.
- Fijar el objetivo probabilístico, el espacio de acciones, el rango de costes y la población de despliegue.
- Separar los ejemplos destinados al entrenamiento del modelo, al ajuste de la calibración, a la selección del método y a la evaluación final.
- Comparar las predicciones no calibradas, un método de referencia de temperatura positiva y una transformación flexible regularizada.
- Comunicar puntuaciones propias y curvas de fiabilidad con reglas de agrupación explícitas, recuentos de ejemplos e incertidumbre.
- Evaluar la fiabilidad de los subgrupos y de la población seleccionada sin ocultar las abstenciones ni las clases poco frecuentes.
- Medir el coste y la cobertura bajo umbrales preespecificados y repetir después la evaluación sobre cambios de distribución verdaderamente reservados.
Qué establecen las fuentes primarias
Chuan Guo, Geoff Pleiss, Yu Sun et al. · 2017 [1]
Contribución. Estudia la mala calibración de las redes neuronales y el escalado por temperatura como método de posprocesamiento.
Límite. La eficacia empírica depende del conjunto de datos; la temperatura conserva el orden de las clases.
Localización en la fuente. Secciones 2 y 4, escalado por temperatura.
Juozas Vaicenavicius, David Widmann, Carl Andersson et al. · 2019 [2]
Contribución. Formaliza distintas nociones de calibración probabilística y su evaluación.
Límite. Un resumen escalar no caracteriza todos los eventos de condicionamiento.
Localización en la fuente. Secciones sobre las definiciones de calibración y su evaluación.
Meelis Kull, Miquel Perello-Nieto, Markus Kängsepp et al. · 2019 [3]
Contribución. Introduce una transformación de calibración multiclase basada en logaritmos de probabilidades y una transformación lineal seguida de softmax.
Límite. La expresividad adicional requiere un ajuste adecuado y una evaluación independiente.
Localización en la fuente. Definición y parametrizaciones de la calibración de Dirichlet.
Límites de este análisis
- La población de veinte casos es una construcción y no constituye evidencia sobre ningún subgrupo real.
- Los cálculos poblacionales exactos evitan el ruido muestral que un estudio real de calibración debe cuantificar.
- Tres fuentes fundamentales no constituyen una comparación exhaustiva de los métodos modernos de calibración.
- El modelo de costes supone acciones binarias y costes conocidos; las decisiones complejas requieren su propio modelo de utilidad.
Una revisión analítica centrada en tres fuentes primarias fundamentales seleccionadas, con ejemplos desarrollados originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre el acceso a las fuentes y sus versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué eventos de condicionamiento de la calibración son necesarios para una decisión posterior concreta?
- ¿Cómo puede estimarse la fiabilidad de los grupos poco frecuentes sin ocultar su incertidumbre estadística?
- ¿Cuándo mejora una transformación multiclase flexible el coste esperado de decisión más allá de una temperatura escalar bien ajustada?
Referencias
- Chuan Guo, Geoff Pleiss, Yu Sun et al.. On Calibration of Modern Neural Networks. Proceedings of the 34th International Conference on Machine Learning (2017). Primary source.
- Juozas Vaicenavicius, David Widmann, Carl Andersson et al.. Evaluating model calibration in classification. Proceedings of the Twenty-Second International Conference on Artificial Intelligence and Statistics (2019). Primary source.
- Meelis Kull, Miquel Perello-Nieto, Markus Kängsepp et al.. Beyond temperature scaling: Obtaining well-calibrated multiclass probabilities with Dirichlet calibration. Advances in Neural Information Processing Systems 32 (2019). Primary source.
Acceso a la fuente [1]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Acceso a la fuente [2]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Acceso a la fuente [3]. Se inspeccionaron el registro primario y secciones seleccionadas accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Las identidades bibliográficas se contrastaron con los registros primarios de los editores y autores. Las notas siguientes sobre el acceso a las fuentes y sus versiones describen el alcance; no se trata de una auditoría exhaustiva de los textos completos.
Autoría y procedencia
Escrito y revisado técnicamente por el propio Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni evaluaciones de referencia de rendimiento reproducidas.
Este borrador local no cuenta con un registro de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos expuestos; no constituyen una verificación formal de los sistemas citados.