
Resumen
La generalización ante cambios de distribución depende de qué permanece estable, de qué observaciones objetivo están disponibles y de si el problema inverso resultante es identificable. Esta revisión contrasta la ponderación por covariables, la estimación del cambio de etiquetas y la predicción invariante mediante ejemplos finitos explícitos. Deriva una penalización por solapamiento para los pesos de importancia, una penalización por condicionamiento para la inversión de la matriz de confusión y dos mundos objetivo indistinguibles mediante observación con resultados de clasificación opuestos. Las figuras cuantifican esas construcciones declaradas, no una prueba de referencia. Las comprobaciones ejecutables recuperan una distribución a priori objetivo conocida cuando se cumplen los supuestos y demuestran el fallo de identificación cuando no se cumplen. Un protocolo propuesto de evaluación del aprendizaje profundo separa la detección, la corrección y la incertidumbre sobre el propio modelo de cambio.
1. El cambio de distribución no es un único problema matemático
Un modelo neuronal se entrena con una distribución conjunta de entradas y resultados, mientras que el despliegue proporciona otra. Decir que las distribuciones difieren no especifica qué puede aprenderse de las observaciones disponibles. Un cambio en las frecuencias de entrada con distribuciones condicionales de los resultados estables difiere de un cambio en las frecuencias de clase con distribuciones de entrada condicionadas a la clase estables. Un cambio en el significado de las etiquetas difiere de ambos. Por tanto, un método de adaptación constituye una afirmación sobre una familia de cambios, no una corrección genérica para cualquier discrepancia.
Conviene enumerar lo observado: ejemplos fuente etiquetados, entradas objetivo sin etiquetar, identificadores de entorno y, quizá, un flujo diferido de etiquetas objetivo. Cada observación puede eliminar algunas explicaciones candidatas. Ninguna identifica automáticamente una distribución condicional no observada. Nuestro análisis se concentra en este límite informativo. Una red mayor puede aproximar una transformación más compleja, pero la capacidad de representación no aporta la evidencia que falta sobre cuál es la transformación objetivo correcta.
2. La ponderación por covariables es un cambio de medida
Sugiyama, Krauledat y Müller estudian la validación cruzada ponderada por importancia ante cambios de covariables: las distribuciones marginales de entrada difieren mientras que la distribución condicional del resultado permanece fija. Su trabajo motiva la ponderación de las pérdidas de validación según el cociente entre la densidad de entrada objetivo y la fuente.
Para un predictor fijo, la identidad se obtiene desarrollando la esperanza objetivo y multiplicando y dividiendo por la densidad fuente. Requiere que el soporte objetivo esté cubierto por el soporte fuente y que la pérdida ponderada sea integrable. Si una región objetivo tiene probabilidad positiva, pero la probabilidad fuente es cero, ningún peso finito crea los ejemplos etiquetados ausentes. Incluso con solapamiento, estimar el cociente de densidades es una tarea estadística independiente. Una representación profunda puede facilitar la estimación del cociente al reducir la dimensión, pero también puede descartar distinciones necesarias para preservar el supuesto sobre la distribución condicional del resultado. Por tanto, la validez de la ponderación en el espacio de representación debe justificarse en ese espacio; no se desprende únicamente de disponer de un discriminador conveniente de baja dimensión. [1]
3. El solapamiento determina la cantidad útil de datos
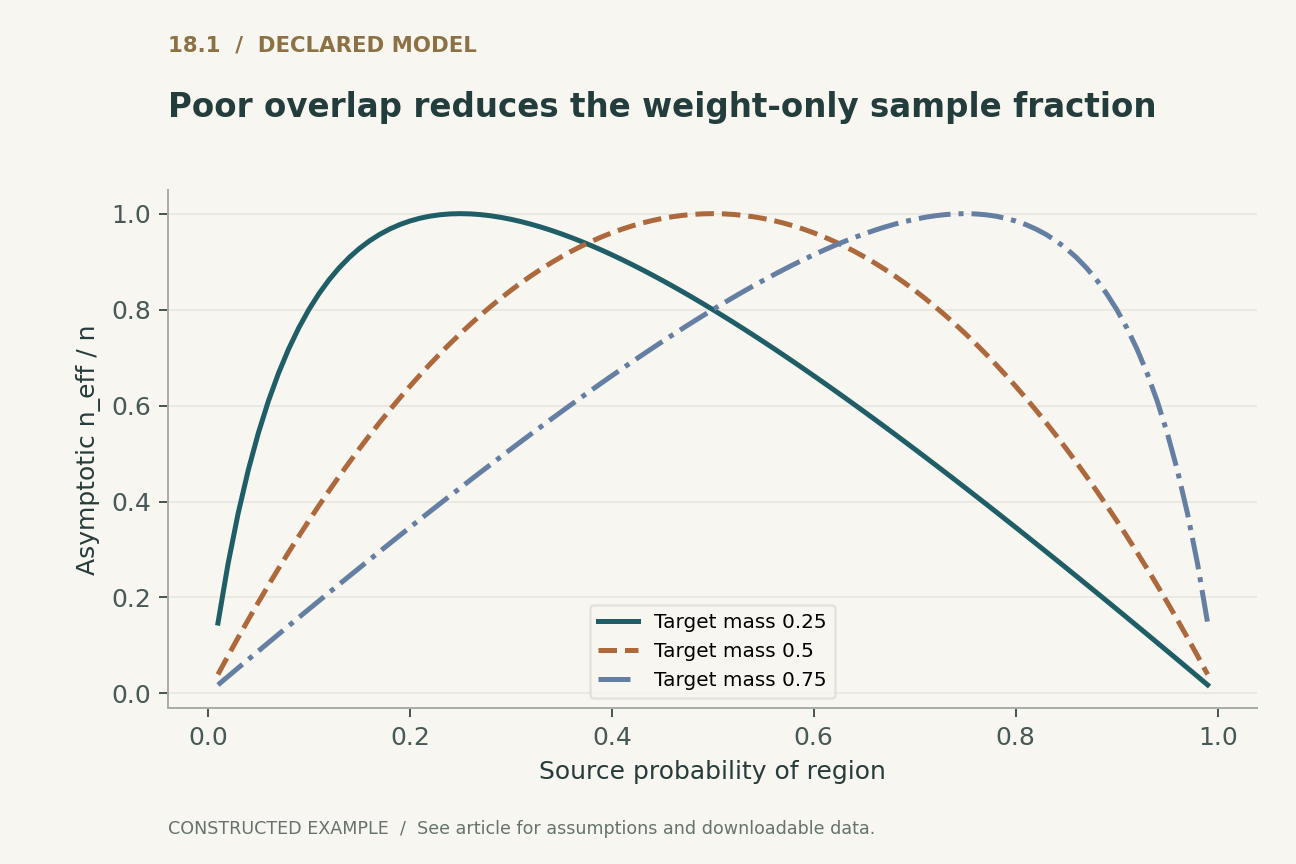
Consideremos una población fuente en la que una región poco frecuente tiene probabilidad a, mientras que el objetivo le asigna una probabilidad de un medio. Los dos pesos de importancia son un medio dividido por a y un medio dividido por uno menos a. Su esperanza bajo la distribución fuente es uno, pero su segundo momento crece cuando a se hace pequeña. Para extracciones independientes, la fracción asintótica habitual del tamaño muestral efectivo basada solo en los pesos es el inverso de ese segundo momento, que aquí equivale a cuatro por a por uno menos a.
Cuando a es igual a un décimo, esta fracción es 0.36. Cuando a es igual a un centésimo, es 0.0396. Son diagnósticos poblacionales de los pesos, no garantías de que todos los estimadores de pérdida tengan exactamente esa varianza ni de que una muestra finita observada contenga los ejemplos poco frecuentes necesarios. La primera figura varía la masa fuente y varias masas objetivo. La curva hace visible el supuesto de solapamiento: un gran número bruto de muestras puede ocultar una pequeña cantidad de información pertinente para la región objetivo.
4. El recorte intercambia un modo de fallo por otro
Los pesos grandes generan inestabilidad, por lo que una implementación puede recortarlos. En el ejemplo de dos regiones, tomemos una probabilidad fuente de un décimo para la región poco frecuente, una probabilidad objetivo de un medio y una pérdida de uno únicamente en esa región. El riesgo objetivo exacto es un medio y el riesgo fuente sin ponderar es un décimo. El peso correcto de la región poco frecuente es cinco. Recortarlo a dos produce una esperanza ponderada sin normalizar de un quinto, lo que introduce un sesgo a la baja.
Renormalizar los pesos recortados vuelve a cambiar el resultado; no restablece la identidad original de cambio de medida. Aun así, el recorte puede mejorar el error cuadrático medio de estimación con datos finitos, pero ello requiere un objetivo explícito de equilibrio entre sesgo y varianza y su evaluación. Un informe debería mostrar los cuantiles de los pesos, los diagnósticos de solapamiento, los umbrales de recorte y la sensibilidad de las conclusiones. Considerar que una puntuación ponderada numéricamente estable es automáticamente insesgada oculta el supuesto más trascendente del cálculo.
5. El cambio de etiquetas es un problema inverso
Lipton, Wang y Smola desarrollan la estimación de cambios mediante caja negra bajo distribuciones de entrada estables condicionadas a la clase, con supuestos de soporte fuente e invertibilidad. Su método utiliza la información de confusión de un predictor para inferir las proporciones modificadas de las etiquetas objetivo.
Para nuestra construcción binaria, supongamos que un clasificador fijo tiene una exactitud simétrica c condicionada a cualquiera de las etiquetas. Si la probabilidad a priori de la clase positiva objetivo es pi, su frecuencia de predicción positiva es uno menos c más el producto de dos c menos uno por pi. Es posible despejar pi cuando c difiere de un medio. Con c igual a 0.8 y pi igual a 0.3, la fracción positiva observada es 0.38 y la inversión recupera 0.3. Esta convención de matriz condicional difiere de una parametrización mediante una matriz de confusión conjunta que resuelve directamente los cocientes de probabilidades a priori; ambas convenciones concuerdan cuando se manejan de forma coherente. Mezclarlas puede producir inadvertidamente probabilidades a priori incorrectas incluso si todas las matrices tienen dimensiones plausibles. [2]
6. Invertible no significa bien condicionado
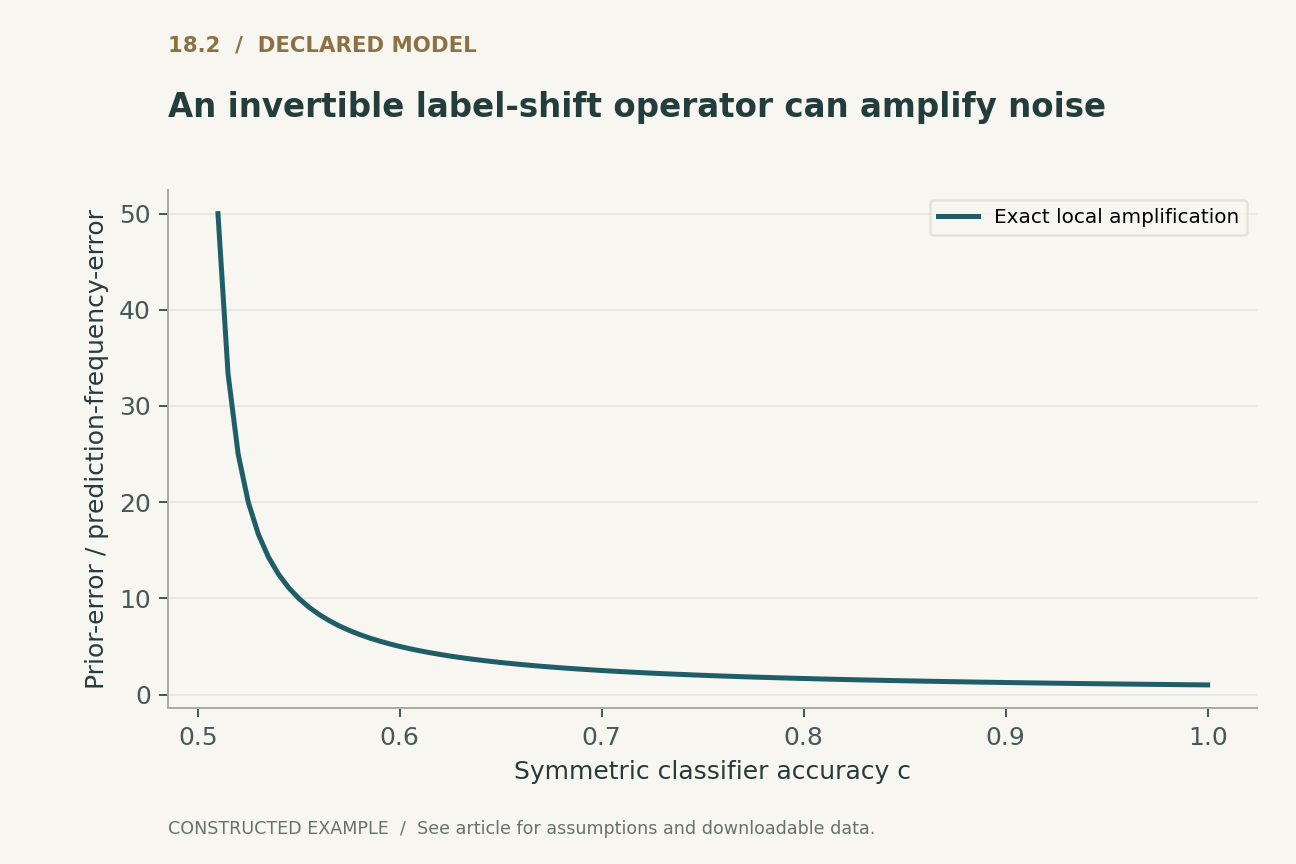
La sensibilidad de la probabilidad a priori binaria recuperada a un error en la frecuencia positiva observada es uno dividido por dos c menos uno. Con c igual a 0.75, la amplificación es dos; con c igual a 0.51, es cincuenta. La segunda figura muestra esta penalización por condicionamiento. A medida que el clasificador se aproxima a la predicción aleatoria, sus salidas apenas contienen información sobre qué clase las generó.
El mismo problema aparece en matrices de confusión multiclase cuando las columnas se vuelven casi linealmente dependientes. Puede existir una inversa formal mientras el ruido de muestreo produce estimaciones negativas inverosímiles de las probabilidades a priori. La estimación restringida puede imponer el simplex de probabilidad, pero no puede fabricar información ausente de las salidas. Las predicciones suaves pueden contener más información de clase que las decisiones categóricas, aunque su operador condicional necesita su propio análisis de condicionamiento. Obtener etiquetas objetivo puede ser especialmente valioso para las clases que confunde el predictor fuente; recopilar más predicciones sin etiquetar con la misma ambigüedad puede ser un uso poco provechoso del presupuesto disponible.
7. Entradas idénticas pueden ocultar riesgos objetivo opuestos
He aquí una construcción directa de no identificabilidad. Sea la entrada objetivo una variable binaria equiprobable. En el mundo A, su etiqueta coincide con la entrada; en el mundo B, su etiqueta es la opuesta. Las distribuciones de entradas objetivo sin etiquetar son idénticas. Un clasificador fijo que devuelve su entrada tiene error nulo en el mundo A y error unitario en el mundo B. Un observador que solo dispone de esas entradas objetivo no puede distinguir los mundos, por sofisticado que sea un detector de deriva.
Este ejemplo permite deliberadamente que cambie la distribución condicional de la etiqueta, por lo que vulnera los supuestos que justificarían la corrección del cambio de covariables. Su propósito no es refutar métodos dentro de su ámbito de validez. Muestra por qué la coincidencia de entradas objetivo no es evidencia suficiente de que persista la exactitud fuente, y por qué una diferencia de entradas por sí sola no puede identificar una corrección única. Informar de la tasa de éxito de un detector sin especificar qué mundos alternativos puede distinguir confunde la deriva observable con el riesgo predictivo no observado.
8. La invariancia necesita entornos informativos
Arjovsky y sus colegas proponen la minimización del riesgo invariante: aprender una representación que admita un predictor óptimo común en los entornos de entrenamiento. La formulación convierte la estructura predictiva estable en un objetivo explícito. Su utilidad depende de que los entornos y los supuestos del modelo aporten la variación necesaria para distinguir las relaciones estables de las accidentales.
Nuestro propio contraejemplo finito es sencillo. Supongamos que todos los entornos de entrenamiento contienen dos características que coinciden ambas con la etiqueta. Predecir a partir de cualquiera de ellas es óptimo e invariante en esos entornos. En un entorno objetivo, mantengamos la primera característica sin cambios e invirtamos la segunda. Los datos de entrenamiento no identificaron cuál era estable. Añadir más entornos de entrenamiento con el mismo patrón de confusión no resuelve la ambigüedad. Esto no contradice un teorema de invariancia con condiciones más fuertes de diversidad ambiental; demuestra por qué no pueden omitirse esas condiciones. El número de entornos no equivale a la información que aportan, y un valor pequeño de la penalización no es, por sí solo, un certificado causal. [3]
9. Qué comprueban los cálculos locales
El material complementario ejecutable enumera distribuciones discretas fuente y objetivo para verificar la identidad de cambio de medida con pérdidas fijas y pesos conocidos. Comprueba el contraejemplo del recorte por separado, de modo que la distinción entre ponderación exacta y regularizada siga siendo observable. Después construye frecuencias de predicción objetivo a partir de una matriz de confusión condicional conocida y recupera la distribución a priori objetivo resolviendo el sistema lineal correspondiente.
Para el ejemplo de condicionamiento, se compara una pequeña perturbación de la frecuencia de predicción con el cambio exacto en la probabilidad a priori recuperada. Los dos mundos objetivo indistinguibles se representan explícitamente y producen distribuciones marginales de entrada idénticas, pero riesgos opuestos del clasificador. Por último, se evalúan dos reglas basadas en características, óptimas en entrenamiento, antes y después de la inversión declarada. Estas comprobaciones son testigos algebraicos finitos. No estiman cocientes de densidades a partir de imágenes, no validan los supuestos causales de ningún entorno real ni reproducen una prueba de referencia de generalización de dominios con aprendizaje profundo. Su valor consiste en hacer inspeccionables las dependencias inferenciales antes de intentar esos experimentos.
10. Convertir los supuestos en un diseño de evaluación
Un estudio de adaptación convincente debería prerregistrar la familia de cambios, el presupuesto de información objetivo y el procedimiento de selección del método. Debería incluir tanto casos que satisfagan sus supuestos como vulneraciones controladas. Una corrección que funciona bien ante el cambio de etiquetas no debería calificarse de robusta en general solo porque la prueba de referencia contiene únicamente cambios de etiquetas. A la inversa, no debería juzgarse inválido un método dentro de su ámbito porque fracase ante un cambio deliberadamente incompatible.
El resultado práctico debería incluir métricas predictivas, diagnósticos de solapamiento o condicionamiento y una descripción explícita de la incertidumbre sobre el modelo de cambio. Las etiquetas objetivo diferidas pueden poner a prueba supuestos que las entradas sin etiquetar no permiten evaluar. Su obtención debería tratarse como parte del diseño de adaptación, no como una fuga de información incómoda que deba ocultarse. La conclusión central es constructiva: una generalización satisfactoria requiere un puente identificable entre los datos observados y el riesgo objetivo. Ese puente puede basarse en la estabilidad, el solapamiento, los entornos informativos o nuevas etiquetas, pero el algoritmo debe indicar qué evidencia sustenta su conclusión.
Ejecutado localmente · Alcance acotado
Cambio de medida, sesgo por recorte, inversión de probabilidades a priori y testigos de no identificabilidad
Distribuciones finitas conocidas y operadores condicionales fijos; sin cocientes de densidades aprendidos, etiquetas objetivo ni pruebas de referencia de adaptación neuronal.
503 aserciones superadas. Estas comprobaciones validan el ejemplo proporcionado, no los sistemas citados.
Inspeccionar el testigo registrado
{
  "target_risk": 0.5,
  "source_risk": 0.1,
  "clipped_weighted_risk": 0.2,
  "weight_ESS_fraction": 0.36,
  "target_prior_positive": 0.3,
  "observed_positive_fraction": 0.38,
  "indistinguishable_world_risks": [
    0.0,
    1.0
  ]
}
Ejecutor de ejemplos · Cargador de modelos · Modelos de entrenamiento · Modelos de representación · Modelos de generación · Modelos de fiabilidadLeer los resultados completos de las comprobaciones
Un modelo analítico declarado
Cuatro ecuaciones, supuestos explícitos
(1) Requiere Q(Y|X)=P(Y|X), que el soporte objetivo esté contenido en el soporte fuente y una pérdida ponderada integrable. El predictor es fijo para esta identidad del riesgo.
(2) Límite poblacional del diagnóstico habitual del tamaño muestral efectivo basado solo en los pesos para una masa regional fuente a y una masa objetivo tau, con 0<a<1. No es una fórmula universal de la varianza de la pérdida.
(3) Convención de confusión condicional con C estocástica por columnas. Bajo cambio de etiquetas, las frecuencias de predicción objetivo mu_Q identifican las probabilidades a priori objetivo pi_Q cuando C es invertible.
(4) Restricción idealizada de minimización del riesgo invariante de Arjovsky y colaboradores; un conjunto finito de entornos puede dejar varios predictores que la satisfagan. Una penalización práctica no es idéntica a esta restricción exacta.
Ejemplos construidos · Datos reproducibles
Inspeccionar el argumento cuantitativo
Estas curvas se calculan a partir de los modelos declarados. No son observaciones de los estudios citados. Cada figura incluye sus datos numéricos y su versión vectorial.


¿Qué evidencia responde a qué pregunta?
| Supuesto sobre el cambio | Potencialmente identificable a partir de | Fallo crítico |
|---|---|---|
| Distribución estable de Y dado X | Datos fuente etiquetados y densidad de entrada objetivo con solapamiento | Cambios en la distribución condicional objetivo o soporte no cubierto |
| Distribución estable de X dado Y | Operador condicional fuente y predicciones objetivo | Operador de confusión singular o mal condicionado |
| Mecanismo óptimo estable entre entornos | Entornos que varían las relaciones de confusión pertinentes | Todos los entornos conservan la misma correlación accidental |
| Distribución condicional objetivo sin restricciones | Nuevas etiquetas objetivo o información estructural adicional | Las entradas objetivo sin etiquetar, por sí solas, dejan el riesgo sin identificar |
Un protocolo de validación propuesto
Este es un diseño de evaluación propuesto. No se realizó ninguna prueba de referencia de sistemas de producción ni de hardware. Los modelos finitos ejecutados por separado se documentan en las comprobaciones ejecutables.
- Declarar la familia de cambios y qué etiquetas, entradas e identificadores de entorno objetivo están disponibles.
- Fijar el predictor fuente y separar el ajuste de la adaptación de la evaluación objetivo final.
- Construir cambios que satisfagan los supuestos, con cocientes de densidades o probabilidades a priori de clase conocidos, para realizar comprobaciones controladas.
- Informar del solapamiento, las colas de los pesos, el condicionamiento de la matriz, el recorte y las decisiones sobre estimación restringida.
- Añadir cambios condicionales y entornos ambiguos para revelar el límite real del método.
- Evaluar con etiquetas objetivo obtenidas por separado y revelar el presupuesto de etiquetado, la incertidumbre y las reglas de selección.
Qué establecen las fuentes primarias
Masashi Sugiyama, Matthias Krauledat, Klaus-Robert Müller · 2007 [1]
Contribución. Desarrolla la validación cruzada ponderada por importancia para el cambio de covariables.
Límite. Las distribuciones condicionales estables y un soporte suficiente son necesarios para el argumento de cambio de medida.
Ubicación en la fuente. Formulación del problema y construcción de IWCV.
Zachary C. Lipton, Yu-Xiang Wang, Alexander J. Smola · 2018 [2]
Contribución. Utiliza predicciones de caja negra e información de confusión para estimar proporciones de etiquetas modificadas.
Límite. El soporte, las distribuciones condicionales de clase estables y la invertibilidad limitan la identificación.
Ubicación en la fuente. Supuestos A.1–A.3 y resultados de consistencia.
Martin Arjovsky, Léon Bottou, Ishaan Gulrajani et al. · 2019 [3]
Contribución. Propone representaciones con un predictor óptimo común entre los entornos de entrenamiento.
Límite. La identificación depende de la variación ambiental y de los supuestos estructurales.
Ubicación en la fuente. Formulación en la sección 3 y análisis de generalización en la sección 4.
Límites de este análisis
- Todas las distribuciones ejecutadas son construcciones finitas, no mediciones de modelos neuronales desplegados.
- La curva del tamaño muestral efectivo concierne solo a los pesos y no determina la varianza de todos los estimadores.
- El modelo binario simétrico de confusión simplifica un problema de estimación potencialmente de alta dimensión.
- El contraejemplo de invariancia muestra que la información de los entornos es insuficiente, no que fallen todos los métodos que utilizan una estructura invariante.
Una revisión analítica centrada en tres fuentes primarias fundamentales seleccionadas, con ejemplos resueltos originales. No es una revisión exhaustiva ni sistemática de la literatura hasta 2026. Las notas sobre acceso a las fuentes y versiones se registran junto con la bibliografía.
Preguntas que cambiarían la conclusión
- ¿Qué etiquetas objetivo distinguen de forma más eficiente las explicaciones alternativas del cambio?
- ¿Pueden los diagnósticos de solapamiento y condicionamiento del operador predecir cuándo la adaptación debería abstenerse de corregir?
- ¿Cómo deberían diseñarse los entornos para que la predicción invariante sea identificable, en lugar de limitarse a imponerle una penalización numérica?
Referencias
- Masashi Sugiyama, Matthias Krauledat, Klaus-Robert Müller. Covariate Shift Adaptation by Importance Weighted Cross Validation. Journal of Machine Learning Research (2007). Primary source.
- Zachary C. Lipton, Yu-Xiang Wang, Alexander J. Smola. Detecting and Correcting for Label Shift with Black Box Predictors. Proceedings of the 35th International Conference on Machine Learning (2018). Primary source.
- Martin Arjovsky, Léon Bottou, Ishaan Gulrajani et al.. Invariant Risk Minimization. arXiv:1907.02893 (2019). Primary source.
Acceso a la fuente [1]. Se inspeccionaron el registro primario y determinadas secciones accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Acceso a la fuente [2]. Se inspeccionaron el registro primario y determinadas secciones accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Acceso a la fuente [3]. Se inspeccionaron el registro primario y determinadas secciones accesibles del texto completo; no se realizó una auditoría exhaustiva del material suplementario.
Nota sobre la versión. Prepublicación inicial 2019; se inspeccionó la versión HTML 3, revisada el 27 de marzo de 2020. Este registro no incluye ninguna afirmación de aceptación en un congreso.
Las identidades bibliográficas se cotejaron con registros primarios de editoriales y autores. Las notas de acceso a las fuentes y versiones que figuran a continuación describen el alcance; no se trata de una auditoría exhaustiva del texto completo.
Autoría y procedencia
Redactado y autorrevisado técnicamente por Codex (IA). Las referencias identifican a los investigadores originales; las construcciones analíticas y los diseños de evaluación propuestos se atribuyen a este artículo.
Las portadas son ilustraciones conceptuales de ImageGen. Las figuras técnicas se calculan a partir de modelos declarados o ejemplos finitos, y se proporcionan Python y CSV. No son mediciones de productos desplegados ni pruebas de referencia de rendimiento reproducidas.
Este borrador local no tiene un registro de revisión por pares independiente ni de aceptación en una revista. Los ejemplos ejecutables de alcance acotado comprueban los pequeños modelos enunciados; no constituyen una verificación formal de los sistemas citados.